
29 KiB
เริ่มต้นกับ Python และ Scikit-learn สำหรับโมเดลการถดถอย
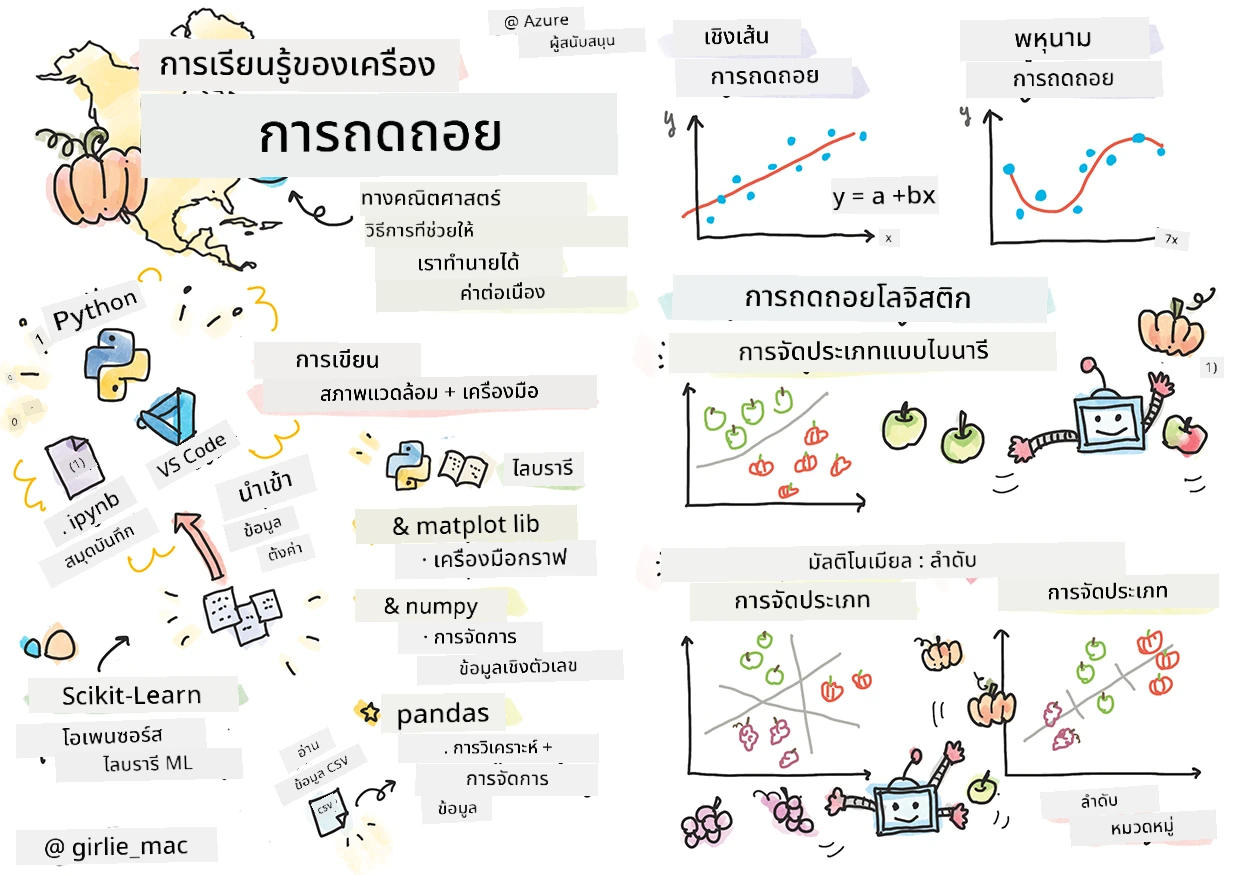
สเก็ตช์โน้ตโดย Tomomi Imura
แบบทดสอบก่อนเรียน
บทเรียนนี้มีให้ใช้ในภาษา R!
บทนำ
ในบทเรียนทั้งสี่นี้ คุณจะได้ค้นพบวิธีสร้างโมเดลการถดถอย เราจะพูดถึงวัตถุประสงค์ของมันในไม่ช้า แต่ก่อนที่คุณจะทำอะไรก็ตาม ให้แน่ใจว่าคุณมีเครื่องมือที่เหมาะสมพร้อมเริ่มต้นกระบวนการนี้!
ในบทเรียนนี้ คุณจะได้เรียนรู้วิธี:
- กำหนดคอมพิวเตอร์ของคุณสำหรับงานเรียนรู้ของเครื่องแบบท้องถิ่น
- ใช้งาน Jupyter Notebooks
- ใช้ Scikit-learn รวมถึงการติดตั้ง
- สำรวจการถดถอยเชิงเส้นด้วยแบบฝึกหัดปฏิบัติ
การติดตั้งและการกำหนดค่า

🎥 คลิกที่ภาพด้านบนเพื่อดูวิดีโอสั้น ๆ เกี่ยวกับการกำหนดค่าคอมพิวเตอร์ของคุณสำหรับ ML
-
ติดตั้ง Python ให้แน่ใจว่า Python ได้ติดตั้งในคอมพิวเตอร์ของคุณแล้ว คุณจะใช้ Python สำหรับงานวิทยาศาสตร์ข้อมูลและการเรียนรู้ของเครื่องจำนวนมาก ระบบคอมพิวเตอร์ส่วนใหญ่มีการติดตั้ง Python อยู่แล้ว มี ชุดรหัส Python ที่มีประโยชน์ให้บริการด้วย เพื่อช่วยให้ง่ายต่อการตั้งค่าสำหรับผู้ใช้บางกลุ่ม
อย่างไรก็ตาม การใช้งานบางอย่างของ Python อาจต้องการซอฟต์แวร์เวอร์ชันหนึ่ง ในขณะที่บางงานใช้เวอร์ชันที่ต่างกัน ดังนั้นจึงเป็นประโยชน์ที่จะทำงานภายใน สภาพแวดล้อมเสมือน
-
ติดตั้ง Visual Studio Code ตรวจสอบให้แน่ใจว่าคุณได้ติดตั้ง Visual Studio Code ในคอมพิวเตอร์ของคุณแล้ว ทำตามคำแนะนำเหล่านี้เพื่อ ติดตั้ง Visual Studio Code สำหรับการติดตั้งพื้นฐาน คุณจะใช้ Python ใน Visual Studio Code ในคอร์สนี้ ดังนั้นคุณอาจต้องการเรียนรู้วิธี กำหนดค่า Visual Studio Code สำหรับการพัฒนา Python
ทำความคุ้นเคยกับ Python โดยทำตามชุด โมดูลการเรียนรู้

🎥 คลิกที่ภาพด้านบนเพื่อดูวิดีโอ: การใช้ Python ใน VS Code
-
ติดตั้ง Scikit-learn โดยทำตาม คำแนะนำเหล่านี้ เนื่องจากคุณต้องแน่ใจว่าใช้ Python 3 ขอแนะนำให้ใช้สภาพแวดล้อมเสมือน หากคุณกำลังติดตั้งไลบรารีนี้บน Mac M1 มีคำแนะนำพิเศษในหน้าที่ลิงก์ไว้ข้างต้น
-
ติดตั้ง Jupyter Notebook คุณจะต้อง ติดตั้งแพ็กเกจ Jupyter
สภาพแวดล้อมสำหรับเขียน ML ของคุณ
คุณจะใช้ โน้ตบุ๊ก เพื่อพัฒนาโค้ด Python ของคุณและสร้างโมเดลการเรียนรู้ของเครื่อง ไฟล์ประเภทนี้เป็นเครื่องมือที่ใช้กันโดยทั่วไปสำหรับนักวิทยาศาสตร์ข้อมูล และสามารถระบุได้จากนามสกุล .ipynb
โน้ตบุ๊กเป็นสภาพแวดล้อมแบบโต้ตอบที่ช่วยให้นักพัฒนาสามารถเขียนโค้ดพร้อมทั้งเพิ่มบันทึกและเอกสารประกอบรอบโค้ด ซึ่งมีประโยชน์อย่างมากสำหรับโครงการทดลองหรือวิจัย

🎥 คลิกที่ภาพด้านบนเพื่อดูวิดีโอสั้น ๆ ในการทำแบบฝึกหัดนี้
แบบฝึกหัด - ทำงานกับโน้ตบุ๊ก
ในโฟลเดอร์นี้ คุณจะพบไฟล์ notebook.ipynb
-
เปิด notebook.ipynb ใน Visual Studio Code
เซิร์ฟเวอร์ Jupyter จะเริ่มทำงานพร้อมกับ Python 3+ เปิดใช้งาน คุณจะพบส่วนของโน้ตบุ๊กที่สามารถ
runหรือรันได้ ซึ่งเป็นชิ้นส่วนของโค้ด คุณสามารถรันโค้ดบล็อกนั้นได้โดยเลือกไอคอนที่เหมือนปุ่มเล่น -
เลือกไอคอน
mdและเพิ่มข้อความมาร์กดาวน์สั้นๆ พร้อมข้อความดังนี้ # ยินดีต้อนรับสู่โน้ตบุ๊กของคุณถัดไป เพิ่มโค้ด Python บางส่วน
-
พิมพ์ print('hello notebook') ในบล็อกโค้ด
-
เลือกลูกศรเพื่อรันโค้ด
คุณควรจะเห็นข้อความที่พิมพ์ออกมา:
hello notebook
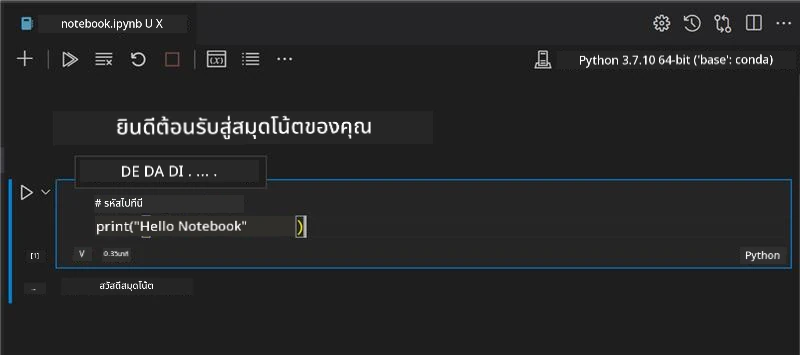
คุณสามารถสลับโค้ดของคุณกับคอมเมนต์เพื่อช่วยบันทึกเอกสารในโน้ตบุ๊กได้
✅ ลองคิดดูสักครู่ว่าสภาพแวดล้อมการทำงานของนักพัฒนาเว็บแตกต่างจากนักวิทยาศาสตร์ข้อมูลอย่างไร
เริ่มต้นกับ Scikit-learn
ตอนนี้ที่ Python ได้ตั้งค่าไว้ในสภาพแวดล้อมท้องถิ่นของคุณแล้ว และคุณเริ่มชินกับ Jupyter Notebooks แล้ว มาทำความคุ้นเคยกับ Scikit-learn กันบ้าง (ออกเสียงว่า sci เหมือนคำว่า science) Scikit-learn มี API ที่หลากหลาย เพื่อช่วยคุณในการทำงาน ML
ตามที่ เว็บไซต์ของพวกเขา กล่าวว่า "Scikit-learn เป็นไลบรารีเครื่องจักรเรียนรู้แบบโอเพ่นซอร์สที่รองรับการเรียนรู้แบบมีผู้ดูแลและไม่มีผู้ดูแล นอกจากนี้ยังมีเครื่องมือต่าง ๆ สำหรับการปรับโมเดล การเตรียมข้อมูล การเลือกและประเมินผลโมเดล และยูทิลิตี้อื่น ๆ อีกมากมาย"
ในคอร์สนี้ คุณจะใช้ Scikit-learn และเครื่องมืออื่น ๆ เพื่อสร้างโมเดลการเรียนรู้ของเครื่องสำหรับงานที่เราเรียกว่า 'การเรียนรู้ของเครื่องแบบดั้งเดิม' เราพยายามหลีกเลี่ยงเครือข่ายประสาทและการเรียนรู้เชิงลึก เพราะคอร์ส 'AI สำหรับผู้เริ่มต้น' ของเราจะครอบคลุมในอนาคต
Scikit-learn ช่วยให้การสร้างและประเมินโมเดลง่ายขึ้นเน้นการใช้ข้อมูลตัวเลขและมีชุดข้อมูลสำเร็จรูปหลายชุดให้ใช้ฟรี มันยังมีโมเดลที่เตรียมไว้สำหรับนักเรียนลองใช้ เรามาลองกระบวนการโหลดข้อมูลสำเร็จรูปและใช้ตัวประมาณโมเดลในตัวเพื่อสร้างโมเดล ML แรกของคุณด้วย Scikit-learn กับข้อมูลพื้นฐานกันเถอะ
แบบฝึกหัด - โน้ตบุ๊ก Scikit-learn แรกของคุณ
แบบฝึกหัดนี้ได้รับแรงบันดาลใจจาก ตัวอย่างการถดถอยเชิงเส้น บนเว็บไซต์ Scikit-learn

🎥 คลิกที่ภาพด้านบนเพื่อดูวิดีโอสั้นๆ ทำแบบฝึกหัดนี้
ในไฟล์ notebook.ipynb ที่เกี่ยวข้องกับบทเรียนนี้ ให้ล้างเซลล์ทั้งหมดโดยกดไอคอนถังขยะ
ในส่วนนี้ คุณจะทำงานกับชุดข้อมูลเล็ก ๆ เกี่ยวกับโรคเบาหวานที่ฝังอยู่ใน Scikit-learn เพื่อการเรียนรู้ ลองนึกภาพว่าคุณต้องการทดสอบการรักษาผู้ป่วยเบาหวาน โมเดลการเรียนรู้ของเครื่องอาจช่วยคุณกำหนดได้ว่าผู้ป่วยคนใดจะตอบสนองดีกับการรักษาตามชุดตัวแปรผสมกัน แม้แต่โมเดลถดถอยพื้นฐานเมื่อมองภาพแล้ว อาจให้ข้อมูลเกี่ยวกับตัวแปรที่ช่วยจัดการทดลองทางคลินิกเชิงทฤษฎีของคุณ
✅ มีวิธีการถดถอยหลายประเภท และการเลือกวิธีขึ้นกับคำตอบที่คุณต้องการ หากต้องการทำนายความสูงที่เป็นไปได้สำหรับคนตามอายุที่กำหนด คุณจะใช้ถดถอยเชิงเส้น เพราะคุณกำลังมองหา ค่าตัวเลข หากคุณสนใจค้นหาว่าอาหารประเภทใดควรจัดว่าเป็นมังสวิรัติหรือไม่ คุณกำลังมองหาการ จัดประเภทหมวดหมู่ ดังนั้นคุณจะใช้การถดถอยโลจิสติก คุณจะได้เรียนรู้เกี่ยวกับการถดถอยโลจิสติกในภายหลัง ลองคิดคำถามบางอย่างที่คุณอาจถามเกี่ยวกับข้อมูล และวิธีไหนที่เหมาะสมกว่า
มาเริ่มต้นงานนี้กันเถอะ
นำเข้าไลบรารี
สำหรับงานนี้เราจะนำเข้าไลบรารีบางตัว:
- matplotlib เป็น เครื่องมือกราฟ ที่มีประโยชน์ และเราจะใช้มันสร้างกราฟเส้น
- numpy numpy เป็นไลบรารีที่ใช้จัดการข้อมูลตัวเลขใน Python
- sklearn คือไลบรารี Scikit-learn
นำเข้าไลบรารีเพื่อช่วยงานของคุณ
-
เพิ่มการนำเข้าโดยพิมพ์โค้ดดังนี้:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
ข้างบน คุณกำลังนำเข้า
matplotlib,numpyและนำเข้าdatasets,linear_modelและmodel_selectionจากsklearnmodel_selectionใช้สำหรับแบ่งข้อมูลเป็นชุดฝึกและชุดทดสอบ
ชุดข้อมูลเบาหวาน
ชุดข้อมูล เบาหวาน ที่ฝังไว้มีข้อมูลตัวอย่าง 442 ตัวอย่างเกี่ยวกับเบาหวานประกอบด้วยตัวแปรคุณลักษณะ 10 ตัวบางตัวได้แก่:
- อายุ: อายุเป็นปี
- bmi: ดัชนีมวลกาย
- bp: ความดันโลหิตเฉลี่ย
- s1 tc: T-เซลล์ (เซลล์ขาวชนิดหนึ่ง)
✅ ชุดข้อมูลนี้รวมแนวคิด 'เพศ' เป็นตัวแปรคุณลักษณะที่สำคัญในการวิจัยเรื่องเบาหวาน ชุดข้อมูลทางการแพทย์จำนวนมากรวมการจำแนกแบบไบนารีนี้ ลองคิดดูว่าการจำแนกแบบนี้อาจกีดกันส่วนหนึ่งของประชากรจากการได้รับการรักษาอย่างไร
ตอนนี้ ให้โหลดข้อมูล X และ y ขึ้นมา
🎓 จำไว้นะ นี่คือการเรียนรู้แบบมีผู้ดูแล เราจึงต้องมี 'y' เป้าหมายชื่อเรียก
ในเซลล์โค้ดใหม่ ให้โหลดชุดข้อมูลเบาหวานโดยเรียก load_diabetes() ป้อนค่า return_X_y=True เพื่อสัญญาณว่า X จะเป็นเมทริกซ์ข้อมูล และ y เป็นเป้าหมายของการถดถอย
-
เพิ่มคำสั่งพิมพ์เพื่อแสดงรูปร่างของเมทริกซ์ข้อมูลและอิลิเมนต์แรก:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
สิ่งที่คุณได้รับกลับเป็นผลลัพธ์ คือทูเพิล สิ่งที่คุณทำคือการกำหนดสองค่าหลังในทูเพิลให้กับ
Xและyตามลำดับ เรียนรู้เพิ่มเติมเกี่ยวกับ ทูเพิลคุณจะเห็นว่าข้อมูลนี้มี 442 ตัวอย่างจัดเป็นอาร์เรย์ 10 อิลิเมนต์:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ ลองคิดดูเล็กน้อยเกี่ยวกับความสัมพันธ์ระหว่างข้อมูลและเป้าหมายการถดถอย การถดถอยเชิงเส้นคาดการณ์ความสัมพันธ์ระหว่างคุณลักษณะ X และตัวแปรเป้าหมาย y คุณจะหา เป้าหมาย ของชุดข้อมูลเบาหวานในเอกสารได้ไหม? ชุดข้อมูลนี้แสดงอะไรเมื่อดูจากเป้าหมายนี้?
-
ต่อไป ให้เลือกบางส่วนของชุดข้อมูลนี้เพื่อพล็อต โดยเลือกคอลัมน์ที่ 3 ของชุดข้อมูล คุณทำได้โดยใช้ตัวดำเนินการ
:เพื่อเลือกแถวทั้งหมด แล้วเลือกคอลัมน์ที่ 3 โดยใช้ดัชนี (2) คุณยังสามารถปรับรูปร่างของข้อมูลให้เป็นอาร์เรย์ 2 มิติได้ตามที่ต้องการสำหรับการพล็อตโดยใช้reshape(n_rows, n_columns)ถ้าพารามิเตอร์เป็น -1 มิติที่เกี่ยวข้องจะถูกคำนวณโดยอัตโนมัติX = X[:, 2] X = X.reshape((-1,1))✅ ทุกเมื่อ คุณสามารถพิมพ์ข้อมูลออกมาเพื่อตรวจสอบรูปร่างได้
-
ตอนนี้คุณมีข้อมูลพร้อมพล็อตแล้ว ดูว่าคอมพิวเตอร์ช่วยหาจุดแบ่งที่เหมาะสมระหว่างตัวเลขในชุดข้อมูลนี้ได้ไหม การทำเช่นนี้ต้องแบ่งข้อมูล (X) และเป้าหมาย (y) เป็นชุดทดสอบและชุดฝึก Scikit-learn มีวิธีที่ง่ายสำหรับเรื่องนี้ คุณสามารถแบ่งชุดข้อมูลทดสอบได้จากจุดที่กำหนด
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
ตอนนี้พร้อมฝึกโมเดลของคุณแล้ว! โหลดโมเดลการถดถอยเชิงเส้นและฝึกด้วยชุดข้อมูล X และ y สำหรับฝึกโดยใช้
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()เป็นฟังก์ชันที่คุณจะเห็นในไลบรารี ML หลายตัว เช่น TensorFlow -
จากนั้น สร้างการทำนายโดยใช้ข้อมูลทดสอบด้วยฟังก์ชัน
predict()ซึ่งจะใช้ในการวาดเส้นแบ่งระหว่างกลุ่มข้อมูลy_pred = model.predict(X_test) -
ถึงเวลาที่จะแสดงข้อมูลบนแผนภูมิ Matplotlib เป็นเครื่องมือที่มีประโยชน์มากสำหรับงานนี้ สร้างแผนภูมิแบบ scatterplot ของข้อมูล X และ y ในชุดทดสอบทั้งหมด และใช้การทำนายเพื่อวาดเส้นในตำแหน่งที่เหมาะสมที่สุด ระหว่างกลุ่มข้อมูลของโมเดล
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()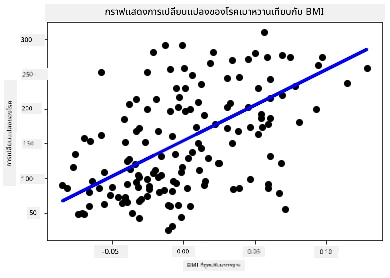
✅ ลองคิดดูว่าเกิดอะไรขึ้นที่นี่เส้นตรงลากผ่านจุดข้อมูลเล็ก ๆ หลายจุด แต่เส้นนี้ทำอะไรแน่? คุณเห็นว่าคุณควรใช้เส้นนี้เพื่อทำนายว่าจุดข้อมูลใหม่ที่ไม่เคยเห็นมาก่อนควรจะอยู่ตรงไหนเมื่อเทียบกับแกน y ของแผนภูมิไหม? ลองอธิบายการใช้งานจริงของโมเดลนี้เป็นคำพูดดู
ยินดีด้วย คุณสร้างโมเดลการถดถอยเชิงเส้นแรกของคุณแล้ว สร้างการทำนายและแสดงผลในแผนภูมิเรียบร้อย!
🚀ความท้าทาย
พล็อตตัวแปรที่แตกต่างจากชุดข้อมูลนี้ คำใบ้: แก้ไขบรรทัดนี้: X = X[:,2] เมื่อดูจากเป้าหมายของชุดข้อมูลนี้ คุณค้นพบอะไรเกี่ยวกับการดำเนินโรคเบาหวาน?
แบบทดสอบหลังเรียน
ทบทวน & ศึกษาด้วยตนเอง
ในบทเรียนนี้ คุณทำงานกับการถดถอยเชิงเส้นง่าย ๆ แทนที่จะเป็นการถดถอยเชิงเส้นแบบตัวแปรเดียวหรือหลายตัวแปร อ่านเพิ่มเติมเกี่ยวกับความแตกต่างระหว่างวิธีเหล่านี้ หรือดู วิดีโอนี้
อ่านเพิ่มเติมเกี่ยวกับแนวคิดของการวิเคราะห์ข้อมูลถดถอยและคิดเกี่ยวกับคำถามประเภทใดที่เทคนิคนี้สามารถตอบได้ ทำแบบฝึกหัด บทช่วยสอนนี้ เพื่อเพิ่มความเข้าใจของคุณ
งานที่มอบหมาย
ปฏิเสธความรับผิดชอบ: เอกสารนี้ได้รับการแปลโดยใช้บริการแปลภาษา AI Co-op Translator ขณะที่เราพยายามให้ความถูกต้อง โปรดทราบว่าการแปลโดยอัตโนมัติอาจมีข้อผิดพลาดหรือความไม่ถูกต้อง เอกสารต้นฉบับในภาษาต้นทางควรถูกพิจารณาเป็นแหล่งข้อมูลที่เชื่อถือได้ สำหรับข้อมูลที่สำคัญ แนะนำให้ใช้การแปลโดยมนุษย์มืออาชีพ เราไม่รับผิดชอบต่อความเข้าใจผิดหรือการตีความที่ผิดพลาดที่เกิดขึ้นจากการใช้การแปลนี้