
37 KiB
การสร้างโซลูชัน Machine Learning ด้วย AI ที่รับผิดชอบ
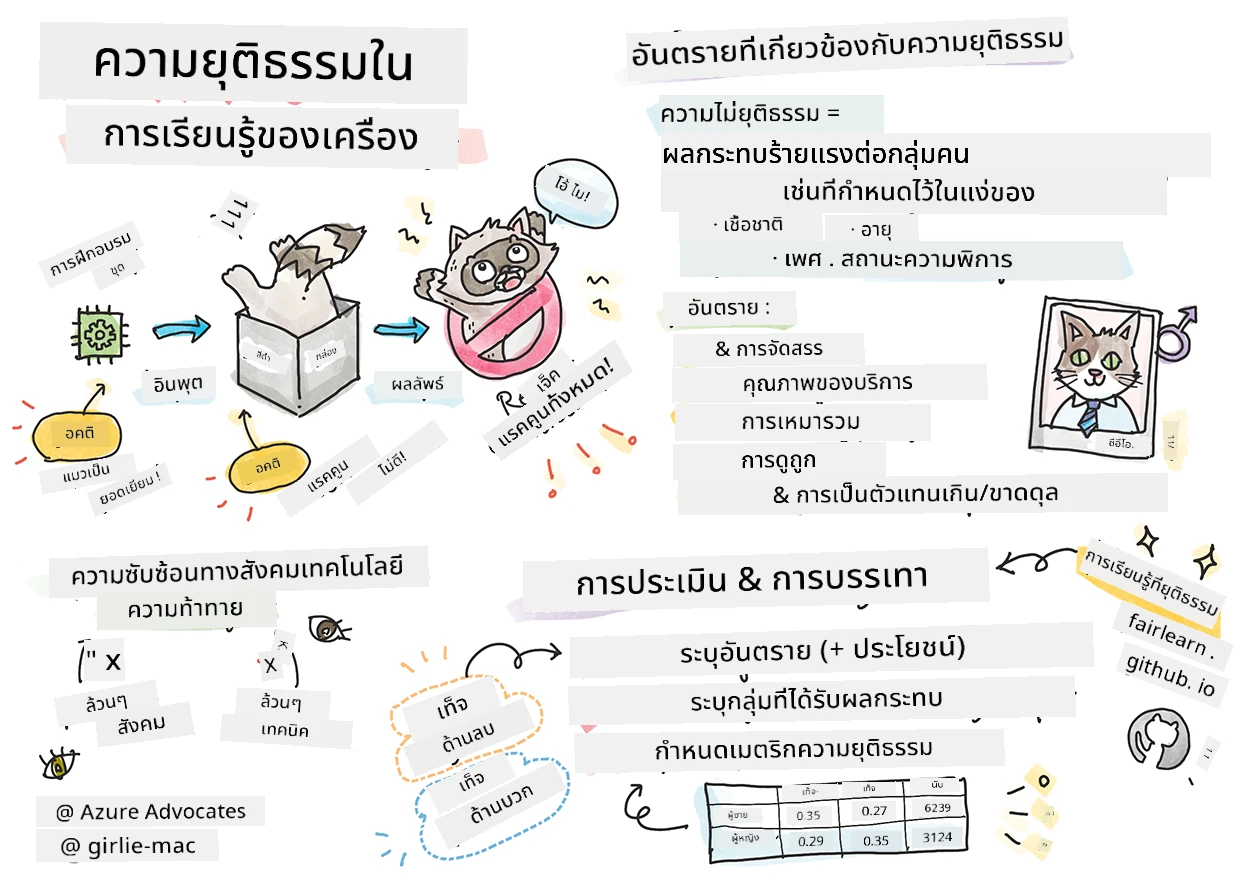
สเก็ตช์โน้ตโดย Tomomi Imura
แบบทดสอบก่อนบทเรียน
บทนำ
ในหลักสูตรนี้ คุณจะเริ่มค้นพบว่า machine learning สามารถและมีผลกระทบต่อชีวิตประจำวันของเราอย่างไร แม้ตอนนี้เอง ระบบและโมเดลมีส่วนร่วมในงานตัดสินใจประจำวัน เช่น การวินิจฉัยดูแลสุขภาพ การอนุมัติสินเชื่อ หรือการตรวจจับการฉ้อโกง ดังนั้นจึงเป็นสิ่งสำคัญที่โมเดลเหล่านี้จะต้องทำงานได้ดีเพื่อให้ผลลัพธ์ที่น่าเชื่อถือ เช่นเดียวกับแอปพลิเคชันซอฟต์แวร์ใด ๆ ระบบ AI ก็อาจไม่เป็นไปตามความคาดหวังหรือมีผลลัพธ์ที่ไม่พึงประสงค์ นั่นคือเหตุผลที่จำเป็นต้องเข้าใจและอธิบายพฤติกรรมของโมเดล AI ได้
ลองจินตนาการดูว่าจะเกิดอะไรขึ้นเมื่อข้อมูลที่คุณใช้สร้างโมเดลนี้ขาดบางกลุ่มประชากร เช่น เชื้อชาติ เพศ มุมมองทางการเมือง ศาสนา หรือเป็นตัวแทนประชากรเหล่านี้ไม่สมดุล แล้วถ้าผลลัพธ์ของโมเดลถูกตีความเพื่อสนับสนุนกลุ่มประชากรบางกลุ่ม ผลลัพธ์จะส่งผลกระทบอย่างไรต่อแอปพลิเคชัน นอกจากนี้จะเกิดอะไรขึ้นเมื่อโมเดลมีผลลัพธ์ที่ไม่พึงประสงค์และเป็นอันตรายต่อคน ใครจะต้องรับผิดชอบต่อพฤติกรรมของระบบ AI เหล่านี้ คำถามเหล่านี้เป็นสิ่งที่เราจะสำรวจในหลักสูตรนี้
ในบทเรียนนี้ คุณจะ:
- เพิ่มความตระหนักรู้เกี่ยวกับความสำคัญของความยุติธรรมใน machine learning และความเสียหายที่เกี่ยวข้องกับความยุติธรรม
- ทำความคุ้นเคยกับการสำรวจข้อมูลที่อยู่นอกกลุ่มและสถานการณ์ที่ไม่ปกติเพื่อความมั่นคงและความปลอดภัย
- เข้าใจความจำเป็นในการเสริมอำนาจให้ทุกคนโดยการออกแบบระบบที่ครอบคลุม
- สำรวจความสำคัญในการปกป้องความเป็นส่วนตัวและความปลอดภัยของข้อมูลและผู้คน
- เห็นความสำคัญของการมีแนวทางกล่องแก้วเพื่ออธิบายพฤติกรรมของโมเดล AI
- ใส่ใจว่าวินัยความรับผิดชอบเป็นสิ่งจำเป็นในการสร้างความไว้วางใจในระบบ AI
ข้อกำหนดเบื้องต้น
เป็นข้อกำหนดเบื้องต้น โปรดเรียนรู้ในเส้นทาง "หลักการ AI ที่รับผิดชอบ" และดูวิดีโอด้านล่างเกี่ยวกับหัวข้อนี้:
เรียนรู้เพิ่มเติมเกี่ยวกับ AI ที่รับผิดชอบโดยติดตาม เส้นทางการเรียนรู้

🎥 คลิกที่ภาพด้านบนเพื่อดูวิดีโอ: แนวทางของ Microsoft ต่อ AI ที่รับผิดชอบ
ความยุติธรรม
ระบบ AI ควรปฏิบัติต่อทุกคนอย่างเป็นธรรมและหลีกเลี่ยงการส่งผลกระทบต่อกลุ่มคนที่คล้ายกันในรูปแบบที่ต่างกัน ตัวอย่างเช่น เมื่อระบบ AI ให้คำแนะนำเกี่ยวกับการรักษาทางการแพทย์ การสมัครสินเชื่อ หรือการจ้างงาน ระบบเหล่านี้ควรให้คำแนะนำเดียวกันกับทุกคนที่มีอาการ คล้ายกัน สถานะทางการเงิน หรือคุณสมบัติทางวิชาชีพแต่ละคนในฐานะมนุษย์ก็มีอคติที่สืบทอดมาต่อการตัดสินใจและการกระทำของเรา อคติเหล่านี้อาจปรากฏชัดในข้อมูลที่เราใช้ฝึกสอนระบบ AI การบิดเบือนดังกล่าวอาจเกิดขึ้นโดยไม่ตั้งใจ บ่อยครั้งมันยากที่จะรู้ตัวเมื่อคุณใส่อคติลงในข้อมูล
“ความไม่เป็นธรรม” รวมถึงผลกระทบด้านลบ หรือ "ความเสียหาย" สำหรับกลุ่มคน ตัวอย่างเช่น กลุ่มที่นิยามตามเชื้อชาติ เพศ อายุ หรือสถานะความพิการ ความเสียหายที่เกี่ยวข้องกับความยุติธรรมสามารถจัดประเภทได้เป็น:
- การจัดสรร หากเพศหรือเชื้อชาติ ตัวอย่างเช่น ได้รับความโปรดปรานมากกว่ากลุ่มอื่น
- คุณภาพของบริการ หากคุณฝึกข้อมูลสำหรับสถานการณ์เฉพาะแต่ความเป็นจริงซับซ้อนกว่านั้นมาก ก็จะนำไปสู่บริการที่มีประสิทธิภาพต่ำ ตัวอย่างเช่น เครื่องกดสบู่ล้างมือที่ดูเหมือนไม่สามารถตรวจจับคนที่มีผิวสีเข้ม อ้างอิง
- การดูถูก การวิจารณ์และติดป้ายอย่างไม่เป็นธรรมต่อตัวสิ่งหรือบุคคล ตัวอย่างเช่น เทคโนโลยีการติดป้ายรูปภาพที่มีชื่อเสียงในทางลบที่ติดป้ายภาพของคนผิวสีเข้มว่าเป็นลิงกอริลลา
- การเป็นตัวแทนเกินหรือขาด คือแนวคิดว่ากลุ่มคนบางกลุ่มไม่ถูกเห็นในวิชาชีพใด ๆ และบริการหรือฟังก์ชันใด ๆ ที่ส่งเสริมสิ่งนั้นจะมีส่วนทำให้เกิดความเสียหาย
- การเหมารวม การสัมพันธ์กลุ่มที่กำหนดกับลักษณะที่ถูกกำหนดไว้ล่วงหน้า ตัวอย่างเช่น ระบบแปลภาษาระหว่างภาษาอังกฤษและตุรกีอาจมีข้อผิดพลาดเนื่องจากคำศัพท์ที่มีการเหมารวมตามเพศ
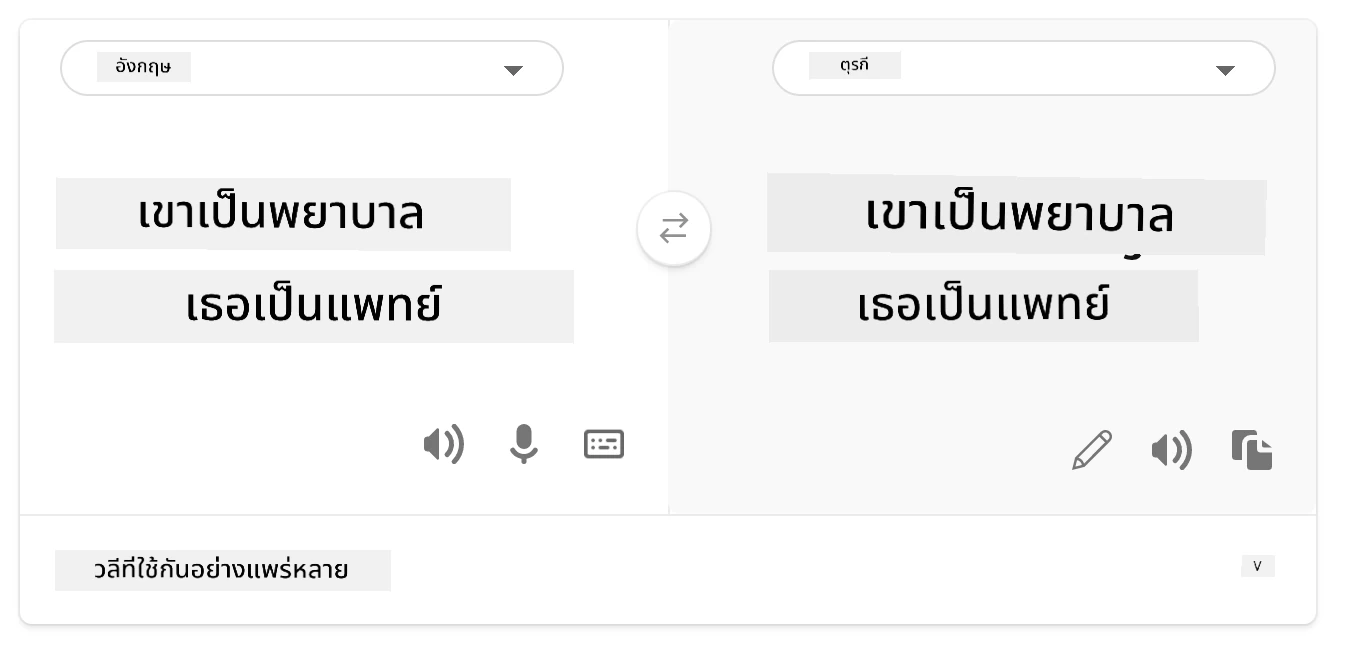
การแปลเป็นภาษาเตอร์กิช
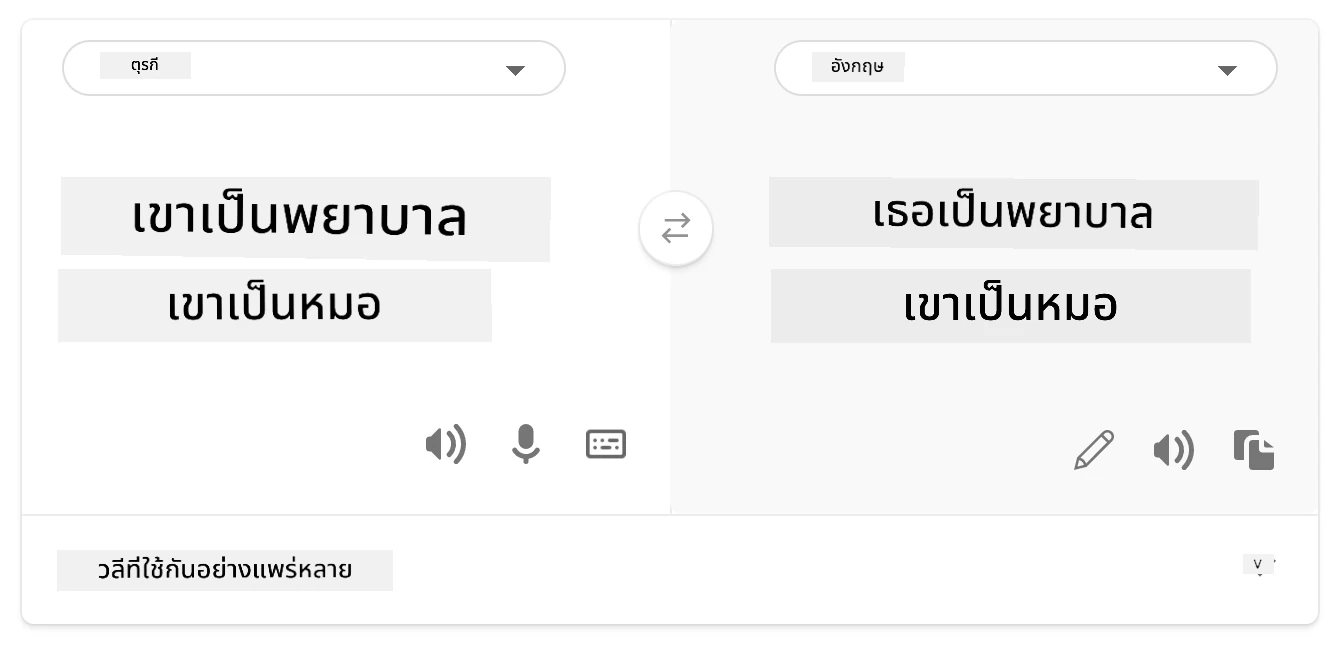
การแปลกลับเป็นภาษาอังกฤษ
เมื่อออกแบบและทดสอบระบบ AI เราต้องมั่นใจว่า AI มีความยุติธรรมและไม่ได้ถูกโปรแกรมให้ตัดสินใจด้วยอคติหรือลำเอียง ซึ่งมนุษย์เองก็ถูกห้ามไม่ให้ทำเช่นนั้น การรับประกันความยุติธรรมใน AI และ machine learning เป็นความท้าทายทางสังคม เทคโนโลยีที่ซับซ้อน
ความน่าเชื่อถือและความปลอดภัย
เพื่อสร้างความไว้วางใจ ระบบ AI จำเป็นต้องเชื่อถือได้ ปลอดภัย และสม่ำเสมอภายใต้สภาวะปกติและไม่คาดคิด เป็นสิ่งสำคัญที่จะรู้ว่าระบบ AI จะทำงานอย่างไรในสถานการณ์ต่าง ๆ โดยเฉพาะอย่างยิ่งเมื่อระบบเผชิญกับข้อมูลตัวอย่างที่ผิดปกติ เมื่อตั้งระบบ AI ต้องให้ความสำคัญอย่างมากกับการจัดการกับสถานการณ์ที่หลากหลายซึ่งระบบ AI อาจเจอ ตัวอย่างเช่น รถยนต์ขับเคลื่อนอัตโนมัติจำเป็นต้องให้ความสำคัญกับความปลอดภัยของผู้คนเป็นลำดับแรก ดังนั้น AI ที่ขับเคลื่อนรถต้องพิจารณาทุกสถานการณ์ที่อาจเกิดขึ้น เช่น เวลากลางคืน พายุฝนฟ้าคะนอง หรือหิมะตก เด็กวิ่งข้ามถนน สัตว์เลี้ยง งานก่อสร้างถนน ฯลฯ ระบบ AI ที่จัดการกับสถานการณ์ที่หลากหลายได้อย่างน่าเชื่อถือและปลอดภัย แสดงให้เห็นถึงระดับการคาดการณ์ที่นักวิทยาศาสตร์ข้อมูลหรือผู้พัฒนา AI ได้พิจารณาระหว่างการออกแบบหรือทดสอบระบบ
🎥 คลิกที่นี่เพื่อดูวิดีโอ: ความน่าเชื่อถือและความปลอดภัยใน AI
ความครอบคลุม
ระบบ AI ควรถูกออกแบบให้มีส่วนร่วมและเสริมอำนาจทุกคน เมื่อนักวิทยาศาสตร์ข้อมูลและผู้พัฒนา AI ออกแบบและนำระบบ AI มาใช้ จะระบุและแก้ไขอุปสรรคที่อาจทำให้บางคนถูกแยกออกโดยไม่ตั้งใจ เช่น มีผู้พิการราว 1 พันล้านคนทั่วโลก ด้วยความก้าวหน้าของ AI พวกเขาสามารถเข้าถึงข้อมูลและโอกาสต่าง ๆ ได้ง่ายขึ้นในชีวิตประจำวัน การแก้ไขอุปสรรคนี้ช่วยสร้างโอกาสในการนวัตกรรมและพัฒนาผลิตภัณฑ์ AI ที่ให้ประสบการณ์ที่ดีกว่าซึ่งเป็นประโยชน์ต่อทุกคน
ความปลอดภัยและความเป็นส่วนตัว
ระบบ AI ควรมีความปลอดภัยและเคารพความเป็นส่วนตัวของผู้คน ผู้คนมีความไว้วางใจน้อยลงในระบบที่เสี่ยงต่อความเป็นส่วนตัว ข้อมูล หรือชีวิตของพวกเขา เมื่อฝึกโมเดล machine learning เราพึ่งพาข้อมูลเพื่อให้ผลลัพธ์ที่ดีที่สุด ในการทำเช่นนี้ ต้องพิจารณาที่มาของข้อมูลและความสมบูรณ์ เช่น ข้อมูลนั้นส่งโดยผู้ใช้หรือเป็นข้อมูลสาธารณะระหว่างทำงานกับข้อมูล จำเป็นต้องพัฒนาระบบ AI ที่สามารถปกป้องข้อมูลที่เป็นความลับและต้านทานการโจมตีได้ เมื่อ AI แพร่หลายมากขึ้น การปกป้องความเป็นส่วนตัวและรักษาความปลอดภัยของข้อมูลส่วนบุคคลและธุรกิจสำคัญยิ่งขึ้นและซับซ้อนมากขึ้น ปัญหาความเป็นส่วนตัวและความปลอดภัยข้อมูลต้องได้รับความสนใจเป็นพิเศษสำหรับ AI เพราะการเข้าถึงข้อมูลเป็นสิ่งจำเป็นสำหรับระบบ AI ในการทำการพยากรณ์และตัดสินใจอย่างถูกต้องและมีข้อมูล
- ในอุตสาหกรรม เราได้ทำความก้าวหน้าที่สำคัญในด้านความเป็นส่วนตัวและความปลอดภัย โดยได้รับแรงสนับสนุนอย่างมากจากข้อบังคับเช่น GDPR (ข้อบังคับคุ้มครองข้อมูลทั่วไป)
- แต่กับระบบ AI เราต้องยอมรับความตึงเครียดระหว่างความจำเป็นในการใช้ข้อมูลส่วนบุคคลมากขึ้นเพื่อทำให้ระบบมีความเป็นส่วนตัวและมีประสิทธิภาพมากขึ้น – กับความเป็นส่วนตัว
- เช่นเดียวกับการเกิดขึ้นของคอมพิวเตอร์ที่เชื่อมต่อกับอินเทอร์เน็ต เราก็เห็นปัญหาด้านความปลอดภัยที่เพิ่มขึ้นอย่างมากที่เกี่ยวข้องกับ AI
- พร้อมกันนั้น เรายังเห็น AI ถูกใช้เพื่อปรับปรุงความปลอดภัยเป็นตัวอย่าง สแกนเนอร์ป้องกันไวรัสสมัยใหม่ส่วนใหญ่นำโดยเทคนิคประมาณการ AI ในปัจจุบัน
- เราต้องทำให้กระบวนการ Data Science ของเราประสานกันอย่างเหมาะสมกับแนวปฏิบัติด้านความเป็นส่วนตัวและความปลอดภัยล่าสุด
ความโปร่งใส
ระบบ AI ควรเข้าใจได้ ส่วนสำคัญของความโปร่งใสคือการอธิบายพฤติกรรมของระบบ AI และส่วนประกอบต่าง ๆ การปรับปรุงความเข้าใจของระบบ AI ต้องการให้ผู้มีส่วนได้เสียเข้าใจว่าเหตุใดและอย่างไรที่ระบบทำงาน เพื่อให้พวกเขาสามารถระบุปัญหาด้านประสิทธิภาพ ความปลอดภัยและความเป็นส่วนตัว อคติ การปฏิบัติที่แยกแยะ หรือผลลัพธ์ที่ไม่ตั้งใจได้ เรายังเชื่อว่าผู้ที่ใช้ระบบ AI ควรซื่อสัตย์และเปิดเผยว่าเมื่อใด ทำไม และอย่างไรที่พวกเขาเลือกที่จะนำระบบเหล่านั้นมาใช้ ตลอดจนข้อจำกัดของระบบเหล่านั้น ตัวอย่างเช่น หากธนาคารใช้ระบบ AI เพื่อสนับสนุนการตัดสินใจสินเชื่อแก่ผู้บริโภค การตรวจสอบผลลัพธ์และทำความเข้าใจว่าข้อมูลใดมีอิทธิพลต่อคำแนะนำของระบบนั้นเป็นสิ่งสำคัญ รัฐบาลเริ่มมีข้อบังคับเกี่ยวกับ AI ในอุตสาหกรรมต่าง ๆ ดังนั้นนักวิทยาศาสตร์ข้อมูลและองค์กรต้องอธิบายว่า ระบบ AI นั้นตรงตามข้อกำหนดทางกฎหมายหรือไม่ โดยเฉพาะอย่างยิ่งเมื่อมีผลลัพธ์ที่ไม่พึงประสงค์
- เนื่องจากระบบ AI ซับซ้อนมาก จึงยากที่จะเข้าใจการทำงานและตีความผลลัพธ์
- การขาดความเข้าใจนี้ส่งผลต่อวิธีการจัดการ การดำเนินงาน และการบันทึกข้อมูลระบบเหล่านี้
- การขาดความเข้าใจนี้โดยเฉพาะส่งผลต่อการตัดสินใจที่ทำโดยใช้ผลลัพธ์ที่ระบบเหล่านี้ผลิตออกมา
ความรับผิดชอบ
ผู้ที่ออกแบบและนำระบบ AI มาใช้ต้องรับผิดชอบต่อการทำงานของระบบของพวกเขา ความจำเป็นในการรับผิดชอบนี้สำคัญอย่างยิ่งกับเทคโนโลยีที่ใช้กับข้อมูลที่อ่อนไหว เช่น การจดจำใบหน้า เมื่อเร็ว ๆ นี้ มีความต้องการใช้เทคโนโลยีการจดจำใบหน้าที่เพิ่มขึ้นอย่างมากโดยเฉพาะจากองค์กรบังคับใช้กฎหมายที่เห็นศักยภาพของเทคโนโลยีนี้ในการใช้งาน เช่น การค้นหาเด็กที่หายตัว อย่างไรก็ตาม เทคโนโลยีเหล่านี้อาจถูกใช้โดยรัฐบาลเพื่อเสี่ยงต่อเสรีภาพพื้นฐานของประชาชน เช่น การเปิดใช้งานการสอดส่องอย่างต่อเนื่องของบุคคลใดบุคคลหนึ่ง ดังนั้น นักวิทยาศาสตร์ข้อมูลและองค์กรต้องรับผิดชอบต่อผลกระทบของระบบ AI ต่อบุคคลหรือสังคม
🎥 คลิกที่ภาพด้านบนเพื่อดูวิดีโอ: คำเตือนเกี่ยวกับการสอดแนมจำนวนมากผ่านการจดจำใบหน้า
สุดท้าย หนึ่งในคำถามที่ใหญ่ที่สุดสำหรับคนในยุคของเราในฐานะรุ่นแรกที่นำ AI เข้าสู่สังคม คือ วิธีการทำให้คอมพิวเตอร์ยังคงรับผิดชอบต่อประชาชน และวิธีการทำให้ผู้ที่ออกแบบคอมพิวเตอร์รับผิดชอบต่ทุกคน
การประเมินผลกระทบ
ก่อนฝึกโมเดล machine learning จำเป็นต้องทำการประเมินผลกระทบเพื่อเข้าใจวัตถุประสงค์ของระบบ AI การใช้งานที่ตั้งใจไว้ ที่ที่จะนำไปใช้ และใครจะใช้งานระบบ เหล่านี้ช่วยให้ผู้ตรวจสอบหรือผู้ทดสอบระบบรู้ว่าควรพิจารณาปัจจัยใดบ้างเมื่อตรวจหาความเสี่ยงและผลที่คาดหวัง
มีข้อควรสนใจดังนี้เมื่อทำการประเมินผลกระทบ:
- ผลกระทบเชิงลบต่อบุคคล การตระหนักถึงข้อจำกัดหรือข้อกำหนด การใช้งานที่ไม่ได้รับการสนับสนุน หรือข้อจำกัดใด ๆ ที่ทราบซึ่งอาจกีดกันประสิทธิภาพระบบ เป็นสิ่งจำเป็นเพื่อให้แน่ใจว่าระบบจะไม่ถูกใช้ในทางที่เป็นอันตรายต่อบุคคล
- ข้อกำหนดข้อมูล การเข้าใจว่าอย่างไรและที่ไหนระบบใช้ข้อมูลช่วยให้ผู้ตรวจสอบสำรวจข้อกำหนดข้อมูลที่ต้องระวัง (เช่น กฎระเบียบ GDPR หรือ HIPAA) นอกจากนี้ตรวจสอบว่าแหล่งที่มาและปริมาณข้อมูลเพียงพอสำหรับการฝึก
- สรุปผลกระทบ รวบรวมรายการความเสียหายที่อาจเกิดขึ้นจากการใช้ระบบ ตลอดวงจรชีวิต ML ให้ทบทวนว่าปัญหาที่ระบุได้รับการบรรเทาหรือแก้ไขแล้วหรือไม่
- เป้าหมายที่ใช้บังคับ สำหรับแต่ละหลักการหลักทั้งหก ให้ประเมินว่าเป้าหมายจากแต่ละหลักการได้รับการตอบสนองหรือไม่ และมีช่องว่างใดบ้าง
การดีบักด้วย AI ที่รับผิดชอบ
เช่นเดียวกับการดีบักแอปพลิเคชันซอฟต์แวร์ การดีบักระบบ AI เป็นกระบวนการที่จำเป็นในการระบุและแก้ไขปัญหาในระบบ มีหลายปัจจัยที่ส่งผลต่อโมเดลไม่ทำงานตามคาดหวังหรือรับผิดชอบ เมตริกประสิทธิภาพโมเดลแบบดั้งเดิมส่วนใหญ่เป็นการสรุปเชิงปริมาณของประสิทธิภาพโมเดล ซึ่งไม่เพียงพอที่จะวิเคราะห์ว่าโมเดลละเมิดหลักการ AI ที่รับผิดชอบอย่างไร นอกจากนี้ โมเดล machine learning เป็นกล่องดำที่ทำให้ยากที่จะเข้าใจว่าปัจจัยใดผลักดันผลลัพธ์ของโมเดลหรือให้คำอธิบายเมื่อโมเดลเกิดข้อผิดพลาด ภายหลังในหลักสูตรนี้ เราจะเรียนรู้วิธีใช้แดชบอร์ด Responsible AI เพื่อช่วยดีบักระบบ AI แดชบอร์ดนี้เป็นเครื่องมือครบวงจรให้นักวิทยาศาสตร์ข้อมูลและผู้พัฒนา AI ใช้ดำเนินการ:
- การวิเคราะห์ข้อผิดพลาด เพื่อระบุการกระจายความผิดพลาดของโมเดลที่สามารถส่งผลต่อความยุติธรรมหรือความน่าเชื่อถือของระบบ
- ภาพรวมของโมเดล เพื่อค้นหาจุดที่มีความแตกต่างในประสิทธิภาพของโมเดลในกลุ่มข้อมูลต่าง ๆ
- การวิเคราะห์ข้อมูล เพื่อเข้าใจการกระจายข้อมูลและระบุอคติที่อาจเกิดขึ้นในข้อมูลซึ่งอาจนำไปสู่ปัญหาความยุติธรรม ความครอบคลุม และความน่าเชื่อถือ
- ความเข้าใจโมเดล เพื่อเข้าใจปัจจัยที่มีผลต่อการทำนายของโมเดล ซึ่งช่วยในการอธิบายพฤติกรรมของโมเดล ซึ่งสำคัญสำหรับความโปร่งใสและความรับผิดชอบ
🚀 ความท้าทาย
เพื่อป้องกันไม่ให้เกิดความเสียหายตั้งแต่แรก เราควร:
- มีความหลากหลายของภูมิหลังและมุมมองในหมู่ผู้ที่ทำงานในระบบ
- ลงทุนในชุดข้อมูลที่สะท้อนความหลากหลายของสังคมของเรา
- พัฒนาวิธีการที่ดีขึ้นตลอดวงจรชีวิต machine learning สำหรับการตรวจจับและแก้ไข AI ที่ไม่มีความรับผิดชอบเมื่อเกิดขึ้น
คิดถึงสถานการณ์ในชีวิตจริงที่ความไม่น่าเชื่อถือของโมเดลเป็นที่เห็นได้ชัดเจนในการสร้างและใช้โมเดล นอกจากนี้เราควรพิจารณาอะไรอีกบ้าง?
แบบทดสอบหลังบทเรียน
ทบทวนและศึกษาด้วยตนเอง
ในบทเรียนนี้ คุณได้เรียนรู้พื้นฐานบางอย่างเกี่ยวกับแนวคิดของความยุติธรรมและความไม่เป็นธรรมใน machine learning
ชมเวิร์กชอปนี้เพื่อเจาะลึกหัวข้อ:
- ในการแสวงหา AI ที่รับผิดชอบ: การนำหลักการสู่การปฏิบัติโดย Besmira Nushi, Mehrnoosh Sameki และ Amit Sharma

🎥 คลิกที่รูปภาพด้านบนเพื่อดูวิดีโอ: RAI Toolbox: กรอบงานแบบโอเพ่นซอร์สสำหรับการสร้าง AI ที่รับผิดชอบ โดย Besmira Nushi, Mehrnoosh Sameki, และ Amit Sharma
นอกจากนี้ อ่าน:
-
ศูนย์ทรัพยากร RAI ของ Microsoft: ทรัพยากร AI ที่รับผิดชอบ – Microsoft AI
-
กลุ่มวิจัย FATE ของ Microsoft: FATE: ความเป็นธรรม ความรับผิดชอบ ความโปร่งใส และจริยธรรมใน AI - Microsoft Research
ชุดเครื่องมือ RAI:
อ่านเกี่ยวกับเครื่องมือ Azure Machine Learning เพื่อรับรองความเป็นธรรม:
งานมอบหมาย
สำรวจชุดเครื่องมือ RAI Toolbox
ปฏิเสธความรับผิดชอบ: เอกสารนี้ได้รับการแปลโดยใช้บริการแปลภาษา AI Co-op Translator ขณะที่เราพยายามให้ความถูกต้อง โปรดทราบว่าการแปลโดยอัตโนมัติอาจมีข้อผิดพลาดหรือความไม่ถูกต้อง เอกสารต้นฉบับในภาษาต้นทางควรถูกพิจารณาเป็นแหล่งข้อมูลที่เชื่อถือได้ สำหรับข้อมูลที่สำคัญ แนะนำให้ใช้การแปลโดยมนุษย์มืออาชีพ เราไม่รับผิดชอบต่อความเข้าใจผิดหรือการตีความที่ผิดพลาดที่เกิดขึ้นจากการใช้การแปลนี้