
17 KiB
Bygga maskininlärningslösningar med ansvarsfull AI
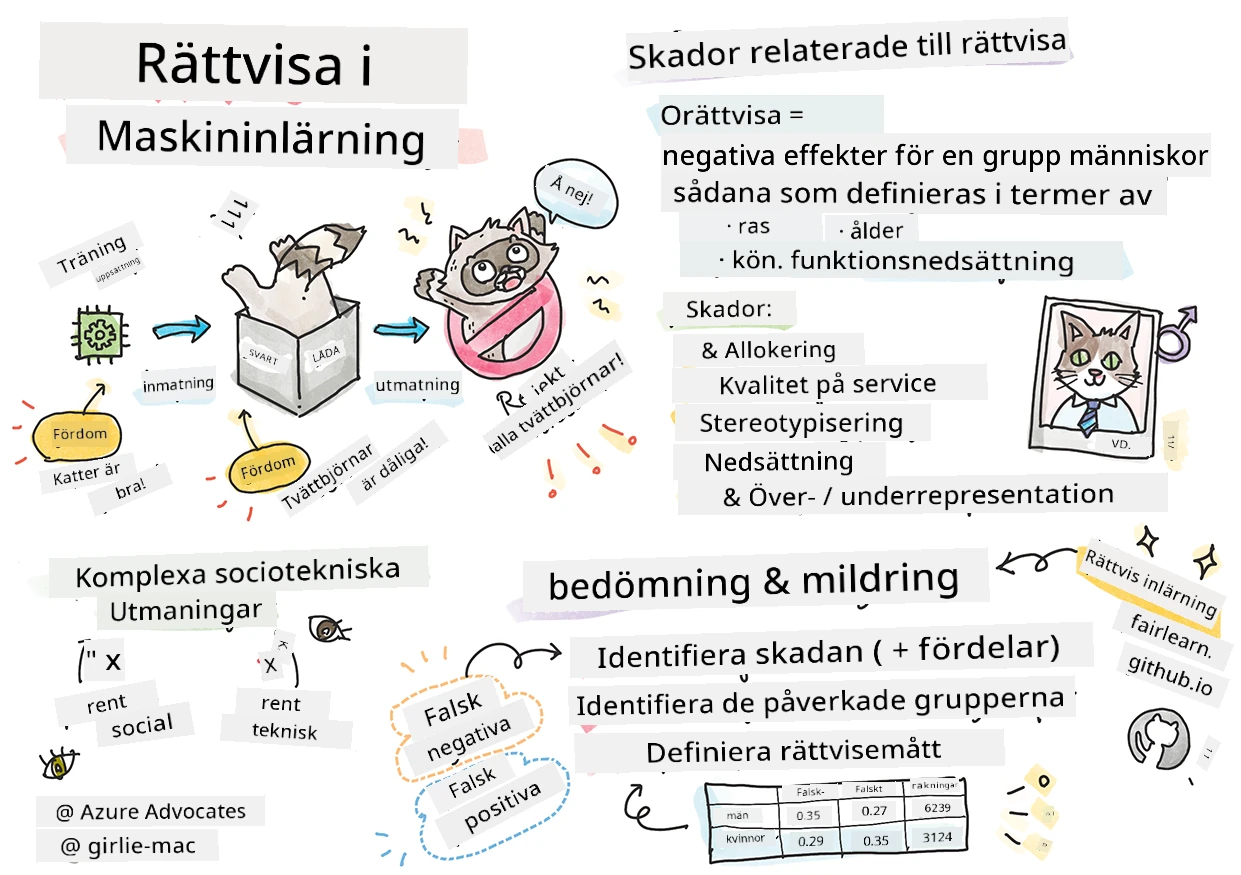
Sketchnote av Tomomi Imura
Förquiz
Introduktion
I denna kursplan kommer du att börja upptäcka hur maskininlärning kan påverka och påverkar våra dagliga liv. Redan nu är system och modeller involverade i dagliga beslutsuppgifter, såsom vårddiagnoser, låneansökningar eller bedrägeribekämpning. Därför är det viktigt att dessa modeller fungerar bra för att ge resultat som går att lita på. Precis som vilken mjukvaruapplikation som helst kommer AI-system att kunna missa förväntningar eller ge oönskade utfall. Därför är det avgörande att kunna förstå och förklara beteendet hos en AI-modell.
Föreställ dig vad som kan hända när datan du använder för att bygga dessa modeller saknar vissa demografiska grupper, såsom ras, kön, politisk åskådning, religion, eller oproportionerligt representerar sådana grupper. Vad händer när modellens output tolkas som att favorisera vissa demografier? Vad blir konsekvensen för applikationen? Dessutom, vad händer när modellen ger ett skadligt utfall som är skadligt för människor? Vem är ansvarig för AI-systemets beteende? Detta är några frågor vi kommer att utforska i denna kursplan.
I denna lektion kommer du att:
- Öka din medvetenhet om vikten av rättvisa i maskininlärning och skador relaterade till rättvisa.
- Bli bekant med praktiken att utforska avvikare och ovanliga scenarier för att säkerställa pålitlighet och säkerhet.
- Få förståelse för behovet att stärka alla genom att designa inkluderande system.
- Utforska hur viktigt det är att skydda integritet och säkerhet för data och människor.
- Se vikten av att ha en "glaslåda"-metod för att förklara AI-modellernas beteende.
- Vara medveten om hur ansvarstagande är avgörande för att bygga förtroende i AI-system.
Förkunskaper
Som förkunskap, ta gärna "Principer för ansvarsfull AI" lärvägen och se videon nedan om ämnet:
Lär dig mer om ansvarsfull AI genom att följa denna Learning Path

🎥 Klicka på bilden ovan för en video: Microsofts tillvägagångssätt för ansvarsfull AI
Rättvisa
AI-system bör behandla alla rättvist och undvika att påverka liknande grupper av människor på olika sätt. Till exempel när AI-system ger vägledning om medicinsk behandling, låneansökningar eller anställning, bör de göra samma rekommendationer till alla med liknande symptom, ekonomiska förhållanden eller yrkeskvalifikationer. Var och en av oss bär påvärkande förutfattade meningar som påverkar våra beslut och handlingar. Dessa bias kan synas i den data som används för att träna AI-system. Sådana manipulationer kan ibland ske oavsiktligt. Det är ofta svårt att medvetet veta när man introducerar bias i data.
"Orättvisa" inkluderar negativa effekter, eller "skador", för en grupp människor, såsom de definierade utifrån ras, kön, ålder eller funktionshindringssstatus. De huvudsakliga rättvise-relaterade skadorna kan klassificeras som:
- Tilldelning, om till exempel ett kön eller en etnicitet favoriseras över en annan.
- Tjänstekvalitet. Om du tränar data för ett specifikt scenario men verkligheten är mycket mer komplex, leder det till en dåligt fungerande tjänst. Till exempel en handtvålsdispenser som inte kunde känna av personer med mörk hud. Referens
- Nedsmakning. Att orättvist kritisera och märka något eller någon negativt. Till exempel, en bildigenkänningsteknologi som ökända felmärkte bilder på mörkhyade personer som gorillor.
- Över- eller undersrepresentation. Idén är att en viss grupp inte ses i ett visst yrke, och någon tjänst eller funktion som fortsätter att främja detta bidrar till skada.
- Stereotyper. Att associera en viss grupp med förutbestämda egenskaper. Till exempel en språköversättningssystem mellan engelska och turkiska kan ha felaktigheter på grund av ord med stereotyper kopplade till kön.
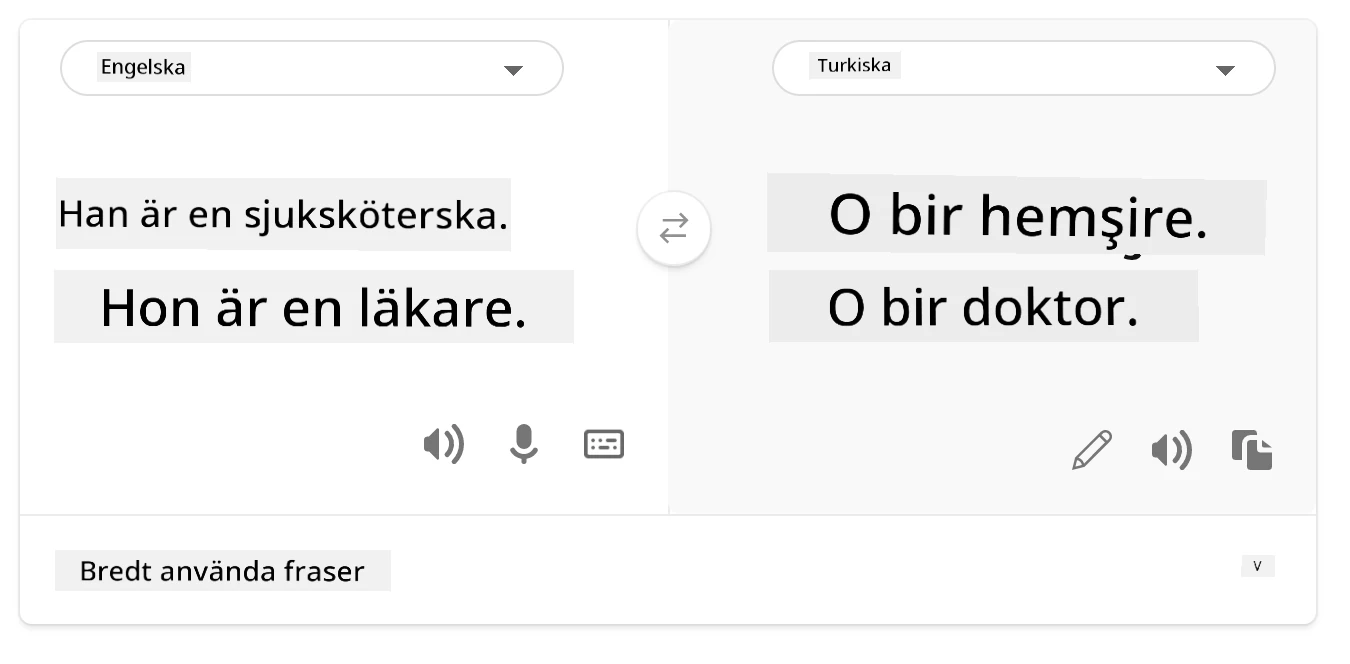
översättning till turkiska
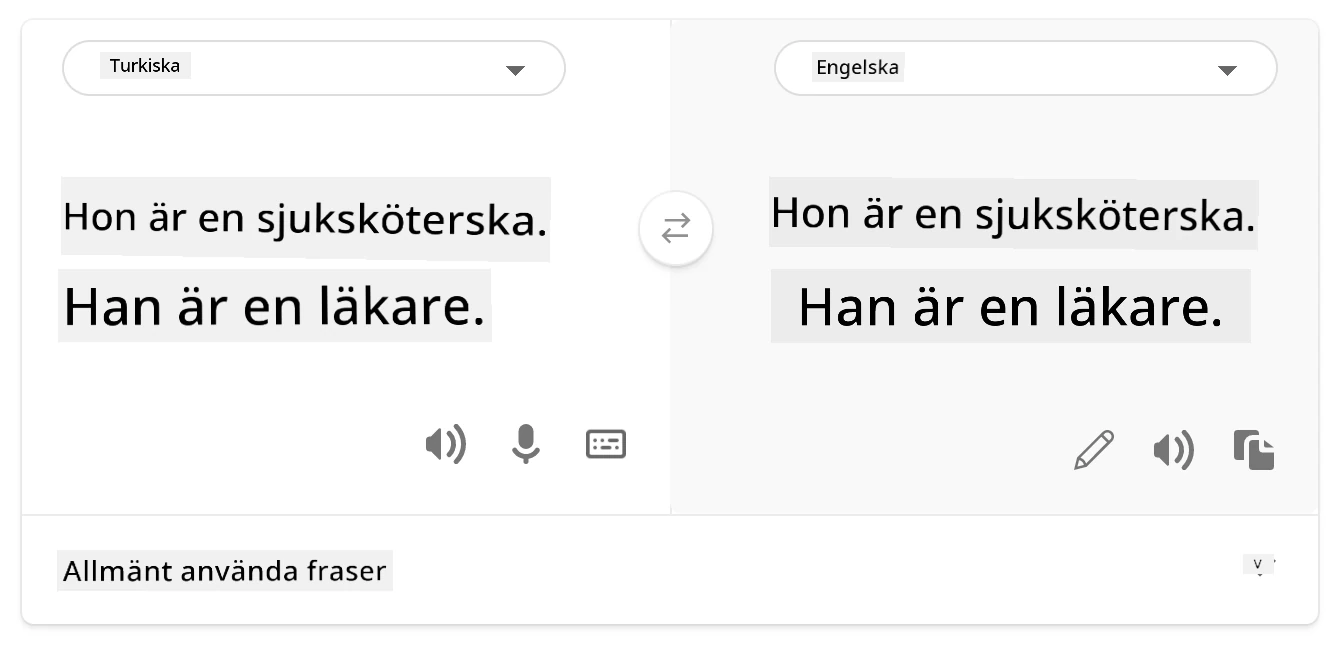
översättning tillbaka till engelska
Vid design och testning av AI-system behöver vi säkerställa att AI är rättvist och inte programmerat att fatta partiska eller diskriminerande beslut, vilket människor också är förbjudna från att göra. Att garantera rättvisa i AI och maskininlärning är fortfarande en komplex socioteknisk utmaning.
Pålitlighet och säkerhet
För att bygga förtroende måste AI-system vara pålitliga, säkra och konsekventa under normala och oväntade förhållanden. Det är viktigt att veta hur AI-system kommer att bete sig i olika situationer, särskilt när det gäller avvikare. När man bygger AI-lösningar måste man lägga stor vikt vid hur man hanterar en mängd olika omständigheter som AI-lösningarna kan stöta på. Till exempel måste en självkörande bil prioritera människors säkerhet högst. Därför måste AI:n som driver bilen beakta alla möjliga scenarier som bilen kan möta, såsom natt, åskväder eller snöstormar, barn som springer över vägen, husdjur, vägbyggen etc. Hur väl ett AI-system kan hantera ett brett spektrum av förhållanden pålitligt och säkert speglar nivån av förutseende som dataforskaren eller AI-utvecklaren tog i beaktande vid design eller testning av systemet.
Inkludering
AI-system bör utformas för att engagera och stärka alla. Vid design och implementering av AI-system identifierar och åtgärdar dataforskare och AI-utvecklare potentiella hinder i systemet som oavsiktligt kan exkludera människor. Till exempel finns det 1 miljard människor med funktionsnedsättningar runt om i världen. Med AI:s framsteg kan de få tillgång till en mängd information och möjligheter mycket lättare i sitt dagliga liv. Genom att hantera dessa hinder skapas möjligheter att innovativt utveckla AI-produkter med bättre upplevelser som gynnar alla.
Säkerhet och integritet
AI-system bör vara säkra och respektera människors integritet. Människor har mindre förtroende för system som äventyrar deras integritet, information eller liv. Vid träning av maskininlärningsmodeller förlitar vi oss på data för att producera bästa resultat. I detta måste datakällan och dess integritet beaktas. Till exempel, var datan användarskickad eller offentligt tillgänglig? Vidare, när man arbetar med data är det avgörande att utveckla AI-system som kan skydda konfidentiell information och motstå attacker. I takt med att AI blir allt vanligare blir skydd av integritet och säkerhet för viktiga person- och företagsuppgifter mer kritiskt och komplext. Integritets- och datasäkerhetsfrågor kräver särskild uppmärksamhet för AI eftersom tillgång till data är väsentligt för att AI-system ska kunna göra exakta och välinformerade förutsägelser och beslut om människor.
- Som bransch har vi gjort stora framsteg inom integritet och säkerhet, mycket drivet av regler som GDPR (Allmän dataskyddsförordning).
- Ändå måste vi med AI-system erkänna spänningen mellan behovet av mer personlig data för att göra systemen mer personliga och effektiva – och integritet.
- Precis som med internets uppkomst och uppkopplade datorer ser vi också en stor ökning av antalet säkerhetsproblem relaterade till AI.
- Samtidigt har vi sett AI användas för att förbättra säkerheten. Som exempel drivs de flesta moderna antivirus-scanners idag av AI-heuristik.
- Vi måste säkerställa att våra data science-processer harmoniskt integreras med de senaste praxis inom integritet och säkerhet.
Transparens
AI-system bör vara begripliga. En avgörande del av transparens är att förklara beteendet hos AI-system och deras komponenter. Förbättrad förståelse av AI-system kräver att intressenter förstår hur och varför de fungerar så att de kan identifiera potentiella prestandaproblem, säkerhets- och integritetsproblem, bias, exkluderande metoder eller oönskade utfall. Vi tror också att de som använder AI-system bör vara ärliga och öppna om när, varför och hur de väljer att använda dem, samt vilka begränsningar systemen har. Till exempel, om en bank använder ett AI-system för att stödja sina konsumentlånebeslut, är det viktigt att granska resultaten och förstå vilken data som påverkar systemets rekommendationer. Regeringar börjar reglera AI över olika branscher, så dataforskare och organisationer måste kunna förklara om ett AI-system uppfyller regleringskrav, särskilt då det finns oönskade utfall.
- Eftersom AI-system är så komplexa är det svårt att förstå hur de fungerar och tolka resultaten.
- Denna brist på förståelse påverkar hur dessa system hanteras, operativsätts och dokumenteras.
- Denna brist på förståelse påverkar viktigare besluten som fattas med hjälp av resultaten dessa system producerar.
Ansvar
De som designar och lanserar AI-system måste vara ansvariga för hur deras system fungerar. Behovet av ansvarstagande är särskilt viktigt för känslig användning som ansiktsigenkänning. På senare tid har efterfrågan på ansiktsigenkänningsteknologi ökat, särskilt från brottsbekämpande myndigheter som ser teknikens potential i användningar som att hitta försvunna barn. Dessa teknologier skulle dock potentiellt kunna användas av en regering för att sätta medborgarnas grundläggande friheter i riskzonen, till exempel genom att möjliggöra kontinuerlig övervakning av specifika individer. Därför behöver dataforskare och organisationer vara ansvariga för hur deras AI-system påverkar individer eller samhället.
🎥 Klicka på bilden ovan för en video: Varningar om massövervakning genom ansiktsigenkänning
I slutändan är en av de största frågorna för vår generation, som den första generationen som för AI till samhället, hur vi ska säkerställa att datorer förblir ansvariga inför människor och hur vi ska säkerställa att de som designar datorer förblir ansvariga inför alla andra.
Påverkansbedömning
Innan du tränar en maskininlärningsmodell är det viktigt att genomföra en påverkansbedömning för att förstå syftet med AI-systemet; vad den tänkta användningen är; var det ska användas; och vem som kommer interagera med systemet. Detta är hjälpsamt för granskare eller testare som utvärderar systemet att veta vilka faktorer de ska ta hänsyn till vid identifiering av potentiella risker och förväntade konsekvenser.
Följande är fokusområden vid genomförande av en påverkansbedömning:
- Negativ påverkan på individer. Att vara medveten om eventuella begränsningar eller krav, otillåten användning eller kända begränsningar som hindrar systemets prestanda är avgörande för att säkerställa att systemet inte används på ett sätt som kan skada individer.
- Datakrav. Att få en förståelse för hur och var systemet kommer att använda data gör det möjligt för granskare att undersöka eventuella datakrav som man behöver ta hänsyn till (t.ex. GDPR- eller HIPAA-regler). Dessutom undersöka om källa eller mängd av data är tillräcklig för träning.
- Sammanfattning av påverkan. Samla en lista över potentiella skador som kan uppstå vid användning av systemet. Under hela ML-livscykeln, granska om de identifierade problemen mildras eller åtgärdas.
- Tillämpliga mål för var och en av de sex kärnprinciperna. Utvärdera om målen från varje princip uppfylls och om det finns några luckor.
Felsökning med ansvarsfull AI
Precis som vid felsökning av en mjukvaruapplikation är felsökning av ett AI-system en nödvändig process för att identifiera och lösa problem i systemet. Det finns många faktorer som kan påverka att en modell inte presterar som förväntat eller ansvarsfullt. De flesta traditionella mått på modellprestanda är kvantitativa sammanlagda mått på modellens prestation, vilket inte är tillräckligt för att analysera hur en modell bryter mot principerna för ansvarsfull AI. Dessutom är en maskininlärningsmodell en svart låda som gör det svårt att förstå vad som driver dess resultat eller ge förklaring när den gör ett misstag. Senare i denna kurs kommer vi att lära oss hur man använder Responsible AI-instrumentpanelen för att felsöka AI-system. Instrumentpanelen erbjuder ett helhetsverktyg för dataforskare och AI-utvecklare att utföra:
- Felanalyser. För att identifiera felens fördelning i modellen som kan påverka systemets rättvisa eller pålitlighet.
- Modellöversikt. För att upptäcka var det finns skillnader i modellens prestanda över olika datakoherter.
- Dataanalys. För att förstå datadistributionen och identifiera eventuell bias i data som kan leda till frågor kring rättvisa, inkludering och pålitlighet.
- Modellförklarbarhet. För att förstå vad som påverkar eller styr modellens förutsägelser. Detta hjälper till att förklara modellens beteende, vilket är viktigt för transparens och ansvarstagande.
🚀 Utmaning
För att förhindra att skador uppstår från början borde vi:
- ha en mångfald av bakgrunder och perspektiv bland de som arbetar med systemen
- investera i dataset som speglar vår samhälls mångfald
- utveckla bättre metoder under hela maskininlärningslivscykeln för att upptäcka och rätta till ansvars- och AI-relaterade brister när de uppstår
Tänk på verkliga scenarier där en modells opålitlighet är uppenbar vid modellbygge och användning. Vad mer bör vi beakta?
Efter-quiz
Granskning & Självstudier
I denna lektion har du lärt dig grunderna i begreppen rättvisa och orättvisa inom maskininlärning.
Titta på denna workshop för att fördjupa dig i ämnena:
- Mot ansvarsfull AI: Förverkliga principer i praktiken av Besmira Nushi, Mehrnoosh Sameki och Amit Sharma

🎥 Klicka på bilden ovan för en video: RAI Toolbox: Ett open-source ramverk för att bygga ansvarsfull AI av Besmira Nushi, Mehrnoosh Sameki och Amit Sharma
Läs också:
-
Microsofts RAI resurscenter: Responsible AI Resources – Microsoft AI
-
Microsofts FATE forskargrupp: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Läs om Azure Machine Learnings verktyg för att säkerställa rättvisa:
Uppgift
Ansvarsfriskrivning: Detta dokument har översatts med hjälp av AI-översättningstjänsten Co-op Translator. Även om vi strävar efter noggrannhet, var vänlig notera att automatiska översättningar kan innehålla fel eller brister. Det ursprungliga dokumentet på dess modersmål bör betraktas som den auktoritativa källan. För kritisk information rekommenderas professionell mänsklig översättning. Vi ansvarar inte för några missförstånd eller feltolkningar som uppstår till följd av användningen av denna översättning.