
32 KiB
Δημιουργήστε ένα μοντέλο παλινδρόμησης χρησιμοποιώντας το Scikit-learn: προετοιμάστε και οπτικοποιήστε δεδομένα
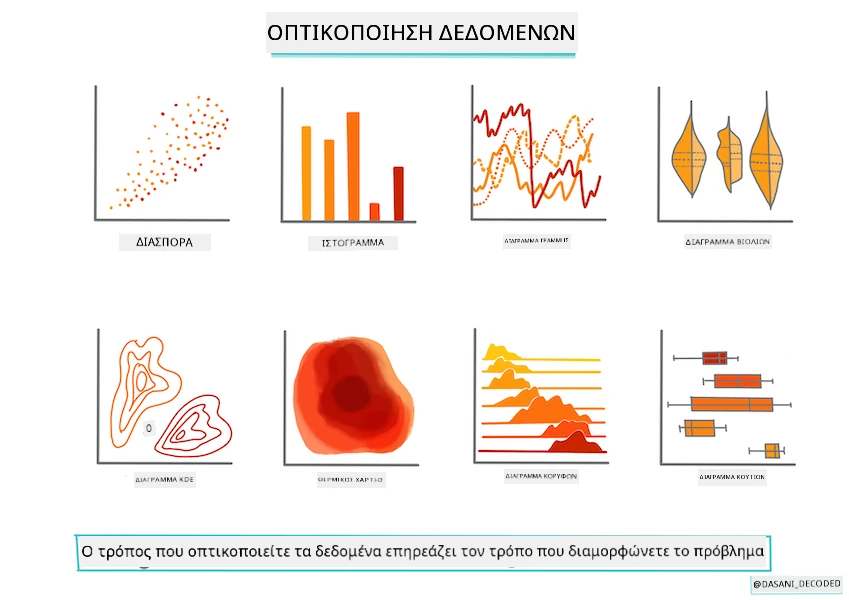
Ενημερωτική εικόνα από τον/την Dasani Madipalli
Προ της διάλεξης κουίζ
Αυτό το μάθημα είναι διαθέσιμο και σε R!
Εισαγωγή
Τώρα που έχετε εξοπλιστεί με τα εργαλεία που χρειάζεστε για να ξεκινήσετε την κατασκευή μοντέλων μηχανικής μάθησης με το Scikit-learn, είστε έτοιμοι να αρχίσετε να κάνετε ερωτήσεις στα δεδομένα σας. Καθώς εργάζεστε με δεδομένα και εφαρμόζετε λύσεις ML, είναι πολύ σημαντικό να κατανοήσετε πώς να κάνετε τη σωστή ερώτηση για να ξεκλειδώσετε σωστά τις δυνατότητες του συνόλου δεδομένων σας.
Σε αυτό το μάθημα, θα μάθετε:
- Πώς να προετοιμάσετε τα δεδομένα σας για την κατασκευή μοντέλου.
- Πώς να χρησιμοποιήσετε το Matplotlib για οπτικοποίηση δεδομένων.
- Πώς να χρησιμοποιήσετε το Seaborn για πιο εκφραστική οπτικοποίηση δεδομένων.
Να κάνετε τη σωστή ερώτηση για τα δεδομένα σας
Η ερώτηση που χρειάζεστε να απαντηθεί θα καθορίσει τον τύπο των αλγορίθμων ML που θα χρησιμοποιήσετε. Και η ποιότητα της απάντησης που θα λάβετε θα εξαρτηθεί σε μεγάλο βαθμό από τη φύση των δεδομένων σας.
Ρίξτε μια ματιά στα δεδομένα που παρέχονται για αυτό το μάθημα. Μπορείτε να ανοίξετε αυτό το αρχείο .csv στο VS Code. Μια γρήγορη ματιά δείχνει αμέσως ότι υπάρχουν κενά και ένας συνδυασμός χαρακτήρων και αριθμητικών δεδομένων. Υπάρχει επίσης μια παράξενη στήλη που ονομάζεται 'Package', όπου τα δεδομένα είναι ένας συνδυασμός μεταξύ 'sacks', 'bins' και άλλων τιμών. Τα δεδομένα, στην πραγματικότητα, είναι λίγο μπερδεμένα.
🎥 Κάντε κλικ στην παραπάνω εικόνα για ένα σύντομο βίντεο που δείχνει την προετοιμασία των δεδομένων για αυτό το μάθημα.
Στην πραγματικότητα, δεν είναι πολύ συνηθισμένο να σας δίνονται δεδομένα που είναι έτοιμα να χρησιμοποιηθούν κατευθείαν για τη δημιουργία ενός μοντέλου ML. Σε αυτό το μάθημα, θα μάθετε πώς να προετοιμάζετε ένα ακατέργαστο σύνολο δεδομένων χρησιμοποιώντας τυπικές βιβλιοθήκες Python. Θα μάθετε επίσης διάφορες τεχνικές για να οπτικοποιήσετε τα δεδομένα.
Μελέτη περίπτωσης: 'η αγορά κολοκύθας'
Σε αυτόν τον φάκελο θα βρείτε ένα αρχείο .csv στο βασικό φάκελο data με το όνομα US-pumpkins.csv που περιλαμβάνει 1757 γραμμές δεδομένων για την αγορά κολοκύθας, ταξινομημένα ανά πόλη. Αυτά είναι ακατέργαστα δεδομένα που εξήχθησαν από τις Ειδικές Αναφορές των Χονδρεμπόρων Αγροτικών Προϊόντων που διανέμονται από το Υπουργείο Γεωργίας των Ηνωμένων Πολιτειών.
Προετοιμασία δεδομένων
Αυτά τα δεδομένα βρίσκονται στο δημόσιο τομέα. Μπορούν να ληφθούν σε πολλά ξεχωριστά αρχεία, ανά πόλη, από τον ιστότοπο του USDA. Για να αποφύγουμε πολλά ξεχωριστά αρχεία, έχουμε συγχωνεύσει όλα τα δεδομένα των πόλεων σε ένα υπολογιστικό φύλλο, έτσι έχουμε ήδη προετοιμάσει λίγο τα δεδομένα. Στη συνέχεια, ας ρίξουμε μια πιο προσεκτική ματιά στα δεδομένα.
Τα δεδομένα της κολοκύθας - πρώτα συμπεράσματα
Τι παρατηρείτε σχετικά με αυτά τα δεδομένα; Έχετε ήδη δει ότι υπάρχει ένας συνδυασμός χαρακτήρων, αριθμών, κενών και περίεργων τιμών που πρέπει να ερμηνεύσετε.
Τι ερώτηση μπορείτε να κάνετε για αυτά τα δεδομένα, χρησιμοποιώντας τεχνική Παλινδρόμησης; Τι θα λέγατε για "Πρόβλεψη της τιμής μιας κολοκύθας προς πώληση κατά τη διάρκεια ενός συγκεκριμένου μήνα"; Κοιτώντας ξανά τα δεδομένα, υπάρχουν κάποιες αλλαγές που πρέπει να κάνετε ώστε να δημιουργήσετε τη δομή δεδομένων που απαιτείται για αυτήν την εργασία.
Άσκηση - αναλύστε τα δεδομένα της κολοκύθας
Ας χρησιμοποιήσουμε το Pandas (το όνομα σημαίνει Python Data Analysis), ένα πολύ χρήσιμο εργαλείο για τη μορφοποίηση δεδομένων, για να αναλύσουμε και να προετοιμάσουμε αυτά τα δεδομένα κολοκύθας.
Πρώτα, ελέγξτε για λείπουνες ημερομηνίες
Πρώτα πρέπει να πάρετε μέτρα για να ελέγξετε αν λείπουν ημερομηνίες:
- Μετατρέψτε τις ημερομηνίες σε μορφή μήνα (οι ημερομηνίες είναι αμερικανικές, οπότε η μορφή είναι
MM/DD/YYYY). - Εξαγάγετε τον μήνα σε μια νέα στήλη.
Ανοίξτε το αρχείο notebook.ipynb στο Visual Studio Code και εισάγετε το υπολογιστικό φύλλο σε ένα νέο dataframe του Pandas.
-
Χρησιμοποιήστε τη συνάρτηση
head()για να δείτε τις πρώτες πέντε γραμμές.import pandas as pd pumpkins = pd.read_csv('../data/US-pumpkins.csv') pumpkins.head()✅ Ποια συνάρτηση θα χρησιμοποιούσατε για να δείτε τις τελευταίες πέντε γραμμές;
-
Ελέγξτε αν υπάρχουν κενά δεδομένα στο τρέχον dataframe:
pumpkins.isnull().sum()Υπάρχουν κενά δεδομένα, αλλά ίσως να μην έχουν σημασία για την εργασία αυτή.
-
Για να κάνετε το dataframe πιο εύκολο στη χρήση, επιλέξτε μόνο τις στήλες που χρειάζεστε, χρησιμοποιώντας τη συνάρτηση
locη οποία εξάγει από το αρχικό dataframe μια ομάδα γραμμών (περασμένη ως πρώτη παράμετρος) και στηλών (περασμένη ως δεύτερη παράμετρος). Η έκφραση:στην παρακάτω περίπτωση σημαίνει "όλες οι γραμμές".columns_to_select = ['Package', 'Low Price', 'High Price', 'Date'] pumpkins = pumpkins.loc[:, columns_to_select]
Δεύτερον, προσδιορίστε τη μέση τιμή της κολοκύθας
Σκεφτείτε πώς να προσδιορίσετε τη μέση τιμή μιας κολοκύθας σε έναν συγκεκριμένο μήνα. Ποιες στήλες θα επιλέγατε για αυτήν την εργασία; Υπόδειξη: θα χρειαστείτε 3 στήλες.
Λύση: πάρτε το μέσο όρο των στηλών Low Price και High Price για να γεμίσετε τη νέα στήλη Τιμή, και μετατρέψτε τη στήλη Ημερομηνία έτσι ώστε να δείχνει μόνο τον μήνα. Ευτυχώς, σύμφωνα με τον παραπάνω έλεγχο, δεν υπάρχουν κενά δεδομένα για τις ημερομηνίες ή τις τιμές.
-
Για να υπολογίσετε το μέσο όρο, προσθέστε τον ακόλουθο κώδικα:
price = (pumpkins['Low Price'] + pumpkins['High Price']) / 2

month = pd.DatetimeIndex(pumpkins['Date']).month
✅ Μπορείτε να εκτυπώσετε οποιαδήποτε δεδομένα θέλετε να ελέγξετε χρησιμοποιώντας
print(month). -
Τώρα, αντιγράψτε τα μετατρεπόμενα δεδομένα σας σε ένα νέο dataframe του Pandas:
new_pumpkins = pd.DataFrame({'Month': month, 'Package': pumpkins['Package'], 'Low Price': pumpkins['Low Price'],'High Price': pumpkins['High Price'], 'Price': price})Η εκτύπωση του dataframe σας θα δείξει ένα καθαρό, τακτοποιημένο σύνολο δεδομένων πάνω στο οποίο μπορείτε να χτίσετε το νέο σας μοντέλο παλινδρόμησης.
Αλλά περιμένετε! Υπάρχει κάτι παράξενο εδώ
Αν κοιτάξετε τη στήλη Package, οι κολοκύθες πωλούνται σε πολλές διαφορετικές διαμορφώσεις. Κάποιες πωλούνται σε μετρήσεις '1 1/9 bushel' και κάποιες σε '1/2 bushel', κάποιες ανά κολοκύθα, κάποιες ανά λίβρα και κάποιες σε μεγάλες κούτες με διαφορετικά πλάτη.
Φαίνεται πολύ δύσκολο να ζυγίσεις τις κολοκύθες με συνέπεια
Βαθύτερη ανάλυση των αρχικών δεδομένων δείχνει ότι οτιδήποτε με Unit of Sale ίσο με 'EACH' ή 'PER BIN' έχει επίσης τον τύπο Package ανά ίντσα, ανά κουτί ή 'καθένα'. Φαίνεται ότι οι κολοκύθες είναι πολύ δύσκολο να ζυγιστούν ομοιόμορφα, οπότε φιλτράρουμε επιλέγοντας μόνο τις κολοκύθες με τη λέξη 'bushel' στη στήλη Package.
-
Προσθέστε ένα φίλτρο στην κορυφή του αρχείου, κάτω από την αρχική εισαγωγή .csv:
pumpkins = pumpkins[pumpkins['Package'].str.contains('bushel', case=True, regex=True)]Αν εκτυπώσετε τα δεδομένα τώρα, μπορείτε να δείτε ότι λαμβάνετε μόνο τις περίπου 415 γραμμές δεδομένων που περιέχουν κολοκύθες ανά bushel.
Αλλά περιμένετε! Υπάρχει ακόμα ένα πράγμα να κάνετε
Παρατηρήσατε ότι η ποσότητα του bushel διαφέρει ανά γραμμή; Πρέπει να ομαλοποιήσετε τις τιμές, ώστε να δείχνετε την τιμή ανά bushel, οπότε κάντε κάποιους υπολογισμούς για να το τυποποιήσετε.
-
Προσθέστε αυτές τις γραμμές μετά το μπλοκ που δημιουργεί το νέο dataframe new_pumpkins:
new_pumpkins.loc[new_pumpkins['Package'].str.contains('1 1/9'), 'Price'] = price/(1 + 1/9)

new_pumpkins.loc[new_pumpkins['Package'].str.contains('1/2'), 'Price'] = price/(1/2)
✅ Σύμφωνα με το The Spruce Eats, το βάρος ενός bushel εξαρτάται από τον τύπο του προϊόντος, καθώς είναι μέτρηση όγκου. "Ένα bushel ντομάτες, για παράδειγμα, υποτίθεται ότι ζυγίζει 56 λίβρες... Τα φύλλα και τα χόρτα καταλαμβάνουν περισσότερο χώρο με λιγότερο βάρος, οπότε ένα bushel σπανάκι ζυγίζει μόνο 20 λίβρες." Όλα αυτά είναι αρκετά περίπλοκα! Ας μην ασχοληθούμε με μετατροπή bushel-σε-λίβρα, αλλά ας τιμολογήσουμε ανά bushel. Όλη αυτή η μελέτη για τα bushels κολοκύθας, όμως, δείχνει πόσο σημαντικό είναι να κατανοήσετε τη φύση των δεδομένων σας!
Τώρα, μπορείτε να αναλύσετε την τιμολόγηση ανά μονάδα βάσει του μέτρηματός τους σε bushel. Αν εκτυπώσετε ξανά τα δεδομένα, μπορείτε να δείτε πώς έχουν τυποποιηθεί.
✅ Παρατηρήσατε ότι οι κολοκύθες που πωλούνται ως μισό bushel είναι πολύ ακριβές; Μπορείτε να καταλάβετε γιατί; Υπόδειξη: οι μικρές κολοκύθες είναι πολύ πιο ακριβές από τις μεγάλες, πιθανώς επειδή υπάρχουν πολύ περισσότερες από αυτές ανά bushel, λόγω του αχρησιμοποίητου χώρου που καταλαμβάνει μία μεγάλη κολοκύθα-πίτα.
Στρατηγικές Οπτικοποίησης
Μέρος του ρόλου του επιστήμονα δεδομένων είναι να αποδείξει την ποιότητα και τη φύση των δεδομένων με τα οποία εργάζεται. Για να το κάνουν αυτό, συχνά δημιουργούν ενδιαφέρουσες οπτικοποιήσεις, ή γραφήματα, διαγράμματα και πίνακες, που δείχνουν διαφορετικές πλευρές των δεδομένων. Με αυτόν τον τρόπο, μπορούν να δείξουν οπτικά σχέσεις και κενά που αλλιώς είναι δύσκολο να ανακαλυφθούν.
🎥 Κάντε κλικ στην παραπάνω εικόνα για ένα σύντομο βίντεο που δείχνει την οπτικοποίηση των δεδομένων για αυτό το μάθημα.
Οι οπτικοποιήσεις μπορούν επίσης να βοηθήσουν στον καθορισμό της πιο κατάλληλης τεχνικής μηχανικής μάθησης για τα δεδομένα. Ένα διάγραμμα διασποράς που φαίνεται να ακολουθεί μια γραμμή, για παράδειγμα, δείχνει ότι τα δεδομένα είναι καλός υποψήφιος για άσκηση γραμμικής παλινδρόμησης.
Μια βιβλιοθήκη οπτικοποίησης δεδομένων που λειτουργεί καλά σε σημειωματάρια Jupyter είναι το Matplotlib (το οποίο είδατε επίσης στο προηγούμενο μάθημα).
Αποκτήστε περισσότερη εμπειρία με την οπτικοποίηση δεδομένων σε αυτά τα tutorial.
Άσκηση - πειραματιστείτε με το Matplotlib
Προσπαθήστε να δημιουργήσετε μερικά βασικά διαγράμματα για να εμφανίσετε το νέο dataframe που μόλις δημιουργήσατε. Τι θα έδειχνε ένα βασικό διάγραμμα γραμμής;
-
Εισάγετε το Matplotlib στην κορυφή του αρχείου, κάτω από την εισαγωγή του Pandas:
import matplotlib.pyplot as plt -
Εκτελέστε ξανά ολόκληρο το σημειωματάριο για ανανέωση.
-
Στο κάτω μέρος του σημειωματάριου, προσθέστε ένα κελί για να σχεδιάσετε τα δεδομένα ως κουτί:
price = new_pumpkins.Price
month = new_pumpkins.Month
plt.scatter(price, month)
plt.show()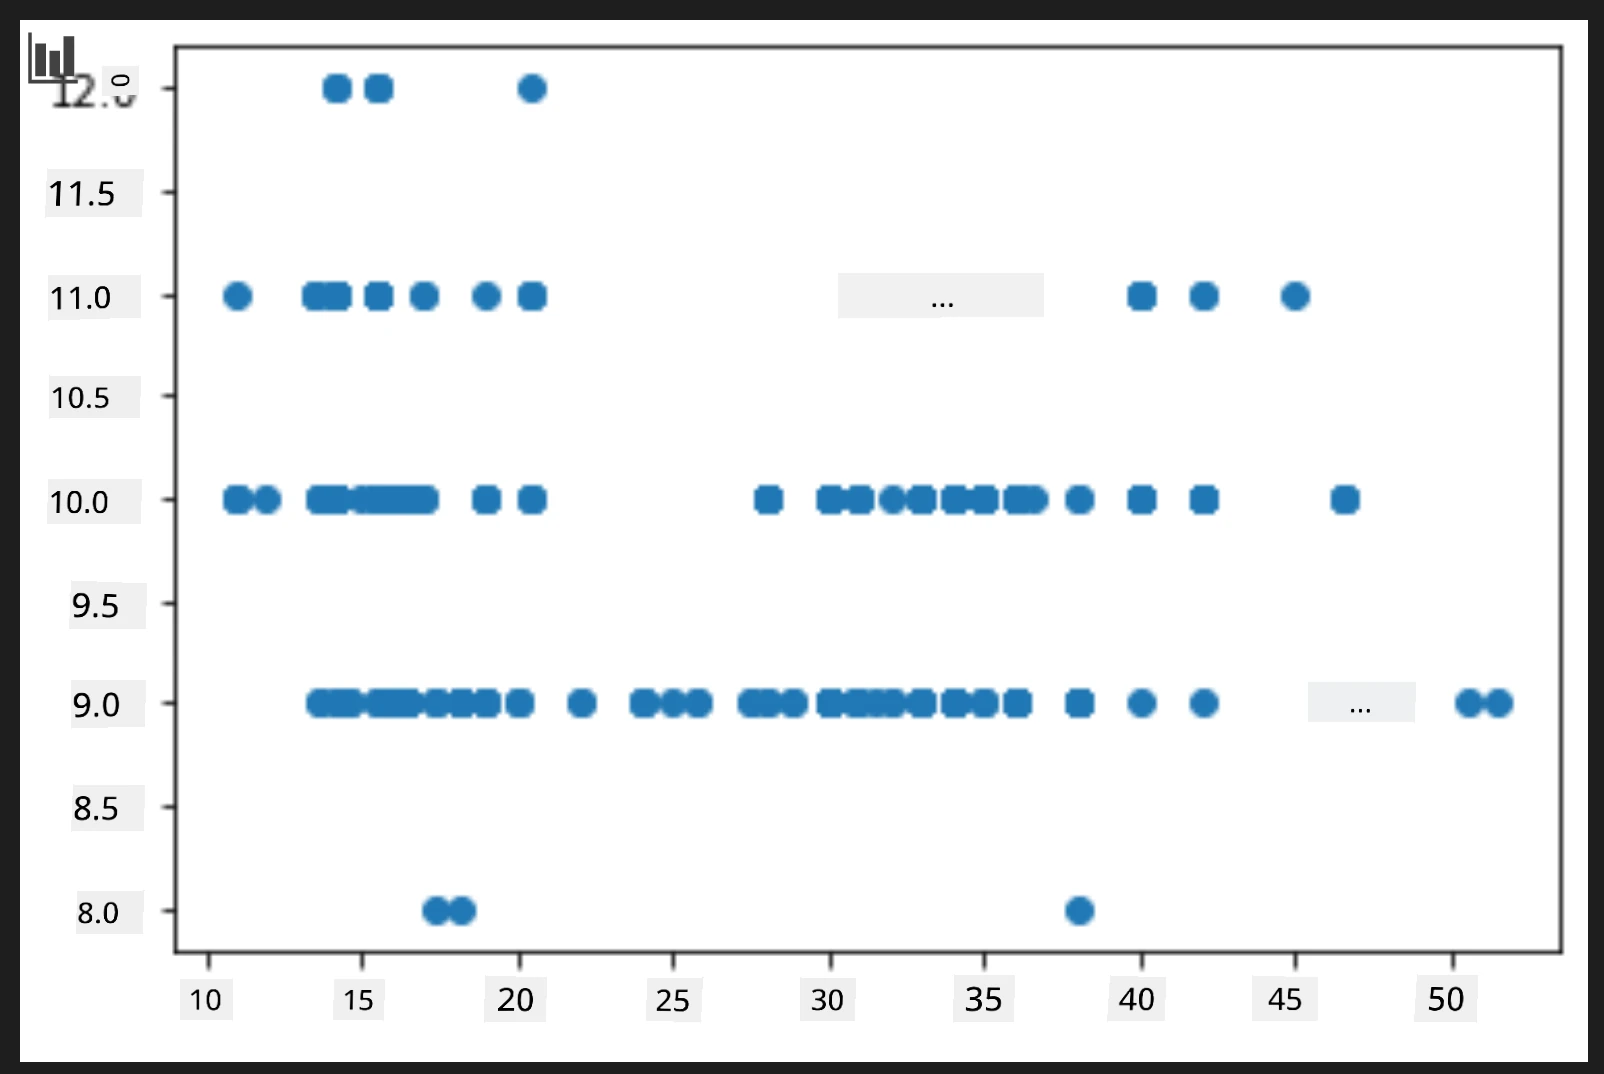
Είναι αυτό ένα χρήσιμο διάγραμμα; Σας εκπλήσσει κάτι σε αυτό;
Δεν είναι ιδιαίτερα χρήσιμο καθώς απλά εμφανίζει τα δεδομένα σας ως μια διασπορά σημείων σε έναν συγκεκριμένο μήνα.
Κάντε το χρήσιμο
Για να εμφανίσετε χρήσιμα δεδομένα στα διαγράμματα, συνήθως πρέπει να ομαδοποιήσετε τα δεδομένα με κάποιο τρόπο. Ας δοκιμάσουμε να δημιουργήσουμε ένα διάγραμμα όπου ο άξονας y δείχνει τους μήνες και τα δεδομένα δείχνουν την κατανομή τους.
-
Προσθέστε ένα κελί για να δημιουργήσετε ένα ομαδοποιημένο ραβδόγραμμα:
new_pumpkins.groupby(['Month'])['Price'].mean().plot(kind='bar')
plt.ylabel("Pumpkin Price")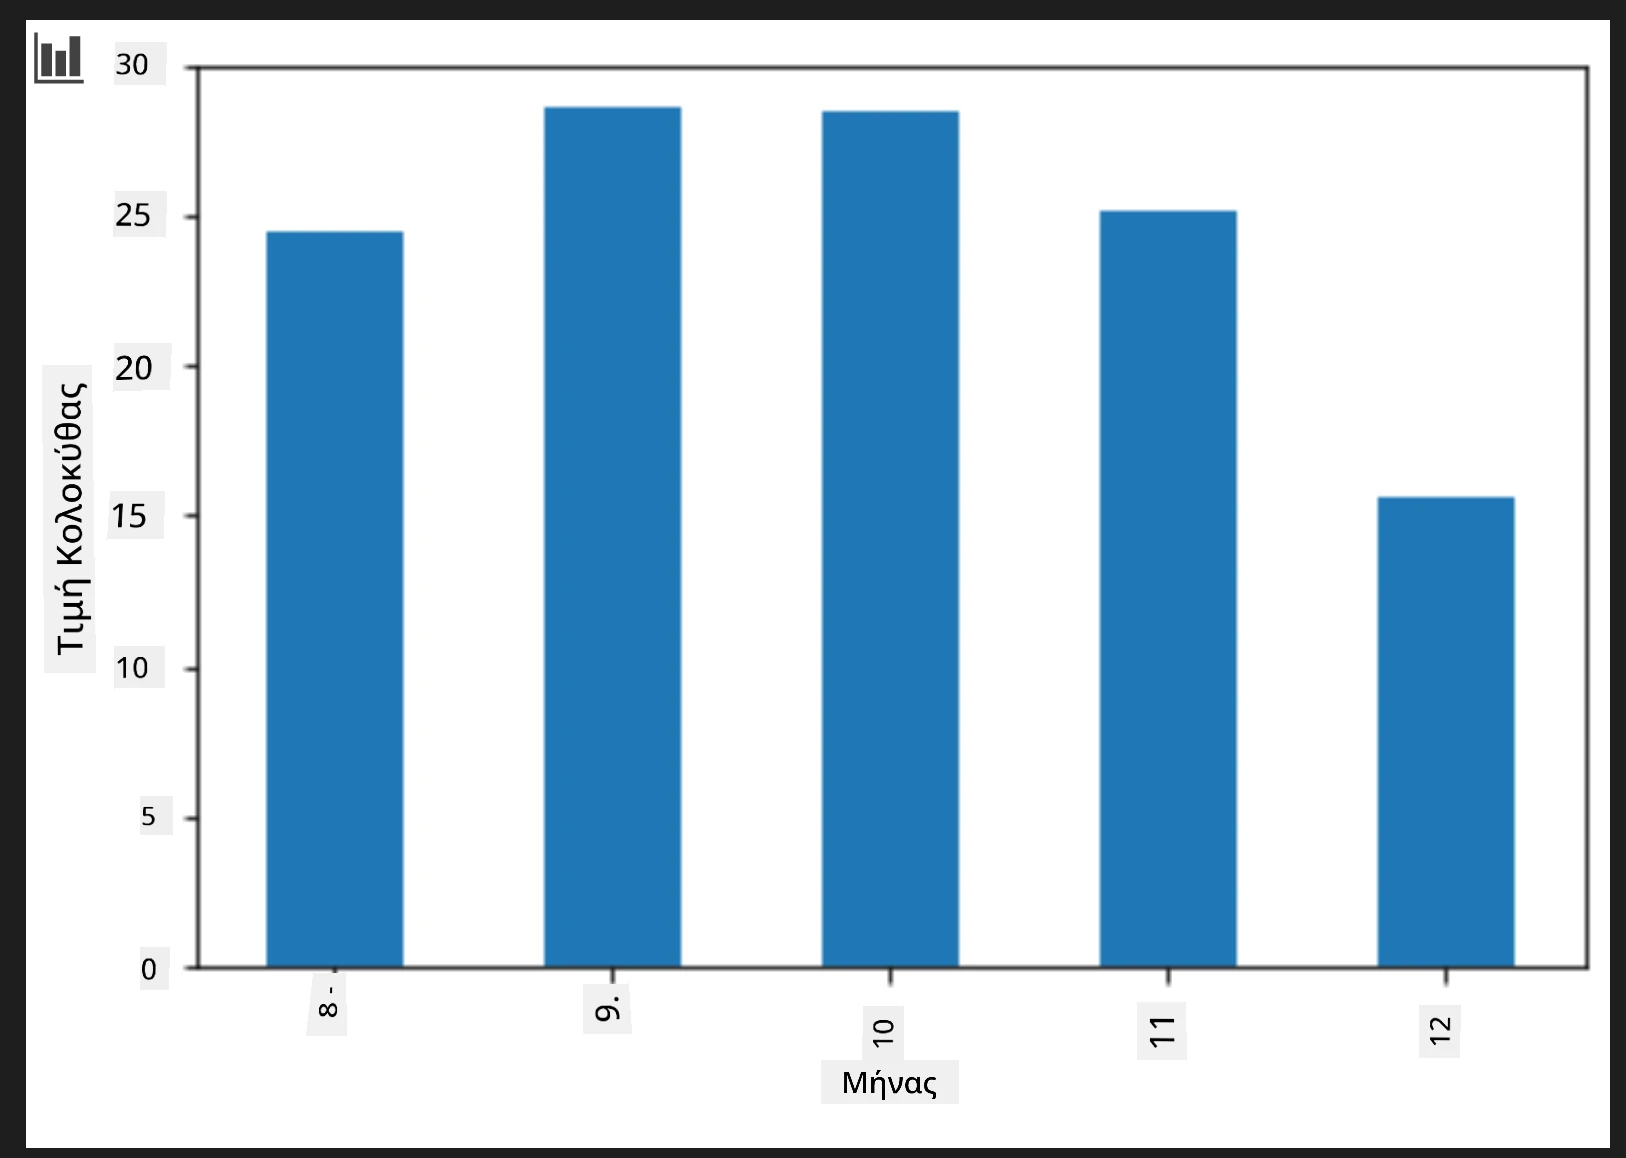
Αυτή είναι μια πιο χρήσιμη οπτικοποίηση δεδομένων! Φαίνεται να δείχνει ότι η υψηλότερη τιμή για τις κολοκύθες εμφανίζεται τον Σεπτέμβριο και τον Οκτώβρη. Συμφωνεί με τις προσδοκίες σας; Γιατί ή γιατί όχι;
Άσκηση - πειραματιστείτε με το Seaborn
Το Matplotlib είναι ισχυρό, αλλά μπορεί να χρειαστεί αρκετός κώδικας για να παραχθεί ένα ολοκληρωμένο διάγραμμα. Το Seaborn είναι μια βιβλιοθήκη που έχει φτιαχτεί πάνω από το Matplotlib και είναι σχεδιασμένη για στατιστική οπτικοποίηση δεδομένων. Λειτουργεί άμεσα με dataframes του Pandas, εφαρμόζει ελκυστικά προεπιλεγμένα στυλ και σας επιτρέπει να δημιουργήσετε ενημερωτικά διαγράμματα με πολύ λιγότερο κώδικα. Επειδή το Seaborn επιστρέφει αντικείμενα του Matplotlib, μπορείτε ακόμα να χρησιμοποιήσετε όσα ήδη γνωρίζετε για το Matplotlib για να βελτιώσετε το αποτέλεσμα.
Αν δεν έχετε ήδη εγκαταστήσει το Seaborn, εγκαταστήστε το με
pip install seaborn.
-
Εισάγετε το Seaborn στην κορυφή του σημειωματάριου, κάτω από τις άλλες εισαγωγές. Συμβατικά εισάγεται ως
sns:import seaborn as sns
Διαγράμματα διασποράς για να δείξετε σχέσεις
Ένα μεγάλο μέρος της εξερεύνησης των δεδομένων πριν από την κατασκευή μοντέλου είναι η αναζήτηση σχέσεων μεταξύ μεταβλητών. Ένα διάγραμμα διασποράς είναι ένα από τα καλύτερα εργαλεία γι’ αυτό: αν τα σημεία φαίνονται να ακολουθούν μια γραμμή, οι δύο μεταβλητές μπορεί να είναι συσχετισμένες, κάτι που είναι σημάδι ότι ένα μοντέλο γραμμικής παλινδρόμησης μπορεί να λειτουργήσει.
-
Αναδημιουργήστε το διάγραμμα διασποράς τιμής προς μήνα από πριν, αυτή τη φορά χρησιμοποιώντας το
relplot()του Seaborn (διάγραμμα συσχέτισης), που λειτουργεί απευθείας με τις στήλες του dataframe σας:sns.relplot(x="Price", y="Month", data=new_pumpkins)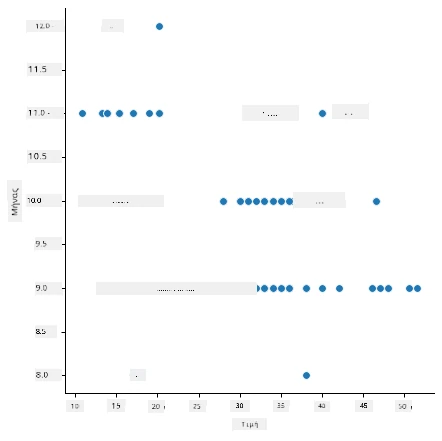
Παρατηρήστε πώς περνάτε τα ονόματα των στηλών και το dataframe, και το Seaborn φροντίζει για τις ετικέτες των αξόνων για εσάς.
-
Μπορείτε να αλλάξετε σε διάγραμμα γραμμής περνώντας
kind="line". Το Seaborn σχεδιάζει ακόμη και μια σκιασμένη ζώνη που δείχνει το διάστημα εμπιστοσύνης γύρω από τη γραμμή:sns.relplot(x="Price", y="Month", kind="line", data=new_pumpkins)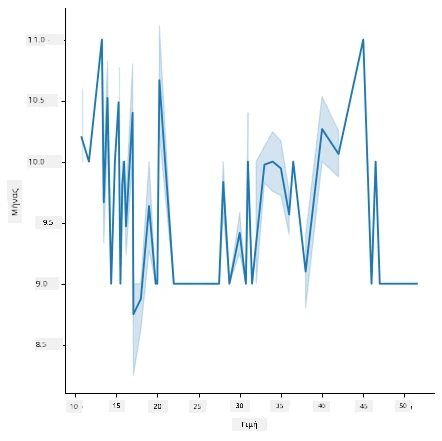
Αυτά τα συγκεκριμένα δεδομένα είναι αρκετά θορυβώδη, οπότε ένα διάγραμμα γραμμής δεν είναι η πιο καθαρή επιλογή εδώ — αλλά δείχνει πόσο εύκολα μπορείτε να αλλάξετε τύπους διαγραμμάτων στο Seaborn.
Ραβδόγραμμα για να δείξετε κατανομές
Νωρίτερα ομαδοποιήσατε τα δεδομένα χειροκίνητα για να δημιουργήσετε ένα ραβδόγραμμα με το Matplotlib. Το catplot() του Seaborn (κατηγοριοποιημένο διάγραμμα) μπορεί να κάνει την ομαδοποίηση και τη συσσωμάτωση για εσάς. Από προεπιλογή, kind="bar" δείχνει τον μέσο όρο κάθε κατηγορίας μαζί με μια μαύρη γραμμή που υποδεικνύει το διάστημα εμπιστοσύνης.
-
Δημιουργήστε ένα ραβδόγραμμα μέσης τιμής ανά μήνα:
sns.catplot(x="Month", y="Price", data=new_pumpkins, kind="bar")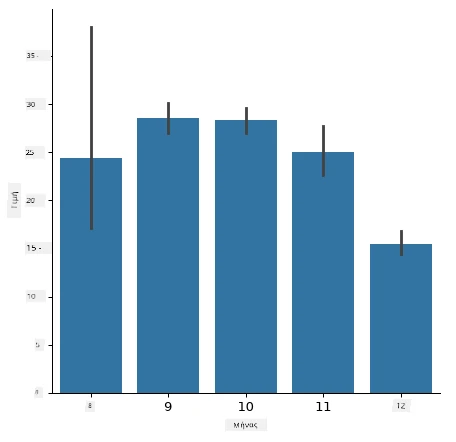
Αυτό επιβεβαιώνει όσα είδατε με το Matplotlib — οι τιμές κορυφώνονται γύρω στους μήνες Σεπτέμβριο και Οκτώβριο — αλλά το Seaborn απεικονίζει επίσης πόσο διαφέρει η τιμή μέσα σε κάθε μήνα.
Θερμικοί χάρτες για να δείξουν συσχετίσεις
Τα διαγράμματα διασποράς συγκρίνουν δύο μεταβλητές κάθε φορά. Όταν έχετε αρκετές αριθμητικές στήλες, ένας θερμικός χάρτης σας επιτρέπει να δείτε τη δύναμη της σχέσης μεταξύ κάθε ζεύγους στηλών ταυτόχρονα. Αυτός είναι ένας κοινός τρόπος να εντοπίσετε ποιες ιδιότητες είναι πιο συσχετισμένες πριν επιλέξετε τι θα δώσετε σε ένα μοντέλο (και ο ίδιος τύπος διαγράμματος χρησιμοποιείται αργότερα για να εμφανίσει πίνακες σύγχυσης στην ταξινόμηση).
-
Δημιουργήστε έναν πίνακα συσχέτισης με Pandas και μετά σχεδιάστε τον με το
heatmap()του Seaborn. Η επιλογήannot=Trueεκτυπώνει τις τιμές συσχέτισης σε κάθε κελί:correlations = new_pumpkins[['Month', 'Low Price', 'High Price', 'Price']].corr() sns.heatmap(correlations, annot=True, cmap="coolwarm")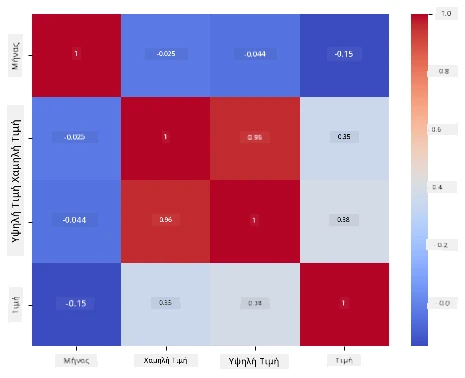
Τιμές κοντά στο
1(ή το-1) σημαίνουν ότι οι στήλες είναι ισχυρά γραμμικά συσχετισμένες. Παρατηρήστε πώς οιΧαμηλή ΤιμήκαιΥψηλή Τιμήσχετίζονται σχεδόν τέλεια. Από την άλλη πλευρά, οΜήναςδείχνει μόνο ασθενή γραμμική συσχέτιση με την τιμή — παρόλο που το ραβδόγραμμα πιο πάνω αποκάλυψε μια σαφή εποχιακή κορύφωση τον Σεπτέμβριο και τον Οκτώβριο. Αυτό είναι ένα σημαντικό μάθημα: ο συντελεστής συσχέτισης μετρά μόνο ευθείες σχέσεις, οπότε μπορεί να παραβλέψει εποχιακά ή άλλου τύπου μη γραμμικά μοτίβα. ✅ Γιατί είναι χρήσιμο να κοιτάμε τόσο έναν θερμικό χάρτη όσο και διαγράμματα όπως το ραβδόγραμμα πριν αποφασίσουμε ποιες στήλες θα χρησιμοποιήσουμε;
Matplotlib ή Seaborn;
Και οι δύο βιβλιοθήκες αξίζουν να τις γνωρίζετε:
- Matplotlib σας δίνει λεπτομερή έλεγχο σε κάθε στοιχείο ενός διαγράμματος και είναι η βάση πάνω στην οποία στηρίζεται σχεδόν κάθε άλλη βιβλιοθήκη γραφικών Python.
- Seaborn παρέχει λειτουργίες υψηλότερου επιπέδου και ελκυστικές προεπιλογές για στατιστικά διαγράμματα, δουλεύει απευθείας με dataframes και είναι συχνά πιο γρήγορο για εξερευνητική ανάλυση δεδομένων.
Μια κοινή ροή εργασίας είναι να χρησιμοποιείτε το Seaborn για να εξερευνήσετε γρήγορα τα δεδομένα σας και μετά να περάσετε στο Matplotlib όταν χρειάζεται να προσαρμόσετε τις λεπτομέρειες.
🚀Πρόκληση
Εξερευνήστε τους διάφορους τύπους οπτικοποίησης που προσφέρουν το Matplotlib και το Seaborn. Ποιοι τύποι είναι πιο κατάλληλοι για προβλήματα παλινδρόμησης;
Κουίζ μετά τη διάλεξη
Επανεξέταση & Αυτοδιδασκαλία
Ρίξτε μια ματιά στους πολλούς τρόπους οπτικοποίησης δεδομένων. Φτιάξτε μια λίστα με τις διάφορες διαθέσιμες βιβλιοθήκες και σημειώστε ποιες είναι οι καλύτερες για συγκεκριμένους τύπους εργασιών, για παράδειγμα 2D έναντι 3D οπτικοποιήσεων. Τι ανακαλύπτετε;
Εργασία
Αποποίηση ευθυνών: Αυτό το έγγραφο έχει μεταφραστεί χρησιμοποιώντας την υπηρεσία μετάφρασης με τεχνητή νοημοσύνη Co-op Translator. Ενώ επιδιώκουμε την ακρίβεια, παρακαλούμε να έχετε υπόψη ότι οι αυτοματοποιημένες μεταφράσεις ενδέχεται να περιέχουν λάθη ή ανακρίβειες. Το πρωτότυπο έγγραφο στη μητρική του γλώσσα πρέπει να θεωρείται η αυθεντική πηγή. Για κρίσιμες πληροφορίες, συνιστάται επαγγελματική ανθρώπινη μετάφραση. Δεν φέρουμε ευθύνη για τυχόν παρεξηγήσεις ή λανθασμένες ερμηνείες που προκύπτουν από τη χρήση αυτής της μετάφρασης.