
26 KiB
Ξεκινώντας με Python και Scikit-learn για μοντέλα παλινδρόμησης
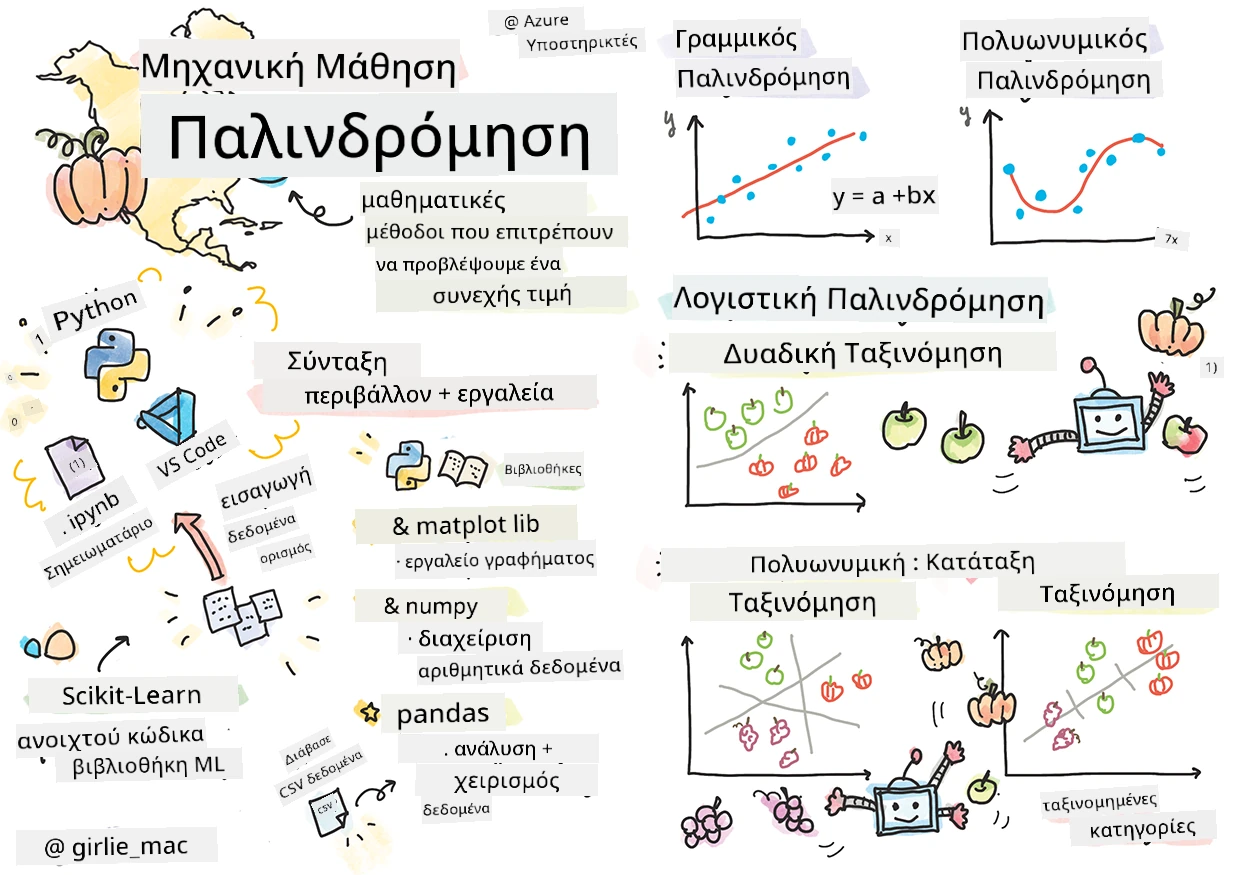
Sketchnote από τον/την Tomomi Imura
Προ-διάλεξη κουίζ
Αυτό το μάθημα είναι διαθέσιμο σε R!
Εισαγωγή
Σε αυτά τα τέσσερα μαθήματα, θα ανακαλύψετε πώς να κατασκευάζετε μοντέλα παλινδρόμησης. Θα συζητήσουμε σύντομα ποιος είναι ο σκοπός τους. Αλλά πριν κάνετε οτιδήποτε, βεβαιωθείτε ότι έχετε τα σωστά εργαλεία στη θέση τους για να ξεκινήσετε!
Σε αυτό το μάθημα, θα μάθετε πώς να:
- Ρυθμίζετε τον υπολογιστή σας για τοπικές εργασίες μηχανικής μάθησης.
- Εργάζεστε με Jupyter Notebooks.
- Χρησιμοποιείτε το Scikit-learn, συμπεριλαμβανομένης της εγκατάστασης.
- Εξερευνάτε τη γραμμική παλινδρόμηση με μια πρακτική άσκηση.
Εγκαταστάσεις και ρυθμίσεις

🎥 Κάντε κλικ στην εικόνα παραπάνω για ένα σύντομο βίντεο με τη διαδικασία ρύθμισης του υπολογιστή σας για ML.
-
Εγκαταστήστε Python. Βεβαιωθείτε ότι η Python είναι εγκατεστημένη στον υπολογιστή σας. Θα χρησιμοποιήσετε την Python σε πολλές εργασίες επιστήμης δεδομένων και μηχανικής μάθησης. Τα περισσότερα συστήματα υπολογιστών περιλαμβάνουν ήδη εγκατάσταση Python. Υπάρχουν επίσης χρήσιμα Python Coding Packs διαθέσιμα, για να διευκολύνουν την εγκατάσταση για κάποιους χρήστες.
Ορισμένες χρήσεις της Python απαιτούν διαφορετικές εκδόσεις του λογισμικού. Για τον λόγο αυτό, είναι χρήσιμο να εργάζεστε σε ένα εικονικό περιβάλλον.
-
Εγκαταστήστε το Visual Studio Code. Βεβαιωθείτε ότι έχετε εγκαταστήσει το Visual Studio Code στον υπολογιστή σας. Ακολουθήστε αυτές τις οδηγίες για να εγκαταστήσετε το Visual Studio Code για την βασική εγκατάσταση. Θα χρησιμοποιήσετε Python στο Visual Studio Code σε αυτό το μάθημα, οπότε ίσως θελήσετε να εξοικειωθείτε με το πώς να ρυθμίσετε το Visual Studio Code για ανάπτυξη Python.
Εξοικειωθείτε με την Python δουλεύοντας μέσα από αυτή τη συλλογή μαθημάτων

🎥 Κάντε κλικ στην εικόνα παραπάνω για βίντεο: Χρήση της Python μέσα στο VS Code.
-
Εγκαταστήστε το Scikit-learn, ακολουθώντας αυτές τις οδηγίες. Δεδομένου ότι πρέπει να χρησιμοποιείτε Python 3, συνιστάται η χρήση εικονικού περιβάλλοντος. Σημειώστε ότι αν εγκαθιστάτε αυτή τη βιβλιοθήκη σε M1 Mac, υπάρχουν ειδικές οδηγίες στη σελίδα που συνδέεται παραπάνω.
-
Εγκαταστήστε το Jupyter Notebook. Θα χρειαστεί να εγκαταστήσετε το πακέτο Jupyter.
Το περιβάλλον γραφής σας για ML
Θα χρησιμοποιήσετε notebooks για να αναπτύξετε τον κώδικα Python και να δημιουργήσετε μοντέλα μηχανικής μάθησης. Αυτού του είδους τα αρχεία είναι κοινά εργαλεία για επιστήμονες δεδομένων και αναγνωρίζονται από την επέκταση .ipynb.
Τα notebooks είναι ένα διαδραστικό περιβάλλον που επιτρέπει στον προγραμματιστή να γράφει κώδικα, να προσθέτει σχόλια και να γράφει τεκμηρίωση γύρω από τον κώδικα, κάτι που είναι πολύ χρήσιμο για πειραματικά ή ερευνητικά έργα.

🎥 Κάντε κλικ στην εικόνα παραπάνω για ένα σύντομο βίντεο που δείχνει αυτή την άσκηση.
Άσκηση - εργασία με notebook
Σε αυτόν το φάκελο, θα βρείτε το αρχείο notebook.ipynb.
-
Ανοίξτε το notebook.ipynb στο Visual Studio Code.
Ένας server του Jupyter θα ξεκινήσει με Python 3+. Θα βρείτε περιοχές του notebook που μπορούν να
εκτελεστούν, κομμάτια κώδικα. Μπορείτε να εκτελέσετε ένα μπλοκ κώδικα, επιλέγοντας το εικονίδιο που μοιάζει με κουμπί αναπαραγωγής. -
Επιλέξτε το εικονίδιο
mdκαι προσθέστε λίγο markdown, και το ακόλουθο κείμενο # Καλώς ήρθατε στο notebook σας.Στη συνέχεια, προσθέστε λίγο κώδικα Python.
-
Πληκτρολογήστε print('hello notebook') στο μπλοκ κώδικα.
-
Επιλέξτε το βέλος για να εκτελέσετε τον κώδικα.
Θα πρέπει να δείτε το εκτυπωμένο μήνυμα:
hello notebook
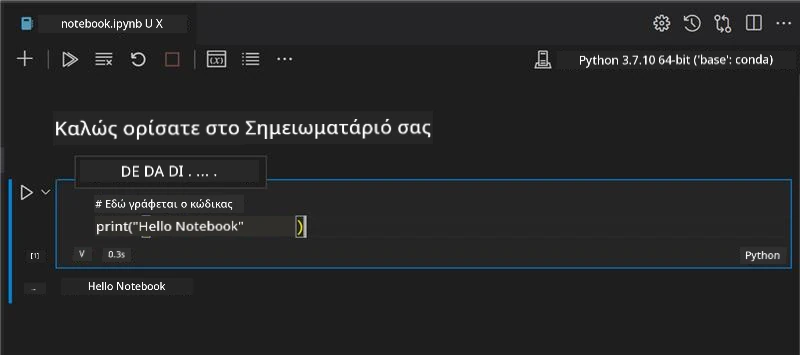
Μπορείτε να ενσωματώσετε τον κώδικά σας με σχόλια για να αυτο-τεκμηριώσετε το notebook.
✅ Σκεφτείτε για ένα λεπτό πόσο διαφορετικό είναι το περιβάλλον εργασίας ενός web developer σε σύγκριση με αυτό ενός επιστήμονα δεδομένων.
Ολοκληρώνουμε με το Scikit-learn
Τώρα που η Python έχει ρυθμιστεί στο τοπικό σας περιβάλλον και είστε εξοικειωμένοι με τα Jupyter Notebooks, ας εξοικειωθούμε εξίσου με το Scikit-learn (προφέρεται σάι όπως το science). Το Scikit-learn παρέχει ένα εκτεταμένο API που σας βοηθά να εκτελέσετε εργασίες ML.
Σύμφωνα με τον δικτυακό τους τόπο, "Το Scikit-learn είναι μια βιβλιοθήκη μηχανικής μάθησης ανοικτού κώδικα που υποστηρίζει επιβλεπόμενη και μη επιβλεπόμενη μάθηση. Παρέχει επίσης διάφορα εργαλεία για την προσαρμογή μοντέλων, την προεπεξεργασία δεδομένων, την επιλογή και αξιολόγηση μοντέλων, και πολλές άλλες λειτουργίες."
Σε αυτό το μάθημα, θα χρησιμοποιήσετε το Scikit-learn και άλλα εργαλεία για να δημιουργήσετε μοντέλα μηχανικής μάθησης που εκτελούν αυτό που ονομάζουμε «παραδοσιακές εργασίες μηχανικής μάθησης». Έχουμε σκόπιμα αποφύγει τα νευρωνικά δίκτυα και τη βαθιά μάθηση, καθώς αυτά καλύπτονται καλύτερα στο επερχόμενο πρόγραμμα «AI for Beginners».
Το Scikit-learn καθιστά εύκολο το χτίσιμο μοντέλων και την αξιολόγησή τους για χρήση. Επικεντρώνεται κυρίως στη χρήση αριθμητικών δεδομένων και περιέχει αρκετά έτοιμα σύνολα δεδομένων για χρήση ως εργαλεία μάθησης. Περιλαμβάνει επίσης προεγκατεστημένα μοντέλα για να δοκιμάσουν οι μαθητές. Ας εξερευνήσουμε τη διαδικασία φόρτωσης προπαρασκευασμένων δεδομένων και τη χρήση ενσωματωμένου εκτιμητή για να δημιουργήσουμε το πρώτο σας μοντέλο ML με το Scikit-learn με μερικά βασικά δεδομένα.
Άσκηση - το πρώτο σας notebook με Scikit-learn
Αυτό το tutorial εμπνεύστηκε από το παράδειγμα γραμμικής παλινδρόμησης στον ιστότοπο του Scikit-learn.

🎥 Κάντε κλικ στην εικόνα παραπάνω για ένα σύντομο βίντεο που δείχνει αυτή την άσκηση.
Στο αρχείο notebook.ipynb που συνδέεται με αυτό το μάθημα, καθαρίστε όλα τα κελιά πατώντας το εικονίδιο 'κάδου απορριμμάτων'.
Σε αυτή την ενότητα, θα εργαστείτε με ένα μικρό σύνολο δεδομένων για τον διαβήτη που είναι ενσωματωμένο στο Scikit-learn για μαθησιακούς σκοπούς. Φανταστείτε ότι θέλετε να δοκιμάσετε μια θεραπεία για διαβητικούς ασθενείς. Τα μοντέλα μηχανικής μάθησης μπορεί να βοηθήσουν να προσδιορίσετε ποιοι ασθενείς θα ανταποκριθούν καλύτερα στη θεραπεία, βάσει συνδυασμών μεταβλητών. Ακόμη και ένα πολύ βασικό μοντέλο παλινδρόμησης, όταν οπτικοποιηθεί, μπορεί να δείξει πληροφορίες για μεταβλητές που θα βοηθούσαν να οργανώσετε τις θεωρητικές κλινικές δοκιμές σας.
✅ Υπάρχουν πολλοί τύποι μεθόδων παλινδρόμησης, και ποια θα επιλέξετε εξαρτάται από την απάντηση που αναζητάτε. Αν θέλετε να προβλέψετε το πιθανό ύψος για ένα άτομο μιας δεδομένης ηλικίας, θα χρησιμοποιήσετε γραμμική παλινδρόμηση, καθώς αναζητάτε μια αριθμητική τιμή. Αν ενδιαφέρεστε να ανακαλύψετε αν ένας τύπος κουζίνας πρέπει να θεωρηθεί vegan ή όχι, αναζητάτε κατηγορική ταξινόμηση, οπότε θα χρησιμοποιήσετε λογιστική παλινδρόμηση. Θα μάθετε περισσότερα για τη λογιστική παλινδρόμηση αργότερα. Σκεφτείτε λίγο για κάποιες ερωτήσεις που μπορείτε να θέσετε στα δεδομένα και ποια από αυτές τις μεθόδους θα ήταν πιο κατάλληλη.
Ας ξεκινήσουμε αυτή την εργασία.
Εισαγωγή βιβλιοθηκών
Για αυτή την εργασία θα εισάγουμε μερικές βιβλιοθήκες:
- matplotlib. Είναι ένα χρήσιμο εργαλείο γραφημάτων και θα το χρησιμοποιήσουμε για να δημιουργήσουμε ένα γράφημα γραμμής.
- numpy. Η numpy είναι μια χρήσιμη βιβλιοθήκη για τη διαχείριση αριθμητικών δεδομένων στην Python.
- sklearn. Αυτή είναι η βιβλιοθήκη Scikit-learn.
Εισάγετε μερικές βιβλιοθήκες για να σας βοηθήσουν στις εργασίες σας.
-
Προσθέστε τις εισαγωγές πληκτρολογώντας τον ακόλουθο κώδικα:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
Πάνω εισάγετε τα
matplotlib,numpyκαι εισάγετε ταdatasets,linear_modelκαιmodel_selectionαπό τοsklearn. Τοmodel_selectionχρησιμοποιείται για το διαχωρισμό των δεδομένων σε σύνολα εκπαίδευσης και δοκιμής.
Το σύνολο δεδομένων για διαβήτη
Το ενσωματωμένο σύνολο δεδομένων διαβήτη περιλαμβάνει 442 δείγματα δεδομένων γύρω από τον διαβήτη, με 10 χαρακτηριστικές μεταβλητές, μερικές από τις οποίες είναι:
- ηλικία: ηλικία σε χρόνια
- bmi: δείκτης μάζας σώματος
- bp: μέση αρτηριακή πίεση
- s1 tc: T-λεμφοκύτταρα (τύπος λευκών αιμοσφαιρίων)
✅ Αυτό το σύνολο δεδομένων περιλαμβάνει την έννοια του 'φύλου' ως χαρακτηριστική μεταβλητή σημαντική για την έρευνα γύρω από τον διαβήτη. Πολλά ιατρικά σύνολα δεδομένων περιλαμβάνουν αυτού του είδους την δυαδική ταξινόμηση. Σκεφτείτε λίγο πώς τέτοιες κατηγοριοποιήσεις μπορεί να αποκλείουν μέρη ενός πληθυσμού από θεραπείες.
Τώρα, φορτώστε τα δεδομένα X και y.
🎓 Θυμηθείτε, αυτή είναι επιβλεπόμενη μάθηση, και χρειαζόμαστε έναν ονομασμένο στόχο 'y'.
Σε ένα νέο κελί κώδικα, φορτώστε το σύνολο δεδομένων διαβήτη καλώντας load_diabetes(). Το όρισμα return_X_y=True σηματοδοτεί ότι το X θα είναι ένας πίνακας δεδομένων και το y ο στόχος παλινδρόμησης.
-
Προσθέστε κάποιες εντολές εκτύπωσης για να δείξετε το σχήμα του πίνακα δεδομένων και το πρώτο του στοιχείο:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Αυτό που λαμβάνετε ως απάντηση είναι ένας πλειάδα. Αυτό που κάνετε είναι να αναθέσετε τις δύο πρώτες τιμές της πλειάδας στα
Xκαιyαντίστοιχα. Μάθετε περισσότερα για τις πλειάδες.Μπορείτε να δείτε ότι αυτά τα δεδομένα έχουν 442 στοιχεία οργανωμένα σε πίνακες των 10 στοιχείων:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Σκεφτείτε λίγο τη σχέση μεταξύ των δεδομένων και του στόχου παλινδρόμησης. Η γραμμική παλινδρόμηση προβλέπει σχέσεις μεταξύ του χαρακτηριστικού X και της μεταβλητής στόχου y. Μπορείτε να βρείτε τον στόχο για το σύνολο δεδομένων διαβήτη στην τεκμηρίωση; Τι παρουσιάζει αυτό το σύνολο δεδομένων, δεδομένου αυτού του στόχου;
-
Στη συνέχεια, επιλέξτε ένα μέρος αυτού του συνόλου δεδομένων για να το απεικονίσετε επιλέγοντας την 3η στήλη του συνόλου δεδομένων. Μπορείτε να το κάνετε χρησιμοποιώντας τον τελεστή
:για να επιλέξετε όλες τις γραμμές, και μετά επιλέγοντας την 3η στήλη με τον δείκτη (2). Μπορείτε επίσης να αναδιαμορφώσετε τα δεδομένα σε 2D πίνακα - όπως απαιτείται για την απεικόνιση - χρησιμοποιώνταςreshape(n_rows, n_columns). Αν μία από τις παραμέτρους είναι -1, η αντίστοιχη διάσταση υπολογίζεται αυτόματα.X = X[:, 2] X = X.reshape((-1,1))✅ Οποιαδήποτε στιγμή, εκτυπώστε τα δεδομένα για να ελέγξετε το σχήμα τους.
-
Τώρα που έχετε τα δεδομένα έτοιμα για απεικόνιση, δείτε αν μια μηχανή μπορεί να βοηθήσει να βρεθεί ένας λογικός διαχωρισμός ανάμεσα στους αριθμούς αυτού του συνόλου δεδομένων. Για να το κάνετε αυτό, πρέπει να χωρίσετε και τα δεδομένα (X) και τον στόχο (y) σε σύνολα δοκιμής και εκπαίδευσης. Το Scikit-learn έχει έναν απλό τρόπο να το κάνει αυτό, μπορείτε να χωρίσετε τα δεδομένα σας σε ένα δεδομένο σημείο.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Τώρα είστε έτοιμοι να εκπαιδεύσετε το μοντέλο σας! Φορτώστε το γραμμικό μοντέλο παλινδρόμησης και εκπαιδεύστε το με τα σύνολα εκπαίδευσης X και y χρησιμοποιώντας το
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅ Το
model.fit()είναι μια συνάρτηση που θα δείτε σε πολλές βιβλιοθήκες ML όπως το TensorFlow -
Στη συνέχεια, δημιουργήστε μια πρόβλεψη χρησιμοποιώντας τα δεδομένα δοκιμής, με τη λειτουργία
predict(). Αυτή θα χρησιμοποιηθεί για να σχεδιάσει τη γραμμή ανάμεσα στις ομάδες δεδομένωνy_pred = model.predict(X_test) -
Τώρα είναι ώρα να εμφανίσουμε τα δεδομένα σε γράφημα. Το Matplotlib είναι ένα πολύ χρήσιμο εργαλείο για αυτή τη δουλειά. Δημιουργήστε ένα scatterplot όλων των X και y δεδομένων δοκιμής, και χρησιμοποιήστε την πρόβλεψη για να σχεδιάσετε μια γραμμή στο πιο κατάλληλο σημείο, ανάμεσα στις ομάδες δεδομένων του μοντέλου.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()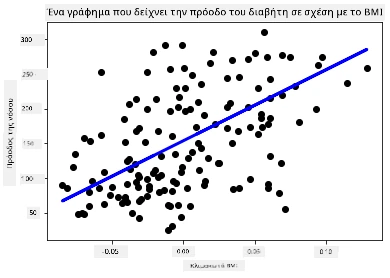
✅ Σκεφτείτε λίγο τι συμβαίνει εδώ. Μια ευθεία γραμμή περνά μέσα από πολλά μικρά σημεία δεδομένων, αλλά τι ακριβώς κάνει; Μπορείτε να δείτε πώς θα πρέπει να μπορείτε να χρησιμοποιήσετε αυτή τη γραμμή για να προβλέψετε πού θα πρέπει να ταιριάξει ένα νέο, αθέατο σημείο δεδομένων σε σχέση με τον άξονα y του γραφήματος; Προσπαθήστε να διατυπώσετε με λέξεις τη πρακτική χρήση αυτού του μοντέλου.
Συγχαρητήρια, κατασκευάσατε το πρώτο σας γραμμικό μοντέλο παλινδρόμησης, δημιουργήσατε μια πρόβλεψη με αυτό και την εμφανίσατε σε γράφημα!
🚀Πρόκληση
Απεικονίστε μια διαφορετική μεταβλητή από αυτό το σύνολο δεδομένων. Υπόδειξη: επεξεργαστείτε αυτή τη γραμμή: X = X[:,2]. Δεδομένου του στόχου αυτού του συνόλου δεδομένων, τι είστε σε θέση να ανακαλύψετε για την εξέλιξη του διαβήτη ως νόσου;
Μετα-διάλεξη κουίζ
Επανάληψη & Αυτο-μελέτη
Σε αυτό το tutorial, εργαστήκατε με απλή γραμμική παλινδρόμηση, αντί για μονομεταβλητή ή πολυμεταβλητή γραμμική παλινδρόμηση. Διαβάστε λίγο για τις διαφορές ανάμεσα σε αυτές τις μεθόδους ή δείτε αυτό το βίντεο
Διαβάστε περισσότερα για την έννοια της παλινδρόμησης και σκεφτείτε τι είδους ερωτήσεις μπορούν να απαντηθούν με αυτήν την τεχνική. Ακολουθήστε αυτό το μάθημα για να εμβαθύνετε την κατανόησή σας.
Ανάθεση
Ένα διαφορετικό σύνολο δεδομένων
Αποποίηση ευθυνών: Αυτό το έγγραφο έχει μεταφραστεί χρησιμοποιώντας την υπηρεσία μετάφρασης με τεχνητή νοημοσύνη Co-op Translator. Ενώ επιδιώκουμε την ακρίβεια, παρακαλούμε να έχετε υπόψη ότι οι αυτοματοποιημένες μεταφράσεις ενδέχεται να περιέχουν λάθη ή ανακρίβειες. Το πρωτότυπο έγγραφο στη μητρική του γλώσσα πρέπει να θεωρείται η αυθεντική πηγή. Για κρίσιμες πληροφορίες, συνιστάται επαγγελματική ανθρώπινη μετάφραση. Δεν φέρουμε ευθύνη για τυχόν παρεξηγήσεις ή λανθασμένες ερμηνείες που προκύπτουν από τη χρήση αυτής της μετάφρασης.