
15 KiB
Kom i gang med Python og Scikit-learn til regressionsmodeller
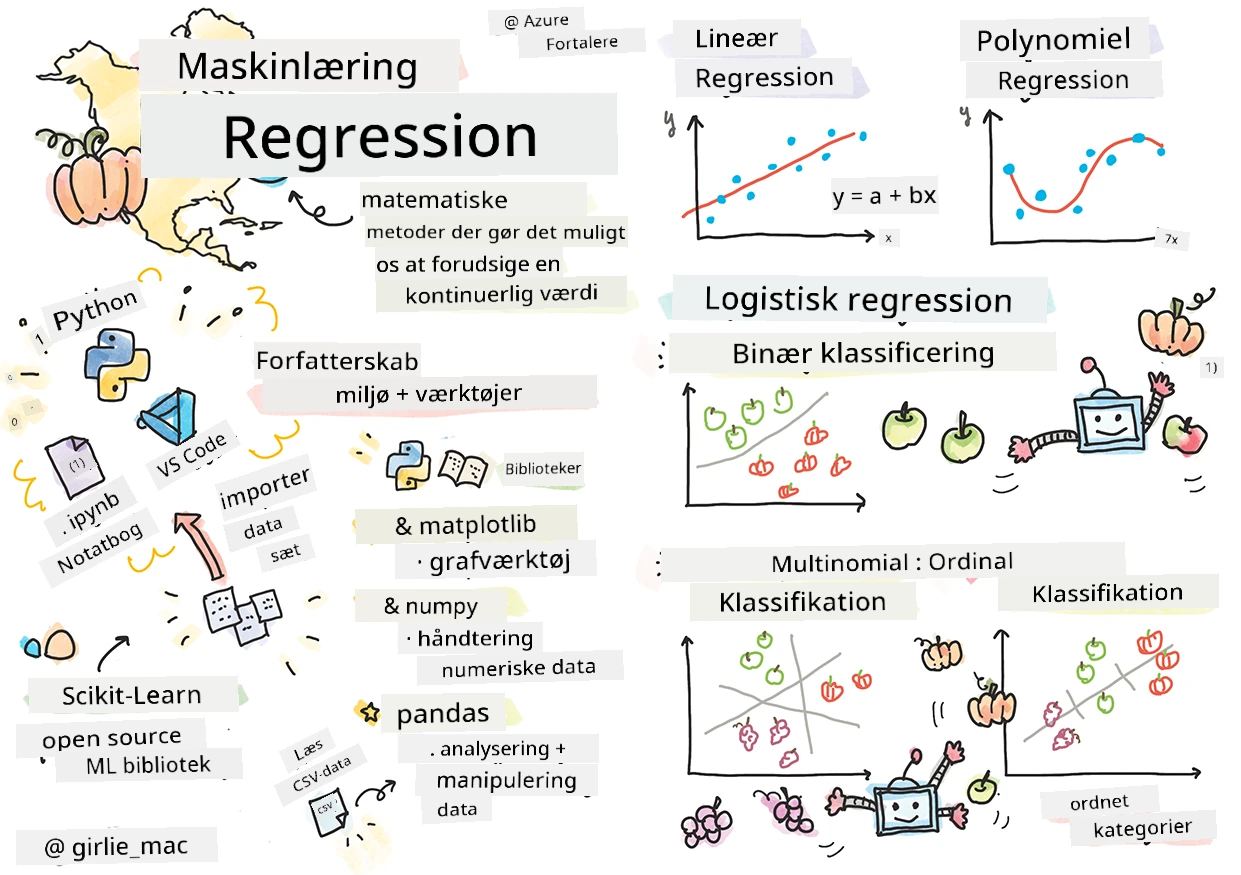
Sketchnote af Tomomi Imura
Quiz før lektionen
Denne lektion findes også i R!
Introduktion
I disse fire lektioner vil du opdage, hvordan man bygger regressionsmodeller. Vi vil snart tale om, hvad de bruges til. Men før du gør noget som helst, skal du sikre dig, at du har de rigtige værktøjer på plads for at starte processen!
I denne lektion vil du lære at:
- Konfigurere din computer til lokale maskinlæringsopgaver.
- Arbejde med Jupyter Notebooks.
- Bruge Scikit-learn, inklusive installation.
- Udforske lineær regression med en praktisk øvelse.
Installationer og konfigurationer

🎥 Klik på billedet ovenfor for en kort video, der gennemgår konfiguration af din computer til ML.
-
Installer Python. Sørg for, at Python er installeret på din computer. Du vil bruge Python til mange data science- og maskinlæringsopgaver. De fleste computersystemer har allerede en Python-installation. Der findes også nyttige Python Coding Packs, der kan lette opsætningen for nogle brugere.
Nogle anvendelser af Python kræver dog en version af softwaren, mens andre kræver en anden version. Derfor er det nyttigt at arbejde inden for et virtuelt miljø.
-
Installer Visual Studio Code. Sørg for at have Visual Studio Code installeret på din computer. Følg disse instruktioner for at installere Visual Studio Code til den grundlæggende installation. Du kommer til at bruge Python i Visual Studio Code i dette kursus, så du vil måske opfriske, hvordan man konfigurerer Visual Studio Code til Python-udvikling.
Bliv fortrolig med Python ved at arbejde dig igennem denne samling af Learn moduler

🎥 Klik på billedet ovenfor for en video: brug af Python inden for VS Code.
-
Installer Scikit-learn, ved at følge disse instruktioner. Da du skal sikre dig, at du bruger Python 3, anbefales det at bruge et virtuelt miljø. Bemærk, hvis du installerer dette bibliotek på en M1 Mac, findes der særlige instruktioner på siden ovenfor.
-
Installer Jupyter Notebook. Du skal installere Jupyter-pakken.
Dit ML-udviklingsmiljø
Du skal bruge notebooks til at udvikle din Python-kode og oprette maskinlæringsmodeller. Denne filtype er et almindeligt værktøj for dataforskere og kan identificeres ved deres suffiks eller filendelse .ipynb.
Notebooks er et interaktivt miljø, der tillader udvikleren både at kode og tilføje noter samt skrive dokumentation omkring koden, hvilket er meget nyttigt til eksperimentelle eller forskningsorienterede projekter.

🎥 Klik på billedet ovenfor for en kort video, der gennemgår denne øvelse.
Øvelse - arbejd med en notebook
I denne mappe finder du filen notebook.ipynb.
-
Åbn notebook.ipynb i Visual Studio Code.
En Jupyter-server vil starte med Python 3+ aktiveret. Du vil finde områder i notebooken, som kan
køres, kodeblokke. Du kan køre en kodeblok ved at vælge ikonet, der ligner en play-knap. -
Vælg
mdikonet og tilføj lidt markdown samt følgende tekst # Velkommen til din notebook.Tilføj derefter noget Python-kode.
-
Skriv print('hello notebook') i kodeblokken.
-
Vælg pilen for at køre koden.
Du skulle gerne se den udskrevne sætning:
hello notebook
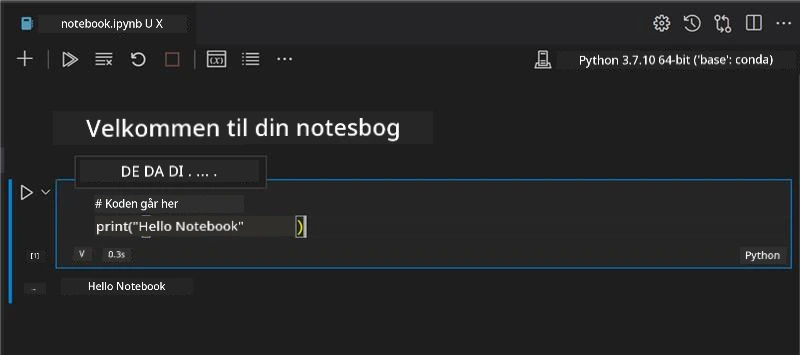
Du kan blande din kode med kommentarer for at selv-dokumentere notebooken.
✅ Tænk et øjeblik over, hvor forskelligt en webudviklers arbejdsmiljø er i forhold til en dataforskers.
Op at køre med Scikit-learn
Nu hvor Python er sat op i dit lokale miljø, og du er tryg ved Jupyter Notebooks, lad os blive lige så fortrolige med Scikit-learn (udtales sci som i science). Scikit-learn tilbyder et omfattende API, der hjælper dig med at udføre ML-opgaver.
Ifølge deres hjemmeside, "er Scikit-learn et open source maskinlæringsbibliotek, der understøtter superviseret og usuperviseret læring. Det tilbyder også forskellige værktøjer til modeltilpasning, datapræbehandling, modelvalg og evaluering samt mange andre hjælpeværktøjer."
I dette kursus vil du bruge Scikit-learn og andre værktøjer til at bygge maskinlæringsmodeller til det, vi kalder 'traditionelle maskinlæringsopgaver'. Vi har bevidst undgået neurale netværk og dyb læring, da de dækkes bedre i vores kommende 'AI for Beginners' læseplan.
Scikit-learn gør det nemt at opbygge modeller og evaluere dem til brug. Det fokuserer primært på at bruge numeriske data og indeholder flere færdiglavede datasæt, som kan bruges som læringsværktøjer. Det inkluderer også forbyggede modeller, som studerende kan prøve. Lad os udforske processen med at indlæse forpakker data og bruge en indbygget estimator til at skabe din første ML-model med Scikit-learn med nogle grundlæggende data.
Øvelse - din første Scikit-learn notebook
Denne vejledning er inspireret af linear regression eksemplet på Scikit-learns hjemmeside.

🎥 Klik på billedet ovenfor for en kort video, der gennemgår denne øvelse.
I filen notebook.ipynb tilknyttet denne lektion, ryd alle celler ved at trykke på 'skraldespands'-ikonet.
I denne sektion vil du arbejde med et lille datasæt om diabetes, som er indbygget i Scikit-learn til læringsformål. Forestil dig, at du ville teste en behandling for diabetikere. Maskinlæringsmodeller kan hjælpe dig med at bestemme, hvilke patienter der vil reagere bedre på behandlingen, baseret på kombinationer af variable. Selv en meget basal regressionsmodel, når den visualiseres, kan vise information om variable, der kan hjælpe dig med at organisere dine teoretiske kliniske forsøg.
✅ Der findes mange typer regressionsmetoder, og hvilken du vælger afhænger af svaret, du leder efter. Hvis du vil forudsige den sandsynlige højde for en person i en given alder, bruger du lineær regression, da du søger en numerisk værdi. Hvis du er interesseret i at finde ud af, om en type køkken bør betragtes som vegansk eller ej, søger du en kategori-tilknytning, så du vil bruge logistisk regression. Du vil lære mere om logistisk regression senere. Tænk lidt over nogle spørgsmål, du kan stille til data, og hvilken af disse metoder der ville være mest passende.
Lad os komme i gang med denne opgave.
Importér biblioteker
Til denne opgave vil vi importere nogle biblioteker:
- matplotlib. Det er et nyttigt grafværktøj, og vi vil bruge det til at lave en linjeplot.
- numpy. numpy er et nyttigt bibliotek til håndtering af numeriske data i Python.
- sklearn. Dette er Scikit-learn biblioteket.
Importér nogle biblioteker til at hjælpe med dine opgaver.
-
Tilføj importerne ved at skrive følgende kode:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
Ovenfor importerer du
matplotlib,numpy, og du importererdatasets,linear_modelogmodel_selectionfrasklearn.model_selectionbruges til at opdele data i trænings- og testsæt.
Diabetesdatasættet
Det indbyggede diabetesdatasæt indeholder 442 prøver af data omkring diabetes, med 10 feature-variabler, hvoraf nogle inkluderer:
- age: alder i år
- bmi: body mass index
- bp: gennemsnitligt blodtryk
- s1 tc: T-celler (en type hvide blodlegemer)
✅ Dette datasæt inkluderer begrebet 'køn' som en feature-variabel vigtig for forskning omkring diabetes. Mange medicinske datasæt inkluderer denne type binær klassifikation. Tænk lidt over, hvordan sådanne kategoriseringer kan udelukke visse dele af en befolkning fra behandlinger.
Indlæs nu X og y data.
🎓 Husk, dette er superviseret læring, og vi har brug for et navngivet 'y'-mål.
I en ny kodecelle skal du indlæse diabetesdatasættet ved at kalde load_diabetes(). Inputtet return_X_y=True signalerer, at X vil være en datamatricer, og y vil være regressionsmålet.
-
Tilføj nogle print-kommandoer for at vise formen på datamatricen og dens første element:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Det du får tilbage som svar er en tuple. Det, du gør, er at tildele de to første værdier i tuplen til henholdsvis
Xogy. Lær mere om tupler.Du kan se, at disse data har 442 elementer formet som arrays med 10 elementer:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Tænk lidt over forholdet mellem data og regressionsmålet. Lineær regression forudsiger relationer mellem feature X og målvariablen y. Kan du finde målet for diabetesdatasættet i dokumentationen? Hvad demonstrerer dette datasæt, givet målet?
-
Vælg derefter en del af dette datasæt til at plotte ved at vælge den 3. kolonne i datasættet. Det kan du gøre ved at bruge
:operatoren til at vælge alle rækker, og så vælge den 3. kolonne med indeks (2). Du kan også omforme data til at være et 2D-array – som krævet til plotting – ved at brugereshape(n_rows, n_columns). Hvis et af parametrene er -1, beregnes den tilsvarende dimension automatisk.X = X[:, 2] X = X.reshape((-1,1))✅ Print altid data ud for at tjekke dets form.
-
Nu hvor du har data klar til at blive plottet, kan du se, om en maskine kan hjælpe med at bestemme et logisk skel mellem tallene i dette datasæt. For at gøre dette, skal du opdele både data (X) og mål (y) i test- og træningssæt. Scikit-learn har en simpel måde at gøre dette på; du kan opdele dit testdata på et givet punkt.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Nu er du klar til at træne din model! Indlæs den lineære regressionsmodel og træn den med dine X- og y-træningssæt ved at bruge
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()er en funktion, du vil se i mange ML-biblioteker såsom TensorFlow. -
Så lav en forudsigelse ved hjælp af testdata ved at bruge funktionen
predict(). Den vil blive brugt til at tegne linjen mellem datagrupperne.y_pred = model.predict(X_test) -
Nu er det tid til at vise data i en graf. Matplotlib er et meget nyttigt værktøj til denne opgave. Lav et spredningsplot af alle X- og y-testdata, og brug forudsigelsen til at tegne en linje på det mest passende sted mellem modellens datagrupper.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()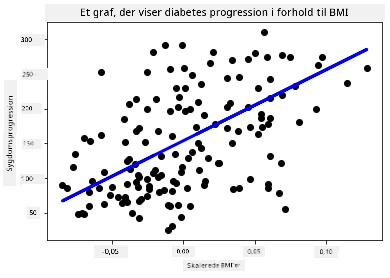
✅ Tænk lidt over, hvad der sker her. En lige linje løber gennem mange små datapunkter, men hvad gør den egentlig? Kan du se, hvordan du bør kunne bruge denne linje til at forudsige, hvor et nyt, uset datapunkt skal passe i forhold til plotets y-akse? Prøv at formulere den praktiske anvendelse af denne model.
Tillykke, du har bygget din første lineære regressionsmodel, lavet en forudsigelse med den og vist den i en graf!
🚀Udfordring
Plot en anden variabel fra dette datasæt. Hint: rediger denne linje: X = X[:,2]. Givet dette datasæts mål, hvad kan du opdage om progressionen af diabetes som sygdom?
Quiz efter lektionen
Gennemgang & Selvstudium
I denne vejledning arbejdede du med simpel lineær regression snarere end univariat eller multivariat lineær regression. Læs lidt om forskellene mellem disse metoder, eller tag et kig på denne video
Læs mere om begrebet regression og tænk over, hvilke slags spørgsmål der kan besvares med denne teknik. Tag denne tutorial for at uddybe din forståelse.
Opgave
Ansvarsfraskrivelse: Dette dokument er blevet oversat ved hjælp af AI-oversættelsestjenesten Co-op Translator. Selvom vi bestræber os på nøjagtighed, skal du være opmærksom på, at automatiserede oversættelser kan indeholde fejl eller unøjagtigheder. Det originale dokument på dets oprindelige sprog bør betragtes som den autoritative kilde. For kritisk information anbefales professionel menneskelig oversættelse. Vi påtager os intet ansvar for misforståelser eller fejltolkninger, der opstår som følge af brugen af denne oversættelse.