
20 KiB
ابدأ مع بايثون و Scikit-learn لنماذج الانحدار
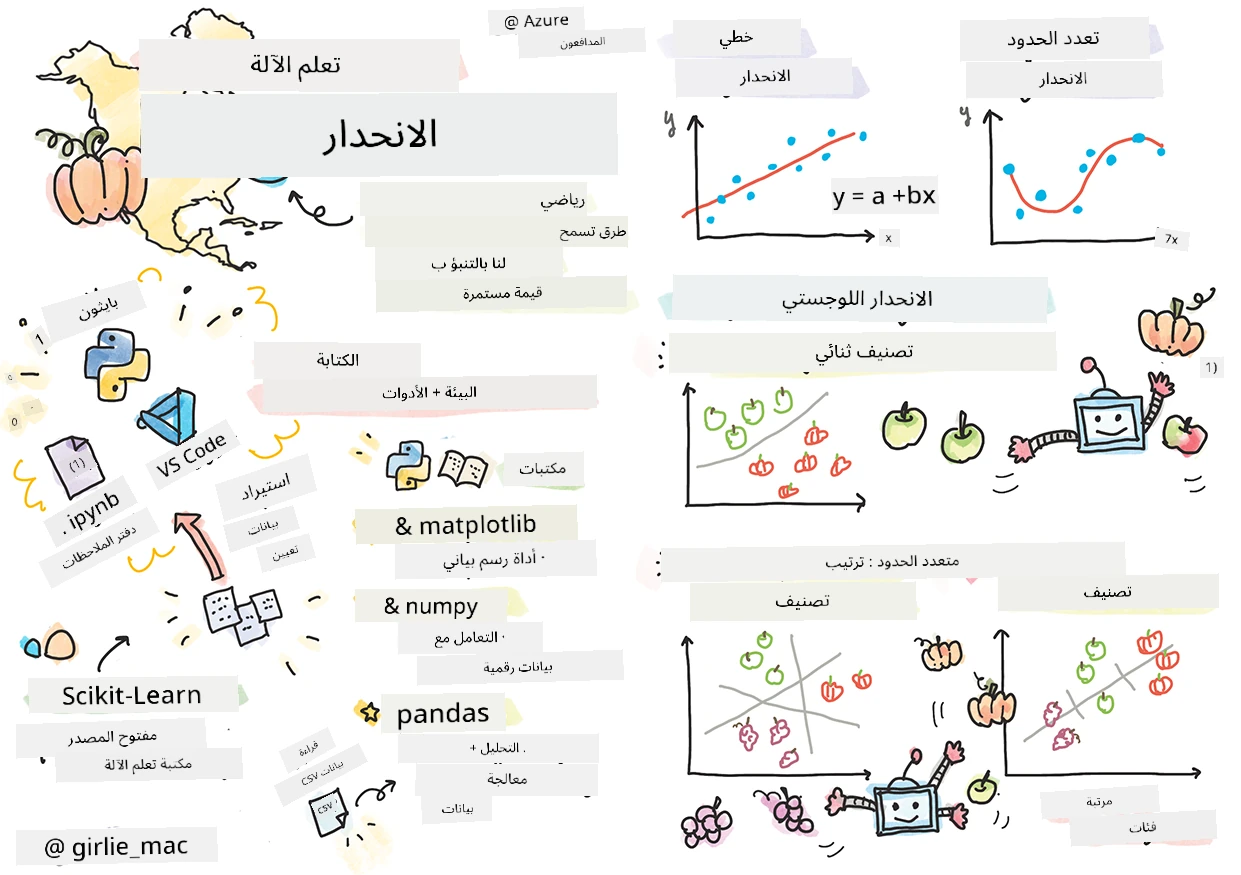
ملاحظة مرسومة بواسطة Tomomi Imura
اختبار ما قبل المحاضرة
هذه الدرس متوفر بلغة R!
المقدمة
في هذه الدروس الأربعة، ستكتشف كيفية بناء نماذج الانحدار. سنناقش الغرض منها قريبًا. ولكن قبل أن تفعل أي شيء، تأكد من أن لديك الأدوات المناسبة لبدء العملية!
في هذا الدرس، ستتعلم كيفية:
- تكوين جهاز الكمبيوتر الخاص بك لمهام التعلم الآلي المحلية.
- العمل مع دفاتر Jupyter.
- استخدام Scikit-learn، بما في ذلك التثبيت.
- استكشاف الانحدار الخطي من خلال تمرين عملي.
التثبيتات والتكوينات

🎥 انقر على الصورة أعلاه لمشاهدة فيديو قصير يشرح كيفية تكوين جهاز الكمبيوتر الخاص بك للتعلم الآلي.
-
ثبّت بايثون. تأكد من أن بايثون مثبت على جهاز الكمبيوتر الخاص بك. ستستخدم بايثون في العديد من مهام علوم البيانات والتعلم الآلي. معظم أنظمة الكمبيوتر تحتوي بالفعل على تثبيت بايثون. هناك حزم ترميز بايثون مفيدة أيضًا لتسهيل الإعداد لبعض المستخدمين.
بعض استخدامات بايثون تتطلب نسخة معينة من البرنامج، بينما يحتاج البعض الآخر لنسخة مختلفة. لذلك، من المفيد العمل ضمن بيئة افتراضية.
-
ثبّت Visual Studio Code. تأكد من تثبيت Visual Studio Code على جهاز الكمبيوتر الخاص بك. اتبع هذه التعليمات لـ تثبيت Visual Studio Code للتثبيت الأساسي. ستستخدم بايثون في Visual Studio Code خلال هذا الدورة، لذا قد ترغب في تعلم كيفية تكوين Visual Studio Code لتطوير بايثون.
تعرّف على بايثون من خلال العمل على مجموعة الوحدات التعليمية

🎥 انقر على الصورة أعلاه لمشاهدة فيديو: استخدام بايثون داخل VS Code.
-
ثبّت Scikit-learn، باتباع هذه التعليمات. بما أنك بحاجة للتأكد من استخدام بايثون 3، فمن المفضل استخدام بيئة افتراضية. ملاحظة، إذا كنت تثبت هذه المكتبة على جهاز Mac M1، هناك تعليمات خاصة في الصفحة المرتبطة أعلاه.
-
ثبّت Jupyter Notebook. ستحتاج إلى تثبيت حزمة Jupyter.
بيئة تأليف التعلم الآلي الخاصة بك
ستستخدم دفاتر الملاحظات لتطوير كود بايثون الخاص بك وإنشاء نماذج التعلم الآلي. هذا النوع من الملفات أداة شائعة لعلماء البيانات، ويمكن التعرف عليها من خلال اللاحقة أو الامتداد .ipynb.
الدفاتر هي بيئة تفاعلية تسمح للمطور بالبرمجة وإضافة الملاحظات وكتابة الوثائق حول الكود، وهو ما يكون مفيدًا جدًا للمشاريع التجريبية أو البحثية.

🎥 انقر على الصورة أعلاه لمشاهدة فيديو قصير يشرح هذا التمرين.
التمرين - العمل مع دفتر ملاحظات
في هذا المجلد، ستجد الملف notebook.ipynb.
-
افتح notebook.ipynb في Visual Studio Code.
سيبدأ خادم جوبتر مع بايثون 3+. ستجد مناطق في الدفتر يمكن
تشغيلها، وهي قطع من الكود. يمكنك تشغيل كتلة كود عن طريق اختيار الأيقونة التي تشبه زر التشغيل. -
اختر أيقونة
mdوأضف بعض ماركداون، مع النص التالي # مرحبًا بك في دفتر ملاحظاتك.ثم، أضف بعض كود بايثون.
-
اكتب print('hello notebook') في كتلة الكود.
-
اختر السهم لتشغيل الكود.
يجب أن ترى البيان المطبوع:
hello notebook
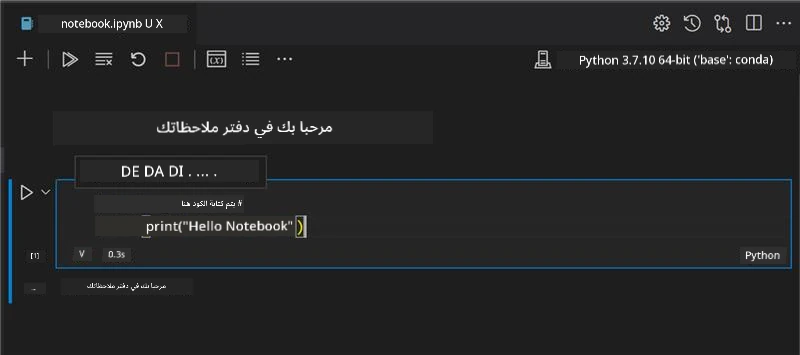
يمكنك مزج كودك مع تعليقات لتوثيق الدفتر بنفسك.
✅ فكّر لبرهة في مدى اختلاف بيئة عمل مطور ويب مقارنة بعالم بيانات.
تشغيل Scikit-learn
الآن بعد إعداد بايثون في بيئتك المحلية وأصبحت مرتاحًا مع دفاتر Jupyter، دعنا نتحلى بالراحة أيضًا مع Scikit-learn (تنطق ساي كما في science). يوفر Scikit-learn واجهة برمجة تطبيقات شاملة لمساعدتك في تنفيذ مهام التعلم الآلي.
وفقًا لموقعهم الرسمي، "Scikit-learn هو مكتبة تعلم آلي مفتوحة المصدر تدعم التعلم المراقب وغير المراقب. كما توفر أدوات مختلفة لتناسب النماذج، معالجة البيانات المسبقة، اختيار النماذج وتقييمها، والعديد من الأدوات المساعدة الأخرى."
في هذه الدورة، ستستخدم Scikit-learn وأدوات أخرى لبناء نماذج التعلم الآلي لتنفيذ ما نسميه مهام 'التعلم الآلي التقليدي'. لقد تجنبنا عمدًا الشبكات العصبية والتعلم العميق، لأنها مغطاة بشكل أفضل في منهج 'الذكاء الاصطناعي للمبتدئين' القادم.
يسهل Scikit-learn بناء النماذج وتقييمها للاستخدام. يركز بشكل رئيسي على استخدام البيانات الرقمية ويحتوي على عدة مجموعات بيانات جاهزة لاستخدامها كأدوات تعلم. كما يضم نماذج مدمجة لتجربتها من قبل الطلاب. دعونا نستكشف عملية تحميل بيانات جاهزة واستخدام نموذج مدمج لإنشاء أول نموذج تعلم آلي مع Scikit-learn باستخدام بيانات بسيطة.
تمرين - أول دفتر ملاحظات Scikit-learn لك
استوحي هذا الدرس من مثال الانحدار الخطي على موقع Scikit-learn.

🎥 انقر على الصورة أعلاه لمشاهدة فيديو قصير يشرح هذا التمرين.
في ملف notebook.ipynb المرفق بهذا الدرس، قم بمسح جميع الخلايا عن طريق الضغط على أيقونة 'سلة المهملات'.
في هذا القسم، ستعمل مع مجموعة بيانات صغيرة عن مرض السكري مدمجة في Scikit-learn لأغراض التعلم. تخيل أنك تريد اختبار علاج للمرضى المصابين بالسكري. قد تساعد نماذج التعلم الآلي في تحديد المرضى الذين سيستجيبون بشكل أفضل للعلاج بناءً على تركيبات من المتغيرات. حتى نموذج انحدار بسيط، عند تصويره، قد يوضح معلومات عن المتغيرات التي تساعد في تنظيم التجارب السريرية النظرية.
✅ هناك العديد من أنواع طرق الانحدار، والاختيار بينها يعتمد على الإجابة التي تبحث عنها. إذا كنت تريد التنبؤ بالطول المحتمل لشخص في عمر معين، ستستخدم الانحدار الخطي، لأنك تبحث عن قيمة رقمية. إذا كنت مهتمًا باكتشاف ما إذا كانت نوعية المطبخ يجب اعتبارها نباتية أم لا، فأنت تبحث عن تصنيف فئوي لذلك ستستخدم الانحدار اللوجستي. ستتعلم المزيد عن الانحدار اللوجستي لاحقًا. فكر قليلاً في بعض الأسئلة التي يمكنك طرحها على البيانات، وأي من هذه الطرق ستكون أكثر ملاءمة.
لنبدأ في هذه المهمة.
استيراد المكتبات
لهذه المهمة سنستورد بعض المكتبات:
- matplotlib. هي أداة رسم بياني مفيدة وسنستخدمها لإنشاء رسم خطي.
- numpy. numpy مكتبة مفيدة للتعامل مع البيانات الرقمية في بايثون.
- sklearn. هذه هي مكتبة Scikit-learn.
استورد بعض المكتبات لمساعدتك في المهام.
-
أضف الاستيرادات بكتابة الكود التالي:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
أعلاه تستورد
matplotlib،numpyوتستوردdatasets،linear_modelوmodel_selectionمنsklearn. تُستخدمmodel_selectionلتقسيم البيانات إلى مجموعات تدريب واختبار.
مجموعة بيانات مرض السكري
مجموعة بيانات مرض السكري المدمجة تشمل 442 عينة من البيانات حول مرض السكري، مع 10 متغيرات ميزات، بعض منها تشمل:
- العمر: العمر بالسنوات
- مؤشر كتلة الجسم
- ضغط الدم: متوسط ضغط الدم
- s1 tc: خلايا T (نوع من خلايا الدم البيضاء)
✅ تتضمن هذه المجموعة مفهوم 'الجنس' كمتغير ميزة مهم للبحث حول مرض السكري. العديد من مجموعات البيانات الطبية تتضمن هذا النوع من التصنيف الثنائي. فكر قليلاً كيف قد تستبعد التصنيفات مثل هذه أجزاء معينة من السكان من العلاجات.
الآن، قم بتحميل بيانات X و y.
🎓 تذكر، هذا تعلم مراقب، ونحتاج إلى هدف مسمى 'y'.
في خلية كود جديدة، حمّل مجموعة بيانات مرض السكري عن طريق استدعاء load_diabetes(). الإدخال return_X_y=True يشير إلى أن X ستكون مصفوفة بيانات، و y ستكون هدف الانحدار.
-
أضف بعض أوامر الطباعة لإظهار شكل مصفوفة البيانات وأول عنصر فيها:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
ما تحصل عليه كرد هو زوج مرتب. ما تفعله هو تعيين أول قيمتين من الزوج إلى
Xوyعلى التوالي. تعرف أكثر عن الأزواج المرتبة.يمكنك رؤية أن هذه البيانات تحتوي على 442 عنصرًا مرتبة في مصفوفات من 10 عناصر:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ فكّر قليلاً في العلاقة بين البيانات وهدف الانحدار. الانحدار الخطي يتنبأ بالعلاقات بين ميزة X والمتغير الهدف y. هل تستطيع العثور على الهدف لمجموعة بيانات مرض السكري في التوثيق؟ ماذا توضح هذه المجموعة بناءً على الهدف؟
-
بعد ذلك، اختر جزءًا من هذه المجموعة للرسم عن طريق اختيار العمود الثالث من المجموعة. يمكنك فعل ذلك باستخدام معامل
:لاختيار كل الصفوف، ثم اختيار العمود الثالث باستخدام الفهرس (2). يمكنك أيضًا إعادة تشكيل البيانات لتكون مصفوفة ثنائية الأبعاد - كما هو مطلوب للرسم - باستخدامreshape(n_rows, n_columns). إذا كان أحد المعلمات -1، يتم حساب البُعد الموافق تلقائيًا.X = X[:, 2] X = X.reshape((-1,1))✅ في أي وقت، اطبع البيانات للتحقق من شكلها.
-
الآن بعد أن أصبحت البيانات جاهزة للرسم، يمكنك معرفة ما إذا كان بإمكان آلة المساعدة في تحديد فصل منطقي بين الأرقام في هذه المجموعة. للقيام بذلك، تحتاج إلى تقسيم كلاً من البيانات (X) والهدف (y) إلى مجموعات اختبار وتدريب. لدى Scikit-learn طريقة مباشرة للقيام بذلك؛ يمكنك تقسيم بيانات الاختبار في نقطة معينة.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
الآن أنت جاهز لتدريب نموذجك! حمّل نموذج الانحدار الخطي ودربه باستخدام مجموعات تدريب X و y باستخدام
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()هي دالة تراها في العديد من مكتبات التعلم الآلي مثل TensorFlow -
ثم، أنشئ تنبؤًا باستخدام بيانات الاختبار، باستخدام الدالة
predict(). ستُستخدم هذه لرسم الخط بين مجموعات بيانات النموذج.y_pred = model.predict(X_test) -
حان الوقت الآن لعرض البيانات في رسم بياني. Matplotlib أداة مفيدة جدًا لهذا الغرض. أنشئ رسمًا نقطيًا لكل بيانات X و y في مجموعة الاختبار، واستخدم التنبؤ لرسم خط في المكان الأنسب بين مجموعات بيانات النموذج.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()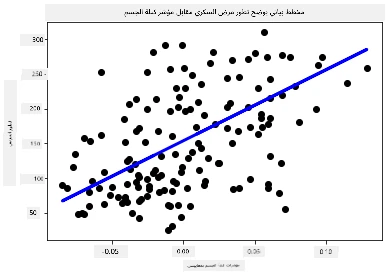
✅ فكّر قليلاً في ما يجري هنا. خط مستقيم يمر عبر العديد من النقاط الصغيرة من البيانات، لكن ما الذي يفعله بالضبط؟ هل ترى كيف ينبغي أن تستخدم هذا الخط لتوقع مكان نقطة بيانات جديدة غير مرئية بالنسبة لمحور y في الرسم؟ حاول أن تضع بالكلمات الاستخدام العملي لهذا النموذج.
مبروك، لقد بنيت أول نموذج انحدار خطي، أنشأت تنبؤًا به، وعرضته في رسم بياني!
🚀التحدي
ارسم متغيرًا مختلفًا من هذه المجموعة. تلميح: عدّل هذا السطر: X = X[:,2]. بناءً على هدف هذه المجموعة، ماذا يمكنك اكتشاف حول تطور مرض السكري كمرض؟
اختبار ما بعد المحاضرة
المراجعة والدراسة الذاتية
في هذا الدرس، عملت مع الانحدار الخطي البسيط، بدلاً من الانحدار الخطي الأحادي أو المتعدد. اقرأ قليلًا عن الفروقات بين هذه الطرق، أو شاهد هذا الفيديو
اقرأ المزيد عن مفهوم الانحدار وفكر في نوع الأسئلة التي يمكن الإجابة عليها بواسطة هذه التقنية. خذ هذا الدليل التعليمي لتعميق فهمك.
التعيين
تنويه: تمت ترجمة هذا المستند باستخدام خدمة الترجمة بالذكاء الاصطناعي Co-op Translator. بينما نسعى للدقة، يرجى العلم أن الترجمات الآلية قد تحتوي على أخطاء أو عدم دقة. يجب اعتبار المستند الأصلي بلغته الأصلية المصدر الرسمي والمعتمد. للمعلومات الهامة، يُنصح بالاستعانة بترجمة بشرية محترفة. نحن غير مسؤولين عن أي سوء فهم أو تفسير ناتج عن استخدام هذه الترجمة.