
16 KiB
Mətbəx qruplaşdırıcıları - hissə 1
Bu dərsdə əvvəlki dərsdən əldə etdiyimiz balanslı və təmizlənmiş mətbəx datasetindən istifadə edəcəksiniz.
Bu dataseti müxtəlif qruplaşdırıcılarda istifadə edərək inqrediyentlər əsasında milli mətbəxləri təxmin edəcəksiniz. Bunu edərkən alqoritmi başqa hansı qruplaşdırma tapşırıqlarında istifadə edə biləcəyinizi də öyrənəcəksiniz.
Mühazirədən əvvəl test
Hazırlıq
Sizin 1-ci dərsi bitirdiyinizi güman edirik. Əlavə olaraq isə bu 4 dərsdə istifadə edəcəyimiz cleaned_cuisines.csv faylının /data qovluğunda olduğundan əmin olun.
Tapşırıq - milli mətbəxi təxmin et
-
Bu dərsin qovluğunda olan notebook.ipynb faylını açın və aşağıdakı kodu (Pandas kitabxanasını) daxil edin:
import pandas as pd cuisines_df = pd.read_csv("../data/cleaned_cuisines.csv") cuisines_df.head()Yuxarıdakı kod, məlumatları belə çap edəcəkdir:
| Unnamed: 0 | cuisine | almond | angelica | anise | anise_seed | apple | apple_brandy | apricot | armagnac | ... | whiskey | white_bread | white_wine | whole_grain_wheat_flour | wine | wood | yam | yeast | yogurt | zucchini | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 0 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | 1 | indian | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 | 2 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 3 | 3 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 4 | 4 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
-
İndi isə digər kitabxanaları da əlavə edin:
from sklearn.linear_model import LogisticRegression from sklearn.model_selection import train_test_split, cross_val_score from sklearn.metrics import accuracy_score,precision_score,confusion_matrix,classification_report, precision_recall_curve from sklearn.svm import SVC import numpy as np -
X və y koordinatlarını öyrənmək üçün iki data qrupuna ayırın.
cuisinedata qrupunun adı ola bilər:cuisines_label_df = cuisines_df['cuisine'] cuisines_label_df.head()Nəticə belə görünəcək:
0 indian 1 indian 2 indian 3 indian 4 indian Name: cuisine, dtype: object -
Unnamed: 0vəcuisinesütunlarınıdrop()kodu ilə silin. Qalan məlumatları öyrənmə alqoritmi üçün saxlayın:cuisines_feature_df = cuisines_df.drop(['Unnamed: 0', 'cuisine'], axis=1) cuisines_feature_df.head()Artıq məlumatlar belə olacaq:
| almond | angelica | anise | anise_seed | apple | apple_brandy | apricot | armagnac | artemisia | artichoke | ... | whiskey | white_bread | white_wine | whole_grain_wheat_flour | wine | wood | yam | yeast | yogurt | zucchini | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 3 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 4 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
Modelimizi öyrətməyə hazır sayılırıq!
Qruplaşdırıcı seçimi
Artıq datanız təmizlənib və öyrədilmək üçün hazırdır. İndi siz bu iş üçün hansı alqoritmi seçməli olduğunuza qərar verməlisiniz.
Scikit-learn kitabxanası qruplaşdırmanı "Supervised Learning (Nəzarətli öyrənmə)" adı altında qruplaşdırır və siz burada çoxlu qruplaşdırma üsullarını tapa bilərsiniz. Seçimlər ilk baxışdan həddindən artıq çox görünəcəkdir. Aşağıdakı metodların hamısı qruplaşdırma texnikalarıdır:
- Linear Models (Xətti modellər)
- Support Vector Machines (Dəstək Vektor Maşını)
- Stochastic Gradient Descent (Stoxastik qradient eniş)
- Nearest Neighbors (Yaxın qonşular)
- Gaussian Processes (Qauss emalları)
- Decision Trees (Qərar sxemləri)
- Ensemble methods (voting Classifier) Ansambl üsullar (səsvermə əsaslı qruplaşdırma)
- Çoxsaylı etiket və çoxsaylı çıxış alqoritmləri (multiclass and multilabel classification, multiclass-multioutput classification)
Siz həmçinin qruplaşdırma üçün neyron şəbəkələr də istifadə edə bilərsiniz, lakin bu mövzu bizim dərsimizdən kənardır.
Hansı qruplaşdırıcı seçilməlidir?
İndi siz hansı qruplaşdırıcı seçməlisiniz? Adətən bunun cavabını bir çox üsulu yoxlamaq və daha yaxşı nəticə göstərəni seçməklə tapmaq olur. Yaratdığınız data qruplarını Scikit-learn kitabxanasında yanbayan müqayisə edə bilərsiniz. Aşağıda nümunə kimi KNeighbors, SVC two ways, GaussianProcessClassifier, DecisionTreeClassifier, RandomForestClassifier, MLPClassifier, AdaBoostClassifier, GaussianNB and QuadraticDiscrinationAnalysis alqoritmləri müqayisəsi göstərilib:
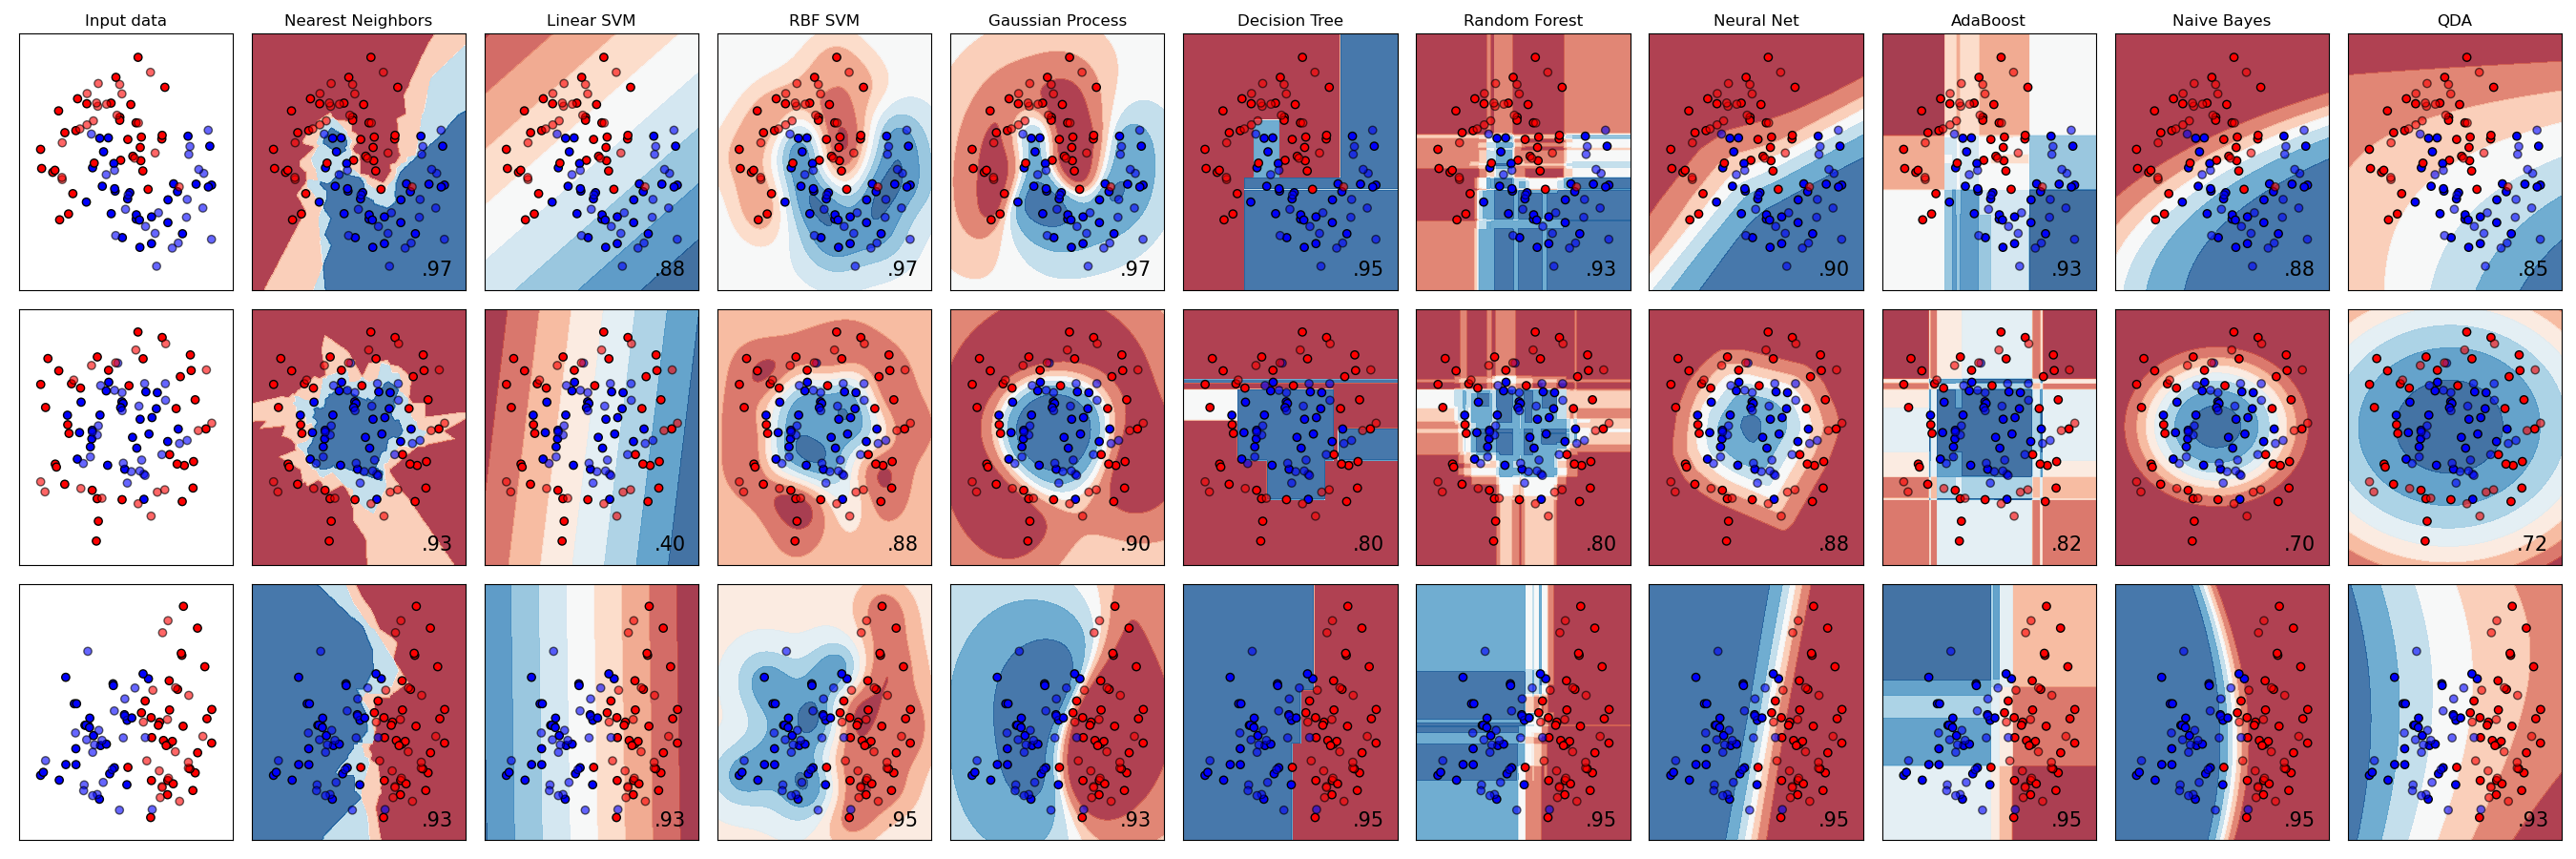
Qrafiklər Scikit-learn sənədlərindən yaradılmışdır
Auto ML platforması bulud mühitində belə nəticələri özü müqayisə edərək sizə ən yaxşı alqoritmi tapmaqda kömək edə bilər. Buradan pulsuz yoxlaya bilərsiniz.
Daha yaxşı yanaşma
Özünüz təxmin etməkdənsə, ML hazır cavablar siyahısından ideyalara əməl edərək daha yaxşı seçim edə bilərsiniz. Misal üçün bizim çoxsaylı etiketləndirmə məsələmizdə bir neçə seçim vardır:
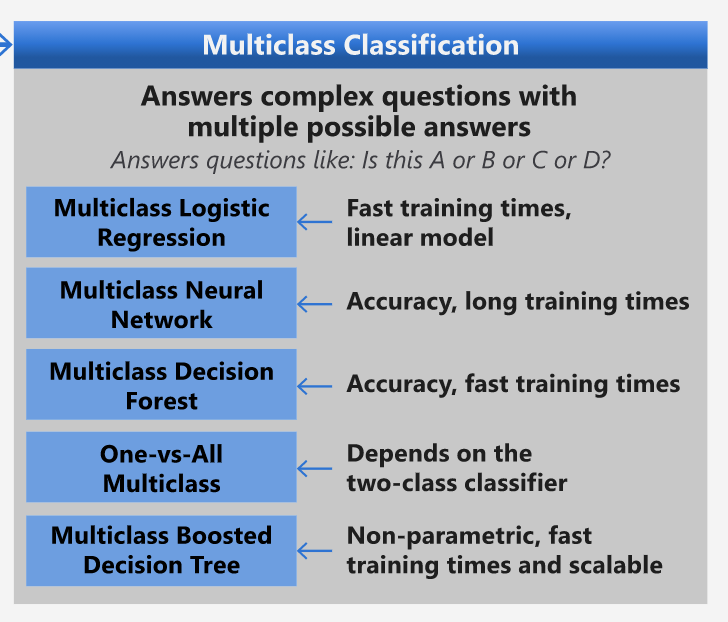
Çoxsaylı etiket qruplaşdırma seçimləri üçün Microsoft Alqoritm Hazır Cavablar siyahısından bir fraqment
✅ Bu hazır cavablar siyahısını yüklə, çap et və divardan as!
Əsaslandırma
Gəlin baxaq biz seçimimizi aşağıdakı şərtlərə əsasən də əsaslandıra bilirikmi:
- Neyron şəbəkələr çox qəlizdir. Bizim təmiz və sadə datasetimizi yalnız öz komputerimizdə öyrədəcəyimizi nəzərə alsaq, neyron şəbəkələr bu tapşırıq üçün çox çətin bir seçimdir.
- İki-etiket qruplaşdırıcısına yox. Biz iki-etiket qruplaşdırıcısı istifadə etmirik, buna görə də digər oxşar seçimləri nəzərə almırıq.
- Qərar sxemləri və ya logistik reqressiya işi görə bilər. Qərar sxemi işimizə yaraya bilər. Logistik reqressiyə isə çoxsaylı etiket datası üçün istifadə oluna bilər.
- Çoxsaylı etiket gücləndirilmiş qərar sxemləri başqa problemləri həll edir. Çoxsaylı etiket gücləndirilmiş qərar sxemləri parametirsiz tapşırıqlar üçün daha uyğundur, misal üçün sıralandırma tapşırıqları. Lakin bizim üçün uyğun deyil.
Scikit-learn istifadə etmək
Data analizi üçün Scikit-learn istifadə edəcəyik. Scikit-learn kitabxanasında logistik reqressiyanın istifadəsi üçün bir çox üsul mövcuddur. Hansı parametrlərin ötürülməsinin lazım olduğunu bilmək üçün sənədlə tanış olun.
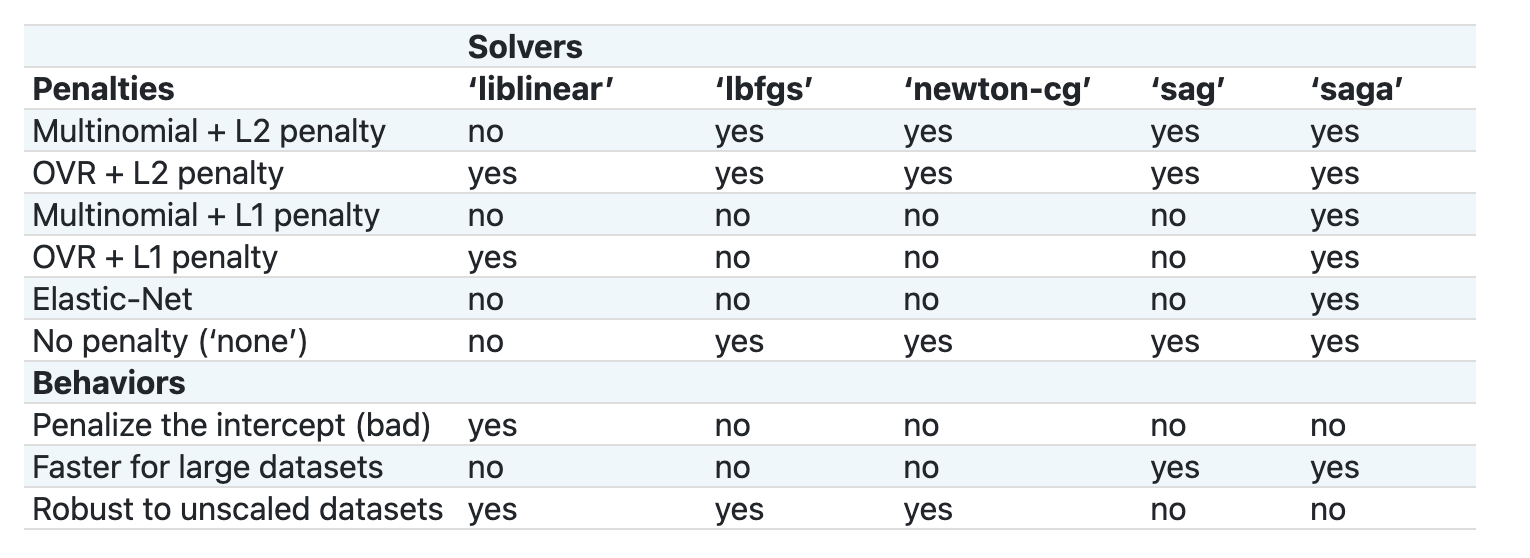
Scikit-learn kitabxanasında logistik reqressiyanı icra etmək üçün bizə əsas iki parametr ötürmək vacibdir - multi_class və solver. multi_class parametri müəyyən olunmuş davranışı bildirir. solver parametri isə istifadə olunacaq alqoritmi təyin edir. Nəzərə almaq lazımdır ki, hər alqoritm multi_class parametri ilə uyğunlaşmır.
Sənədlərə əsasən multi_class seçimində aşağıdakı öyrənmə alqoritmləri seçilə bilər:
- one-vs-rest (OvR) sxemi istifadə edənlər, əgər
multi_classparametriovrseçilmişdirsə. - cross-entropy loss (çarpaz-entropiya itkisi) istifadə edənlər, əgər
multi_classparametrimultinomialseçilmişdirsə. (Hazırdamultinomialseçimi yalnız ‘lbfgs’, ‘sag’, ‘saga’ və ‘newton-cg’ alqoritmləri tərəfindən dəstəklənir)"
🎓 Burada
'scheme'parametri 'ovr' (one-vs-rest) və ya 'multinomial' ola bilər. Logistik reqressiya əslində ikili qruplaşdırma üçün tərtib olunduğu üçün bu sxemlər çoxsaylı etiket qruplaşdırma tapşırıqları üçün daha uyğundur. mənbə
🎓
'solver'parametri "optimizasiya üçün istifadə olunacaq alqoritmi" nəzərdə tutur. mənbə.
Aşağıdakı cədvəldə Scikit-learn kitabxanasındakı alqoritmlərlə müxtəlif növ tapşırıqları və data strukturlarını necə idarə edə biləcəyiniz göstərilib:
Tapşırıq - datanı bölün
Biz indi ilk öyrənmə cəhdimizdə logistik reqressiyasına fokuslana bilərik. train_test_split() istifadə etməklə datanı öyrətmə və test üçün iki qrupa ayırın:
X_train, X_test, y_train, y_test = train_test_split(cuisines_feature_df, cuisines_label_df, test_size=0.3)
Tapşırıq - logistik reqressiyanın tətbiqi
Biz çoxsaylı etiket məsələsinə baxdığımız üçün scheme və solver parametrləri üçün müvafiq dəyərləri ötürməliyik. Bunun üçün çoxsaylı etiket (multiclass ovr) və liblinear alqoritmini seçin.
-
Logistik reqressiya modeli yaradın və
ovrdəyərini multi_class parametri,liblineardəyərini isə solver parametri kimi ötürün:lr = LogisticRegression(multi_class='ovr',solver='liblinear') model = lr.fit(X_train, np.ravel(y_train)) accuracy = model.score(X_test, y_test) print ("Accuracy is {}".format(accuracy))✅ Başqa bir alqoritmi seçib yoxlayın, misal üçün
lbfgs.Qeyd. Pandas kitabxanasında
ravelfunksiyasını istifadə edərək data modelinizi daha səthi (az-ölçülü) formaya keçirə bilərsiniz.Dəqiqliyin 80%-dən yuxarı olması yaxşıdır!
-
Siz bu modelin işlədiyini bir sətir data (#50-ci sıra) ilə yoxlaya bilərsiniz:
print(f'ingredients: {X_test.iloc[50][X_test.iloc[50]!=0].keys()}')
print(f'cuisine: {y_test.iloc[50]}')
Nəticə belə çap olunacaq:
ingredients: Index(['cilantro', 'onion', 'pea', 'potato', 'tomato', 'vegetable_oil'], dtype='object')
cuisine: indian
✅ Fərqli sıra nömrələrini yoxla və nəticəyə bax.
-
Daha dərinə getsək, qruplaşdırma modelinin dəqiqliyini belə yoxlaya bilərsiniz:
test= X_test.iloc[50].values.reshape(-1, 1).T
proba = model.predict_proba(test)
classes = model.classes_
resultdf = pd.DataFrame(data=proba, columns=classes)

topPrediction = resultdf.T.sort_values(by=[0], ascending = [False])
topPrediction.head()
Nəticə çap olundu - Hindisdan mətbəxi ən yuxarı dəqiqliklə qruplaşdırılır:
0 indian 0.715851 chinese 0.229475 japanese 0.029763 korean 0.017277 thai 0.007634 ✅ Bu modelin Hindistan mətbəxini nə üçün seçdiyini izah edə bilərsən?
-
Daha çox məlumat almaq üçün qruplaşdırma hesabatını çap edin:
y_pred = model.predict(X_test)
print(classification_report(y_test,y_pred))
precision recall f1-score support chinese 0.73 0.71 0.72 229 indian 0.91 0.93 0.92 254 japanese 0.70 0.75 0.72 220 korean 0.86 0.76 0.81 242 thai 0.79 0.85 0.82 254 accuracy 0.80 1199 macro avg 0.80 0.80 0.80 1199 weighted avg 0.80 0.80 0.80 1199
🚀 Məşğələ
Bu dərsdə siz təmizlənmiş data istifadə edərək inqrediyentlər əsasında milli mətbəxi təxmin edə biləcək maşın öyrənməsi modelini qurdunuz. Scikit-learn kitabxanası istifadə etməklə daha hansı üsullarla qruplaşdırma etmək mümkün olduğunu oxuyun. "Solver (alqoritm)" anlayışı üzərində daha dərinə gedərək arxa planda necə işlədiyini öyrənin.
Mühazirə sonrası test
Təkrarlayın və özünüz öyrənin
Logistik reqressiya metodunda hansı riyazı modellər istifadə olunduğunu bu dərsdə daha dərindən öyrənin.