
17 KiB
Reqressiya modellərinə Python və SciKit-learn ilə giriş
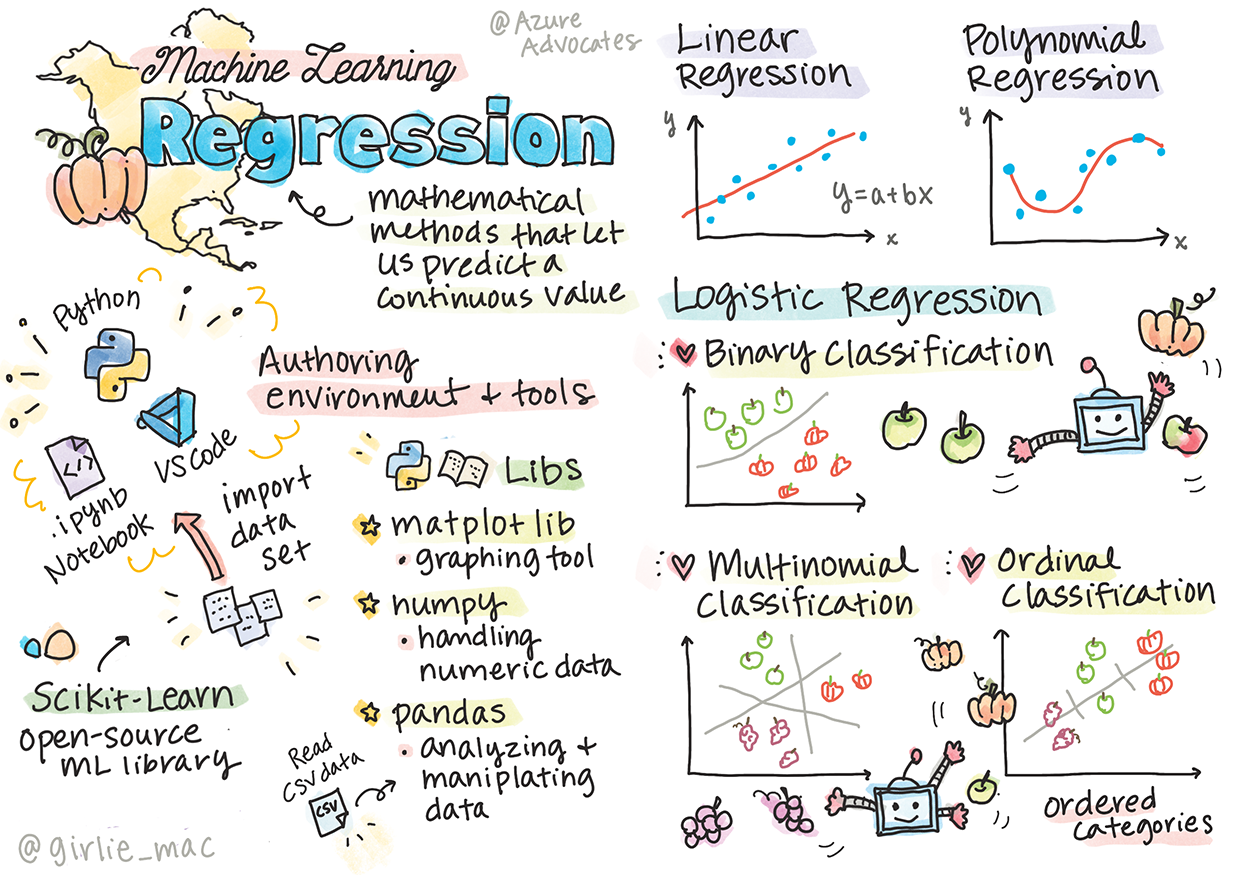
Tomomi Imura tərəfindən çəkilmiş eskiz
Mühazirədən əvvəl test
Bu dərs R proqramlaşdırma dili ilə də mövcuddur!
Giriş
Bu 4 dərsdə siz reqressiya modellərinin necə qurulmasını öyrənəcəksiniz. Qısa olaraq bu modellərin nə üçün olduğunu müzakirə edəcəyik. Amma ilk öncə, prosesi başlatmaq üçün lazım olan bütün alətlərinizin olduğundan əmin olun.
Bu dərsdə siz:
- Kompüterinizi lokal maşın öyrənməsi tapşırıqlarını icrası üçün konfiqurasiya etməyi
- Jupyter notbuklarla işləməyi
- SciKit-learn quraşdırmağı və istifadə etməyi
- Tətbiqi tapşırıqlarla xətti reqressiyanı kəşf etməyi
öyrənəcəksiniz.
Quraşdırılma və Konfiqurasiyalar

🎥 Kompüterin ML üçün konfiqurasiyasını izah edən qısa video üçün yuxarıdakı şəkilin üzərinə klikləyin.
-
Python yükləyin. Kompüterinizə Python yükləndiyinizdən əmin olun. Siz data elmi və maşın öyrənməsi tapşırıqlarının çoxu üçün Python-dan istifadə edəcəksiniz. Bəzi istifadəçilər üçün quraşdırmanı daha asan etmək məqsədilə yaradılmış faydalı Python Kodlaşdırma Paketləri də mövcuddur.
Amma istifadəsindən asılı olaraq Python üçün bəzən bir, bəzən isə digər versiyası tələb oluna bilər. Buna görə, virtual mühitdə işləmək daha məqsədəuyğundur.
-
Visual Studio Code yükləyin. Kompüterinizə Visual Studio Code yükləndiyindən əmin olun. Sadə formada Visual Studio Code yükləmək üçün bu təlimatları izləyə bilərsiniz. Bu kursda Python-u Visual Studio Code vasitəsilə istifadə edəcəyiniz üçün, ola bilər ki, Visual Studio Code-u Python proqramlaşdırma üçün necə konfiqurasiya edəcəyinizi öyrənmək istəyəsiniz.
Bu öyrənmə modulları siyahısından istifadə etməklə özünüzü Python-la tanış edin.

🎥 Python-un Visual Studio Code-da istifadəsi ilə bağlı video üçün yuxarıdakı şəkilə klikləyin.
-
Scikit-learn yükləyin. Bu təlimatları izləyərək yükləyin. Python 3-ü istifadə etdiyinizdən əmin olmalı olduğunuz üçün, virtual mühitdən istifadə etməyinizi tövsiyyə edirik. Qeyd olaraq onu deyək ki, əgər bu kitabxananı M prosessorlu Mac-lər üçün yükləyirsinizsə, səhifənin yuxarısında qeyd olunmuş linkdə xüsusi təlimatlar mövcuddur.
-
Jupyter Notebooks yükləyin. Jupyter paketini yükləməyiniz lazım olacaq.
ML tərtibatı üçün mühitiniz
Python kodları yazmaq və maşın öyrənməsi modellərini qurmanız üçün siz notbuklardan istifadə edəcəksiniz. Bu fayl tipi data mühəndisləri arasında geniş yayılmış alətdir və .ipynb uzantısı və yaxud suffiksi ilə ayırd oluna bilirlər.
Notbuklar proqramçılara kod yazmaq ilə yanaşı, həm kodda qeydlər etmək, həm də kodla bağlı dokumentasiya yazmağa imkan verdiyi üçün təcrübi və ya araşdırma yönümlü proyektlər üçün çox yararlı olan interaktiv bir mühitdir.

🎥 Bu tapşırığın üzərindən keçən qısa video üçün yuxarıdakı şəkilin üzərinə klikləyin.
Tapşırıq - notbuklarla iş
Bu qovluqda siz notebook.ipynb adlı faylı görəcəksiniz.
-
notebook.ipynb faylını Visual Studio Code-da açın.
Jupyter serveri Python 3+ ilə birgə başlayacaq. Dəftərçənin içərisində kod hissələrini icra edəcək
başlatsahəsini görəcəksiniz. "Play" düyməsinə bənzəyən ikonu seçərək kod bloklarını icra edə bilərsiniz. -
mdsimgəsini seçin və əvvəlcə "markdown", ardınca da # Notbuka xoş gəlmisiniz mətnini əlavə edin.Daha sonra, bir az Python kodunuzu əlavə edin.
-
Kod blokunda print('hello notebook') yazın.
-
Kodu başlatmaq üçün ox simgəsini seçin.
Bu ifadə ekranda çap olunacaq:
hello notebook
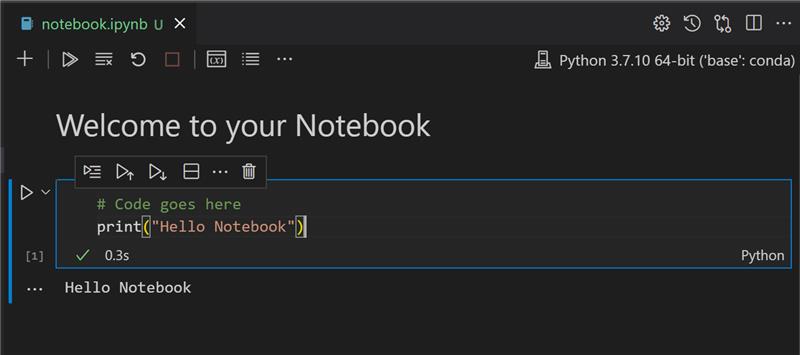
Notbuku sənədləşdirmək üçün öz kodunuza rəylər əlavə edə bilərsiniz.
✅ Bir dəqiqəliyinə veb proqramçısı ilə data mühitinin iş mühitinin necə fərqləndiyi barəsində düşünün.
Scikit-learn ilə işin icrası
Artıq lokal mühitinizi quraşdırdığınız və özünüzü Jupyter notbuklarına öyrəşdirdiyiniz üçün, keçək özümüzü Scikit-learn-lə(science sözündəki sci kimi tələffüz edin) də tanış edək. Scikit-learn ML tapşırıqlarını həll etmənizdə köməkçi olacaq geniş API təqdim edir.
Vebsaytlarına görə, "Scikit-learn açıq mənbə lisenziyalı, nəzarətli və nəzarətsiz öyrənməni dəstəkləyən maşın öyrənməsi kitabxanasıdır. O həmçinin model uyğunlaşdırılması, datanın ön-emalı, model seçilməsi və dəyərləndirilməsi kimi bir çox alətləri də təqdim edir.
Bu kursda siz, bizim 'ənənəvi maşın öyrənməsi' adlandırdığımız tapşırıqları maşın öyrənməsi modelləri qurmaqla həll etmək üçün Scikit-learn və digər alətlərdən istifadə edəcəksiniz.
Scikit-learn, modelləri qurmaq və onların istifadəyə yararlılığının dəyərləndirməsini asanlaşdırır. O ədədi məlumatlar üzərinə fokusludur və öyrənmə aləti olaraq istifadə olunması üçün bir neçə hazır məlumat massivinə məxsusdur. Əlavə olaraq daxilində tələbələrin təcrübə etməsi üçün öncədən qurulmuş bir neçə model də mövcuddur. Gəlin əvvəlcədən paketlənmiş dataların yüklənməsini və bəzi əsas datalarla Scikit-learn ilə öncədən qurulmuş qiymətləndirmə ML modelindən istifadə edilməsini araşdıraq.
Tapşırıq - sizin ilk Scikit-learn notbukunuz
Bu təlimat Scikit-learn-ün vebsaytındakı xətti reqressiya modelindən ilhamlanmışdır.

🎥 Bu tapşırığın üzərindən keçən qısa video üçün yuxarıdakı şəkilin üzərinə klikləyin.
Bu dərslə əlaqəli olan notebook.ipynb faylında 'zibil qutusu' simgəsinə klikləyərək bütün xanaları təmizləyin.
Bu bölmədə siz Scikit-learn-də öyrənmə məqsədi üçün əvvəlcədən hazırlanmış şəkərli diabet xəstələri ilə bağlı olan kiçik data seti ilə işləyəcəksiniz. Maşın öyrənməsi modelləri dəyişənlərin kombinasiyası əsasında hansı xəstələrin müalicəyə daha yaxşı cavab verə biləcəyini müəyyən etməyə kömək edə bilər. Hətta ən sadə reqressiya modeli belə vizuallaşdırıldıqda nəzəri klinik sınaqlarınızı təşkil etməkdə sizə kömək edəcək dəyişənlər haqqında məlumat verə bilər.
✅ Reqressiya metodlarının bir çox növü mövcud olsa da, hansını seçməyiniz axtardığınız cavabdan asıldır. Əgər insanın yaşına uyğun boyunun hündürlüyünü təxmin etmək istəyirsinizsə, bu məlumat *ədədi dəyərə malik olduğu üçün xətti reqressiyadan istifadə edə bilərsiniz. Yox əgər hansısa mətbəxin veqan hesab edilib-edilməməli olduğunu tapmaqla maraqlanırsınızsa, deməli kateqoriya mənimsədilməsini axtarırsınız. Bunun üçün logistik reqressiyadan istifadə edə bilərsiniz. Logistik reqressiyalar haqqında sonradan daha çox öyrənəcəksiniz. Məlumatlarla bağlı soruşa biləcəyiniz suallar və bu metodlardan hansının daha uyğun ola biləcəyi ilə bağlı isə biraz düşünün.
Gəlin bu tapşırıqla başlayaq.
Kitabxanaları köçürün
Bu tapşırıq üçün biz bəzi kitabxanaları köçürəcəyik:
- matplotlib lazımlı qrafikləşdirmə alətidir və biz ondan xətti qrafikləri yaratmaq üçün istifadə edəcəyik.
- numpy. numpy Python-da ədədi dataların emalı üçün faydalı bir kitabxanadır.
- sklearn. Bu isə Scikit-learn kitabxanasıdır.
Tapşırıqda sizə kömək olması üçün kitabxanalardan bəzilərini köçürün.
-
Aşağıdakı kodu yazaraq köçürmələri edək:
import matplotlib.pyplot as plt import numpy as np from sklearn import datasets, linear_model, model_selectionYuxarıda siz
matplotlib-i,numpy-ı vəsklearn-dəndatasets,linear_modelvəmodel_selection-ı köçürürsünüz.model_selectiondatanı öyrədilmə və test massivlərinə bölmək üçün istifadə olunur.
Şəkərli diabet data seti
Öncədən qurulmuş olan şəkərli diabet data setinə 10 xüsusiyyət dəyişəni olmaqla bu xəstəliklə bağlı 442 nümunə daxildir. Xüsusiyyət dəyişənlərinin bəziləri aşağıdakılardır:
- age: illər ilə yaş
- bmi: bədənin çəki indeksi
- bp: eortalama qan təzyiqi
- s1 tc: T-hüceyrələri (ağ qan hüceyrələrinin növü)
✅ Bu data setinə şəkərli diabet haqqında araşdırma etmək üçün önəmli bir xüsusiyyət dəyişəni olaraq 'cins' anlayışı da daxildir. Əksər tibbi data setinə bu tip ikili sinifləndirmə daxil edilir. Bir qədər bu formada kateqoriyalaşdırılmanın əhalinin bir qismini müalicələrdən necə kənarda tuta biləcəyi barəsində düşünün.
İndi isə, X və y datalarını yükləyək.
🎓 Yadda saxlayın ki, bu nəzarətli öyrənmə olduğuna görə 'y' adlı hədəfə ehtiyacımız var.
Yeni kod xanasında, şəkərli diabet data setini load_diabetes() çağıraraq yükləyin. Verilən return_X_y=True, X-in bir data matrisi, y-in isə reqressiya hədəfi olacağını göstərir.
-
Data matrisinin formasını və ilk elementini göstərmək üçün bir neçə "print" komandası əlavə edin:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Cavab olaraq aldığınız şey - tuple adlanır. Etdiyiniz isə tuple-un ilk iki dəyərini sıra ilə
Xvəy-ə mənimsətməkdir. Tuple haqqında ətraflı buradan öyrənin.Gördüyünüz kimi bu məlumat, 10 elementli massivi olan 442 sətirdən ibarətdir:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Data və reqressiya hədəfi arasındakı əlaqə barəsində biraz düşünün. Xətti reqressiya X xüsusiyyəti ilə y dəyişəni arasındakı əlaqəni təxmin edir. Dokumentasiyada şəkərli diabet data setindəki hədəfi tapa bilərsiniz? Bu data massivi hədəf nəzərdə tutulduqda nəyi təsvir edir?
-
Növbəti olaraq qrafiki təsvir üçün bu data setinin 3-cü sütununu seçin. Bunu
:operatoru ilə bütün sıraları seçərək və daha sonraindex(2)ilə bütün sütunları seçərək edə bilərsiniz. Əlavə olaraq siz datanı qrafiki təsvir üçün tələb olunduğuna görəreshape(n_rows, n_columns)istifadə edərək 2 ölçülü massiv formasına də sala bilərsiniz.X = X[:, 2] X = X.reshape((-1,1))✅ İstənilən vaxt datanın quruluşunu yoxlamaq üçün məlumatı ekrana çap edə bilərsiniz.
-
Artıq qrafikləşdirilə bilən datanız olduğu üçün maşının bu data setindəki rəqəmlər arasındakı məntiqi bölgünü təyin etməyə yardımçı ola bilib-bilmədiyini görə bilərsiniz. Bunun üçün hər iki (X) və hədəf (y) datalarını test və öyrətmə setlərinə ayırmağınıza ehtiyacınız var. Scikit-learn-ün bunu etmək üçün sadə bir yolu var; istənilən nöqtədə test datanızı ayıra bilərsiniz.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Artıq modelinizi öyrətmək üçün hazırsınız! Xətti reqressiya modelinizi yükləyin və onu
model.fit()istifadə edərək, X və y öyrətmə massivləri ilə öyrədin:model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()TensorFlow kimi birçox ML kitabxanasında görə biləcəyiniz bir funksiyadır. -
Daha sonra, test datasından və
predict()funksiyasından istifadə etməklə proqnoz yaradın. Bu proqnoz data qrupları arasındakı xəttin çəkilməsi üçün istifadə olunacaq.y_pred = model.predict(X_test) -
Artıq datanı qrafiklə göstərməyin vaxtıdır. Matplotlib bu tapşırıq üçün çox uyğun bir alətdir. Bütün X və y test məlumatlarının paylanma qrafikini yaradın və modelin data qrupları arasında ən uyğun yerə xətti çəkmək üçün proqnozdan istifadə edin.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()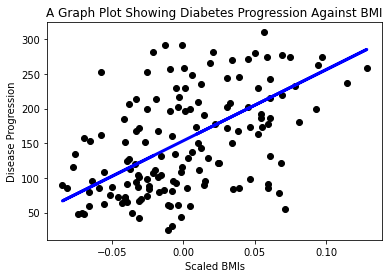
✅ Bu hissədə nə baş verdiyi barədə biraz düşünün. Düz xətt çoxlu kiçik data nöqtələrinin arasından keçir. Amma tam olaraq nə baş verir? Yeni, görünməz məlumat nöqtəsinin qrafikin y oxuna nisbətən harada olacağını proqnozlaşdırmaq üçün bu xəttdən necə istifadə edə biləcəyinizi düşünə bilirsinizmi? Bu modelin praktiki istifadəsini sözlə ifadə etməyə çalışın.
İlk reqressiya modelinizi qurduğunuz, onunla proqnoz yaradıb və təsvir etdiyiniz üçün təbriklər!
🚀 Məşğələ
Bu data setindən fərqli bir dəyişən üçün qrafik çəkin. İpucu: bu sətirə düzəliş edin: X = X[:,2]. Data massivinin hədəfi verilmək şərti ilə şəkərli diabetin xəstəlik olaraq inkişafı ilə bağlı nələri tapa bilərsiniz?
Mühazirə sonrası test
Təkrarlayın və özünüz öyrənin
Bu təlimatda çoxdəyişənli və yaxud çoxlu xətti reqressiya yerinə,sadə xətti reqressiya ilə işlədiniz. Bu metodlar arasındakı fərqlər barəsində oxuyun və ya bu videoya nəzər salın.
Reqressiya konsepti haqqında oxuyun və bu texnika vasitəsilə hansı tip suallara cavab tapıla bildiyi barəsində düşünün. Anlayışınızı dərinləşdirmək üçün bu təlimatı keçin.