
20 KiB
ARIMA ilə zaman seriyalarının proqnozlaşdırılması
Əvvəlki dərsdə siz zaman sıralarının proqnozlaşdırılması haqqında öyrəndiniz. Əlavə olaraq isə, zamanla elektrik yükünün dalğalanmalarını göstərən verilənlər toplusunu yüklədiniz.
🎥 Video üçün yuxarıdakı şəkilə klikləyin: ARIMA modellərinə qısa giriş. Nümunə R dilində olsa da, anlayışlar universaldır.
Mühazirə öncəsi quiz
Giriş
Bu dərsdə siz ARIMA: AutoRegressive Iinteqrasiya edilmiş Moving Average ilə modellər qurmağın xüsusi üsulunu kəşf edəcəksiniz. ARIMA modelləri qeyri-stasionarlığı göstərən datalara uyğunlaşdırılmışdır.
Ümumi anlayışlar
ARIMA ilə işləyə bilmək üçün bilməli olduğunuz bəzi anlayışlar var:
-
🎓 Stasionarlıq. Statistik kontekstdən götürsək, stasionarlıq, zaman dəyişsə də paylanması dəyişməyən datalara aid bir anlayışdır. Beləliklə, qeyri-stasionar data, təhlil edilmək üçün transformasiya edilməli olan tendensiyalara görə dalğalanmaları göstərir. Məsələn, mövsümilik, məlumatlarda dalğalanmalar yarada bilər və “mövsümi fərqləndirmə” prosesi ilə aradan qaldırıla bilər.
-
🎓 Fərqləndirmə. Fərqləndirmə, yenə də statistik kontekstdən götürsək, qeyri-stasionar məlumatların qeyri-sabit tendensiyasını aradan qaldıraraq stasionar hala gətirmək üçün çevrilməsi prosesinə deyilir. "Fərqləndirmə zaman seriyasının səviyyəsindəki dəyişiklikləri, trend və mövsümiliyi aradan qaldırır və nəticədə zaman seriyasının orta dəyərini sabitləşdirir." Shixiong və digərlərinin müəllifi olduğu məqalə
ARIMA zaman seriyası kontekstində
ARIMA-nın vaxt seriyalarını modelləşdirməyə və ona qarşı proqnozlar verməyə necə kömək etdiyini araşdıraq.
-
AR - AvtoReqressiv. Avtoreqressiv modellər, adından da göründüyü kimi, məlumatlarınızdakı əvvəlki dəyərləri təhlil etmək və onlar haqqında fərziyyələr irəli sürmək üçün zamanda "geriyə" baxır. Həmin əvvəlki dəyərlər “geriləmiş” adlanır. Məsələn, qələmlərin aylıq satışını göstərən məlumatlar. Hər ayın ümumi satışları datasetdə "inkişaf edən dəyişən" hesab olunacaq. Bu model "inkişaf edən maraq dəyişəninin öz geridə qalmış (yəni əvvəlki) dəyərlərinə dönməsi" kimi qurulmuşdur. wikipediax
-
I - İnteqrasiya. Oxşar "ARMA" modellərindən fərqli olaraq, ARIMA-dakı "I" onun inteqrasiya edilmiş olmasına işarə edir. Qeyri-stasionarlığı aradan qaldırmaq üçün fərqli addımlar tətbiq edildikdə məlumatlar “inteqrasiya olunur”.
-
MA - Moving Average(Dəyişkən Orta Dəyər). Bu modelin dəyişkən orta dəyər aspekti geriləmiş dəyərlərin cari və keçmiş qiymətlərini müşahidə etməklə müəyyən edilən çıxış dəyişəninə aiddir.
Qeyd: ARIMA modeli zaman seriyası məlumatlarının xüsusi formasına mümkün qədər yaxından uyğunlaşdırmaq üçün istifadə olunur.
Tapşırıq - ARIMA modelini qurun
Bu dərsin /working qovluğunu açın və [notebook.ipynb] faylını tapın (https://github.com/microsoft/ML-For-Beginners/blob/main/7-TimeSeries/2-ARIMA/working/notebook.ipynb).
-
ARIMA modellərində sizə lazım olacaq
statsmodelsPython kitabxanasını yükləmək üçün dəftərçəni işə salın. -
Lazımi kitabxanaları yükləyin
-
İndi verilənlərin planlaşdırılması üçün faydalı olan daha bir neçə kitabxana yükləyin:
import os import warnings import matplotlib.pyplot as plt import numpy as np import pandas as pd import datetime as dt import math from pandas.plotting import autocorrelation_plot from statsmodels.tsa.statespace.sarimax import SARIMAX from sklearn.preprocessing import MinMaxScaler from common.utils import load_data, mape from IPython.display import Image %matplotlib inline pd.options.display.float_format = '{:,.2f}'.format np.set_printoptions(precision=2) warnings.filterwarnings("ignore") # specify to ignore warning messages -
/data/energy.csvfaylından məlumatları Pandas datafreyminə yükləyin və nəzər salın:energy = load_data('./data')[['load']] energy.head(10) -
2012-ci ilin yanvarından 2014-cü ilin dekabrına qədər mövcud olan bütün enerji məlumatlarının qrafikini tərtib edin. Son dərsdə bu dataları gördüyümüz üçün heç bir qaranlıq məqam olmamalıdır:
energy.plot(y='load', subplots=True, figsize=(15, 8), fontsize=12)
plt.xlabel('timestamp', fontsize=12)
plt.ylabel('load', fontsize=12)
plt.show()
İndi, modeli quraq!
Öyrətmə və test data setlərini yaradın
İndi datalarımız yükləndi, beləliklə siz onları öyrətmə və test dəstlərinə ayıra bilərsiniz. Modelinizi öyrətmə dəstində öyrədəcəksiniz. Həmişə olduğu kimi, modelin öyrədilməsini bitirdikdən sonra siz test setindən istifadə edərək onun düzgünlüyünü qiymətləndirəcəksiniz. Modelin gələcək zaman dilimlərindən məlumat əldə etməməsini təmin etmək üçün test setinin, öyrətmə setindən sonrakı dövrü əhatə etdiyinə əmin olmalısınız.
-
Öyrətmə setinə 2014-cü il sentyabrın 1-dən oktyabrın 31-dək iki aylıq müddət ayırın. Data setinə 2014-cü il noyabrın 1-dən dekabrın 31-dək olan iki aylıq dövr daxildir:
train_start_dt = '2014-11-01 00:00:00'
test_start_dt = '2014-12-30 00:00:00'
Bu məlumatlar gündəlik enerji istehlakını əks etdirdiyi üçün güclü mövsümi model var, lakin istehlak son günlərdəki istehlakla daha çox oxşardır.
-
Fərqləri vizuallaşdırın:
energy[(energy.index < test_start_dt) & (energy.index >= train_start_dt)][['load']].rename(columns={'load':'train'}) \
    .join(energy[test_start_dt:][['load']].rename(columns={'load':'test'}), how='outer') \
    .plot(y=['train', 'test'], figsize=(15, 8), fontsize=12)
plt.xlabel('timestamp', fontsize=12)
plt.ylabel('load', fontsize=12)
plt.show()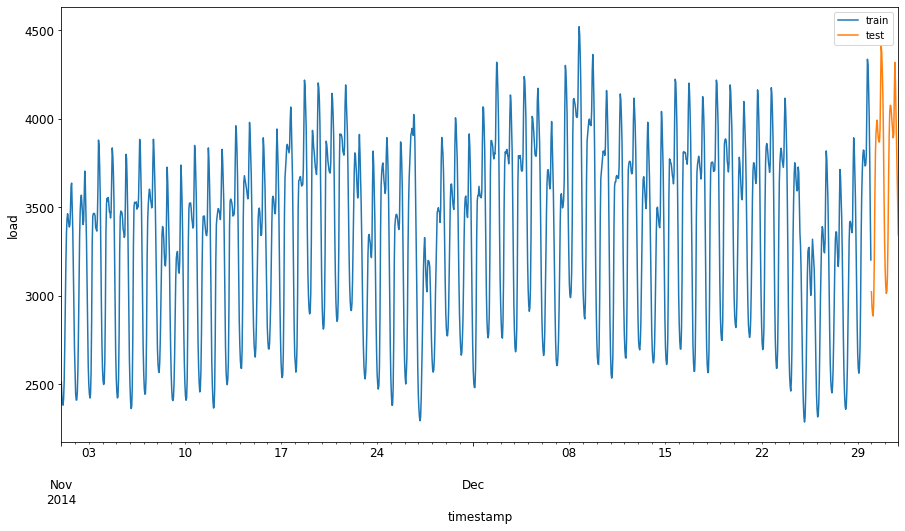
Buna görə də, öyrətmə dataları üçün nisbətən kiçik bir zaman pəncərəsindən istifadə etmək bizə kifayət edəcək.
Qeyd: ARIMA modelinə uyğunlaşdırmaq üçün istifadə etdiyimiz funksiya, uyğunlaşdırma zamanı nümunədaxili yoxlamadan istifadə etdiyi üçün, təsdiqləmə məlumatlarını ortadan qaldıracağıq.
Dataları öyrədilmək üçün hazırlayın
İndi siz datalarınızı filterləyərək və miqyasını dəyişdirərək onları öyrədilmək üçün hazırlamalısınız. Yalnız sizə lazım olan vaxt dövrləri və sütunları daxil etmək üçün data dəstinizi filterləyin və məlumatların 0,1 intervalında proqnozlaşdırılmasını təmin etmək üçün miqyaslayın.
-
Data setini hər birində yalnız yuxarıda qeyd olunan vaxt dövrlərini və yalnız lazım olan "yük" sütununu özündə saxlayacaq şəkildə filterləyin:
train = energy.copy()[(energy.index >= train_start_dt) & (energy.index < test_start_dt)][['load']] test = energy.copy()[energy.index >= test_start_dt][['load']] print('Training data shape: ', train.shape) print('Test data shape: ', test.shape)Datanın formasını görə bilərsiniz:
Training data shape: (1416, 1) Test data shape: (48, 1) -
Dataları (0, 1) intervalında miqyaslandırın.
scaler = MinMaxScaler() train['load'] = scaler.fit_transform(train) train.head(10) -
Orijinal və miqyaslı dataları vizuallaşdırın:
energy[(energy.index >= train_start_dt) & (energy.index < test_start_dt)][['load']].rename(columns={'load':'original load'}).plot.hist(bins=100, fontsize=12)
train.rename(columns={'load':'scaled load'}).plot.hist(bins=100, fontsize=12)
plt.show()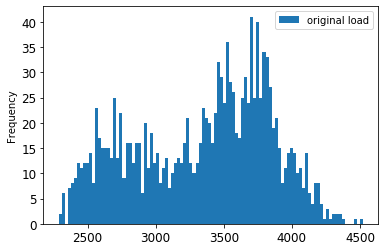
Orijinal data
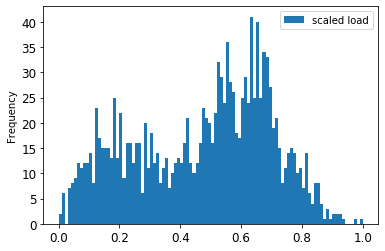
Miqyaslanmış data
-
Artıq miqyaslanmış datanı kalibrasiya etdiyimiz üçün, test dalarını miqyaslaya bilərik:
test['load'] = scaler.transform(test)
test.head()
ARIMA-ın icrası
ARIMA-nı icra etməyin vaxtı gəldi çatdı! İndi siz bir az əvvəl yüklədiyiniz statsmodels kitabxanasından istifadə edəcəksiniz.
İzləməli olduğumuz bir neçə addım var
1. `SARIMAX()` çağırmaqla və p, d, q, P, D və Q parametrlərini daxil etməklə modeli təyin edin.
2. fit() funksiyasını çağıraraq modeli öyrətmə dataları üçün hazırlayın.
3. `forecast()` funksiyasını çağıraraq və təxmin etmək üçün addımların sayını (`horizon`) müəyyən etməklə proqnozlaşdırmanı icra edin.
🎓 Bütün bu parametrlər nə üçündür? ARIMA modelində zaman seriyasının əsas aspektlərini modelləşdirməyə kömək etmək üçün istifadə olunan 3 parametr var: mövsümilik, trend və küy. Bu parametrlər bunlardır:
p: keçmiş dəyərləri özündə birləşdirən modelin avtoreqressiv aspekti ilə əlaqəli parametr.
d: zaman seriyasına tətbiq etmək üçün fərqlənmənin (🎓fərqlənməni xatırlayırsınız 👆?) miqdarına təsir edən modelin inteqrasiya olunmuş hissəsi ilə əlaqəli parametr.
q: modelin orta hərəkətli hissəsi ilə əlaqəli parametr.
Qeyd: Əgər məlumatınızın mövsümi aspekti varsa - indi istifadə etdiyimiz mövsümi ARIMA modeli(SARIMA) bunu edir. Bu halda siz başqa parametrlər dəstindən istifadə etməlisiniz:
p,dvəqilə eyni assosiasiyaları təsvir edən, lakin modelin mövsümi komponentlərə uyğun gələnP,DvəQdəsti.
-
Üstün bildiyiniz üfüq dəyərini təyin etməklə başlayın. Gəlin 3 saatı üfüq dəyəri olaraq yoxlayaq:
# Specify the number of steps to forecast ahead
HORIZON = 3
print('Forecasting horizon:', HORIZON, 'hours')
ARIMA modelinin parametrləri üçün ən yaxşı dəyərləri seçmək bir qədər subyektiv olduğu və vaxt tələb etdiyi üçün çətin ola bilər. Bu hallarda
pyramidkitabxanasınınauto_arima()funksiyasından istifadə edə bilərsiniz. -
Yaxşı model tapmaq üçün hələlik əl ilə seçimləri yoxlayın.
order = (4, 1, 0)
seasonal_order = (1, 1, 0, 24)

model = SARIMAX(endog=train, order=order, seasonal_order=seasonal_order)
results = model.fit()

print(results.summary())
Nəticələrin cədvəli ekranda çap olunur.
İlk modelinizi yaratdınız! İndi biz bunu qiymətləndirməyin yolunu tapmalıyıq.
Modelinizi qiymətləndirin
Modelinizi qiymətləndirmək üçün siz irəli gəzinti deyilən yoxlamanı həyata keçirə bilərsiniz. Praktikada, zaman seriyası modelləri, hər təzə məlumat əldə edildikdə, yenidən öyrədilir. Bu, modelə hər zaman addımında ən yaxşı proqnozu verməyə imkan verir.
Həmin texnikadan istifadə edərək zaman seriyasının əvvəlindən başlayaraq, öyrətmə data setində modeli öyrədin. Sonra növbəti addım üçün proqnoz verin. Proqnoz bilinən dəyərlə qiymətləndirilir. Daha sonra öyrətmə seti məlum dəyəri daxil etmək üçün genişləndirilir və proses təkrarlanır.
Qeyd: Daha səmərəli öyrədilmə üçün siz öyrətmə setinin pəncərə ölçüsünü sabit saxlamalısınız ki, hər dəfə təlim dəstinə yeni müşahidə əlavə etdikdə, müşahidəni setin əvvəlindən siləsiniz.
Bu proses modelin praktikada necə işləyəcəyinə dair daha etibarlı təxmin verir. Bununla belə, bu qədər model yaratmağın hesablama xərcləri də var. Data kiçikdirsə və ya model sadədirsə, bu məqbuldur, lakin daha böyük miqyaslarda bu problemə səbəb ola bilər.
İrəli gəzinti üsulu vaxt seriyası modelinin qiymətləndirilməsinin qızıl standartıdır və öz layihələriniz üçün də tövsiyə olunur.
-
Əvvəlcə hər HORIZON addımı üçün test məlumat nöqtəsi yaradın.
test_shifted = test.copy()

for t in range(1, HORIZON+1):
    test_shifted['load+'+str(t)] = test_shifted['load'].shift(-t, freq='H')

test_shifted = test_shifted.dropna(how='any')
test_shifted.head(5)
load load+1 load+2 2014-12-30 00:00:00 0.33 0.29 0.27 2014-12-30 01:00:00 0.29 0.27 0.27 2014-12-30 02:00:00 0.27 0.27 0.30 2014-12-30 03:00:00 0.27 0.30 0.41 2014-12-30 04:00:00 0.30 0.41 0.57 Məlumatlar üfüq nöqtəsinə uyğun olaraq üfüqi olaraq sürüşdürülür.
-
Test datasının uzunluğunun döngü ölçüsündə, sürüşən pəncərə yanaşmasından istifadə edərək test datalarınızla bağlı proqnozlar verin:
%%time
training_window = 720 # dedicate 30 days (720 hours) for training

train_ts = train['load']
test_ts = test_shifted

history = [x for x in train_ts]
history = history[(-training_window):]

predictions = list()

order = (2, 1, 0)
seasonal_order = (1, 1, 0, 24)

for t in range(test_ts.shape[0]):
    model = SARIMAX(endog=history, order=order, seasonal_order=seasonal_order)
    model_fit = model.fit()
    yhat = model_fit.forecast(steps = HORIZON)
    predictions.append(yhat)
    obs = list(test_ts.iloc[t])
    # move the training window
    history.append(obs[0])
    history.pop(0)
    print(test_ts.index[t])
    print(t+1, ': predicted =', yhat, 'expected =', obs)
Baş verən öyrədilməni izləyə bilərsiniz:
2014-12-30 00:00:00 1 : predicted = [0.32 0.29 0.28] expected = [0.32945389435989236, 0.2900626678603402, 0.2739480752014323] 2014-12-30 01:00:00 2 : predicted = [0.3 0.29 0.3 ] expected = [0.2900626678603402, 0.2739480752014323, 0.26812891674127126] 2014-12-30 02:00:00 3 : predicted = [0.27 0.28 0.32] expected = [0.2739480752014323, 0.26812891674127126, 0.3025962399283795] -
Proqnozları faktiki yüklə müqayisə edin:
eval_df = pd.DataFrame(predictions, columns=['t+'+str(t) for t in range(1, HORIZON+1)])
eval_df['timestamp'] = test.index[0:len(test.index)-HORIZON+1]
eval_df = pd.melt(eval_df, id_vars='timestamp', value_name='prediction', var_name='h')
eval_df['actual'] = np.array(np.transpose(test_ts)).ravel()
eval_df[['prediction', 'actual']] = scaler.inverse_transform(eval_df[['prediction', 'actual']])
eval_df.head()
Output
timestamp h prediction actual 0 2014-12-30 00:00:00 t+1 3,008.74 3,023.00 1 2014-12-30 01:00:00 t+1 2,955.53 2,935.00 2 2014-12-30 02:00:00 t+1 2,900.17 2,899.00 3 2014-12-30 03:00:00 t+1 2,917.69 2,886.00 4 2014-12-30 04:00:00 t+1 2,946.99 2,963.00 Faktiki yüklə müqayisədə saatlıq məlumatın proqnozunu müşahidə edin. Nə dərəcədə dəqiqlik var?
Modelin düzgünlüyünü yoxlayın
Bütün proqnozlar üzərində ortalama mütləq faiz xətasını (MAPE) tapmaqla modelinizin düzgünlüyünü yoxlayın.
🧮 İşin riyazi tərəfini göstərin
MAPE yuxarıdakı düsturla tapılmış proqnoz dəqiqliyini nisbət formasında göstərmək üçün istifadə olunur. Faktikit ilə proqnozlaşdırılant arasındakı fərq faktikit-ə bölünür. "Bu hesablamada mütləq dəyər hər bir proqnozlaşdırılan vaxt üçün cəmlənir və uyğunlaşdırılmış n nöqtələrinin sayına bölünür." wikipedia
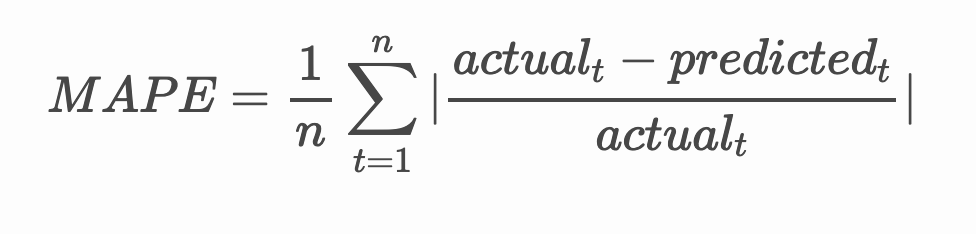
-
Tənliyi kodla ifadə edək:
if(HORIZON > 1): eval_df['APE'] = (eval_df['prediction'] - eval_df['actual']).abs() / eval_df['actual'] print(eval_df.groupby('h')['APE'].mean()) -
Bir addımın MAPE-i hesablayın:
print('One step forecast MAPE: ', (mape(eval_df[eval_df['h'] == 't+1']['prediction'], eval_df[eval_df['h'] == 't+1']['actual']))*100, '%')Bir addımlı proqnoz MAPE: 0.5570581332313952 %
-
Çox mərhələli MAPE proqnozunu ekrana çap edin:
print('Multi-step forecast MAPE: ', mape(eval_df['prediction'], eval_df['actual'])*100, '%')Multi-step forecast MAPE: 1.1460048657704118 %Aşağı rəqəm ən yaxşısıdır: 10 MAPE olan bir proqnozun 10% azaldığını düşünün.
-
Ancaq həmişə olduğu kimi, bu cür ölçmə dəqiqliyini vizual olaraq görmək daha asandır deyə qrafikini çəkək:
 if(HORIZON == 1):
    ## Plotting single step forecast
    eval_df.plot(x='timestamp', y=['actual', 'prediction'], style=['r', 'b'], figsize=(15, 8))

else:
    ## Plotting multi step forecast
    plot_df = eval_df[(eval_df.h=='t+1')][['timestamp', 'actual']]
    for t in range(1, HORIZON+1):
        plot_df['t+'+str(t)] = eval_df[(eval_df.h=='t+'+str(t))]['prediction'].values

    fig = plt.figure(figsize=(15, 8))
    ax = plt.plot(plot_df['timestamp'], plot_df['actual'], color='red', linewidth=4.0)
    ax = fig.add_subplot(111)
    for t in range(1, HORIZON+1):
        x = plot_df['timestamp'][(t-1):]
        y = plot_df['t+'+str(t)][0:len(x)]
        ax.plot(x, y, color='blue', linewidth=4*math.pow(.9,t), alpha=math.pow(0.8,t))

    ax.legend(loc='best')

plt.xlabel('timestamp', fontsize=12)
plt.ylabel('load', fontsize=12)
plt.show()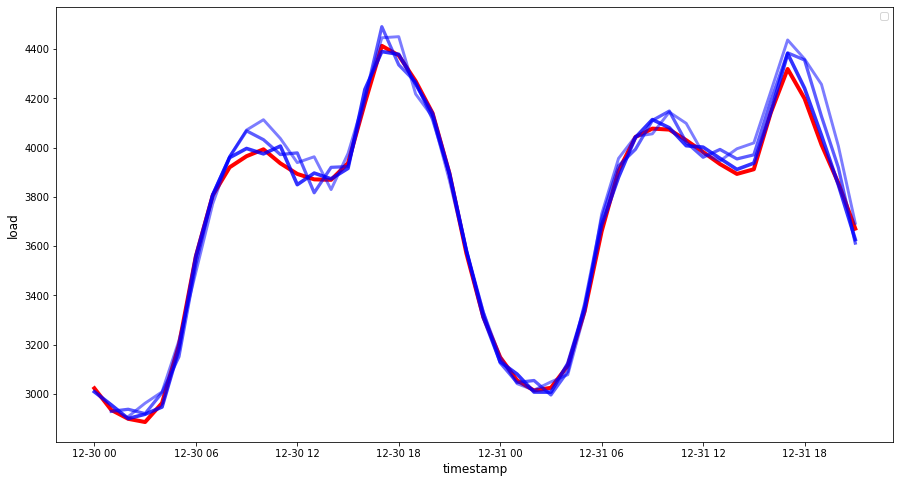
🏆 Yuxarı dəqiqlik göstərən gözəl qrafik alındı. Əla!
🚀 Məşğələ
Zaman Seriyası Modelinin düzgünlüyünü yoxlamaq yollarını araşdırın. Bu dərsdə MAPE-ə toxunacağıq, amma istifadə edə biləcəyiniz başqa üsullar varmı? Onları araşdırın və şərh edin. Yardımçı sənədi [burada] tapa bilərsiniz(https://otexts.com/fpp2/accuracy.html)
Mühazirə sonrası quiz
Təkrarlayın və özünüz öyrənin
Bu dərs yalnız ARIMA ilə Zaman Seriyasının Proqnozlaşdırılmasının əsaslarına toxunur. Time Series modellərini qurmağın digər yollarını öyrənmək və bilikləriniz dərinləşdirmək üçün bu reponu və onun müxtəlif model növlərini araşdırmağa vaxtınızı ayırın.