
15 KiB
Alustamine Pythoniga ja Scikit-learniga regressioonimudelite jaoks
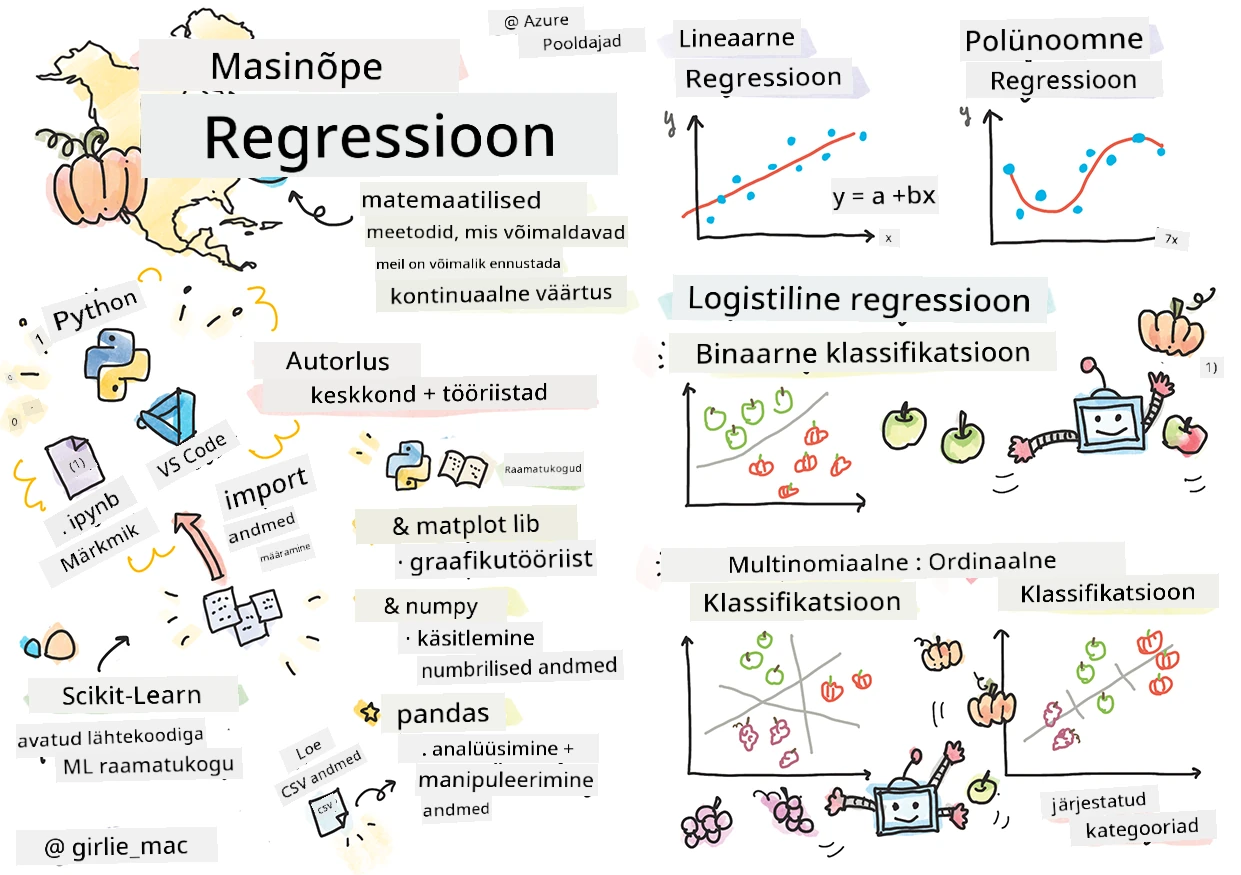
Sketchnote autor Tomomi Imura
Eel-loengu viktoriin
See õppetund on saadaval ka R-is!
Sissejuhatus
Nendes neljas õppetunnis avastate, kuidas ehitada regressioonimudeleid. Peagi arutleme, milleks need vajalikud on. Kuid enne kui midagi ette võtate, veenduge, et teil oleks õige tööriistakomplekt protsessi alustamiseks olemas!
Selles õppetunnis õpite:
- Konfigureerima oma arvutit kohalike masinõppetöödeks.
- Töötama Jupyter Notebook’idega.
- Kasutama Scikit-learn’i, sealhulgas selle installimist.
- Uurima lineaarset regressiooni praktilise ülesande abil.
Installatsioonid ja seadistused

🎥 Klõpsake ülaloleval pildil, et vaadata lühikest videot arvuti masinõppeks seadistamisest.
-
Paigalda Python. Veendu, et Python on arvutisse paigaldatud. Pythonit kasutatakse paljudes andmeteaduse ja masinõppe töödes. Enamik arvutisüsteeme sisaldab juba Pythonit. Samuti on saadaval kasulikud Python programmeerimise paketid, mis võivad mõnele kasutajale seadistamist lihtsustada.
Mõningates Pythoni kasutusvaldkondades on vaja üht tarkvara versiooni, teistes aga teist. Seetõttu on kasulik töötada virtuaalkeskkonnas.
-
Paigalda Visual Studio Code. Veendu, et Visual Studio Code on arvutisse paigaldatud. Järgi nende juhiste abil Visual Studio Code’i paigaldamist põhipaigalduseks. Käesolevas kursuses kasutad Pythoni Visual Studio Code’is, seega võib olla kasulik harjutada, kuidas Visual Studio Code’i seadistada Python-arenduseks.
Tundu end Pythoni osas mugavalt, läbides selle õppemoodulite kogu.

🎥 Klõpsake ülaloleval pildil, et vaadata videot Pythoniga VS Code’is töötamisest.
-
Paigalda Scikit-learn, järgides neid juhiseid. Kuna on vajalik Python 3 kasutamine, soovitatakse kasutada virtuaalkeskkonda. Pane tähele, et kui paigaldate seda teeki M1 Macile, on vastavas lingitud lehel erijuhised.
-
Paigalda Jupyter Notebook. Sul tuleb paigaldada Jupyter’i pakett.
Teie masinõppe keskkond
Sa kasutad notebook’e oma Pythoni koodi arendamiseks ja masinõppemudelite loomiseks. Sellist tüüpi failid on andmeteadlaste seas tavalised ja neid tuvastatakse laiendi .ipynb järgi.
Notebook’id on interaktiivne keskkond, mis võimaldab arendajal nii kodeerida kui ka lisada märkmeid ja kirjutada dokumentatsiooni, mis on eriti kasulik eksperimendi- või uurimuseesmärkidel.

🎥 Klõpsake ülaloleval pildil, et vaadata lühikest videot selle ülesande läbiviimisest.
Ülesanne - töötamine notebook’iga
Selles kaustas leiate faili notebook.ipynb.
-
Ava notebook.ipynb Visual Studio Code’is.
Käivitub Jupyter server Python 3+ versiooniga. Notebook’is on alasid, mida saab
käivitada, koodilõike. Koodiploki jooksutamiseks vali ikoon, mis näeb välja nagu mängunupp. -
Vali
mdsümbol ja lisa natuke markdown-koodi, ning tekst # Tere tulemast sinu notebook’i.Seejärel lisa natuke Python-koodi.
-
Tippige koodiplokki print('hello notebook').
-
Käivita koodivahetuse ikooni abil.
Peaksid nägema trükitud väljundit:
hello notebook
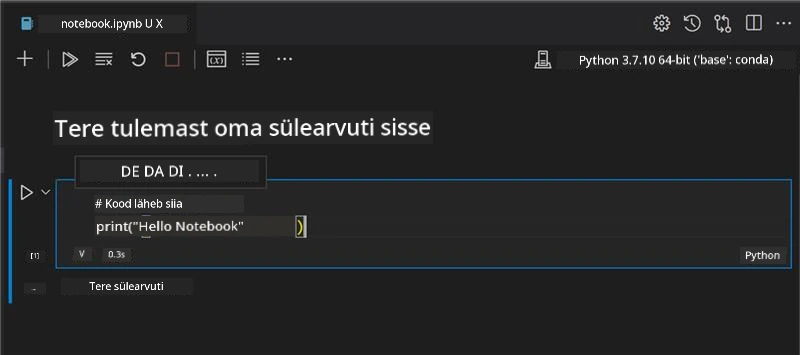
Võid oma koodi miksida kommentaaridega, et notebook iseend dokumenteeriks.
✅ Mõtle korraks, kui erinev on veebiarendaja töökeskkond võrreldes andmeteadlase omaga.
Scikit-learniga töövalmis
Nüüd, kui Python on su kohalikus keskkonnas paigas ja Sinu mugavus Jupyter Notebook’idega on suurenenud, tutvume sama kindlalt Scikit-learn’iga (hääldus sai nagu science). Scikit-learn pakub ulatuslikku API-d, mis aitab sul teostada ML-töid.
Vastavalt nende veebisaidile, „Scikit-learn on avatud lähtekoodiga masinõppe teek, mis toetab juhendatud ja juhendamata õppimist. Samuti pakub see erinevaid tööriistu mudeli sobitamiseks, andmete eeltöötluseks, mudeli valikuks ja hindamiseks ning paljusid teisi abivahendeid.“
Selles kursuses kasutad Scikit-learn’i ja teisi tööriistu, et luua masinõppemudeleid, mis täidavad nii-öelda „traditsioonilise masinõppe“ ülesandeid. Oleme teadlikult kõrvale hoidnud närvivõrke ja süvaõpet, sest neist räägitakse põhjalikumalt meie tulevases „AI algajatele“ õppekavas.
Scikit-learn muudab mudelite loomise ja nende hindamise lihtsaks. See keskendub peamiselt numbrilistele andmetele ja sisaldab mitmeid valmisandmekogumeid õppematerjalideks. Samuti sisaldab see eelvalmis mudeleid, mida õpilased saavad proovida. Uurime nüüd, kuidas laadida valmisandmeid ja kasutada sisseehitatud hinnangut, et luua oma esimene ML mudel Scikit-learn’iga mõne lihtsa andmega.
Ülesanne - sinu esimene Scikit-learn notebook
See juhend põhineb Scikit-learn’i veebisaidil oleval lineaarse regressiooni näitel.

🎥 Klõpsake ülaloleval pildil, et vaadata lühikest videot selle ülesande läbiviimisest.
Kustuta kõigist lahtritest sisu, vajutades prügikastiikoonile, failis notebook.ipynb, mis on selle õppetunniga seotud.
Selles jaotises töötad väikese andmekogumiga diabeedi kohta, mis on Scikit-learn’i sisse ehitatud õppimise eesmärgil. Kujuta ette, et sooviksid testida ravi diabeediga patsientide jaoks. Masinõppemudelid võivad aidata sul määrata, millised patsiendid reageeriksid ravile paremini, põhinedes erinevate muutujate kombinatsioonidel. Isegi väga lihtne regressioonimudel, kui seda visualiseerida, võib näidata infot, mis aitab teoreetilisi kliinilisi uuringuid paremini korraldada.
✅ Regresioonimeetodeid on mitut tüüpi ja valik sõltub küsimusest, millele vastust otsid. Kui soovid ennustada isiku tõenäolist kõrgust antud vanuses, kasutad lineaarset regressiooni, sest otsid numbrilist väärtust. Kui aga tahad välja selgitada, kas mingi köögi stiil peaks olema vegan või mitte, siis otsid kategooriatähistust ja kasutad logistilist regressiooni. Logistilise regressiooni kohta õpid hiljem rohkem. Mõtle veidi küsimustele, mida andmetest võid küsida, ja milline meetod neist sobiks paremini.
Alustame sellest ülesandest.
Impordi raamatukogud
Selle ülesande jaoks impordime mõned raamatukogud:
- matplotlib. See on kasulik graafikutööriist, mida kasutame joondiagrammi loomiseks.
- numpy. numpy on kasulik raamatukogu numbriliste andmete haldamiseks Pythonis.
- sklearn. See on Scikit-learn teek.
Impordi mõned raamatukogud, mis aitavad sul ülesandeid lahendada.
-
Lisa impordikäsklused, tippides järgmise koodi:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
Ülaltoodud koodis impordid
matplotlib,numpyjasklearnaltdatasets,linear_modelningmodel_selection.model_selectionaitab jagada andmeid treening- ja testijääkideks.
Diabeedi andmestik
Sisseehitatud diabeedi andmekogum sisaldab 442 näidist diabeedi kohta koos 10 tunnusega, millest mõned on:
- age: vanus aastates
- bmi: kehamassiindeks
- bp: keskmine vererõhk
- s1 tc: T-rakud (valgete vereliblede tüüp)
✅ See andmekogum sisaldab tunnusena ka „sugu“, mis on diabeedi uurimisel oluline. Paljud meditsiinilised andmestikud sisaldavad sellist binaarset klassifikatsiooni. Mõtle veidi, kuidas sellised kategooriad võivad teatud elanikkonnaliikmeid ravist välistada.
Nüüd laadi andmed X ja y muutujatesse.
🎓 Pea meeles, et tegemist on juhendatud õppimisega (supervised learning) ja meil peab olema nimetatud sihtmuutuja
y.
Uues koodilõigus lae diabeedi andmekogum, kutsudes välja load_diabetes(). Sisendi return_X_y=True tähendus on, et X saab andmemaatriksi ja y regressiooni sihtmärgi.
-
Lisa mõningad print-käsud, mis näitavad andmemaatriksi kuju ja esimest elementi:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Vastusena saad tupel, millest esimese ja teise väärtuse omistad vastavalt
X-ile jay-le. Loe rohkem tupel’itest.Näed, et andmestikus on 442 objekti, igaühes 10 tunnusega:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Mõtle veidi andmete ja regressiooni sihtmärgi omavahelisele seosele. Lineaarne regressioon ennustab seoseid tunnuse X ja sihtmuutuja y vahel. Kas leiad dokumentatsioonist diabeedi andmestiku sihtmärgi? Mida see andmestik näitab, arvestades seda sihtmärki?
-
Vali nüüd osa sellest andmestikust, mida joonistada, valides andmestiku 3. veeru. Seda saab teha kasutades
:operaatorit kõigi ridade valimiseks ja seejärel valides indeksi (2) 3. veeru. Andmeid saab ka ümber vormindada 2D maatriksiks, nagu nõutud joonistamisel, kasutadesreshape(n_rows, n_columns). Kui üks parameetritest on -1, arvutatakse vastav dimensioon automaatselt.X = X[:, 2] X = X.reshape((-1,1))✅ Vahepeal prindi andmed välja, et kontrollida nende kuju.
-
Kui andmed on joonistamiseks valmis, vaata, kas masin saab aidata leida loogilise jaotuse arvude vahel selles andmestikus. Selleks tuleb jagada nii andmed (X) kui ka sihtmärgid (y) test- ja treeningandmeteks. Scikit-learn’il on lihtne viis selleks: testandmed saab jagada valitud punkti juurest.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Nüüd oled valmis oma mudelit treenima! Laadi lineaarse regressiooni mudel ja treeni seda oma X ja y treeningandmetega, kasutades
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()on funktsioon, mida näed paljudes ML raamatukogudes nagu TensorFlow. -
Seejärel loo ennustus testandmete abil, kasutades funktsiooni
predict(). Sellega saab joonistada joone andmegruppide vahele.y_pred = model.predict(X_test) -
Nüüd joonista andmed graafikule. Matplotlib on selleks väga kasulik tööriist. Loo hajuvusdiagramm kõigist X ja y testandmetest ning kasuta ennustust, et joonistada joone modelleeritud andmegruppide vahele kõige sobivamasse kohta.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()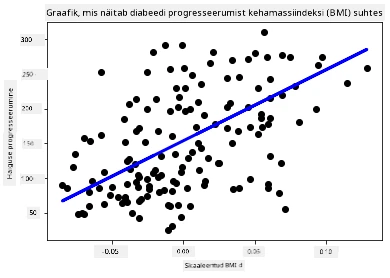
✅ Mõtle veidi, mis siin toimub. Sirge joon läbib palju väikeseid andmepunkte, kuid mida see täpselt teeb? Kas näed, kuidas selle joone abil peaks olema võimalik ennustada, kuhu uus, nähtamata andmepunkt paigutuks diagrammi y-teljega seoses? Püüa sõnadesse panna selle mudeli praktiline kasutus.
Palju õnne, sa ehitasid oma esimese lineaarse regressioonimudeli, lõid selle abil ennustuse ja kuvasid selle graafikul!
🚀Väljakutse
Ploti selle andmestiku mõni teine muutuja. Vihje: muuda rida: X = X[:,2]. Arvestades selle andmestiku sihtmärki, mida saad avastada diabeedi progresseerumise kohta haigusena?
Järg-loengu viktoriin
Kordamine ja iseseisev õpe
Selles juhendis töötasid lihtsa lineaarse regressiooniga, mitte univariatsiooni ega mitmiklineaarse regressiooniga. Loe veidi erinevustest nende meetodite vahel või vaata seda videot
Loe rohkem regressiooni kontseptsioonist ja mõtle, milliseid küsimusi seda tehnikat kasutades saab vastata. Võta see õpetus, et süvendada oma arusaamist.
Ülesanne
Lahtiütlus: See dokument on tõlgitud kasutades AI tõlketeenust Co-op Translator. Kuigi me püüdleme täpsuse poole, palun pange tähele, et automatiseeritud tõlgetes võib esineda vigu või ebatäpsusi. Originaaldokument selle emakeeles tuleks pidada autoriteetseks allikaks. Olulise teabe puhul soovitatakse kasutada professionaalset inimtõlget. Me ei vastuta selle tõlkega seotud eksimustest või valesti mõistmistest.