
20 KiB
CartPole(Sürgülü Araba) Sürüşü
Əvvəlki dərsdə həll etdiyimiz problem əslində real həyat ssenariləri üçün uyğun olmadığı üçün oyuncaq problem kimi görünə bilər. Amma bu belə deyil, çünki Şahmat və ya Go oynamaq kimi bir çox real dünya problemləri də bu ssenarini bölüşür. Onlar arasındakı oxşarlığın səbəbi bizdə də verilmiş qaydalar və diskret vəziyyəti olan lövhəmizin olmasıdır.
Mühazirədən əvvəl test
Giriş
Bu dərsdə biz Q-Öyrənməsinin eyni prinsiplərini davamlı vəziyyət probleminə, yəni bir və ya bir neçə həqiqi ədədlə verilən vəziyyətə tətbiq edəcəyik. Aşağıdakı problemlə məşğul olacağıq:
Problem: Piter canavardan qaçmaq istəyirsə, daha sürətli hərəkət edə bilməlidir. Biz Piterin Q-Öyrənməsindən istifadə edərək konki sürməyi, xüsusən də tarazlığı saxlamağı necə öyrənə biləcəyini görəcəyik.
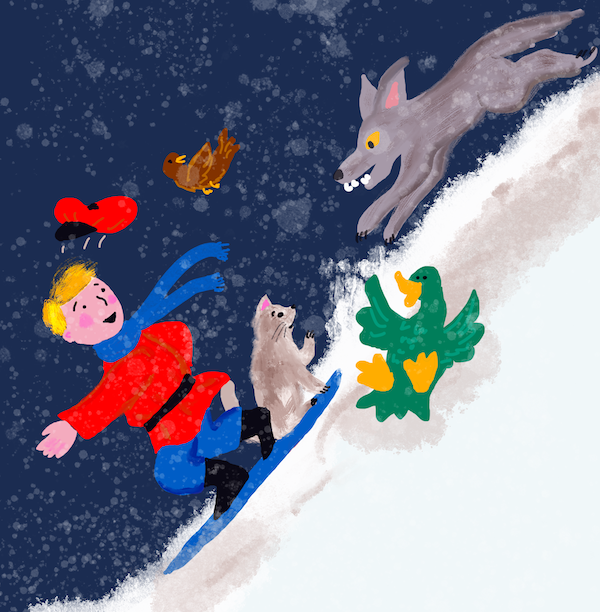
Piter və dostları canavardan qaçmaq üçün yaradıcı olurlar! Jen Looper tərəfindən çəkilmiş şəkil
Biz tarazlamanın CartPole problemi kimi tanınan sadələşdirilmiş versiyasından istifadə edəcəyik. CartPole dünyasında sola və ya sağa hərəkət edə bilən üfüqi sürgümüz var və məqsəd həmin sürgünün üstündəki şaquli dirəyi tarazlıqda saxlamaqdır.
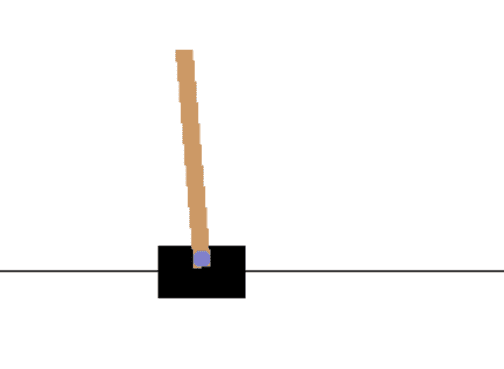
İlkin şərtlər
Bu dərsdə biz müxtəlif mühitləri simulyasiya etmək üçün OpenAI Gym adlı kitabxanadan istifadə edəcəyik. Siz bu dərsin kodunu öz kompüterinizdə(məsələn, Visual Studio Code-dan istifadə edərək) işlədə bilərsiniz. Amma nəzərə alın ki, simulyasiya yeni pəncərədə açılacaq. Kodu onlayn işlədərkən, burada təsvir olunduğu kimi koda bəzi düzəlişlər etməli ola bilərsiniz.
OpenAI Gym
Əvvəlki dərsdə oyunun qaydalarını və vəziyyəti özümüz yaratdığımız Board sinifi təyin edirdi. Burada isə biz balans dirəyinin arxasındakı fizikanı simulyasiya edəcək xüsusi simulyasiya mühitindən istifadə edəcəyik. Gücləndirilmiş öyrənmə alqoritmlərini öyrətmək üçün ən məşhur simulyasiya mühitlərindən biri OpenAI tərəfindən idarə olunan Gym-dir. Bu gym-dən istifadə etməklə biz, cartpole simulyasiyasından Atari oyunlarına qədər fərqli mühitlər yarada bilərik.
Qeyd: OpenAI Gym-də mövcud olan digər mühitlərə burada baxa bilərsiniz.
Əvvəlcə gym-i quraşdıraq və tələb olunan kitabxanaları əlavə edək (1. kod bloku):
import sys
!{sys.executable} -m pip install gym

import gym
import matplotlib.pyplot as plt
import numpy as np
import random
Tapşırıq - cartpole mühitini işə salın
Kartpol balans problemi ilə işləmək üçün müvafiq mühiti işə salmalıyıq. Hər bir mühit aşağıdakılarla əlaqələndirilir:
-
Müşahidə məkanı, mühitdən aldığımız məlumatların strukturunu müəyyən edir. Kartpol problemi üçün biz qütbün mövqeyini, sürəti və bəzi digər dəyərləri alırıq.
-
Mümkün hərəkətləri müəyyən edən fəaliyyət sahəsi. Bizim vəziyyətimizdə fəaliyyət sahəsi diskretdir və iki hərəkətdən ibarətdir - sol və sağ. (2. kod bloku)
-
İlkin olaraq aşağıdakı kodu daxil edin:
env = gym.make("CartPole-v1")
print(env.action_space)
print(env.observation_space)
print(env.action_space.sample())
Ətraf mühitin necə işlədiyini görmək üçün gəlin 100 addım üçün qısa bir simulyasiya keçirək. Hər addımda biz gediləcək gedişlərdən birini təqdim edirik - bu simulyasiyada biz sadəcə olaraq action_space-dən təsadüfi bir gediş seçirik.
-
Aşağıdakı kodu icra edin və nəticəsini izləyin.
✅ Nəzərə alın ki, bu kodu lokalda icra etməyiniz daha məqsədəuyğundur! (3. kod bloku)
env.reset()

for i in range(100):
   env.render()
   env.step(env.action_space.sample())
env.close()
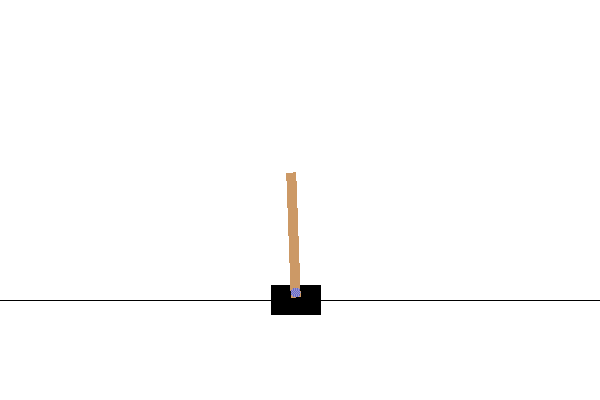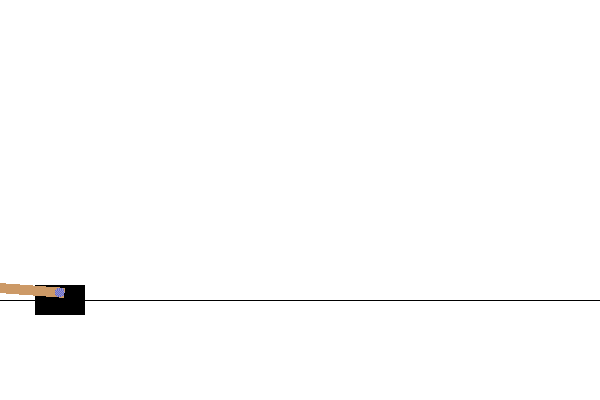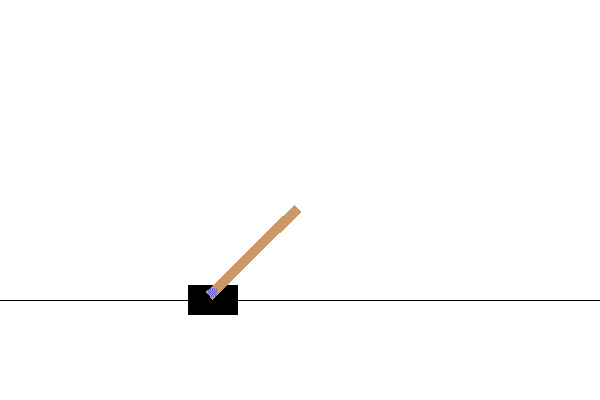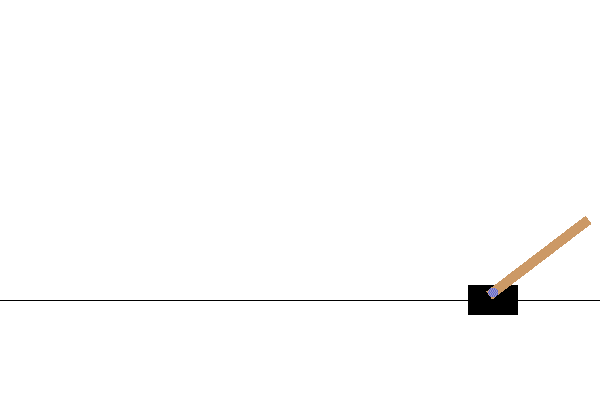
Bu şəkilə bənzər bir şey görməlisiniz:
-
Simulyasiya zamanı necə hərəkət edəcəyimizə qərar vermək üçün müşahidələr aparmalıyıq. Əslində,
stepfunksiyası bizə cari müşahidələri, mükafat funksiyasını və simulyasiyanı davam etdirməyin mənalı olub-olmadığını göstərən indikatoru qaytarır: (4. kod bloku)env.reset() done = False while not done: env.render() obs, rew, done, info = env.step(env.action_space.sample()) print(f"{obs} -> {rew}") env.close()Ekranda belə bir nəticə çap olunacaq:
[ 0.03403272 -0.24301182 0.02669811 0.2895829 ] -> 1.0 [ 0.02917248 -0.04828055 0.03248977 0.00543839] -> 1.0 [ 0.02820687 0.14636075 0.03259854 -0.27681916] -> 1.0 [ 0.03113408 0.34100283 0.02706215 -0.55904489] -> 1.0 [ 0.03795414 0.53573468 0.01588125 -0.84308041] -> 1.0 ... [ 0.17299878 0.15868546 -0.20754175 -0.55975453] -> 1.0 [ 0.17617249 0.35602306 -0.21873684 -0.90998894] -> 1.0Simulyasiyanın hər addımında qaytarılan müşahidə vektoru aşağıdakı dəyərləri ehtiva edir:
- Arabanın pozisiyası
- Arabanın sürəti
- Dirəyin bucağı
- Dirəyin fırlanma dərəcəsi
-
Həmin nömrələrin minimum və maksimum dəyərini əldə edin: (5. kod bloku)
print(env.observation_space.low)
print(env.observation_space.high)
Diqqət etsəniz, hər bir simulyasiya addımında mükafat dəyəri həmişə 1 olduğunu görə bilərsiniz. Bunun səbəbi odur ki, bizim məqsədimiz mümkün qədər uzun müddət sağ qalmaqdır. Başqa cürə ifadə etsək, dirəyi ən uzun müddətə şaquli vəziyyətdə saxlamaqdır.
✅ Əslində, ardıcıl 100 sınaq üzərindən 195-lik orta mükafat əldə edə bilsək, CartPole simulyasiyası həll edilmiş sayılacaq.
Vəziyyətin diskretləşməsi
Q-Öyrənməsində biz hər bir vəziyyətdə nə edəcəyimizi müəyyən edən Q-Cədvəli qurmalıyıq. Bunu edə bilmək üçün vəziyyətin diskret olması lazımdır, daha dəqiq desək, sonlu sayda diskret dəyərləri ehtiva etməlidir. Bu da o deməkdir ki, bizim hansısa formada müşahidələrimizi sonlu vəziyyətlər toplusuna uyğunlaşdıraraq diskretləşdirməyə ehtiyacımız var.
Bunu edə biləcəyimiz bir neçə yol var:
- Hissələrə bölün. Müəyyən bir dəyərin intervalını bilsək, bu intervalı bir neçə ** hissəyə** bölmək və sonra həmin dəyəri onun aid olduğu hissənin nömrəsi ilə əvəz edə bilərik. Bunu numpy-ın
digitize(rəqəmsallaşdırmaq) metodundan istifadə etməklə edə bilərik. Vəziyyətin rəqəmsallaşdırma üçün seçdiyimiz hissələrin sayından asılı olacağından, onun ölçüsünü dəqiq biləcəyik.
✅ Xətti interpolyasiyadan istifadə edərək dəyərləri sonlu intervala(məsələn, -20-dən 20-yə) yerləşdirə bilərik və sonra onları yuvarlaqlaşdırmaqla ədədləri tam ədədlərə çevirə bilərik. Belə etmək, xüsusən də giriş dəyərlərinin dəqiq diapazonlarını bilməmək bizə vəziyyətin ölçüsünə bir az daha az nəzarət imkanı verir. Məsələn, bizim vəziyyətimizdə 4 dəyərdən 2-in öz dəyərlərində yuxarı/aşağı sərhədləri olmadığı üçün, bu sonsuz sayda vəziyyətlə nəticələnə bilər.
Nümunəmizdə ikinci yanaşma ilə gedəcəyik. Beləliklə müşahidə edəcəksiniz ki, qeyri-müəyyən yuxarı/aşağı sərhədlərə baxmayaraq, bu dəyər nadir hallarda müəyyən sonlu intervallardan kənarda dəyərlər qəbul edir. Buna görə də ekstremal dəyərlərə malik vəziyyətlər çox nadir hallarda olacaq.
-
Modelimizdən müşahidələri toplayacaq və 4 tam dəyərdən ibarət qrup çıxaracaq funksiya budur: (6. kod bloku)
def discretize(x): return tuple((x/np.array([0.25, 0.25, 0.01, 0.1])).astype(np.int)) -
Gəlin ayırdığımız hissələrdən istifadə edərək başqa diskretləşdirmə üsulunu da araşdıraq: (7. kod bloku)
def create_bins(i,num): return np.arange(num+1)*(i[1]-i[0])/num+i[0] print("Sample bins for interval (-5,5) with 10 bins\n",create_bins((-5,5),10)) ints = [(-5,5),(-2,2),(-0.5,0.5),(-2,2)] # intervals of values for each parameter nbins = [20,20,10,10] # number of bins for each parameter bins = [create_bins(ints[i],nbins[i]) for i in range(4)] def discretize_bins(x): return tuple(np.digitize(x[i],bins[i]) for i in range(4)) -
İndi qısa bir simulyasiya aparaq və həmin diskret mühit dəyərlərini müşahidə edək. Fərqin olub-olmadığını görmək üçün həm
discretize, həm dədiscretize_binsseçimlərini sınayın.✅ discretize_bins 0-a əsaslı hissənin nömrəsini qaytarır. Yəni, giriş dəyişəninin 0-a yaxın qiymətləri üçün o, intervalın(10) ortasındakı rəqəmi qaytarır. Diskretləşdirmədə biz çıxış dəyərlərinin diapazonuna əhəmiyyət vermədik, onların mənfi olmasına imkan verdik. Bununla da vəziyyət dəyərləri dəyişdirilmir və 0, 0-a uyğun olmuş olur.(8. kod bloku)
env.reset()

done = False
while not done:
  #env.render()
  obs, rew, done, info = env.step(env.action_space.sample())
  #print(discretize_bins(obs))
  print(discretize(obs))
env.close()
✅ Mühitin necə işlədiyini görmək istəyirsinizsə, env.render ilə başlayan sətri şərhdən çıxarın. Onu arxa planda daha sürətli icra etməyiniz də mümkündür. Q-Öyrənməsi prosesimiz zamanı bu "görünməz" icradan istifadə edəcəyik.
Q-Cədvəlinin strukturu
Əvvəlki dərsimizdə vəziyyət 0-dan 8-ə qədər sadə ədədlər cütü olduğu üçün, Q-Cədvəlini 8x8x2 formalı numpy tensoru ilə təmsil etmək rahat idi. Vəziyyət vektorumuzun ölçüsü məlum olduğu üçün hissələrin diskretləşdirilməsini tətbiq etsək, bu zaman eyni yanaşmadan istifadə edə və vəziyyəti 20x20x10x10x2 formalı massiv ilə təqdim edə bilərik(buradakı 2 fəaliyyət sahəsinin ölçüsüdür və ilk ölçülər müşahidə məkanındakı hər bir parametr üçün seçdiyimiz hissələrin sayına uyğundur).
Lakin bəzən müşahidə məkanının dəqiq ölçüləri məlum olmur. discretize funksiyasında heç vaxt vəziyyətin bəzi orijinal dəyərlərin bağlı olmamasından dolayı müəyyən sərhədlər daxilində qalacağından əmin olmaya bilərik. Buna görə də, bir qədər fərqli yanaşmadan istifadə edəcəyik və Q-Cədvəlini lüğətlə təmsil edəcəyik.
-
Lüğət açarı kimi (vəziyyət, fəaliyyət) cütündən istifadə edin. Dəyər isə Q-Cədvəlinin giriş dəyərinə uyğun olacaq. (9. kod bloku)
Q = {}
actions = (0,1)

def qvalues(state):
    return [Q.get((state,a),0) for a in actions]
Burada biz həmçinin bütün mümkün hərəkətlərə uyğun gələn verilmiş vəziyyət üçün Q-Cədvəl qiymətlərinin siyahısını qaytaran
qvalues()funksiyasını təyin edirik. Giriş Q-Cədvəlində yoxdursa, biz standart olaraq 0-ı qaytaracağıq.
Q-Öyrənməsinə başlayaq
Artıq Piterə tarazlığı öyrətməyə hazırıq!
-
Əvvəlcə bəzi hiperparametrləri təyin edək: (10. kod bloku)
# hyperparameters
alpha = 0.3
gamma = 0.9
epsilon = 0.90
Burada
alfahər addımda Q-Cədvəlinin cari dəyərlərini nə dərəcədə tənzimləməli olduğumuzu müəyyən edən öyrənmə dərəcəsidir. Əvvəlki dərsdə biz 1 ilə başladıq, sonra isə təlim zamanıalpha-ı aşağı qiymətlərə endirdik. Bu nümunədə biz onu sadəlik üçün sabit saxlayacağıq və daha sonra sizalphadəyərlərini tənzimləməklə təcrübələr apara biləcəksiniz.gammaendirim faktorudur və gələcək mükafatı cari mükafatdan nə dərəcədə daha prioritetləşdirməli olduğumuzu göstərir.epsilonkəşfiyyat/istifadə faktorudur. Bizim istifadədən daha çox kəşfiyyata və ya əksinə üstünlük verməli olduğumuzu müəyyən edir. Alqoritmimizdə hallarınepsilonfaizində Q-Cədvəl qiymətlərinə uyğun növbəti hərəkəti seçəcəyik, qalan hallarda isə təsadüfi hərəkəti yerinə yetirəcəyik. Bu, axtarış məkanında əvvəllər heç görmədiyimiz sahələri araşdırmağımıza təkan verəcək.✅ Balanslaşdırma baxımından - təsadüfi hərəkətin(kəşfiyyatın) seçilməsi yanlış istiqamətdə təsadüfi bir zərbə rolunu oynayacaq və dirək həmin "səhvlərdən" tarazlığı necə bərpa edəcəyini öyrənməli olacaq.
Alqoritmi təkmilləşdirin
Biz həmçinin əvvəlki dərsdən olan alqoritmimizi iki formada təkmilləşdirə bilərik:
-
Bir sıra simulyasiyalar üzrə orta məcmu mükafatını hesablayın. Hər 5000 iterasiyada nə qədər irəlilədiyimizi ekrana çap edəcəyik və bu müddət ərzində ümumi mükafatımızın orta qiymətini çıxaracağıq. Bu o deməkdir ki, 195-dən çox bal toplasaq, tələb olunandan daha yüksək keyfiyyətlə problemi həll edilmiş hesab edə bilərik.
-
Maksimum orta məcmu nəticəni hesablayın,
Qmaxvə biz həmin nəticəyə uyğun olan Q-Cədvəlini yadda saxlayacağıq. Təlimi icra edən zaman görəcəksiniz ki, bəzən orta məcmunun qiyməti aşağı düşməyə başlayır və biz Q-Cədvəlinin təlim zamanı müşahidə edilən ən yaxşı modelə uyğun olan dəyərlərini saxlamaq istəyirik.
-
Sonrakı planlar üçün
rewardsvektorunda hər simulyasiyada bütün məcmu mükafatları toplayın. (11. kod bloku)def probs(v,eps=1e-4): v = v-v.min()+eps v = v/v.sum() return v Qmax = 0 cum_rewards = [] rewards = [] for epoch in range(100000): obs = env.reset() done = False cum_reward=0 # == do the simulation == while not done: s = discretize(obs) if random.random()<epsilon: # exploitation - chose the action according to Q-Table probabilities v = probs(np.array(qvalues(s))) a = random.choices(actions,weights=v)[0] else: # exploration - randomly chose the action a = np.random.randint(env.action_space.n) obs, rew, done, info = env.step(a) cum_reward+=rew ns = discretize(obs) Q[(s,a)] = (1 - alpha) * Q.get((s,a),0) + alpha * (rew + gamma * max(qvalues(ns))) cum_rewards.append(cum_reward) rewards.append(cum_reward) # == Periodically print results and calculate average reward == if epoch%5000==0: print(f"{epoch}: {np.average(cum_rewards)}, alpha={alpha}, epsilon={epsilon}") if np.average(cum_rewards) > Qmax: Qmax = np.average(cum_rewards) Qbest = Q cum_rewards=[]
Bu nəticələrdən aşağıdakı fərqləri görə bilərsən:
-
Məqsədimizə yaxın. Simulyasiyanın 100+ ardıcıl işləməsi ilə 195 məcmu mükafatı əldə etmək məqsədinə çatmaq üçün çox yaxınıq və ya həqiqətən buna nail ola bilərik! Kiçik nömrələr alsaq da, hələ də bilmirik, çünki ortalama 5000-dən çox icra həyata keçiririk və rəsmi meyarlarda yalnız 100 icra tələb olunur.
-
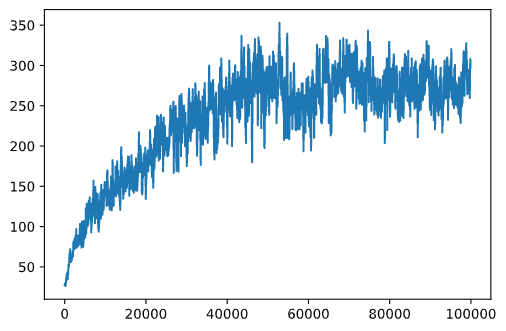
Mükafat atmağa başlayır. Bəzən mükafat düşməyə başlayır, yəni vəziyyəti daha da pis hala gətirənlərlə birlikdə Q-Cədvəlindəki öyrənilən dəyərləri "məhv edə" bilər.
Təlimin inkişaf qrafikini qursaq, bu müşahidə daha aydın görünür.
Öyrədilmənin İnkişaf Qrafikinin qurulması
Təlim zamanı, hər bir iterasiyada rewards vektoruna əlavə edilən məcmu mükafat qiymətlərini topladıq. Həmin qiymətləri iterasiya nömrəsinə qarşı formada qrafikini qurduğumuz zaman belə görünür:
plt.plot(rewards)
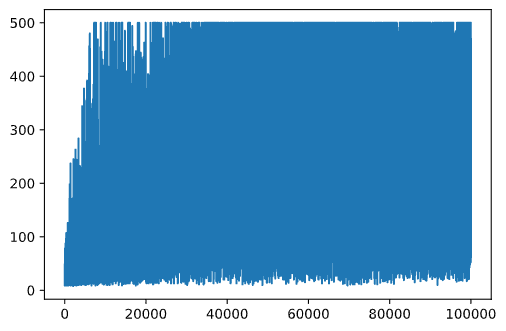
Bu qrafikdən, bir şey demək mümkün deyil, çünki stoxastik Təlim prosesinin təbiətinə görə təlim sessiyalarının uzunluğu çox dəyişir. Bu qrafikin daha çox məna kəsb etməsi üçün ortalama icranı, məsələn, 100 təcrübə üzərindən np.convolve istifadə edərək hesablaya bilərik: (Kod Bloku 12)
def running_average(x,window):
    return np.convolve(x,np.ones(window)/window,mode='valid')

plt.plot(running_average(rewards,100))
Dəyişkən hiperparameterlər
Öyrənməyi daha sabit etmək üçün təlim zamanı bəzi hiperparametrlərimizi tənzimləmək fayda var. Xüsusilə:
-
Öyrənmə dərəcəsi
alphaüçün, 1-ə yaxın dəyərlərdən başlaya və sonra azalda bilərik. Zamanla Q-Cədvəlində yaxşı ehtimal dəyərləri əldə edəcəyik. Bunun üçün onları ehtiyatla tənzimləməli və tamamilə yeni dəyərlərlə yazmamalıyıq. -
Epsilonu artırmaq. Daha az kəşf, daha çox istifadə üçün
epsilon-u yavaş-yavaş artırmaq istəyə bilərik. Ona görə də,epsilon-u aşağı dəyəri ilə başlamağımız və 1-ə qədər artırmağımız yaxşı olardı.
Tapşırıq 1: Hiperparametr dəyərləri ilə oynayın və daha yüksək məcmu mükafat əldə edə biləcəyinizə baxın. 195-dən yuxarı qiymət ala bilirsinizmi?
Tapşırıq 2: Problemi tam həll etmək üçün, 100 ardıcıl icrada orta mükafat dəyərini 195 olaraq almalısınız. Təlim zamanı qiymətləri ölçün və problemi tam şəkildə həll etdiyinizə əmin olun!
İcra zamanı nəticəni görək
Öyrədilmiş modelin necə davrandığını görmək maraqlı olardı. Simulyasiyanı işə salaq və Q-Cədvəldəki ehtimal paylamasına görə təlim, nümunə götürmə zamanı etdiyimiz fəaliyyət seçmə strategiyasını izləyək: (Kod bloku 13)
obs = env.reset()
done = False
while not done:
   s = discretize(obs)
   env.render()
   v = probs(np.array(qvalues(s)))
   a = random.choices(actions,weights=v)[0]
   obs,_,done,_ = env.step(a)
env.close()
Bu kimi bir şey görməlisən:
🚀 Məşğələ
Tapşırıq 3: Burada biz ən yaxşısı olmaya biləcək Q-Cədvəlinin son versiyasını istifadə edirdik. Xatırlayırsınızsa, ən yaxşı Q-Cədvəlini
Qbestdəyişənində saxlamışıq!Qbest-iQ-ə kopyalayaraq ən optimal Q-Cədvəllə eyni nümunəni sınaqdan keçirin və fərqi izləyin.
Tapşırıq 4: Burada hər addımda ən yaxşı hərəkəti seçmirdik. Bunun əksinə müvafiq ehtimal paylanması ilə nümunə götürürdük. Ən yüksək Q-Cədvəl dəyəri olan ən yaxşı hərəkəti həmişə seçmək daha düzgün olmazdımı? Bu, Q-Cədvəlinin dəyərinə uyğun hərəkət nömrəsini tapmaq üçün
np.argmaxfunksiyasından istifadə etməklə edilə bilər. Həmin strategiyanı icra edin və tarazlanmanın yaxşılaşdığını izləyin.
Mühazirə sonrası test
Tapşırıq
Nəticə
Artıq oyunun istədiyi vəziyyətini müəyyənləşdirən və axtarış sahəsini ağıllı şəkildə araşdıran bir mükafat funksiyasını təmin etməklə, yaxşı nəticələr əldə edəcək agentlər yetişdirməyi öyrəndik. Q-Öyrənməsi alqoritmini diskret hərəkətlərlə, diskret və davamlı mühit hallarında uğurla tətbiq etmiş olduq.
Müşahidə sahəsi Atari oyun ekranındakı görüntü kimi fəaliyyət vəziyyətinin də davamlı olduğu daha mürəkkəb vəziyyətləri öyrənmək vacibdir. Bu problemlərdə tez-tez yaxşı nəticələr əldə etmək üçün neyron şəbəkələri kimi daha güclü maşın öyrənmə texnikasından istifadə etməliyik. Bu cür irəli mövzular qarşıdakı daha mürəkkəb AI kursumuzun mövzusudur.