
21 KiB
Gücləndirilmiş Öyrənmə və Q-Öyrənməsinə Giriş
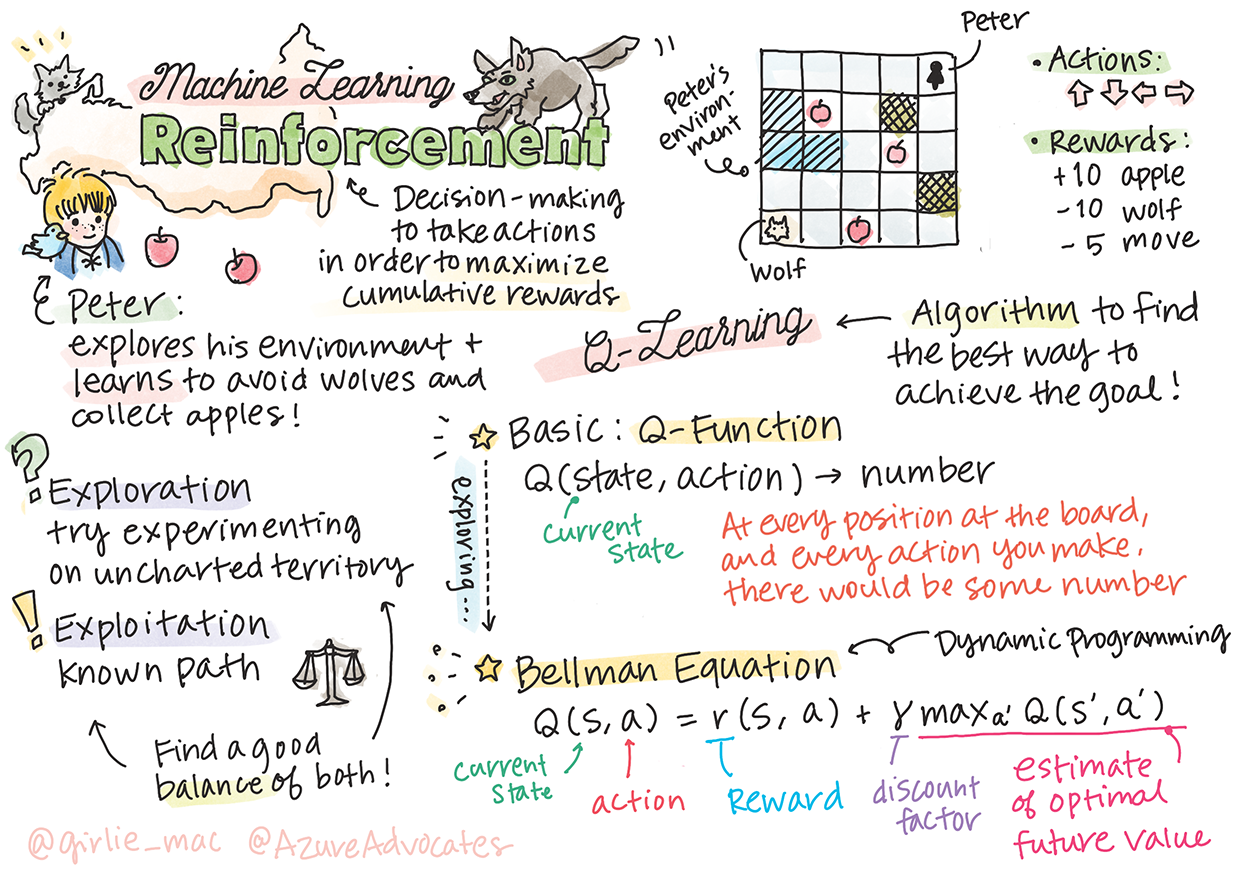
Tomomi Imura tərəfindən çəkilmiş eskiz
Gücləndirilmiş öyrənmə üç mühüm anlayışı özündə birləşdirir: agent, vəziyyətlər və hər vəziyyət üçün icra yığını. Müəyyən edilmiş vəziyyətdə hərəkəti icra etməklə agentə mükafat verilir. Super Mario oyununu yadınıza salın. Təsəvvür edin ki siz Mariosunuz və hansısa mərhələdə uçurum kənarında dayanmısınız. Sizin üstünüzdə isə qəpik var. Hansısa bir mərhələdə Mario olmağınız sizin vəziyyətinizdir. Bir addım ataraq sağa hərəkət etmək sizi uçuruma aparacaq və aşağı xal toplayacaqsınız. Amma atlamaq düyməsinə basmağınız xal toplamanıza və sağ qalmanıza səbəb olacaqdı. Dediyimiz müsbət nəticə olduğuna görə sizə müsbət xal verilməlidir.
Oyunda sağ qalaraq və mümkün olduğu qədər yuxarı xal toplamaqla mükafatı maksimuma çatdırmağı möhkəmləndirilmiş öyrənmədən və simulyator(oyun) istifadə edərək öyrənə bilərsiniz.
🎥 Dmitrinin Gücləndirilmiş Öyrənmə barədə olan müzakirəsini dinləmək üçün yuxarıdakı şəkilə klikləyin
Mühazirədən əvvəl test
İlkin Şərtlər və Quraşdırma
Bu gün Python-da bəzi kodları sınaqdan keçirəcəyik. Dərsə aid olan Jupyter Notebook kodunu həm kompüterinizdə, həm də buludda işlədə bilməlisiniz.
Siz dərs notebook-unu aça və qurmaq üçün bu dərsi izləyə bilərsiniz.
Qeyd: Bu kodu buludda açırsınızsa,
rlboard.pyfaylını da notebook kodunda istifadə olunduğuna görə yükləməyiniz lazımdır. Onu notebook faylı ilə eyni qovluğa əlavə edin.
Giriş
Bu dərsdə biz rus bəstəkarı Sergei Prokofyevin musiqili nağılından ilhamlanaraq, Piter və Canavar dünyasını araşdıracağıq. Peterə ətrafını araşdırmaq, dadlı alma toplamaq və canavarla görüşməmək üçün Gücləndirilmiş Öyrənmədən istifadə edəcəyik.
Gücləndirilmiş Öyrənmə (RL – Reinforcement Learning) çoxlu təcrübələr keçirərək, mühit daxilində agentin optimal davranışını öyrənməyə imkan verən öyrənmə texnikasıdır. Bu mühitdəki agentin mükafat funksiyası ilə müəyyən edilmiş hədəfi olmalıdır.
Mühit
Sadəlik üçün hesab edək ki, Peterin dünyası en x hündürlük ölçülü kvadrat bir lövhədir:
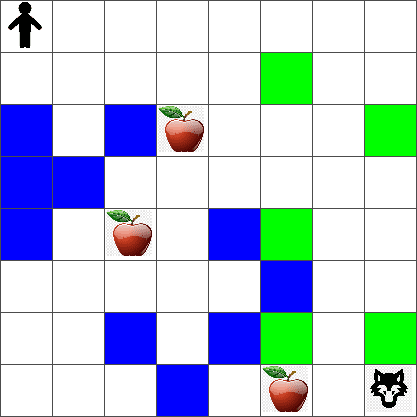
Bu lövhədəki hər bir xana aşağıdakılardan biri ola bilər:
- torpaq – üzərində Piter və digər canlılar gəzə bilər.
- su – üstündə gəzə bilməyəcəksiniz.
- ağac və ya ot – istirahət edə biləcəyiniz yer.
- alma – Piterin özünü qidalandırmaq üçün tapmaqdan məmnun qalacağı bir şeyi təmsil edir.
- canvar – bu təhlükəlidir və ondan qaçınmaq lazımdır.
Bu mühitlə işləmək üçün içərisində kodlar olan, rlboard.py adlı ayrıca Python modulu mövcuddur. Bu kodlar indiki konseptləri başa düşmək üçün o qədər də vacib olmadığından, həmin moduldan nümunə lövhəsini yaratmaq üçün istifadə edəcəyik (1. kod bloku):
from rlboard import *

width, height = 8,8
m = Board(width,height)
m.randomize(seed=13)
m.plot()
Bu kod yuxarıdakı şəkil kimi ətraf mühitin görüntüsünü ekrana çap etməlidir.
Addımlar və Taktika
Bizim nümunəmizdə Peterin məqsədi canavardan və digər maneələrdən qaçaraq bir alma tapmaq olardı. Bunu etmək üçün, o, alma tapana qədər gəzə bilər.
Buna görə də, istənilən mövqedə o, yuxarı, aşağı, sola və sağa hərəkətlərindən birini seçə bilər.
Biz bu hərəkətləri lüğət kimi müəyyənləşdirəcəyik və onları müvafiq koordinat dəyişiklikləri cütlərinə uyğunlaşdıracağıq. Məsələn, sağa hərəkət etmək (R) (1,0) cütünə uyğun olacaq. (2. kod bloku):
actions = { "U" : (0,-1), "D" : (0,1), "L" : (-1,0), "R" : (1,0) }
action_idx = { a : i for i,a in enumerate(actions.keys()) }
Ümumiləşdirsək, bu ssenarinin strategiyası və hədəfi aşağıdakılardır:
-
Agentimizin(Piter) strategiyası, "taktika" ilə müəyyən edilir. Taktika hər hansı bir vəziyyətdə, atılmalı olan addımı qaytaran funksiyadır. Bizim vəziyyətimizdə problemin vəziyyəti oyunçunun hazırkı mövqeyi də daxil olmaqla, lövhə ilə təmsil olunur.
-
Gücləndirilmiş öyrənmənin məqsədi problemi səmərəli şəkildə həll etməyə imkan verəcək yaxşı bir taktika öyrənməkdir. Amma indilik, başlanğıc olaraq təsadüfi gediş adlı ən sadə siyasəti nəzərdən keçirək.
Təsadüfi gəzinti
Gəlin əvvəlcə təsadüfi gediş strategiyasını həyata keçirərək problemimizi həll edək. Təsadüfi gedişlə, almaya çatana qədər icazə verilən addımlar arasından növbəti addımımızı təsadüfi seçəcəyik (3. kod bloku).
-
Aşağıdakı kodla təsadüfi gedişi həyata keçirin:
def random_policy(m): return random.choice(list(actions)) def walk(m,policy,start_position=None): n = 0 # number of steps # set initial position if start_position: m.human = start_position else: m.random_start() while True: if m.at() == Board.Cell.apple: return n # success! if m.at() in [Board.Cell.wolf, Board.Cell.water]: return -1 # eaten by wolf or drowned while True: a = actions[policy(m)] new_pos = m.move_pos(m.human,a) if m.is_valid(new_pos) and m.at(new_pos)!=Board.Cell.water: m.move(a) # do the actual move break n+=1 walk(m,random_policy)walkmüvafiq yolun uzunluğunu qaytarmalıdır. Amma təsadüfi olduğu üçün hər çağrılma zamanı fərqli uzunluq qaytara bilər. -
Gəzinti təcrübəsini bir neçə dəfə yerinə yetirin(məsələn, 100) və nəticədə əldə edilən statistikanı çap edin (4. kod bloku):
def print_statistics(policy):
    s,w,n = 0,0,0
    for _ in range(100):
        z = walk(m,policy)
        if z<0:
            w+=1
        else:
            s += z
            n += 1
    print(f"Average path length = {s/n}, eaten by wolf: {w} times")

print_statistics(random_policy)
Diqqət etsək görərik ki, yolun orta uzunluğu təxminən 30-40 addımdır, ən yaxın almaya qədər orta məsafənin 5-6 addım civarında olduğunu nəzərə alsaq, bu, kifayət qədər çoxdur.
Siz həmçinin təsadüfi gəzinti zamanı Peterin hərəkətinin necə göründüyünü görə bilərsiniz:
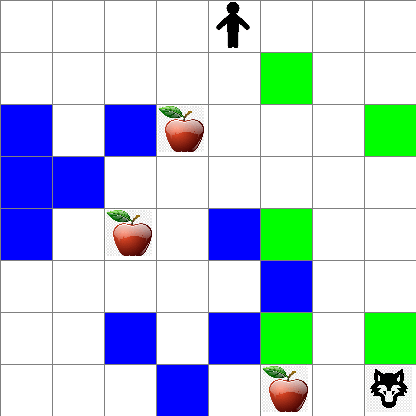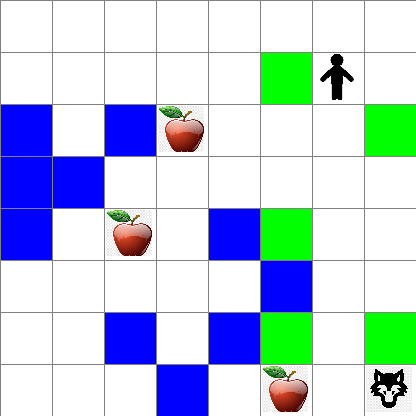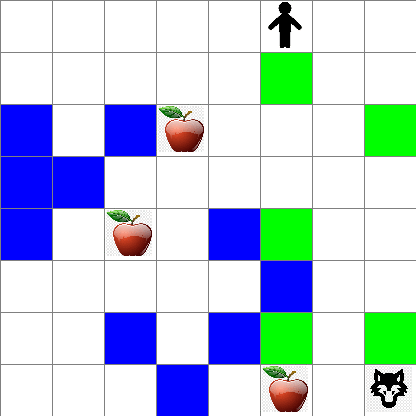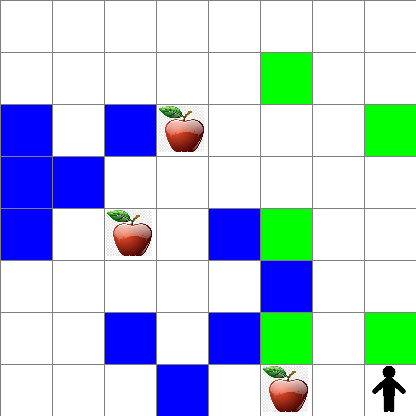
Mükafat funksiyası
Taktikamızı daha ağıllı etmək üçün hansı hərəkətlərin digərlərindən “daha yaxşı” olduğunu başa düşməliyik. Bunun üçün hədəfimizi müəyyən etməliyik.
Məqsəd mükafat funksiyası ilə müəyyən edilə bilər ki, bu da hər bir vəziyyət üçün müəyyən xal dəyərini qaytaracaq. Sayı nə qədər çox olarsa, mükafat funksiyası bir o qədər yaxşı olar.(5. kod bloku)
move_reward = -0.1
goal_reward = 10
end_reward = -10

def reward(m,pos=None):
    pos = pos or m.human
    if not m.is_valid(pos):
        return end_reward
    x = m.at(pos)
    if x==Board.Cell.water or x == Board.Cell.wolf:
        return end_reward
    if x==Board.Cell.apple:
        return goal_reward
    return move_reward
Mükafat funksiyaları ilə bağlı maraqlı məqam ondan ibarətdir ki, əksər hallarda bizə yalnız oyunun sonunda əhəmiyyətli bir mükafat verilir. Bu o deməkdir ki, alqoritmimiz sonda müsbət mükafata səbəb olan “yaxşı” addımları birtəhər yadda saxlamalı və onların əhəmiyyətini artırmalıdır. Eyni qayda ilə, pis nəticələrə səbəb olan bütün hərəkətlərdən də çəkinməsi lazımdır.
Q-Öyrənməsi
Burada müzakirə edəcəyimiz alqoritm Q-Öyrənməsi adlanır. Bu alqoritmdəki taktika Q-Cədvəl adlı funksiya(və ya data strukturu) ilə müəyyən edilir. O, verilmiş vəziyyət üçün hər bir addımın "yaxşılığını" qeyd edir.
Bu məlumatı, cədvəl və ya çoxölçülü massiv kimi təqdim etmək əksər hallarda rahat olduğu üçün Q-Cədvəli deyə adlanır. Lövhəmizin en x hündürlük ölçüləri olduğundan, biz Q-Cədvəlini en x hündürlük x len(actions) formalı numpy massivdən istifadə etməklə təmsil edə bilərik: (6. kod bloku)
Q = np.ones((width,height,len(actions)),dtype=np.float)*1.0/len(actions)
Diqqət edin ki, biz Q-Cədvəlinin bütün dəyərlərini eyni dəyərlə işə salırıq, indiki halda - 0,25. Hər bir vəziyyətdə bütün hərəkətlər eyni dərəcədə yaxşı olduğu üçün "təsadüfi gəzinti" taktikasına uyğundur. Lövhədə cədvəli vizuallaşdırmaq üçün Q-Cədvəlini plot funksiyasına ötürə bilərik: m.plot(Q).
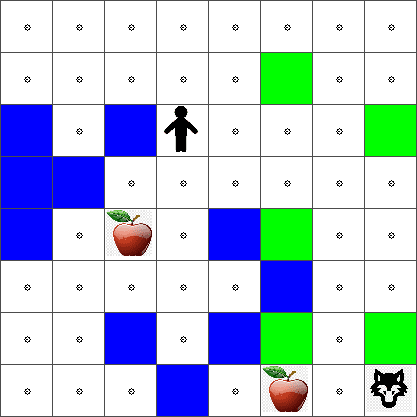
Hər bir hüceyrənin mərkəzində üstünlük verilən hərəkət istiqamətini göstərən "ox" var. Bütün istiqamətlər bərabər olduğundan, nöqtə ilə göstərilmişdir.
İndi biz, almaya gedən yolu daha tez tapmaq üçün simulyasiyanı işə salmalı, ətrafımızı araşdırmalı və Q-Cədvəl dəyərlərinin daha yaxşı paylanmasını öyrənməliyik.
Q-öyrənməsinin mahiyyəti: Bellman tənliyi
Hərəkət etməyə başladıqdan sonra hər bir gedişin müvafiq mükafatı olacaq. Nəzəri olaraq ən yüksək ani mükafat əsasında növbəti addımı seçə bilərik. Bununla belə, əksər vəziyyətlərdə, atılan addım almaya çatmaq hədəfimizə nail olmayacaq və buna görə də hansı istiqamətin daha yaxşı olduğuna dərhal qərar verə bilməyəcəyik.
Unutmayın ki, vacib olan ani nəticə deyil, simulyasiyanın sonunda əldə edəcəyimiz son nəticədir.
Bu gecikmiş mükafatı hesablamaq üçün problemi rekursiv şəkildə düşünməyə imkan verən dinamik proqramlaşdırma prinsiplərindən istifadə etməliyik.
Tutaq ki, biz indi s vəziyyətindəyik və növbəti s' vəziyyətinə keçmək istəyirik. Bunu etməklə, biz mükafat funksiyası ilə müəyyən edilən ani mükafatı(r(s,a)), və gələcək mükafatı alacağıq. Q-Cədvəlimizin hər bir hərəkətin "cəlbediciliyini" düzgün əks etdirdiyini fərz etsək, s' vəziyyətində Q(s',a')-in maksimum dəyərinə uyğun gələn a addımını seçəcəyik. Beləliklə, s vəziyyətində əldə edə biləcəyimiz ən yaxşı gələcək mükafat maxa'Q(s',a') kimi müəyyən ediləcək(burada maksimum s' vəziyyətindəki bütün mümkün a' addımlarının üzərində hesablanır).
Bu da bizə, verilmiş a addımı üçün Q-Cədvəlinin s vəziyyətində dəyərinin hesablanması üçün olan Bellman düsturunu vermiş olur:
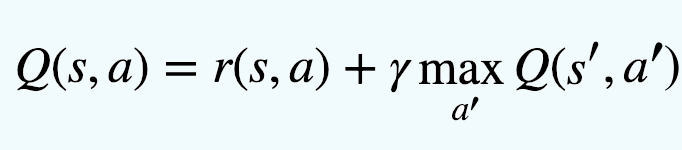
Burada γ endirim faktoru adlanır və cari mükafata və ya bunun əksinə, gələcək mükafata nə dərəcədə üstünlük verməli olduğunuzu müəyyən edir.
Öyrənmə Alqoritmi
Yuxarıdakı tənliyi nəzərə alaraq, indi öyrənmə alqoritmimiz üçün psevdokod yaza bilərik:
- Q-Cədvəli Q-ü bütün vəziyyət və gedişlər üçün bərabər ədədlərlə yaradın
- Öyrənmə dərəcəsini α ← 1 təyin edin
- Simulyasiyanı dəfələrlə təkrarlayın
- Təsadüfi mövqedən başlayın
- Təkrar edin
- s vəziyyətində a addımını seçin
- Yeni vəziyyətə keçərək gedişi yerinə yetirin s'
- Oyunun sonu vəziyyəti ilə qarşılaşsaq və ya ümumi mükafat çox kiçik olarsa - simulyasiyadan çıxın
- Yeni vəziyyətdə r mükafatını hesablayın
- Q-Funksiyasını Bellman tənliyinə uyğun yeniləyin: Q(s,a) ← (1-α)Q(s,a)+α(r+γ maxa'Q( s',a'))
- s ← s'
- Ümumi mükafatı yeniləyin və α-nı azaldın.
İstifadə ilə Kəşf qarşı-qarşıya
Yuxarıdakı alqoritmdə 2.1-ci addımda gedişi necə dəqiq seçməli olduğumuzu müəyyənləşdirməmişik. Addımı təsadüfi seçsək, ətrafı təsadüfi formada tədqiq edəcəyimiz üçün, tez-tez ölmək, eləcə də normalda getmədiyimiz əraziləri araşdırmaq kimi ehtimallarımız var. Alternativ yanaşma isə artıq bildiyimiz Q-Cədvəl dəyərlərini istifadə etmək və bununla da, s vəziyyətində ən yaxşı hərəkəti(daha yüksək Q-Cədvəl dəyəri ilə) seçmək olardı. Amma, belə etmək, digər vəziyyətləri araşdırmağımıza mane olacaq və çox güman ki, optimal həlli tapa bilməyəcəyik.
Beləliklə, ən yaxşı yanaşma kəşfiyyat və istifadə arasında balansı qorumaqdır. Bu, Q-Cədvəlindəki dəyərlərə mütənasib ehtimallarla s vəziyyətində hərəkəti seçməklə edilə bilər. Başlanğıcda, Q-Cədvəl dəyərləri eyni olduqda, bu, təsadüfi seçimə uyğun olacaq, lakin ətrafımız haqqında daha çox öyrəndikcə, arabir agentə araşdırılmamış yolu seçməyə icazə verərkən, optimal marşrutu izləmək ehtimalımız daha yüksək olacaq.
Python üzərindən icrası
İndi biz öyrənmə alqoritmini həyata keçirməyə hazırıq. Bunu etməzdən əvvəl bizə Q-Cədvəlindəki ixtiyari ədədləri müvafiq hərəkətlər üçün ehtimallar vektoruna çevirəcək bəzi funksiyalar da lazımdır.
-
probs()funksiyası yaradın:def probs(v,eps=1e-4): v = v-v.min()+eps v = v/v.sum() return vİlkin halda vektorun bütün komponentləri eyni olduqda 0-a bölünmədən yayınmaq üçün orijinal vektora bir neçə
epsəlavə edirik.
5000 təcrübə və ya iterasiya vasitəsilə öyrənmə alqoritmini işə salın: (8. kod bloku)
```python
for epoch in range(5000):

    # Pick initial point
    m.random_start()

    # Start travelling
    n=0
    cum_reward = 0
    while True:
        x,y = m.human
        v = probs(Q[x,y])
        a = random.choices(list(actions),weights=v)[0]
        dpos = actions[a]
        m.move(dpos,check_correctness=False) # we allow player to move outside the board, which terminates episode
        r = reward(m)
        cum_reward += r
        if r==end_reward or cum_reward < -1000:
            lpath.append(n)
            break
        alpha = np.exp(-n / 10e5)
        gamma = 0.5
        ai = action_idx[a]
        Q[x,y,ai] = (1 - alpha) * Q[x,y,ai] + alpha * (r + gamma * Q[x+dpos[0], y+dpos[1]].max())
        n+=1
```
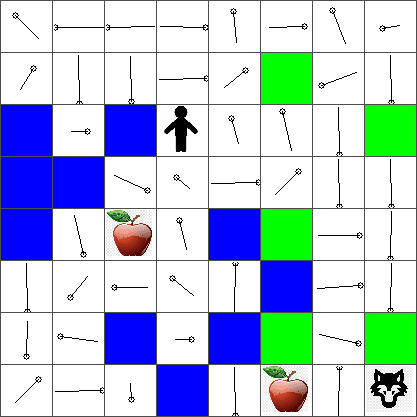
Bu alqoritmi yerinə yetirdikdən sonra Q-Cədvəli hər addımda müxtəlif hərəkətlərin cəlbediciliyini müəyyən edən dəyərlərlə yenilənməlidir. İstənilən hərəkət istiqamətini göstərəcək hər bir hüceyrədə bir vektor çəkərək Q-Cədvəlini vizuallaşdırmağa cəhd edə bilərik. Sadəlik üçün ox ucluğu əvəzinə kiçik bir dairə çəkirik.
Taktikanın yoxlanılması
Q-Cədvəli hər bir vəziyyətdə hər bir addımın "cəlbediciliyini" saxladığı üçün dünyamızda səmərəli naviqasiyanı müəyyən etmək üçün ondan istifadə etmək olduqca asandır. Ən sadə halda, ən yüksək Q-Cədvəl dəyərinə uyğun hərəkəti seçə bilərik: (9. kod bloku)
def qpolicy_strict(m):
        x,y = m.human
        v = probs(Q[x,y])
        a = list(actions)[np.argmax(v)]
        return a

walk(m,qpolicy_strict)
Yuxarıdakı kodu bir neçə dəfə sınasanız, onun bəzən "donduğunu" görə bilərsiniz. Belə olduqda onu dayandırmaq üçün noutbukda STOP düyməsini sıxmalısınız. Bu hal iki vəziyyətin optimal Q-Dəyəri baxımından bir-birinə "işarə etdiyi" zaman yarana bilər. Həmin durumda agentlər bu vəziyyətlər arasında qeyri-müəyyən müddətə qədər hərəkət etmiş olur.
🚀 Məşğələ
Tapşırıq 1: Yolun maksimum uzunluğunu müəyyən sayda addımlarla (məsələn, 100) məhdudlaşdırmaq üçün
walkfunksiyasını dəyişdirin və yuxarıdakı kodun vaxtaşırı bu dəyəri qaytarmasına baxın.
Tapşırıq 2:
walkfunksiyasını elə dəyişdirin ki, o, əvvəllər olduğu yerlərə qayıtmasın. Belə etməkwalk-un döngüyə girməsinin qarşısını alsa da, agent yenə də qaça bilməyəcəyi yerdə "tələyə" düşə bilər.
Naviqasiya
Daha yaxşı naviqasiya taktikası təlim zamanı istifadə etdiyimiz istifadə və kəşfiyyatı birləşdirmiş olan versiya olardı. Bu taktika biz hər bir hərəkəti Q-Cədvəlindəki dəyərlərə mütənasib olaraq müəyyən bir ehtimalla seçəcəyik. Bu strategiya hələ də agentin artıq tədqiq etdiyi mövqeyə qayıtması ilə nəticələnə bilər, lakin, aşağıdakı koddan da göründüyü kimi, bu sizə istədiyiniz məkana olan çox qısa orta yolu verir(unutmayın ki, print_statistics simulyasiyanı 100 dəfə həyata keçirir): (10. kod bloku)
def qpolicy(m):
        x,y = m.human
        v = probs(Q[x,y])
        a = random.choices(list(actions),weights=v)[0]
        return a

print_statistics(qpolicy)
Bu kodu işlətdikdən sonra əvvəlkindən daha kiçik, 3-6 aralığında dəyişən orta yol uzunluğu əldə etməlisiniz.
Öyrənmə prosesinin tədqiqi
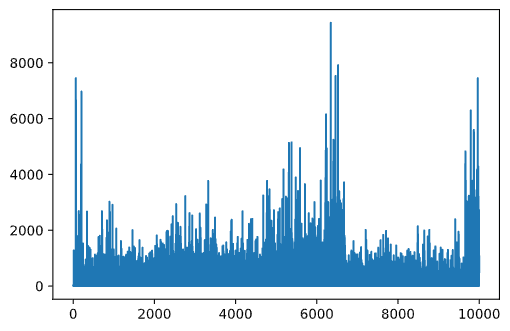
Qeyd etdiyimiz kimi, təlim prosesi problem məkanının strukturu haqqında əldə edilmiş biliklərin tədqiqi və ümumi kəşfi arasındakı balansdır. Öyrənmənin nəticələrinin(agentə hədəfə olan qısa yolu tapmaqda kömək etmək qabiliyyəti) yaxşılaşdığını görmüş olsaq da, öyrənmə prosesi zamanı orta yol uzunluğunun necə davrandığını müşahidə etmək də bir o qədər maraqlı olardı:
Öyrənilənləri belə ümumiləşdirmək olar:
-
Orta yol uzunluğu artır. Burada gördüyümüz odur ki, əvvəlcə orta yol uzunluğu artır. Bu, yəqin ki, ətraf mühit haqqında heç nə bilmədiyimiz zaman pis vəziyyətlərdə, suda və ya canavarda tələyə düşmək ehtimalımızla bağlıdır. Daha çox öyrəndikcə və bu biliklərdən istifadə etməyə başladıqda, ətraf mühiti daha uzun müddət araşdıra bilərik. Bununla belə, almaların harada daha çox olduğunu hələ də bilmiş olmuruq.
-
Daha çox öyrəndikcə yol uzunluğu azalır. Kifayət qədər öyrəndikdən sonra agentin hədəfə çatması asanlaşır və yol uzunluğu azalmağa başlayır. Amma, biz hələ də kəşfiyyata açığıq, ona görə də biz tez-tez ən yaxşı yoldan uzaqlaşırıq və yeni variantları araşdıraraq yolu optimaldan daha uzun edirik.
-
Uzunluğun kəskin artması. Bu qrafikdə də müşahidə etdiyimiz odur ki, müəyyən bir nöqtədə uzunluq kəskin şəkildə artır. Bu, prosesin stoxastik xarakterini göstərir və biz nə vaxtsa Q-Cədvəl əmsallarını yeni dəyərlərlə əvəz etməklə onları "korlaya" bilərik. İdeal olaraq, bu, öyrənmə sürətini azaltmaqla minimuma endirilməlidir(məsələn, təlimin sonuna doğru biz Q-Cədvəl dəyərlərini yalnız kiçik bir dəyərlə tənzimləyirik).
Ümumiyyətlə, yadda saxlamaq lazımdır ki, təlim prosesinin uğuru və keyfiyyəti öyrənmə sürəti, öyrənmə sürətinin azalması və endirim faktoru kimi parametrlərdən əhəmiyyətli dərəcədə asılıdır. Təlim zamanı optimallaşdırdığımız(məsələn, Q-Cədvəl əmsalları) parametrlərdən fərqləndirmək üçün onları tez-tez hiperparametrlər adlandırırlar. Ən yaxşı hiperparametr dəyərlərinin tapılması prosesi hiperparametrlərin optimallaşdırılması adlanır və bu, ayrıca mövzu səviyyəsindədir.