
14 KiB
Regresyon modelleri için Python ve Scikit-learn'e giriş
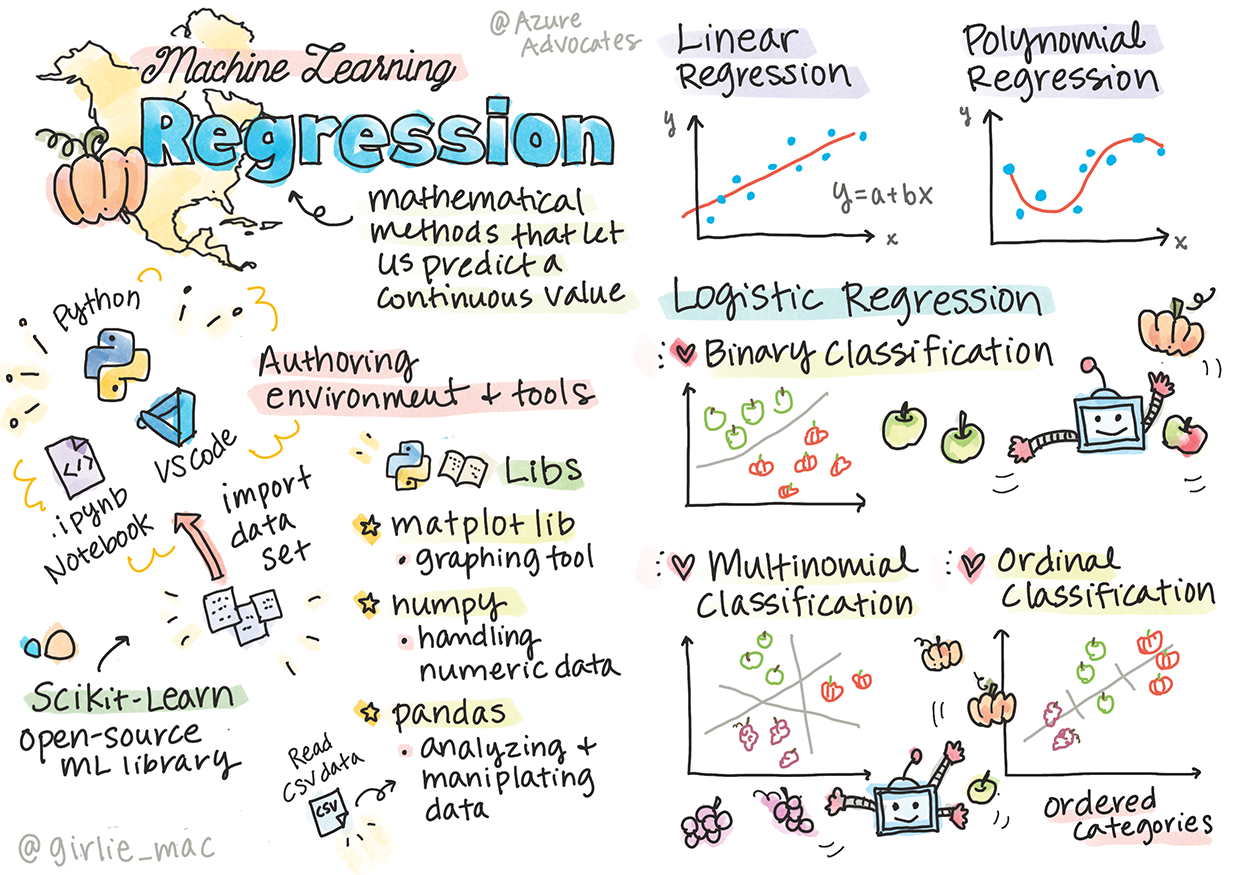
Sketchnote by Tomomi Imura
Ders öncesi quiz
R dili ile bu dersin içeriği!
Giriş
Bu dört derste, regresyon modellerinin nasıl oluşturulacağını keşfedeceksiniz.Bunların ne için olduğunu birazdan tartışacağız. Ancak herhangi bir şey yapmadan önce, süreci başlatmak için doğru araçlara sahip olduğunuzdan emin olun!
Bu derste, şunları öğreneceğiz:
- Bilgisayarınızı yerel makine öğrenimi görevleri için yapılandırma.
- Jupyter notebooks ile çalışmayı.
- Scikit-learn kullanmayı, kurulum da dahil.
- Uygulamalı alıştırma ile doğrusal(lineer) regresyonu keşfedin.
Kurulum ve Konfigürasyonlar

🎥 Video için yukarıdaki resme tıklayınız: Python'u VS Code içinde kullanma.
-
Python Kurulumu. Python kurulumunun bilgisayarınızda yüklü olduğundan emin olun.Python'u birçok veri bilimi ve makine öğrenimi görevi için kullanacaksınız. Çoğu bilgisayar sistemi zaten bir Python kurulumu içerir. Şurada Python Kodlama Paketleri mevcut, bazı kullanıcılar için kurulumu daha kolay.
Ancak Python'un bazı kullanımları, yazılımın spesifik bir sürümünü gerektirir, diğerleri ise farklı bir sürüm gerektirir. Bu yüzden, virtual environment (sanal ortamlar) ile çalışmak daha kullanışlıdır.
-
Visual Studio Code kurulumu. Visual Studio Code'un bilgisayarınıza kurulduğundan emin olun. Visual Studio Code kurulumu bu adımları takip ederek basitçe bir kurulum yapabilirsiniz. Bu kursta Python'ı Visual Studio Code'un içinde kullanacaksınız, bu yüzden nasıl yapılacağını görmek isteyebilirsiniz. Python ile geliştirme için Visual Studio Code konfigürasyonu.
Bu koleksiyon üzerinde çalışarak Python ile rahatlayın. Modülleri öğren
-
Scikit-learn kurulumu, bu talimatları takip ediniz. Python 3 kullandığınızdan emin olmanız gerektiğinden, sanal ortam kullanmanız önerilir. Not, bu kütüphaneyi bir M1 Mac'e kuruyorsanız, yukarıda bağlantısı verilen sayfada özel talimatlar var onları takip ediniz.
-
Jupyter Notebook kurulumu. Jupyter package'ı kurmanız gerekmektedir.
Makine öğrenimi geliştirme ortamınız
Python kodunuzu geliştirmek ve makine öğrenimi modelleri oluşturmak için notebook kullanacaksınız. Bu dosya türü, veri bilimcileri için yaygın bir araçtır ve bunlar, ".ipynb" son eki veya uzantısıyla tanımlanabilir.
Notebook'lar, geliştiricinin hem kod yazmasına hem de notlar eklemesine ve kodun etrafına deneysel veya araştırma odaklı projeler için oldukça yararlı olan dökümantasyonlar yazmasına izin veren etkileşimli bir ortamdır.
Alıştırma - notebook'larla çalışmak
Bu klasörde, notebook.ipynb adlı dosyası bulacaksınız.
- notebook.ipynb dosyasını Visual Studio Code ile açınız.
Bir Jupyter serveri Python 3+ ile beraber başlayacaktır. Notebook içinde kod parçalarını çalıştıracak run alanını göreceksiniz. Play butonuna benzeyen buton ile kod bloklarını çalıştırabileceksiniz.
-
mdikonunu seçip bir markdown ekleyelim ve # Welcome to your notebook yazalım.Sonra, biraz Python kodu ekleyelim.
-
Kod bloğuna print('hello notebook') yazalım.
-
Ok işaretini seçip kodu çalıştıralım.
Bu ifadeyi çıktı olarak göreceksiniz:
hello notebook

Notebook'ğunuzu dökümante etmek için kodunuza yorumlar ekleyebilirsiniz.
✅ Bir web geliştiricisinin çalışma ortamının bir veri bilimcisinden ne kadar farklı olduğunu bir an için düşünün.
Scikit-learn çalışır durumda
Artık Python yerel ortamınızda kurulduğuna göre ve Jupyter notebook ile rahatsanız, hadi Scikit-learn ile de eşit derecede rahat edelim.(sci science'ın kısaltması yani bilim anlamı taşır). Scikit-learn sağladığı yaygın API ile ML görevlerinde sizlere yardım eder.
websitelerine göre, "Scikit-learn, denetimli ve denetimsiz öğrenmeyi destekleyen açık kaynaklı bir makine öğrenimi kütüphanesidir. Ayrıca model uydurma, veri ön işleme, model seçimi ve değerlendirmesi gibi diğer birçok şey için yardımcı olacak çeşitli araçlar sağlar."
Bu kursta, 'geleneksel makine öğrenimi' olarak adlandırdığımız görevleri gerçekleştirmek üzere ve makine öğrenimi modelleri oluşturmak için Scikit-learn ve diğer araçları kullanacaksınız. Yakında çıkacak olan 'Yeni Başlayanlar için Yapay Zeka' müfredatımızda daha iyi ele alındığı için sinir ağlarından ve derin öğrenme konularından bilinçli olarak kaçındık.
Scikit-learn, modeller oluşturmayı ve bunları kullanım için modeli değerlendirmeyi kolaylaştırır. Öncelikle sayısal verileri kullanmaya odaklanır ve öğrenme araçları olarak kullanılmak üzere birkaç hazır veri seti içerir. Ayrıca öğrencilerin denemesi için önceden oluşturulmuş modelleri de içerir. Önceden paketlenmiş verileri yükleme ve bazı temel verilerle birlikte Scikit-learn'de ilk ML modelini kullanma sürecini keşfedelim.
Alıştırma - ilk Scikit-learn notebook'unuz
Bu eğitim Scikit-learn web sitesindeki lineer regresyon örneğinden ilham alınmıştır.
notebook.ipynb dosyasıda bu dersle ilgili olan, tüm hücreleri 'çöp kutusu' simgesine basarak temizleyin.
Bu bölümde, öğrenme amacıyla Scikit-learn'de yerleşik olarak bulunan diyabetle ilgili küçük bir veri seti ile çalışacaksınız. Diyabet hastaları için bir tedaviyi test etmek istediğinizi hayal edin. Makine Öğrenimi modelleri, değişken kombinasyonlarına göre hangi hastaların tedaviye daha iyi yanıt vereceğini belirlemenize yardımcı olabilir. Çok basit bir regresyon modeli bile görselleştirildiğinde, teorik klinik denemelerinizi düzenlemenize yardımcı olacak değişkenler hakkında bilgi verebilir.
✅ Pek çok regresyon yöntemi vardır ve hangisini seçeceğiniz, aradığınız cevaba bağlıdır. Belirli bir yaştaki bir kişinin olası boyunu tahmin etmek istiyorsanız, sayısal bir değer aradığınız için doğrusal regresyon kullanırsınız. Bir yemeğin vegan olarak kabul edilip edilmeyeceğini keşfetmekle ilgileniyorsanız, kategorik görev olduğu için lojistik regresyon kullanmalısınız. Daha sonra lojistik regresyon hakkında daha fazla bilgi edineceksiniz. Verilere sorabileceğiniz bazı sorular ve bu yöntemlerden hangisinin daha uygun olacağı hakkında biraz düşünün.
Hadi bu görev ile başlayalım.
Kütüphaneleri Import etmek
Bu görev için bazı kütüphaneleri import edeceğiz:
- matplotlib. Kullanışlı bir grafiksel bir araç ve bir çizgi grafiği oluşturmak için kullanacağız.
- numpy. numpy Python'da nümerik verileri ele almak için kullanışlı bir kütüphane.
- sklearn. Bu da Scikit-learn kütüphanesi.
Bu görevimizde yardımcı olacak bazı kütüphaneleri import edelim.
-
Aşağıdaki kodu yazarak import edelim:
import matplotlib.pyplot as plt import numpy as np from sklearn import datasets, linear_model, model_selectionmatplotlib,numpyimport ettik vedatasets,linear_model,model_selection'ısklearnden import ettik.model_selectionveri setimizi eğitim ve test kümeleri şeklinde bölmemize yardımcı olacak.
Diyabet veri seti
Diyabet veri seti 442 tane diyabet ile ilgili örnek içeririr, 10 öznitelik değişkeni,bazıları şunları içerir:
- age: yaşı
- bmi: vücut kitle indeksi
- bp: ortalama kan basıncı
- s1 tc: T-Cells (bir tür beyaz kan hücresi)
✅ Bu veri seti, diyabet hakkında araştırma yapmak için önemli bir özellik değişkeni olarak 'cinsiyet' kavramını içerir. Birçok tıbbi veri kümesi bu tür ikili sınıflandırmayı içerir. Bunun gibi sınıflandırmaların bir popülasyonun belirli bölümlerini tedavilerden nasıl dışlayabileceğini biraz düşünün.
Şimdi, X ve y verilerini yükleyelim.
🎓 Unutmayın, bu denetimli öğrenmedir ve adlandırılmış bir 'y' hedefi vardır.
In a new code cell, load the diabetes dataset by calling load_diabetes(). The input return_X_y=True signals that X will be a data matrix, and y will be the regression target.
-
Add some print commands to show the shape of the data matrix and its first element:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
What you are getting back as a response, is a tuple. What you are doing is to assign the two first values of the tuple to
Xandyrespectively. Learn more about tuples.You can see that this data has 442 items shaped in arrays of 10 elements:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Think a bit about the relationship between the data and the regression target. Linear regression predicts relationships between feature X and target variable y. Can you find the target for the diabetes dataset in the documentation? What is this dataset demonstrating, given that target?
-
Next, select a portion of this dataset to plot by arranging it into a new array using numpy's
newaxisfunction. We are going to use linear regression to generate a line between values in this data, according to a pattern it determines.X = X[:, np.newaxis, 2]✅ At any time, print out the data to check its shape.
-
Now that you have data ready to be plotted, you can see if a machine can help determine a logical split between the numbers in this dataset. To do this, you need to split both the data (X) and the target (y) into test and training sets. Scikit-learn has a straightforward way to do this; you can split your test data at a given point.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Now you are ready to train your model! Load up the linear regression model and train it with your X and y training sets using
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()is a function you'll see in many ML libraries such as TensorFlow -
Then, create a prediction using test data, using the function
predict(). This will be used to draw the line between data groupsy_pred = model.predict(X_test) -
Now it's time to show the data in a plot. Matplotlib is a very useful tool for this task. Create a scatterplot of all the X and y test data, and use the prediction to draw a line in the most appropriate place, between the model's data groupings.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()
✅ Think a bit about what's going on here. A straight line is running through many small dots of data, but what is it doing exactly? Can you see how you should be able to use this line to predict where a new, unseen data point should fit in relationship to the plot's y axis? Try to put into words the practical use of this model.
Congratulations, you built your first linear regression model, created a prediction with it, and displayed it in a plot!
🚀Challenge
Plot a different variable from this dataset. Hint: edit this line: X = X[:, np.newaxis, 2]. Given this dataset's target, what are you able to discover about the progression of diabetes as a disease?
Post-lecture quiz
Review & Self Study
In this tutorial, you worked with simple linear regression, rather than univariate or multiple linear regression. Read a little about the differences between these methods, or take a look at this video
Read more about the concept of regression and think about what kinds of questions can be answered by this technique. Take this tutorial to deepen your understanding.