
22 KiB
Xây dựng giải pháp Machine Learning với AI có trách nhiệm
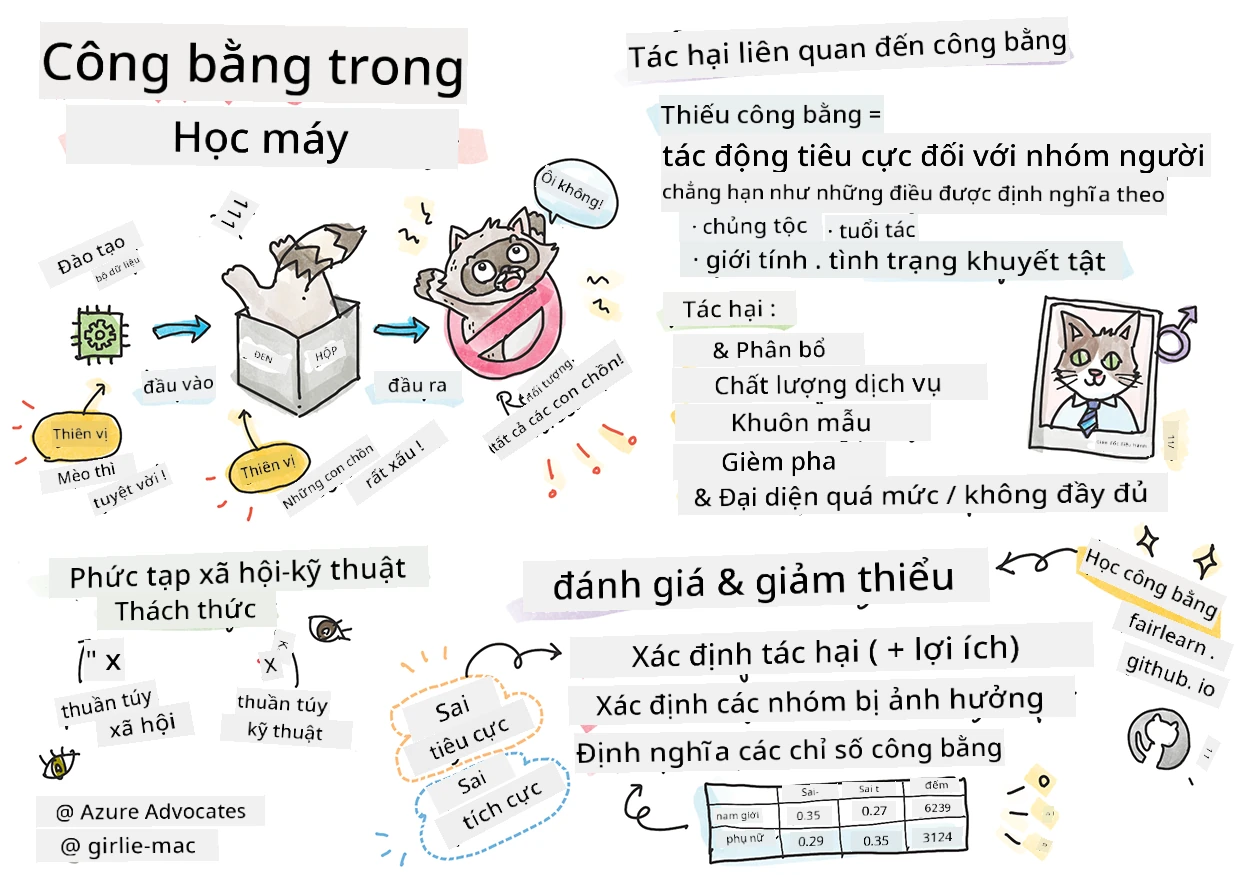
Sketchnote bởi Tomomi Imura
Kiểm tra trước bài giảng
Giới thiệu
Trong chương trình học này, bạn sẽ bắt đầu khám phá cách mà machine learning có thể và đang tác động đến cuộc sống hàng ngày của chúng ta. Ngay cả bây giờ, các hệ thống và mô hình đã tham gia vào các nhiệm vụ ra quyết định hàng ngày, chẳng hạn như chẩn đoán y tế, phê duyệt khoản vay hoặc phát hiện gian lận. Vì vậy, điều quan trọng là các mô hình này hoạt động tốt để cung cấp các kết quả đáng tin cậy. Cũng như bất kỳ ứng dụng phần mềm nào, các hệ thống AI có thể không đạt được kỳ vọng hoặc có kết quả không mong muốn. Đó là lý do tại sao việc hiểu và giải thích hành vi của một mô hình AI là thiết yếu.
Hãy tưởng tượng điều gì có thể xảy ra khi dữ liệu bạn sử dụng để xây dựng các mô hình này thiếu một số nhóm nhân khẩu học nhất định, như chủng tộc, giới tính, quan điểm chính trị, tôn giáo, hoặc đại diện không tương xứng cho các nhóm đó. Điều gì xảy ra khi kết quả của mô hình được diễn giải thiên vị một số nhóm nhân khẩu? Hệ quả của ứng dụng là gì? Ngoài ra, điều gì xảy ra khi mô hình có kết quả bất lợi và gây hại cho con người? Ai là người chịu trách nhiệm về hành vi của hệ thống AI? Đây là một số câu hỏi chúng ta sẽ khám phá trong chương trình học này.
Trong bài học này, bạn sẽ:
- Nâng cao nhận thức về tầm quan trọng của sự công bằng trong machine learning và những tổn hại liên quan đến công bằng.
- Làm quen với việc khám phá các giá trị ngoại lai và các trường hợp bất thường để đảm bảo độ tin cậy và an toàn.
- Hiểu được nhu cầu trao quyền cho mọi người bằng cách thiết kế các hệ thống bao gồm.
- Khám phá tầm quan trọng của việc bảo vệ quyền riêng tư và an ninh của dữ liệu cũng như con người.
- Thấy được tầm quan trọng của phương pháp hộp kính trong việc giải thích hành vi của các mô hình AI.
- Nhận thức rằng trách nhiệm rất cần thiết để xây dựng niềm tin vào hệ thống AI.
Yêu cầu tiên quyết
Là yêu cầu tiên quyết, vui lòng hoàn thành Lộ trình học "Nguyên tắc AI có trách nhiệm" và xem video bên dưới về chủ đề này:
Tìm hiểu thêm về AI có trách nhiệm qua Lộ trình học

🎥 Nhấp vào hình ảnh trên để xem video: Cách tiếp cận AI có trách nhiệm của Microsoft
Công bằng
Các hệ thống AI nên đối xử công bằng với mọi người và tránh gây ảnh hưởng khác nhau đến các nhóm người tương tự. Ví dụ, khi các hệ thống AI cung cấp hướng dẫn về điều trị y tế, hồ sơ vay vốn hoặc tuyển dụng, chúng nên đưa ra các khuyến nghị giống nhau cho tất cả mọi người với các triệu chứng, hoàn cảnh tài chính hoặc trình độ chuyên môn tương tự. Mỗi chúng ta với tư cách là con người đều mang trong mình những định kiến kế thừa ảnh hưởng đến quyết định và hành động của mình. Những định kiến này có thể rõ ràng trong dữ liệu được sử dụng để huấn luyện các hệ thống AI. Việc thao túng này đôi khi xảy ra một cách vô tình. Thường rất khó để ý thức biết được khi nào bạn đang đưa vào dữ liệu các định kiến.
“Thiếu công bằng” bao gồm các tác động tiêu cực, hay “tổn hại”, cho một nhóm người, như những nhóm được xác định theo chủng tộc, giới tính, tuổi tác hoặc tình trạng khuyết tật. Các tổn hại liên quan đến công bằng chính có thể được phân loại như sau:
- Phân bổ, nếu một giới tính hoặc dân tộc được ưu tiên hơn so với nhóm khác.
- Chất lượng dịch vụ. Nếu bạn huấn luyện dữ liệu cho một kịch bản cụ thể nhưng thực tế phức tạp hơn, điều đó dẫn đến dịch vụ hoạt động kém. Ví dụ, một thiết bị xịt xà phòng tay không thể cảm nhận được người có làn da tối màu. Tham khảo
- Phỉ báng. Chỉ trích và gán nhãn một cách không công bằng cho ai đó hoặc điều gì đó. Ví dụ, công nghệ gán nhãn ảnh từng nổi tiếng gán nhầm ảnh người có làn da tối màu thành hình con vượn.
- Quá mức hoặc thiếu đại diện. Ý tưởng là một nhóm người nhất định không được thấy trong một nghề nghiệp nào đó, và bất kỳ dịch vụ hoặc chức năng nào tiếp tục thúc đẩy điều này đều góp phần gây tổn hại.
- Định kiến. Liên kết một nhóm người nhất định với các thuộc tính được gán trước. Ví dụ, hệ thống dịch ngôn ngữ giữa tiếng Anh và tiếng Thổ Nhĩ Kỳ có thể có những lỗi do các từ gắn liền với các định kiến giới tính.
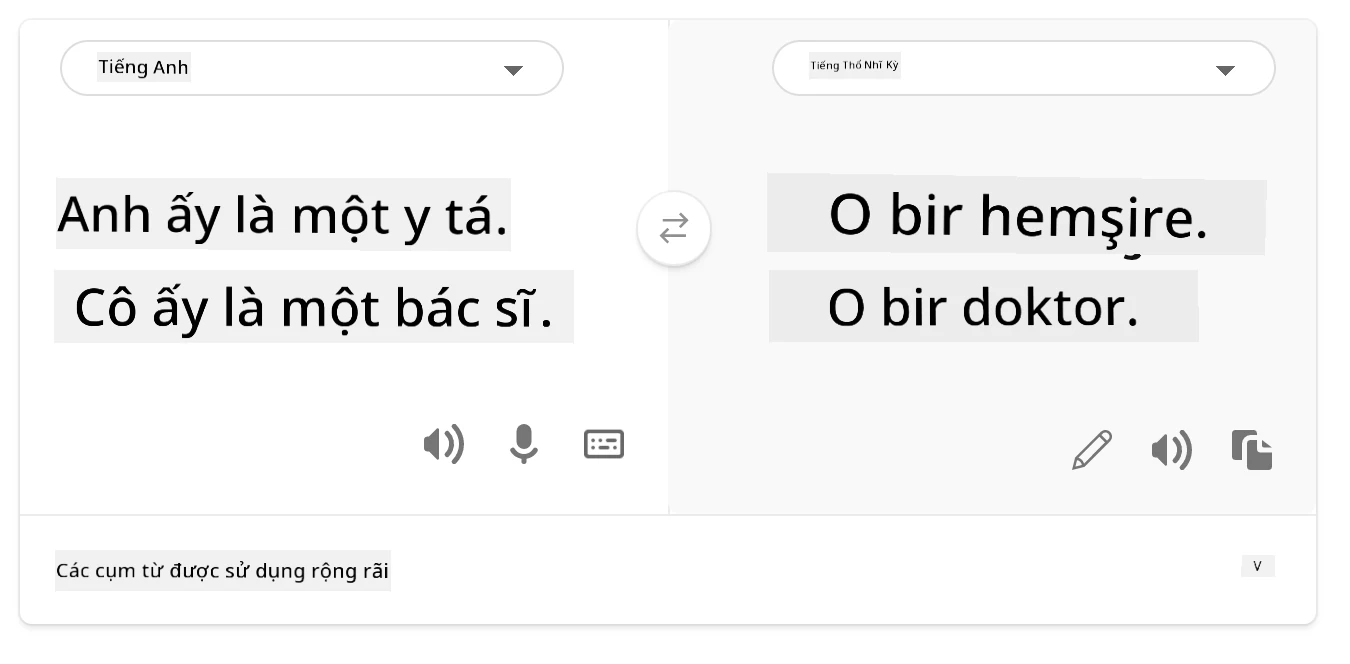
dịch sang tiếng Thổ Nhĩ Kỳ
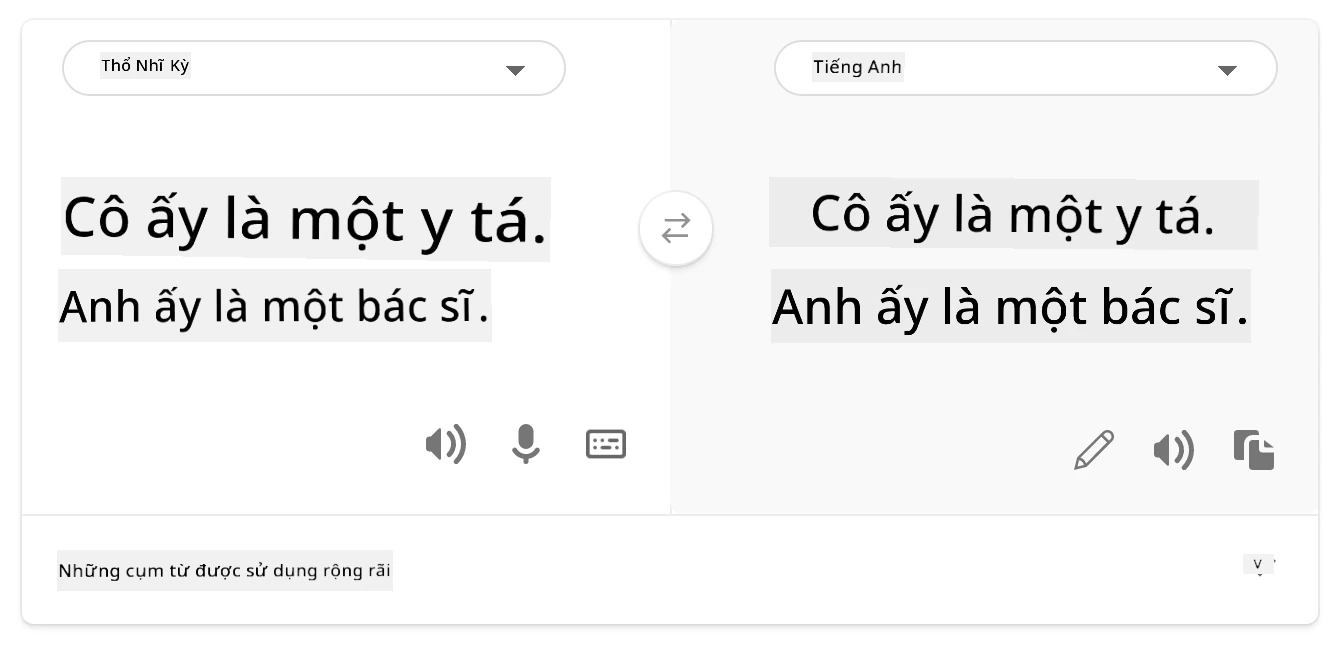
dịch ngược sang tiếng Anh
Khi thiết kế và kiểm thử các hệ thống AI, chúng ta cần đảm bảo AI công bằng và không được lập trình để đưa ra các quyết định thiên vị hoặc phân biệt đối xử, điều mà con người cũng bị cấm làm. Đảm bảo công bằng trong AI và machine learning vẫn là một thách thức kỹ thuật xã hội phức tạp.
Độ tin cậy và an toàn
Để xây dựng niềm tin, các hệ thống AI cần phải đáng tin cậy, an toàn và nhất quán trong điều kiện bình thường cũng như bất ngờ. Quan trọng là phải biết các hệ thống AI sẽ hành xử như thế nào trong nhiều tình huống khác nhau, đặc biệt là khi chúng là các giá trị ngoại lai. Khi xây dựng các giải pháp AI, cần tập trung đáng kể vào việc xử lý nhiều trường hợp mà các giải pháp AI có thể gặp phải. Ví dụ, xe tự lái cần đặt sự an toàn của con người lên hàng đầu. Do đó, AI của xe cần phải xem xét tất cả các kịch bản có thể xảy ra như ban đêm, giông bão, bão tuyết, trẻ nhỏ chạy qua đường, thú nuôi, công trình xây dựng đường v.v. Khả năng một hệ thống AI xử lý đa dạng điều kiện một cách tin cậy và an toàn phản ánh mức độ dự liệu của nhà khoa học dữ liệu hoặc nhà phát triển AI trong quá trình thiết kế hoặc thử nghiệm hệ thống.
Tính toàn diện
Các hệ thống AI nên được thiết kế để thu hút và trao quyền cho mọi người. Khi thiết kế và triển khai hệ thống AI, các nhà khoa học dữ liệu và nhà phát triển AI xác định và giải quyết các rào cản tiềm năng trong hệ thống mà có thể vô tình loại trừ một số người. Ví dụ, có 1 tỷ người khuyết tật trên thế giới. Với sự phát triển của AI, họ có thể tiếp cận nhiều thông tin và cơ hội một cách dễ dàng hơn trong cuộc sống hàng ngày. Bằng cách giải quyết các rào cản, điều này tạo ra cơ hội để đổi mới và phát triển các sản phẩm AI với trải nghiệm tốt hơn, đem lại lợi ích cho mọi người.
An ninh và quyền riêng tư
Các hệ thống AI cần an toàn và tôn trọng quyền riêng tư của con người. Mọi người sẽ ít tin tưởng các hệ thống có nguy cơ làm tổn hại đến quyền riêng tư, thông tin hoặc cuộc sống của họ. Khi huấn luyện các mô hình machine learning, chúng ta dựa vào dữ liệu để tạo ra kết quả tốt nhất. Trong quá trình đó, nguồn gốc và tính toàn vẹn của dữ liệu phải được xem xét. Ví dụ, dữ liệu là do người dùng cung cấp hay là thông tin công khai? Tiếp theo, khi làm việc với dữ liệu, việc phát triển các hệ thống AI có khả năng bảo vệ thông tin bí mật và chống lại các cuộc tấn công là vô cùng quan trọng. Khi AI trở nên phổ biến hơn, việc bảo vệ quyền riêng tư và đảm bảo an ninh thông tin cá nhân và doanh nghiệp ngày càng quan trọng và phức tạp hơn. Vấn đề quyền riêng tư và bảo mật dữ liệu đòi hỏi sự chú ý đặc biệt đối với AI vì việc truy cập dữ liệu là cần thiết để các hệ thống AI có thể đưa ra các dự đoán và quyết định chính xác, có cơ sở về con người.
- Là một ngành công nghiệp, chúng ta đã đạt được những tiến bộ đáng kể về Quyền riêng tư & An ninh, được thúc đẩy đáng kể bởi các quy định như GDPR (Quy định Bảo vệ Dữ liệu Chung).
- Tuy nhiên với các hệ thống AI, chúng ta phải thừa nhận sự căng thẳng giữa nhu cầu có nhiều dữ liệu cá nhân hơn để làm cho các hệ thống trở nên cá nhân hóa và hiệu quả hơn – và quyền riêng tư.
- Giống như khi các máy tính kết nối Internet ra đời, chúng ta cũng đang chứng kiến sự gia tăng lớn về các vấn đề bảo mật liên quan đến AI.
- Đồng thời, AI cũng được sử dụng để cải thiện an ninh. Ví dụ, hầu hết các phần mềm chống virus hiện đại ngày nay đều được điều khiển bởi các thuật toán AI.
- Chúng ta cần đảm bảo rằng các quy trình Khoa học Dữ liệu của mình hòa hợp với các thực hành quyền riêng tư và an ninh mới nhất.
Minh bạch
Các hệ thống AI cần dễ hiểu. Một phần quan trọng của sự minh bạch là giải thích hành vi của các hệ thống AI và các thành phần của chúng. Cải thiện sự hiểu biết về các hệ thống AI đòi hỏi các bên liên quan phải hiểu cách thức và lý do hoạt động của chúng để có thể xác định các vấn đề về hiệu suất, an toàn và quyền riêng tư, các định kiến, các thực hành loại trừ, hoặc các kết quả không mong muốn. Chúng tôi cũng tin rằng những người sử dụng hệ thống AI nên trung thực và minh bạch về khi nào, tại sao và như thế nào họ chọn triển khai chúng, cũng như các giới hạn của các hệ thống họ sử dụng. Ví dụ, nếu một ngân hàng sử dụng hệ thống AI để hỗ trợ quyết định cho vay tiêu dùng, điều quan trọng là phải xem xét các kết quả và hiểu dữ liệu nào ảnh hưởng đến các đề xuất của hệ thống. Các chính phủ đang bắt đầu điều chỉnh AI trong các ngành công nghiệp, do đó các nhà khoa học dữ liệu và tổ chức phải giải thích nếu một hệ thống AI đáp ứng các yêu cầu quy định, đặc biệt khi có kết quả không mong muốn.
- Vì các hệ thống AI rất phức tạp, nên rất khó để hiểu cách chúng hoạt động và giải thích các kết quả.
- Sự thiếu hiểu biết này ảnh hưởng đến cách các hệ thống này được quản lý, triển khai và tài liệu hóa.
- Điều quan trọng hơn là sự thiếu hiểu biết này ảnh hưởng đến các quyết định được đưa ra dựa trên kết quả mà các hệ thống này tạo ra.
Trách nhiệm giải trình
Những người thiết kế và triển khai hệ thống AI phải chịu trách nhiệm về cách hệ thống vận hành. Nhu cầu về trách nhiệm càng trở nên thiết yếu với các công nghệ sử dụng nhạy cảm như nhận dạng khuôn mặt. Gần đây, nhu cầu về công nghệ nhận dạng khuôn mặt ngày càng tăng, đặc biệt từ các tổ chức thực thi pháp luật, những người thấy tiềm năng của công nghệ này trong các trường hợp như tìm kiếm trẻ mất tích. Tuy nhiên, các công nghệ này có thể bị chính phủ sử dụng để đe dọa các quyền tự do cơ bản của công dân bằng cách, ví dụ, cho phép giám sát liên tục các cá nhân cụ thể. Do đó, các nhà khoa học dữ liệu và tổ chức cần có trách nhiệm về cách hệ thống AI của họ ảnh hưởng đến cá nhân hoặc xã hội.
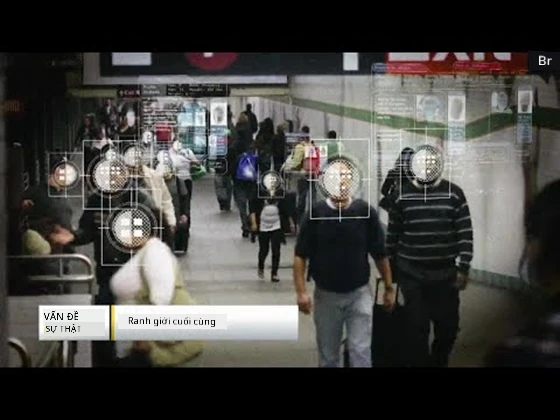
🎥 Nhấp vào hình ảnh trên để xem video: Cảnh báo về giám sát hàng loạt qua nhận dạng khuôn mặt
Cuối cùng, một trong những câu hỏi lớn nhất dành cho thế hệ chúng ta, thế hệ đầu tiên đưa AI vào xã hội, là làm thế nào để đảm bảo rằng máy tính sẽ luôn chịu trách nhiệm trước con người và làm sao để những người thiết kế máy tính cũng luôn chịu trách nhiệm trước mọi người khác.
Đánh giá tác động
Trước khi huấn luyện một mô hình machine learning, việc thực hiện đánh giá tác động là quan trọng để hiểu mục đích của hệ thống AI; mục đích sử dụng dự kiến là gì; nó sẽ được triển khai ở đâu; và ai sẽ tương tác với hệ thống. Điều này giúp cho người đánh giá hoặc người kiểm thử khi đánh giá hệ thống biết những yếu tố cần xem xét khi xác định rủi ro tiềm ẩn và hậu quả mong đợi.
Dưới đây là các lĩnh vực cần tập trung khi tiến hành đánh giá tác động:
- Tác động bất lợi lên cá nhân. Nhận thức về bất kỳ hạn chế hay yêu cầu nào, sử dụng không hỗ trợ hoặc giới hạn biết trước ảnh hưởng đến hiệu suất của hệ thống là rất quan trọng để đảm bảo hệ thống không được sử dụng theo cách gây hại cho cá nhân.
- Yêu cầu về dữ liệu. Hiểu được cách và nơi hệ thống sử dụng dữ liệu sẽ giúp người đánh giá khám phá các yêu cầu dữ liệu mà bạn cần lưu ý (ví dụ như quy định GDPR hoặc HIPAA). Ngoài ra, xem xét liệu nguồn dữ liệu hoặc số lượng dữ liệu có đủ lớn để huấn luyện hay không.
- Tóm tắt tác động. Thu thập danh sách các tổn hại tiềm ẩn có thể phát sinh từ việc sử dụng hệ thống. Trong suốt vòng đời của ML, xem xét liệu các vấn đề đã phát hiện có được giảm thiểu hoặc giải quyết hay không.
- Mục tiêu áp dụng cho từng trong sáu nguyên tắc cốt lõi. Đánh giá xem các mục tiêu từ mỗi nguyên tắc có được đáp ứng và có khoảng trống hay không.
Gỡ lỗi với AI có trách nhiệm
Tương tự như gỡ lỗi một ứng dụng phần mềm, gỡ lỗi một hệ thống AI là quá trình cần thiết để xác định và giải quyết các vấn đề trong hệ thống. Có nhiều yếu tố ảnh hưởng đến việc một mô hình không hoạt động như mong đợi hoặc không có trách nhiệm. Hầu hết các chỉ số hiệu suất mô hình truyền thống là các đại lượng định lượng về hiệu suất của mô hình, không đủ để phân tích mô hình vi phạm các nguyên tắc AI có trách nhiệm như thế nào. Hơn nữa, một mô hình machine learning là một hộp đen khiến cho việc hiểu điều gì thúc đẩy kết quả của nó hoặc cung cấp lời giải thích khi nó mắc lỗi trở nên khó khăn. Trong phần sau của khóa học, chúng ta sẽ học cách sử dụng bảng điều khiển Responsible AI để giúp gỡ lỗi các hệ thống AI. Bảng điều khiển cung cấp một công cụ toàn diện cho các nhà khoa học dữ liệu và nhà phát triển AI thực hiện:
- Phân tích lỗi. Xác định phân bố lỗi của mô hình có thể ảnh hưởng đến sự công bằng hoặc độ tin cậy của hệ thống.
- Tổng quan mô hình. Khám phá nơi có sự khác biệt trong hiệu suất mô hình giữa các nhóm dữ liệu.
- Phân tích dữ liệu. Hiểu phân bố dữ liệu và xác định bất kỳ thiên vị tiềm ẩn trong dữ liệu có thể dẫn đến các vấn đề về công bằng, tính toàn diện và độ tin cậy.
- Khả năng diễn giải mô hình. Hiểu những gì ảnh hưởng hoặc tác động đến dự đoán của mô hình. Điều này giúp giải thích hành vi của mô hình, điều rất quan trọng cho sự minh bạch và trách nhiệm giải trình.
🚀 Thách thức
Để ngăn ngừa các tổn hại xảy ra ngay từ ban đầu, chúng ta nên:
- có sự đa dạng về nền tảng và quan điểm trong những người làm việc trên hệ thống
- đầu tư vào các bộ dữ liệu phản ánh sự đa dạng của xã hội chúng ta
- phát triển các phương pháp tốt hơn trong suốt vòng đời machine learning để phát hiện và sửa chữa AI không có trách nhiệm khi nó xảy ra
Hãy suy nghĩ về các kịch bản thực tế nơi sự không tin cậy của mô hình rõ ràng trong xây dựng và sử dụng mô hình. Chúng ta còn nên cân nhắc gì nữa?
Kiểm tra sau bài giảng
Ôn tập & Tự học
Trong bài học này, bạn đã học được một số khái niệm cơ bản về công bằng và thiếu công bằng trong machine learning.
Xem hội thảo này để đi sâu hơn vào các chủ đề:
- Trong hành trình AI có trách nhiệm: Đưa các nguyên tắc vào thực tiễn bởi Besmira Nushi, Mehrnoosh Sameki và Amit Sharma

🎥 Nhấp vào hình ảnh trên để xem video: RAI Toolbox: Một khung mã nguồn mở để xây dựng AI có trách nhiệm bởi Besmira Nushi, Mehrnoosh Sameki, và Amit Sharma
Ngoài ra, đọc thêm:
-
Trung tâm tài nguyên RAI của Microsoft: Responsible AI Resources – Microsoft AI
-
Nhóm nghiên cứu FATE của Microsoft: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
Bộ công cụ RAI:
Tìm hiểu về các công cụ của Azure Machine Learning để đảm bảo công bằng:
Bài tập
Tuyên bố miễn trừ trách nhiệm: Tài liệu này đã được dịch bằng dịch vụ dịch thuật AI Co-op Translator. Mặc dù chúng tôi cố gắng đảm bảo độ chính xác, xin lưu ý rằng bản dịch tự động có thể chứa lỗi hoặc sai sót. Tài liệu gốc bằng ngôn ngữ gốc nên được coi là nguồn tin chính thức. Đối với thông tin quan trọng, nên sử dụng dịch vụ dịch thuật chuyên nghiệp bởi con người. Chúng tôi không chịu trách nhiệm về bất kỳ hiểu lầm hoặc giải thích sai nào phát sinh từ việc sử dụng bản dịch này.