
25 KiB
ذمہ دار AI کے ساتھ مشین لرننگ کے حل تعمیر کرنا
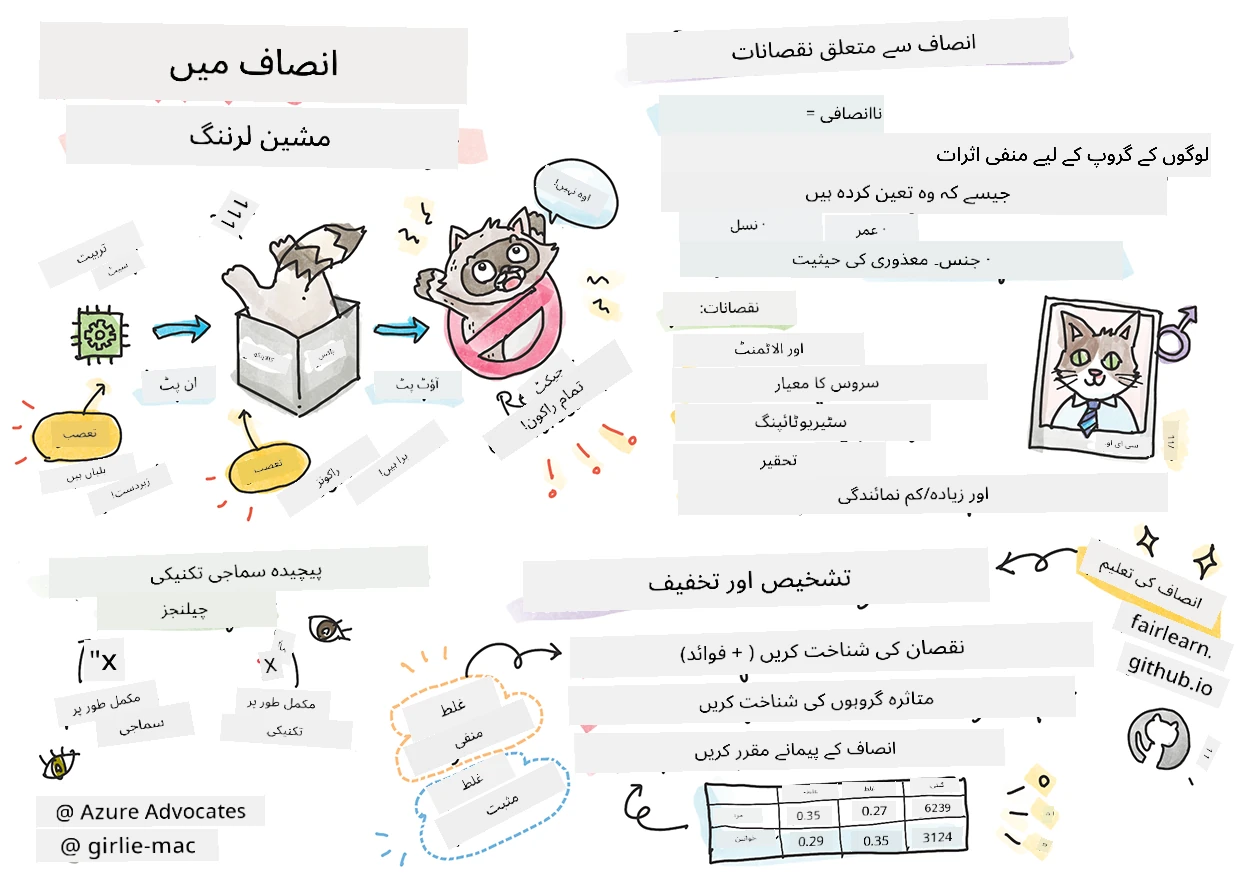
سکیچ نوٹ از Tomomi Imura
پری لیکچر کوئز
تعارف
اس نصاب میں، آپ دریافت کرنا شروع کریں گے کہ مشین لرننگ کس طرح ہماری روزمرہ زندگی کو متاثر کر رہی ہے اور کر سکتی ہے۔ ابھی بھی، نظام اور ماڈلز روزمرہ کے فیصلے کرنے کے کاموں میں شامل ہیں، جیسے صحت کی تشخیص، قرض کی منظوری، یا فراڈ کا پتہ لگانا۔ لہذا، یہ اہم ہے کہ یہ ماڈلز اچھی کارکردگی دکھائیں تاکہ قابل اعتماد نتائج فراہم کریں۔ جیسے کسی بھی سافٹ ویئر ایپلیکیشن کی طرح، AI نظام توقعات پر پورا نہیں اتر سکتے یا ناپسندیدہ نتائج دے سکتے ہیں۔ اسی لیے یہ ضروری ہے کہ AI ماڈل کے رویے کو سمجھا اور وضاحت کی جا سکے۔
تصور کریں کہ اگر آپ جو ڈیٹا ان ماڈلز کو بنانے کے لیے استعمال کر رہے ہیں اس میں کچھ آبادیاتی گروہ جیسے نسل، جنس، سیاسی نظریہ، مذہب کی کمی ہو یا غیر متناسب انداز میں نمائندگی ہو۔ جب ماڈل کے آؤٹ پٹ کو کسی مخصوص آبادیاتی گروہ کی حمایت میں تشریح کیا جائے تو کیا ہوگا؟ اس کا اطلاق پر کیا اثر ہوگا؟ مزید برآں، جب ماڈل کے نتیجے میں نقصان دہ یا افراد کے لیے نقصان دہ نتائج ہوں تو کیا ہوگا؟ AI نظام کے رویے کی ذمہ داری کس پر ہوگی؟ یہ کچھ سوالات ہیں جن کی ہم اس نصاب میں تحقیق کریں گے۔
اس سبق میں، آپ:
- مشین لرننگ میں عدل کی اہمیت اور عدل سے متعلق نقصانات کے بارے میں آگاہی بڑھائیں گے۔
- غیر معمولی واقعات اور آؤٹ لائرز کی تحقیق کے عمل سے واقف ہوں گے تاکہ اعتماد اور حفاظت کو یقینی بنایا جا سکے۔
- شامل نظام ڈیزائن کرنے کی ضرورت کو سمجھیں گے تاکہ ہر کسی کو بااختیار بنایا جا سکے۔
- اس بات کی اہمیت کا جائزہ لیں گے کہ ڈیٹا اور لوگوں کی پرائیویسی اور سیکیورٹی کی حفاظت کتنا ضروری ہے۔
- AI ماڈلز کے رویے کی وضاحت کے لیے گلاس باکس اپروچ کی اہمیت دیکھیں گے۔
- AI نظام میں اعتماد قائم کرنے کے لیے جوابدہی کی اہمیت کو سمجھیں گے۔
پیشگی ضرورت
پیشگی ضرورت کے طور پر، براہ کرم "Responsible AI Principles" لرننگ پاتھ لیں اور ذیل میں موضوع پر ویڈیو دیکھیں:
ذمہ دار AI کے بارے میں مزید جاننے کے لیے اس Learning Path کو فالو کریں

🎥 ویڈیو دیکھنے کے لیے اوپر تصویر پر کلک کریں: Microsoft's Approach to Responsible AI
عدل
AI نظام کو سب کے ساتھ منصفانہ رویہ کرنا چاہیے اور ایک جیسی خصوصیات والے گروپوں پر مختلف طریقوں سے اثر نہیں ڈالنا چاہیے۔ مثال کے طور پر، جب AI نظام طبی علاج، قرض کی درخواستیں، یا ملازمت کے بارے میں رہنمائی فراہم کرتے ہیں، تو انہیں ہر ایک کو ایک جیسی علامات، مالی حالات، یا پیشہ ورانہ اہلیت کے ساتھ ایک ہی سفارشات دینی چاہیے۔ ہر انسان میں موروثی تعصبات ہوتے ہیں جو ہمارے فیصلوں اور اقدامات کو متاثر کرتے ہیں۔ یہ تعصبات اس ڈیٹا میں ظاہر ہو سکتے ہیں جسے ہم AI نظاموں کو تربیت دینے کے لیے استعمال کرتے ہیں۔ بعض اوقات یہ منفی اثرات غیر ارادی طور پر بھی ہو سکتے ہیں۔ شعوری طور پر یہ جاننا مشکل ہوتا ہے کہ آپ ڈیٹا میں تعصب شامل کر رہے ہیں یا نہیں۔
"ناانصافی" ایسے منفی اثرات یا "نقصانات" پر مشتمل ہوتی ہے جو کسی گروہ کو پہنچتے ہیں، جیسے کہ نسل، جنس، عمر، یا معذوری کی بنیاد پر۔ اہم عدل سے متعلق نقصانات کو درج ذیل اقسام میں تقسیم کیا جا سکتا ہے:
- اختیار، اگر مثال کے طور پر صنف یا نسل کو دوسرے پر ترجیح دی جائے۔
- خدمت کا معیار۔ اگر آپ خاص صورتحال کے لیے ڈیٹا کو تربیت دیتے ہیں لیکن حقیقت زیادہ پیچیدہ ہو، تو اس کا نتیجہ کم معیار کی خدمت ہو سکتا ہے۔ مثال کے طور پر، ایک ہینڈ صابن ڈسپنسر جو گہرے رنگ کی جلد والے لوگوں کو محسوس نہیں کر پا رہا تھا۔ حوالہ
- توہین آمیز رویہ۔ کسی چیز یا کسی شخص کو زیادتی کے ساتھ تنقید کرنا اور برانڈ کرنا۔ مثال کے طور پر، ایک امیج لیبلنگ ٹیکنالوجی نے بدنامی کے ساتھ گہرے رنگ کی جلد والے لوگوں کی تصاویر کو گوریلا کے طور پر نشان زد کیا۔
- زیادہ یا کم نمائندگی۔ خیال یہ ہے کہ ایک مخصوص گروہ کسی پیشے میں نظر نہیں آتا، اور کوئی بھی خدمت یا فنکشن جو اسے مسلسل آگے بڑھاتا ہے نقصان کا باعث بنتا ہے۔
- سٹیریو ٹائپنگ۔ کسی گروہ کو پہلے سے دی گئی خصوصیات کے ساتھ منسوب کرنا۔ مثال کے طور پر، انگریزی اور ترک زبان کے درمیان ترجمہ کرنے والے نظام میں لفظوں کی صنفی سٹیریو ٹائپ کے باعث غلطیاں ہو سکتی ہیں۔
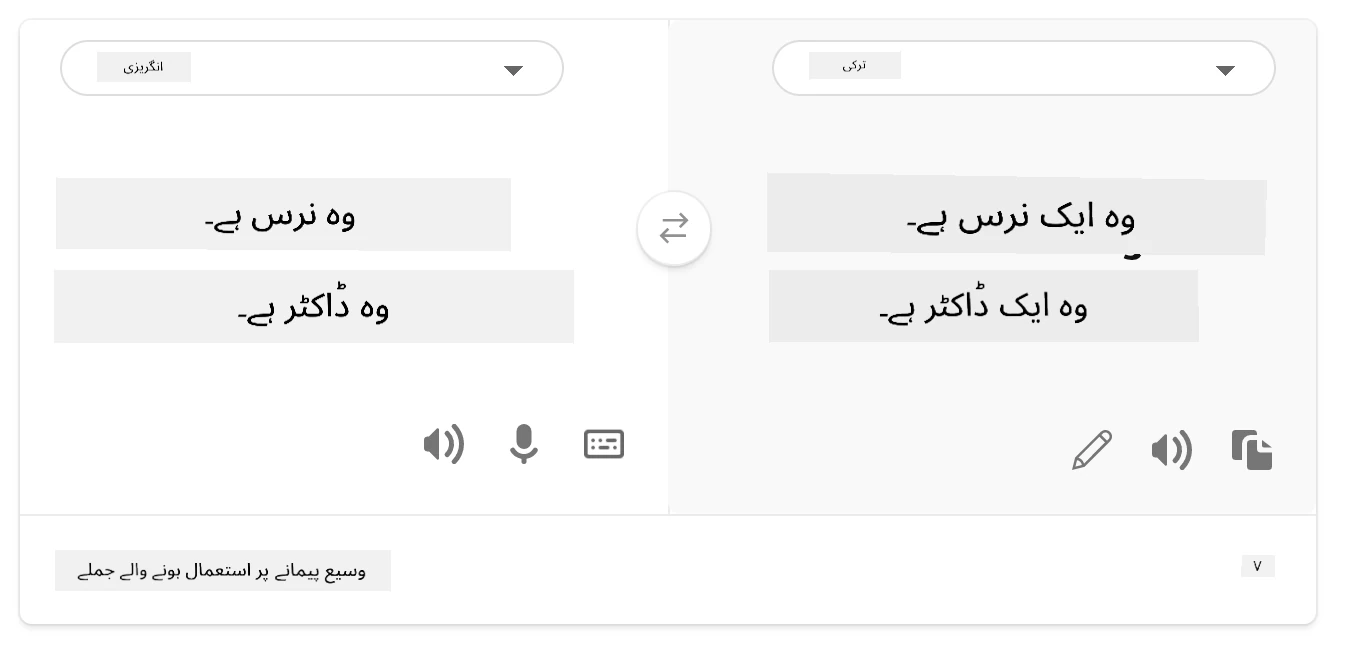
ترکی زبان میں ترجمہ
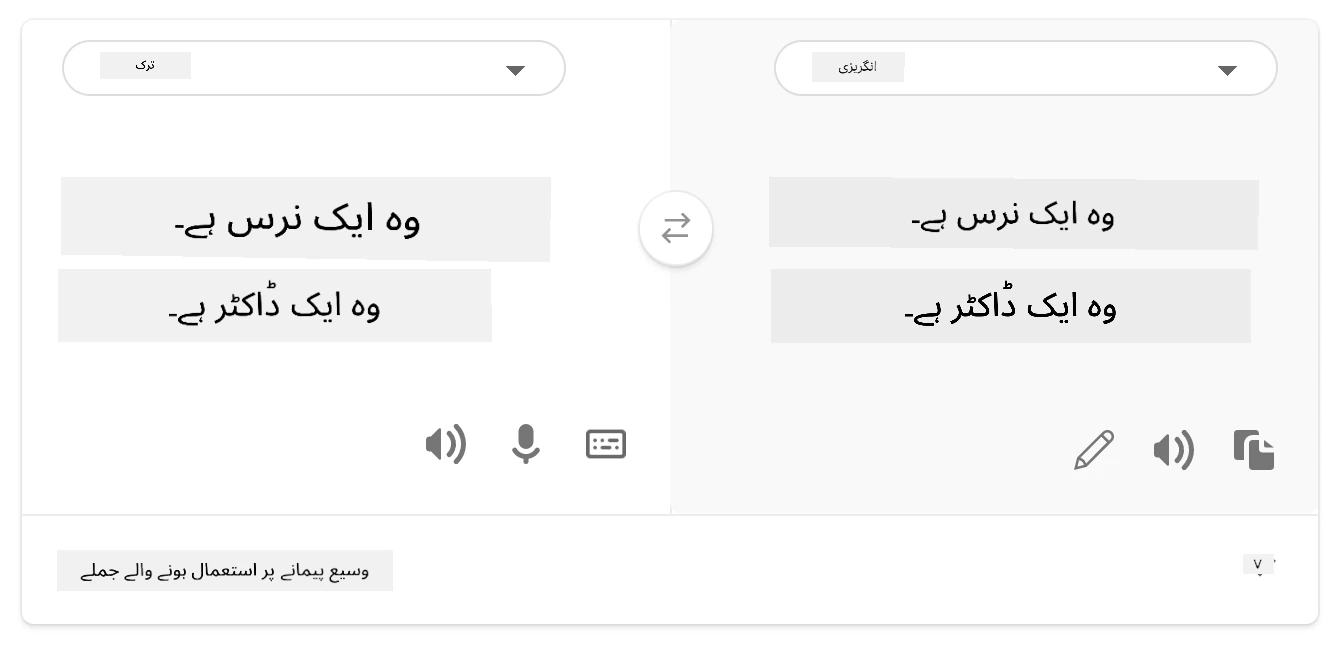
انگریزی میں دوبارہ ترجمہ
AI نظام ڈیزائن اور جانچتے وقت، ہمیں یہ یقینی بنانا چاہیے کہ AI منصفانہ ہو اور تعصبی یا امتیازی فیصلے کرنے کے لیے پروگرام نہ کیا گیا ہو، جو انسان بھی کرنے سے منع ہیں۔ AI اور مشین لرننگ میں عدل کی ضمانت دینا ایک پیچیدہ سماجی فنی چیلنج ہے۔
اعتماد اور حفاظت
اعتماد قائم کرنے کے لیے، AI نظاموں کو عام اور غیر متوقع حالات میں قابل اعتماد، محفوظ، اور مستقل ہونا چاہیے۔ یہ جاننا اہم ہے کہ AI نظام مختلف صورتوں میں کیسے برتاؤ کریں گے، خاص طور پر جب وہ آؤٹ لائرز ہوں۔ AI حل تیار کرتے وقت، اس بات پر کافی توجہ دینی چاہیے کہ AI حل کو کن مختلف صورتحال سے گزرنا پڑے گا۔ مثال کے طور پر، خود ڈرائیونگ کار کو لوگوں کی حفاظت سب سے اہم رکھنی ہوگی۔ نتیجتاً، کار کو چلانے والا AI تمام ممکنہ حالات کو مدنظر رکھے گا جیسے رات، آندھی، برفباری، بچے سڑک پار کر رہے ہوں، پالتو جانور، سڑک کی مرمت وغیرہ۔ ایک AI نظام کی اچھی کارکردگی اور حفاظت ان حالات کی متوقع تعداد کو ظاہر کرتی ہے جس پر ڈیٹا سائنسدان یا AI ڈویلپر نے ڈیزائن یا جانچ کے دوران غور کیا ہو۔
🎥 AI میں اعتماد اور حفاظت کے بارے میں ویڈیو کے لیے یہاں کلک کریں
شمولیت
AI نظام ایسے ڈیزائن کیے جانے چاہئیں کہ وہ سب کو شامل کریں اور بااختیار بنائیں۔ جب AI نظام ڈیزائن اور نافذ کیے جاتے ہیں، تو ڈیٹا سائنسدان اور AI ڈویلپر ان رکاوٹوں کی نشاندہی کرتے اور دور کرتے ہیں جو غیر ارادی طور پر لوگوں کو خارج کر سکتی ہیں۔ مثال کے طور پر، دنیا بھر میں 1 ارب معذور افراد ہیں۔ AI کی ترقی کے ساتھ، وہ اپنی روزمرہ زندگی میں آسانی سے معلومات اور مواقع تک رسائی حاصل کر سکتے ہیں۔ رکاوٹیں دور کر کے، یہ مواقع پیدا ہوتے ہیں کہ AI مصنوعات کو بہتر تجربات کے ساتھ ترقی دی جائے جو سب کے فائدے میں ہوں۔
سیکیورٹی اور پرائیویسی
AI نظام محفوظ ہونے چاہئیں اور لوگوں کی پرائیویسی کا احترام کریں۔ انہی نظاموں پر لوگوں کا کم اعتماد ہوتا ہے جو ان کی پرائیویسی، معلومات، یا زندگی کو خطرے میں ڈالیں۔ مشین لرننگ ماڈلز کی تربیت کے دوران، ہم بہترین نتائج حاصل کرنے کے لیے ڈیٹا پر اعتماد کرتے ہیں۔ ایسا کرتے ہوئے، ڈیٹا کی اصل اور سالمیت کو مدنظر رکھنا چاہیے۔ مثال کے طور پر، کیا ڈیٹا صارف نے فراہم کیا تھا یا عوامی طور پر دستیاب تھا؟ پھر، ڈیٹا کے ساتھ کام کرتے ہوئے، AI نظام تیار کرنا ضروری ہے جو خفیہ معلومات کی حفاظت کریں اور حملوں کی مزاحمت کریں۔ جیسے جیسے AI زیادہ عام ہو رہا ہے، پرائیویسی کی حفاظت اور اہم ذاتی و کاروباری معلومات کی سیکیورٹی زیادہ اہم اور پیچیدہ ہوتی جا رہی ہے۔ پرائیویسی اور ڈیٹا سیکیورٹی کے مسائل AI کے لیے خاص توجہ کے طلبگار ہیں کیونکہ ڈیٹا تک رسائی AI نظاموں کے لیے رہنما اور صحیح پیش گوئیاں اور فیصلے کرنے کے لیے لازمی ہے۔
- ایک صنعت کے طور پر، ہم نے پرائیویسی اور سیکیورٹی میں نمایاں پیشرفت کی ہے، جس کی بنیادی وجہ قوانین جیسے GDPR (جنرل ڈیٹا پروٹیکشن ریگولیشن) ہے۔
- لیکن AI نظاموں کے ساتھ ہمیں اس تنازع کو تسلیم کرنا ہوگا کہ زیادہ ذاتی ڈیٹا کی ضرورت ہوتی ہے تاکہ نظام ذاتی اور مؤثر بن سکیں، اور پرائیویسی کے درمیان توازن برقرار رکھا جائے۔
- بالکل ویسے ہی جیسے انٹرنیٹ کے ساتھ کمپیوٹرز کے جنم پر، ہم AI سے متعلق سیکیورٹی مسائل میں بھی بڑی تیزی دیکھ رہے ہیں۔
- اسی دوران، ہم نے دیکھا ہے کہ AI سیکیورٹی کو بہتر بنانے کے لیے بھی استعمال ہو رہا ہے۔ مثال کے طور پر، آج کے بیشتر جدید اینٹی وائرس اسکینرز AI ہیوراسٹکس پر مبنی ہیں۔
- ہمیں یہ یقینی بنانا چاہیے کہ ہمارے ڈیٹا سائنس کے عمل جدید پرائیویسی اور سیکیورٹی کی عادات کے ساتھ مطابقت رکھتے ہوں۔
شفافیت
AI نظام قابل فہم ہونے چاہئیں۔ شفافیت کا ایک اہم حصہ AI نظاموں اور ان کے اجزاء کے رویے کی وضاحت ہے۔ AI نظاموں کی بہتر سمجھ کے لیے فریقین کو یہ جاننا ضروری ہے کہ وہ کیسے اور کیوں کام کرتے ہیں تاکہ ممکنہ کارکردگی کے مسائل، حفاظت اور پرائیویسی کے خدشات، تعصبات، خانہ جنگی کے طریقہ کار، یا ناخواہ نتائج کی نشاندہی کر سکیں۔ ہم یہ بھی ایمان رکھتے ہیں کہ جو لوگ AI نظام استعمال کرتے ہیں انہیں دیانتدار اور کھلے دل سے بتانا چاہیے کہ وہ کب، کیوں، اور کیسے ان کا استعمال کرتے ہیں، اور نظام کی حدود کیا ہیں۔ مثال کے طور پر، اگر کوئی بینک اپنے صارفین کے قرض کے فیصلوں کی حمایت کے لیے AI نظام استعمال کرتا ہے، تو نتائج کا جائزہ لینا اور سمجھنا ضروری ہے کہ کون سا ڈیٹا نظام کی سفارشات کو متاثر کرتا ہے۔ حکومتیں صنعتوں میں AI کی نگرانی شروع کر رہی ہیں، اس لیے ڈیٹا سائنسدانوں اور تنظیموں کو وضاحت کرنی ہوگی کہ آیا AI نظام ریگولیٹری تقاضوں پر پورا اترتا ہے، خاص طور پر جب کوئی ناپسندیدہ نتیجہ سامنے آئے۔
- چونکہ AI نظام بہت پیچیدہ ہیں، انہیں سمجھنا اور نتائج کی تشریح کرنا مشکل ہے۔
- اس عدم سمجھ بوجھ کا اثر اس طریقے پر پڑتا ہے جس سے ان نظاموں کو مینیج، آپریٹ، اور دستاویزی شکل دی جاتی ہے۔
- اہم بات یہ ہے کہ اس عدم تفہیم کا اثر ان فیصلوں پر بھی پڑتا ہے جو ان نظاموں کے نتائج کی بنیاد پر کیے جاتے ہیں۔
جوابدہی
AI نظام بنانے اور نافذ کرنے والے افراد کو اس بات کا ذمہ دار ہونا چاہیے کہ ان کے نظام کیسے کام کرتے ہیں۔ جوابدہی کی ضرورت خاص طور پر حساس ٹیکنالوجیز جیسے چہروں کی شناخت میں زیادہ اہم ہے۔ حال ہی میں، چہروں کی شناخت ٹیکنالوجی کی مانگ میں اضافہ ہوا ہے، خاص طور پر قانون نافذ کرنے والے اداروں کا جو اس کے فائدمند استعمال، جیسے لاپتہ بچوں کی تلاش، دیکھتے ہیں۔ تاہم، یہ ٹیکنالوجی حکومت کی طرف سے اپنے شہریوں کی بنیادی آزادیوں کو خطرے میں ڈالنے کے لیے استعمال کی جا سکتی ہے، مثلاً مخصوص افراد کی مسلسل نگرانی کے ذریعے۔ اس لیے، ڈیٹا سائنسدانوں اور تنظیموں کو یہ ذمہ داری لینی ہوگی کہ ان کے AI نظام کا افراد یا معاشرے پر کیا اثر ہوتا ہے۔
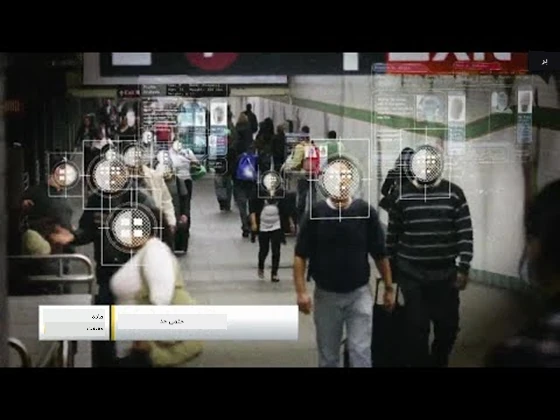
🎥 ویڈیو کے لیے اوپر تصویر پر کلک کریں: چہرے کی شناخت کے ذریعے بڑے پیمانے پر نگرانی کی وارننگز
آخر کار، ہماری نسل کے لیے سب سے بڑے سوالات میں سے ایک، جو AI کو معاشرے میں لا رہی ہے، یہ ہے کہ کمپیوٹرز کو لوگوں کے سامنے جوابدہ کیسے رکھا جائے اور جنہوں نے کمپیوٹرز بنائے ہیں وہ سب کے سامنے کیسے جوابدہ رہیں۔
اثر کا جائزہ
مشین لرننگ ماڈل کی تربیت سے پہلے، یہ ضروری ہے کہ AI نظام کے مقصد کو سمجھنے کے لیے اثر کا جائزہ لیا جائے؛ اس کا ارادہ شدہ استعمال کیا ہے؛ کہاں تعینات کیا جائے گا؛ اور کون نظام کے ساتھ تعامل کرے گا۔ یہ جائزہ لینے والے یا جانچ کرنے والوں کے لیے مددگار ہوتا ہے تاکہ وہ ممکنہ خطرات اور متوقع نتائج کی شناخت کرتے وقت کون سے عوامل کو مدنظر رکھیں۔
اثر کے جائزہ کے دوران توجہ کے درج ذیل علاقے ہوتے ہیں:
- افراد پر منفی اثرات۔ کسی بھی پابندی یا ضروریات، غیر معاون استعمال یا نظام کی کارکردگی پر اثر انداز ہونے والی معلوم حدود سے آگاہ ہونا ضروری ہے تاکہ نظام ایسے طریقے سے استعمال نہ ہو جو افراد کو نقصان پہنچائے۔
- ڈیٹا کی ضروریات۔ یہ سمجھنا کہ نظام کہاں اور کیسے ڈیٹا استعمال کرے گا، جائزہ لینے والوں کو کسی بھی ڈیٹا کی ضرورت کی جانچ پڑتال میں مدد دیتا ہے (مثلاً GDPR یا HIPAA کے قوانین)۔ اس کے علاوہ، یہ دیکھنا کہ ڈیٹا کا ماخذ یا مقدار تربیت کے لیے کافی ہے یا نہیں۔
- اثر کا خلاصہ۔ نظام کے استعمال سے ممکنہ نقصان کی فہرست تیار کریں۔ مشین لرننگ کے پوری زندگی کے دوران جائزہ لیں کہ شناخت شدہ مسائل کو کم یا حل کیا گیا ہے یا نہیں۔
- ہر بنیادی اصول کے لیے قابل اطلاق اہداف۔ یہ جانچیں کہ اصولوں کے اہداف پورے ہوئے ہیں یا ان میں کوئی کمی ہے۔
ذمہ دار AI کے ساتھ ڈی بگنگ
کسی سافٹ ویئر ایپلیکیشن کی طرح AI نظام کی ڈی بگنگ بھی مسئلوں کی شناخت اور حل کرنے کا ضروری عمل ہے۔ متعدد عوامل ایسے ہوتے ہیں جو ماڈل کی متوقع یا ذمہ دارانہ کارکردگی کو متاثر کر سکتے ہیں۔ زیادہ تر روایتی ماڈل کارکردگی کے میٹرکس ماڈل کی کارکردگی کا مقداری مجموعہ ہوتے ہیں، جو ذمہ دار AI اصولوں کی خلاف ورزی کو تجزیہ کرنے کے لیے کافی نہیں ہوتے۔ علاوہ ازیں، مشین لرننگ ماڈل ایک بلیک باکس ہوتا ہے جس کی وجہ سے یہ سمجھنا مشکل ہوتا ہے کہ اس کا نتیجہ کیا محرک ہے یا جب وہ غلطی کرتا ہے تو وضاحت پیش کرنا آسان نہیں ہوتا۔ اس کورس میں ہم بعد میں ذمہ دار AI ڈیش بورڈ کے استعمال سے AI نظام کی ڈی بگنگ سیکھیں گے۔ یہ ڈیش بورڈ ڈیٹا سائنسدانوں اور AI ڈویلپرز کو ایک جامع آلہ فراہم کرتا ہے تاکہ وہ مندرجہ ذیل کام انجام دے سکیں:
- غلطی تجزیہ۔ ماڈل کی غلطی کی تقسیم کی شناخت کے لیے جو نظام کی عدل یا اعتماد کو متاثر کر سکتی ہے۔
- ماڈل کا جائزہ۔ یہ جاننے کے لیے کہ ماڈل کی کارکردگی مختلف ڈیٹا گروپوں میں کہاں فرق کر رہی ہے۔
- ڈیٹا تجزیہ۔ ڈیٹا کی تقسیم کو سمجھنے اور ان تعصبات کی شناخت کے لیے جو عدل، شمولیت، اور اعتماد کے مسائل پیدا کر سکتے ہیں۔
- ماڈل کی وضاحت پذیری۔ یہ سمجھنے کے لیے کہ ماڈل کی پیشن گوئیوں کو کیا اثر یا اثر انداز کرتا ہے۔ یہ ماڈل کے رویے کی وضاحت میں مدد دیتا ہے، جو شفافیت اور جوابدہی کے لیے ضروری ہے۔
🚀 چیلنج
نقصانات کو ابتدا میں داخل ہونے سے روکنے کے لیے، ہمیں چاہیے کہ:
- نظام پر کام کرنے والے افراد کے درمیان پس منظر اور نظریات کی تنوع کو یقینی بنائیں۔
- ایسے ڈیٹا سیٹس میں سرمایہ کاری کریں جو ہماری معاشرت کی تنوع کی عکاسی کرتے ہوں۔
- مشین لرننگ کے مکمل مرحلے میں بہتر طریقے وضع کریں تاکہ نا ذمہ دار AI کو وقتی شناخت اور اصلاح کی جا سکے جب وہ واقع ہو۔
حقیقی زندگی کے ایسے منظرنامے سوچیں جہاں ماڈل کی غیر قابل اعتمادیت ماڈل بنانے اور استعمال میں واضح ہو۔ ہمیں اور کیا چیزیں مدنظر رکھنی چاہئیں؟
پوسٹ لیکچر کوئز
جائزہ اور خود مطالعہ
اس سبق میں آپ نے مشین لرننگ میں عدل اور ناانصافی کے بنیادی تصورات سیکھے ہیں۔
اس ورکشاپ کو دیکھیں تاکہ موضوعات میں مزید گہرائی حاصل ہو:
- ذمہ دار AI کے حصول کی کوشش: اصولوں کو عملی جامہ پہنانا از Besmira Nushi، Mehrnoosh Sameki اور Amit Sharma

🎥 ویڈیو کے لیے اوپر دی گئی تصویر پر کلک کریں: RAI ٹول باکس: ذمہ دار AI بنانے کے لیے ایک اوپن سورس فریم ورک، از بسمیرا نوشی، مہرنوش سامیکی، اور امت شرما
مزید پڑھیں:
-
مائیکروسافٹ کا RAI ریسورس سینٹر: ذمہ دار AI کے وسائل – Microsoft AI
-
مائیکروسافٹ کا FATE ریسرچ گروپ: FATE: AI میں انصاف، جوابدہی، شفافیت، اور اخلاقیات - Microsoft Research
RAI ٹول باکس:
Azure Machine Learning کے اوزار جس سے انصاف کو یقینی بنایا جاتا ہے، کے بارے میں پڑھیں:
اسائنمنٹ
ڈس کلیمر: یہ دستاویز AI ترجمہ سروس Co-op Translator کے ذریعے ترجمہ کی گئی ہے۔ جبکہ ہم درستگی کے لیے کوشاں ہیں، براہ کرم اس بات سے آگاہ رہیں کہ خودکار ترجمے میں غلطیاں یا عدم درستیاں ہو سکتی ہیں۔ اصل دستاویز اپنے مادری زبان میں مستند ماخذ سمجھی جائے گی۔ حساس معلومات کے لیے پیشہ ور انسانی ترجمہ کی سفارش کی جاتی ہے۔ اس ترجمے کے استعمال سے پیدا ہونے والی کسی بھی غلط فہمی یا غلط تشریح کی ذمہ داری ہم قبول نہیں کرتے۔