
16 KiB
Python ve Scikit-learn ile regresyon modellerine başlama
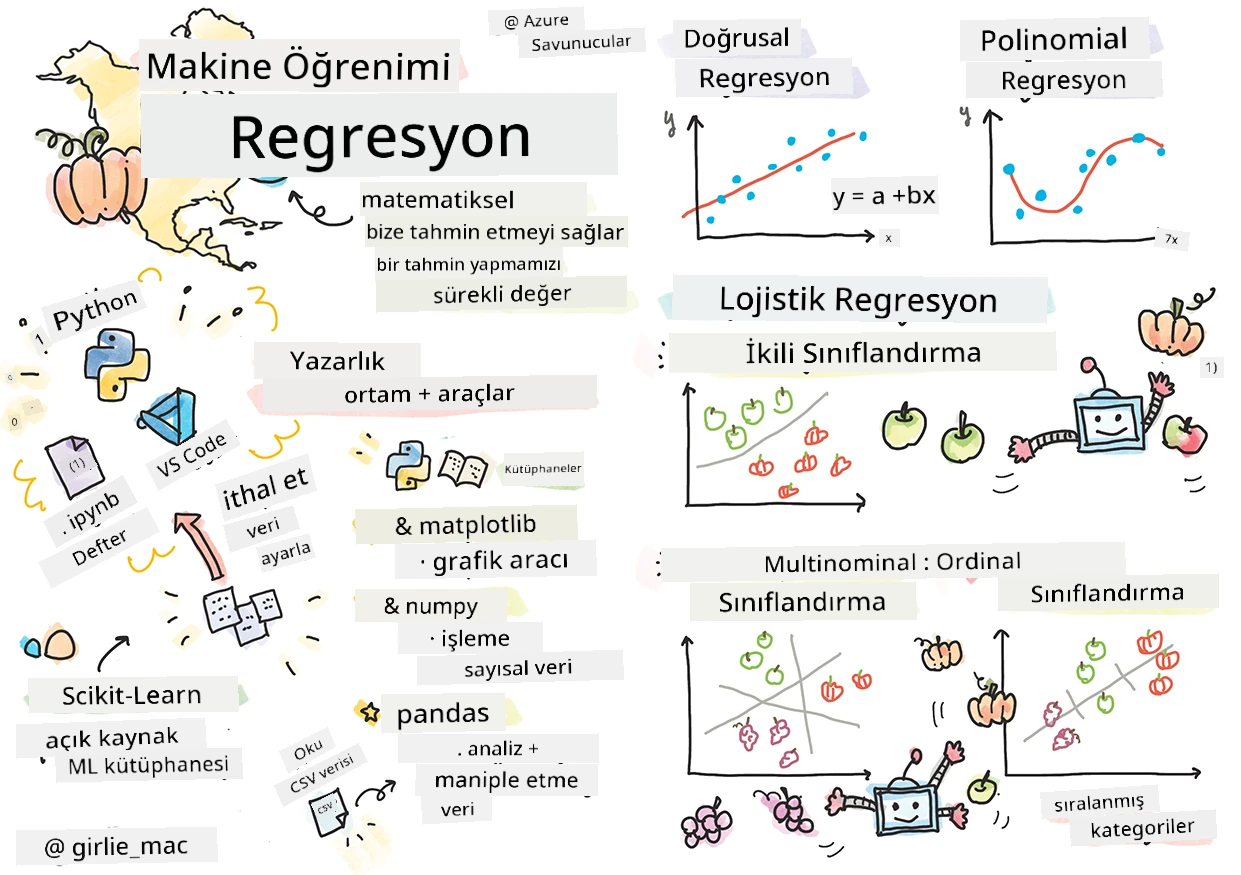
Sketchnote: Tomomi Imura
Ders öncesi sınav
Bu ders R dilinde de mevcuttur!
Giriş
Bu dört derste regresyon modellerini nasıl oluşturacağınızı keşfedeceksiniz. Bunların ne için olduğunu birazdan tartışacağız. Ama herhangi bir şey yapmadan önce, süreci başlatmak için doğru araçlara sahip olduğunuzdan emin olun!
Bu derste şunları öğreneceksiniz:
- Bilgisayarınızı yerel makine öğrenimi görevleri için yapılandırmak.
- Jupyter Notebooks ile çalışmak.
- Scikit-learn'i kullanmak, kurulumu dahil.
- Temel bir uygulama ile lineer regresyonu keşfetmek.
Kurulumlar ve yapılandırmalar

🎥 Bilgisayarınızı ML için yapılandırma adımlarını gösteren kısa video için yukarıdaki görsele tıklayın.
-
Python’u yükleyin. Bilgisayarınızda Python yüklü olduğundan emin olun. Python’u birçok veri bilimi ve makine öğrenmesi görevinde kullanacaksınız. Çoğu bilgisayar sisteminde zaten Python kuruludur. Bazı kullanıcıların kurulumu kolaylaştırması için yararlı Python Kodlama Paketleri de mevcuttur.
Ancak, Python’un bazı kullanımları bir yazılım sürümünü gerektirirken, diğerleri farklı bir sürüm ister. Bu nedenle, bir sanallaştırılmış ortam içinde çalışmak faydalıdır.
-
Visual Studio Code’u yükleyin. Bilgisayarınızda Visual Studio Code’un kurulu olduğundan emin olun. Temel kurulum için Visual Studio Code kurulum talimatlarını izleyin. Bu kursta Python’u Visual Studio Code’da kullanacağınız için, Python geliştirme için Visual Studio Code nasıl yapılandırılır öğrenmek isteyebilirsiniz.
Python ile rahat etmek için bu Öğren modülleri koleksiyonunu inceleyin

🎥 Python’u VS Code içinde kullanmayı gösteren videoya yukarıdaki resme tıklayarak ulaşabilirsiniz.
-
Scikit-learn’i yükleyin, bu talimatları izleyerek. Python 3 kullandığınızdan emin olmalısınız; sanal ortam kullanmanız önerilir. M1 Mac için bu kütüphaneyi kurarken özel talimatlar sayfada bulunuyor.
-
Jupyter Notebook’u yükleyin. Jupyter paketini kurmanız gerekecek.
Makine Öğrenimi geliştirme ortamınız
Python kodunuzu geliştirmek ve makine öğrenimi modelleri oluşturmak için notebook'lar kullanacaksınız. Bu tür dosyalar veri bilimciler arasında yaygın bir araçtır ve .ipynb uzantısıyla tanımlanır.
Notebook'lar, kod yazmanın yanı sıra notlar ekleyip kod çevresine dokümantasyon yazmaya imkan tanıyan etkileşimli bir ortamdır; bu da deneysel veya araştırma odaklı projeler için oldukça faydalıdır.

🎥 Bu egzersizi çalıştıran kısa videoya yukarıdaki görsele tıklayarak ulaşabilirsiniz.
Alıştırma - bir notebook ile çalışma
Bu klasörde notebook.ipynb dosyasını bulacaksınız.
-
Visual Studio Code’da notebook.ipynb dosyasını açın.
Python 3+ çalışan bir Jupyter sunucusu başlayacak. Notebook bölümlerinde
run(çalıştırılabilir) kod parçaları vardır. Bir kod bloğunu çalıştırmak için oynat düğmesine benzeyen ikon seçilir. -
mdikonunu seçin ve biraz markdown ekleyin, ardından şu metni yazın: # Notebook'unuza hoş geldiniz.Ardından biraz Python kodu ekleyin.
-
Kod bloğuna print('hello notebook') yazın.
-
Kodu çalıştırmak için ok işaretini seçin.
Yazdırılan ifadeyi görmelisiniz:
hello notebook
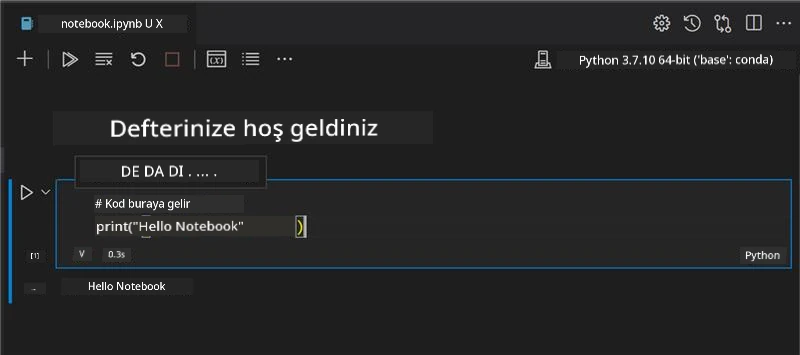
Kodlarınızı açıklamalarla destekleyerek notebook'u kendi kendinize belgeleyebilirsiniz.
✅ Bir web geliştiricisinin çalışma ortamının bir veri bilimcisinden ne kadar farklı olabileceğini bir dakika düşünün.
Scikit-learn ile çalışmaya başlamak
Python artık yerel ortamınızda kurulu ve Jupyter Notebooks ile rahat olduğunuz için, Scikit-learn ile de aynı rahatlığı kazanma zamanı. Scikit-learn, ML görevlerini gerçekleştirmekte size yardımcı olacak kapsamlı bir API sağlar.
Kendi web sitesine göre, "Scikit-learn, denetimli ve denetimsiz öğrenmeyi destekleyen açık kaynak makine öğrenimi kütüphanesidir. Ayrıca model uyumu, veri ön işleme, model seçimi ve değerlendirilmesi için çeşitli araçlar ve birçok diğer yardımcı araç sağlar."
Bu kursta Scikit-learn ve diğer araçları kullanarak, 'geleneksel makine öğrenimi' görevlerini gerçekleştirecek modeller inşa edeceksiniz. Sinir ağları ve derin öğrenmeden kasıtlı olarak kaçındık; çünkü bunlar yakında yayınlanacak 'Yapay Zeka Yeni Başlayanlar İçin' müfredatında daha iyi ele alınacak.
Scikit-learn, modeller oluşturmayı ve kullanım için değerlendirmeyi kolaylaştırır. Öncelikle sayısal verilerle çalışmak için tasarlanmıştır ve öğrenme araçları olarak kullanılabilecek birkaç hazır veri seti içerir. Ayrıca öğrencilerin denemesi için önceden oluşturulmuş modeller içerir. Hazır paketlenmiş veriyi yükleme ve dahili bir tahminleyici kullanarak temel verilerle ilk ML modelinizi oluşturma sürecini keşfedelim.
Alıştırma - ilk Scikit-learn notebook’unuz
Bu eğitim, Scikit-learn web sitesindeki lineer regresyon örneği ilham alınarak hazırlanmıştır.

🎥 Bu alıştırmayı gösteren kısa videoya yukarıdaki görsele tıklayarak ulaşabilirsiniz.
Bu derse ilişkin notebook.ipynb dosyasında, tüm hücreleri 'çöp kutusu' ikonuna basarak temizleyin.
Bu bölümde, eğitim amaçlı Scikit-learn içine gömülü küçük bir diyabet veri seti ile çalışacaksınız. Diyabetli hastalara bir tedavi test etmek istediğinizi hayal edin. Makine öğrenimi modelleri, değişken kombinasyonlarına göre hangi hastaların tedaviye daha iyi yanıt vereceğini belirlemede yardımcı olabilir. Basit bir regresyon modeli bile görselleştirildiğinde, teorik klinik deneylerinizi organize etmenize yardımcı olacak değişkenler hakkında bilgi gösterebilir.
✅ Regresyon yöntemlerinin birçok türü vardır ve hangisini seçtiğiniz aradığınız cevaba göre değişir. Belirli bir yaş için bir kişinin olası boyunu tahmin etmek istiyorsanız, bir sayısal değer aradığınız için lineer regresyon kullanırsınız. Bir mutfak türünün vegan olup olmadığını öğrenmek istiyorsanız, kategori ataması yapmak istiyorsunuz demektir; bu durumda lojistik regresyon kullanırsınız. Daha sonra lojistik regresyon hakkında daha fazla bilgi edineceksiniz. Veriye sorabileceğiniz bazı soruları ve hangi yöntemlerin daha uygun olacağını düşünün.
Hadi bu göreve başlayalım.
Kütüphaneleri içe aktarın
Bu görev için bazı kütüphaneleri içe aktaracağız:
- matplotlib. Kullanışlı bir grafik aracıdır ve bir çizgi grafiği oluşturmak için kullanacağız.
- numpy. numpy, Python’da sayısal verilerle çalışmak için yararlı bir kütüphanedir.
- sklearn. Bu, Scikit-learn kütüphanesidir.
Görevlerinize yardımcı olması için bazı kütüphaneleri içe aktarın.
-
Aşağıdaki kodu yazarak içe aktarımları ekleyin:
import matplotlib.pyplot as plt import numpy as np from sklearn import datasets, linear_model, model_selectionYukarıda
matplotlib,numpyiçe aktarılıyor vesklearndendatasets,linear_modelvemodel_selectionde dahil ediliyor.model_selection, veriyi eğitim ve test setlerine bölmek için kullanılır.
Diyabet veri seti
Dahili diyabet veri seti, diyabet hakkında 10 özellik değişkeni içeren 442 örnek veri sunar. Bazı özellikler şunlardır:
- yaş: yaş (yıl olarak)
- vki: vücut kitle indeksi
- kb: ortalama kan basıncı
- s1 tc: T Hücreleri (bir tür beyaz kan hücresi)
✅ Bu veri seti, diyabet araştırmaları açısından önemli bir özellik olan 'cinsiyet' kavramını içerir. Pek çok tıbbi veri seti bu tür ikili sınıflandırmalar içerir. Bu tür sınıflandırmaların nüfusun bazı kesimlerini tedavilerden dışlayabileceğini bir düşünün.
Şimdi, X ve y verilerini yükleyin.
🎓 Unutmayın, bu denetimli öğrenmedir ve adlandırılmış bir ‘y’ hedefi gereklidir.
Yeni bir kod hücresinde load_diabetes() fonksiyonunu çağırarak diyabet veri setini yükleyin. return_X_y=True girişi, X'in bir veri matrisi, y'nin ise regresyon hedefi olduğunu belirtir.
-
Veri matrisinin şekli ve ilk elemanını göstermek için bazı print komutları ekleyin:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Geri dönen yanıt bir tuple’dır. İlk iki değeri sırasıyla
Xveydeğişkenlerine atıyorsunuz. Daha fazla bilgi için tuple’lar hakkında okuyabilirsiniz.Bu verinin 442 öğeden oluştuğunu ve her öğenin 10 elemanlı dizi şeklinde olduğunu görebilirsiniz:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Veri ve regresyon hedefinin ilişkisini biraz düşünün. Lineer regresyon, özellik X ile hedef değişken y arasındaki ilişkileri tahmin eder. Diyabet veri seti için hedef ne olabilir? Bu veri seti, verilen hedefle neyi gösteriyor?
-
Ardından, 3. sütunu seçerek bu veri setinden bir kısmını çizim için seçin. Bunu tüm satırları seçmek için
:operatörü ve sonra 3. sütunu seçmek için indeks (2) kullanarak yapabilirsiniz. Ayrıca veriyi çizim için gereken 2 boyutlu dizi haline getirmek içinreshape(n_rows, n_columns)kullanabilirsiniz. Parametrelerden biri -1 ise, karşılık gelen boyut otomatik olarak hesaplanır.X = X[:, 2] X = X.reshape((-1,1))✅ Her zaman veriyi yazdırarak şekline bakabilirsiniz.
-
Artık verileriniz çizime hazır, makinenizin bu veri kümesindeki sayılar arasında mantıklı bir ayrım yapıp yapamayacağını görebilirsiniz. Bunu yapmak için, hem verileri (X) hem de hedefi (y) test ve eğitim setlerine bölmeniz gerekir. Scikit-learn bunu yapmak için kolay bir yol sağlar; test verilerini belirttiğiniz bir noktada bölebilirsiniz.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Şimdi modelinizi eğitmeye hazırsınız! Lineer regresyon modelini yükleyin ve
model.fit()ile X ve y eğitim setlerinizle eğitin:model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()birçok ML kütüphanesinde göreceğiniz bir fonksiyondur, örneğin TensorFlow'da da vardır. -
Sonra, test verisi kullanarak
predict()fonksiyonu ile tahmin oluşturun. Bu, veri gruplarının arasına çizgi çizmek için kullanılacak.y_pred = model.predict(X_test) -
Şimdi veriyi grafikte gösterme zamanı. Matplotlib bu iş için çok faydalı bir araçtır. Tüm X ve y test verisinin bir dağılım grafiğini oluşturun ve tahmin çizgisini modelin veri gruplarının en uygun yerine çizin.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()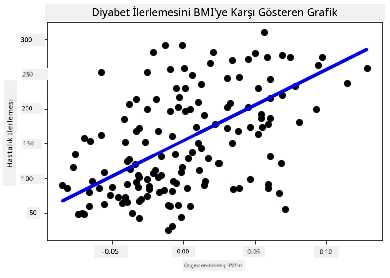
✅ Burada ne olduğunu biraz düşünün. Bir düz çizgi birçok küçük veri noktasının içinden geçiyor, peki tam olarak ne yapıyor? Bu çizgiyi kullanarak yeni, görülmemiş bir veri noktasının grafiğin y ekseniyle ilişkisi içinde nerede olması gerektiğini tahmin etmeniz gerektiğini görebiliyor musunuz? Bu modelin pratik kullanımı için kelimelere dökmeye çalışın.
Tebrikler, ilk lineer regresyon modelinizi oluşturdunuz, onunla tahmin yaptınız ve grafikte gösterdiniz!
🚀Meydan Okuma
Bu veri setinden farklı bir değişkeni çizin. İpucu: bu satırı düzenleyin: X = X[:,2]. Bu veri setinin hedefi göz önüne alındığında, diyabetin bir hastalık olarak ilerleyişi hakkında ne keşfedebilirsiniz?
Ders sonrası sınav
Tekrar ve Kendi Kendine Çalışma
Bu eğitimde, basit lineer regresyon ile çalıştınız, tek değişkenli veya çoklu lineer regresyondan ziyade. Bu yöntemler arasındaki farkları biraz okuyun veya bu videoya göz atın.
Regresyon kavramı hakkında daha fazla bilgi edinin ve bu teknikle hangi tür soruların cevaplanabileceğini düşünün. Anlayışınızı derinleştirmek için bu öğreticiyi alın.
Ödev
Feragatname: Bu belge, AI çeviri hizmeti Co-op Translator kullanılarak çevrilmiştir. Doğruluk için çaba sarf etsek de, otomatik çevirilerin hata veya yanlışlık içerebileceğini lütfen unutmayınız. Orijinal belge, kendi dilinde yetkili kaynak olarak kabul edilmelidir. Kritik bilgiler için profesyonel insan çevirisi önerilir. Bu çevirinin kullanımı sonucu ortaya çıkabilecek yanlış anlamalardan veya yanlış yorumlamalardan sorumlu değiliz.