
30 KiB
రిగ్రెషన్ మోడల్స్ కోసం పైథాన్ మరియు స్కైకిట్-లెర్న్తో ప్రారంభించండి
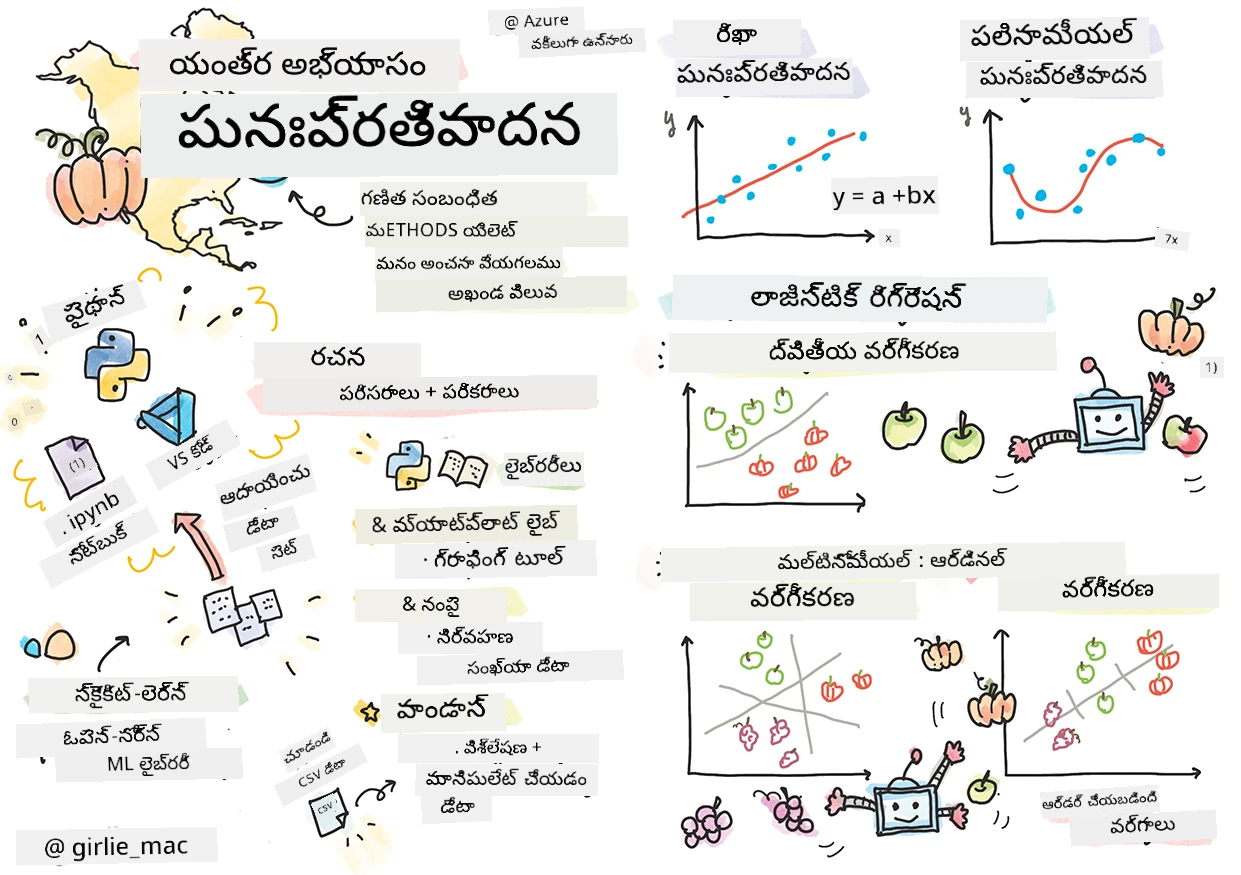
స్కెచ్ నోట్ రచయిత టోమోమీ ఇమురా
పూర్వ-ఉపన్యాస క్విజ్
ఈ పాఠం R లో అందుబాటులో ఉంది!
పరిచయం
ఈ నాలుగు పాఠాలలో, మీరు రిగ్రెషన్ మోడల్స్ను ఎలా తయారు చేసుకోవచ్చో తెలుసుకుంటారు. వీటి ఉపయోగం త్వరలో చర్చించబడుతుంది. కానీ ఏదైనా చేయక ముందే, మీరు సరైన టూల్స్ను సిద్ధం చేసుకున్నారని నిర్ధారించుకోండి!
ఈ పాఠంలో మీరు నేర్చుకుంటారు:
- స్థానిక మెషిన్ లెర్నింగ్ పనుల కోసం మీ కంప్యూటర్ని సెట్ చేయటం.
- జూపైటర్ నోట్లతో పనిచేయటం.
- స్కైకిట్-లెర్న్ను ఉపయోగించటం, ఇన్స్టాల్ సహా.
- హ్యాండ్స్-ఆన్ వ్యాయామంతో లీనియర్ రిగ్రెషన్ను అన్వేషించటం.
ఇన్స్టలేషన్లు మరియు కాన్ఫిగరేషన్లు

🎥 మీ కంప్యూటర్ను మెషిన్ లెర్నింగ్ కోసం సెటప్ చేయాలెం ఇచ్చిన ఈ చిన్న వీడియో కోసం పై చిత్రాన్ని క్లిక్ చేయండి.
-
పైథాన్ ఇన్స్టాల్ చేయండి. పైథాన్ మీ కంప్యూటర్లో ఇన్స్టాల్ ఉందని నిర్ధారించుకోండి. మీరు డేటా సైన్స్ మరియు మెషిన్ లెర్నింగ్ పనుల కోసం పైథాన్ను ఉపయోగిస్తారు. చాలా కంప్యూటర్ వ్యవస్థల్లోనే పైథాన్ ఇన్స్టాలేషన్ ఉంటుంది. కొన్ని వినియోగదారులకు సులభతరం చేయడానికి ఉపయోగకరమైన పైథాన్ కోడింగ్ ప్యాక్స్ కూడా అందుబాటులో ఉన్నాయి.
కానీ కొన్ని ఉపయోగాలు ఒక వెర్షన్ ది వైయేర్ చేస్తాయి, మరి కొన్ని వేరొక వెర్షన్ అవసరం. అందుకే వర్చువల్ ఎన్విరాన్మెంట్లో పనిచేయడం బెటర్.
-
విజువల్ స్టూడియో కోడ్ ఇన్స్టాల్ చేయండి. మీ కంప్యూటర్ మీద Visual Studio Code ఉండటం చాందనం. ఈ సూచనలు పాటించి Visual Studio Code ఇన్స్టాల్ చేయండి. ఈ కోర్సు కోసం మీరు Visual Studio Codeలో Python ఉపయోగించనున్నందున, Python డెవలప్మెంట్ కోసం Visual Studio Code ఎలా కాంపిగర్ చేయాలి తెలుసుకోవచ్చు.
ఈ Learn మాడ్యూల్స్ ఉపయోగించి పైథాన్తో సౌకర్యంగా ఉన్న బ్రష్ అయిపోండి

🎥 పై చిత్రం క్లిక్ చేసి వీడియో చూడండి: VS కోడ్ లో Python ఉపయోగించడం.
-
స్కైకిట్-లెర్న్ ఇన్స్టాల్ చేయండి, ఈ సూచనలు అనుసరించి. Python 3 ఉపయోగించటం తప్పనిసరి కావడంతో, వర్చువల్ ఎన్విరాన్మెంట్ వాడటం మంచిది. M1 మాక్ మీద ఇన్స్టాల్ చేస్తే ప్రత్యేక సూచనలు లింక్ పేజీలో ఉన్నాయి.
-
జూపైటర్ నోట్బుక్ ఇన్స్టాల్ చేయండి. జూపైటర్ ప్యాకేజీ ఇన్స్టాల్ చేయాలి.
మీ ML రచనా వాతావరణం
మీరు మీ Python కోడ్ అభివృద్ధి చేసేందుకు మరియు మెషిన్ లెర్నింగ్ మోడల్స్ తయారుచేయడానికి నోట్లబుక్స్ను ఉపయోగిస్తారు. ఈ ఫైల్ రకం డేటా శాస్త్రవేత్తలకు సాధారణ ఉపకరణం, ఇవి వారి సఫిక్స్ లేదా విస్తరణ .ipynb ద్వారా గుర్తించబడతాయి.
నోట్లబుక్స్ ఒక ఇంటరాక్టివ్ వాతావరణం, కోడ్ తోపాటు గమనికలు జోడించడానికి, డాక్యుమెంటేషన్ రాయడానికి సహాయం చేస్తాయి, ఇది ప్రయోగదారుల లేదా పరిశోధనా-ఆధారిత ప్రాజెక్టులకు ఔత్సాహికంగా ఉపయోగపడుతుంది.

🎥 ఈ వ్యాయామం ద్వారా షార్ట్ వీడియో కోసం పై చిత్రాన్ని క్లిక్ చేయండి.
వ్యాయామం - నోట్లు బుక్తో పని చేయండి
ఈ ఫోల్డర్లో, notebook.ipynb ఫైల్ ఉంది.
-
Visual Studio Codeలో notebook.ipynb ని ఓపెన్ చేయండి.
జూపైటర్ సర్వర్ Python 3+తో స్టార్ట్ అవుతుంది. నోట్లు బుక్లో
runచేయగల కోడ్ భాగాలు ఉంటాయి. కోడ్ బ్లాక్ నడిపేందుకు ప్లే బటన్ లాంటిది ఉన్న ఐకాన్ ఎంచుకోండి. -
mdఐకాన్ ఎంచుకుని కొంత Markdown జోడించి క్రింద వాక్యం రాయండి # మీ నోటుబుక్కి స్వాగతం.తర్వాత కొద్ది Python కోడ్ జోడించండి.
-
కోడ్ బ్లాక్లో print('hello notebook') టైప్ చేయండి.
-
కోడ్ నడిపేందుకు అడుగు ఎంచుకోండి.
మీరు ప్రింట్ చేసిన ప్రకటన చూడగలరు:
hello notebook
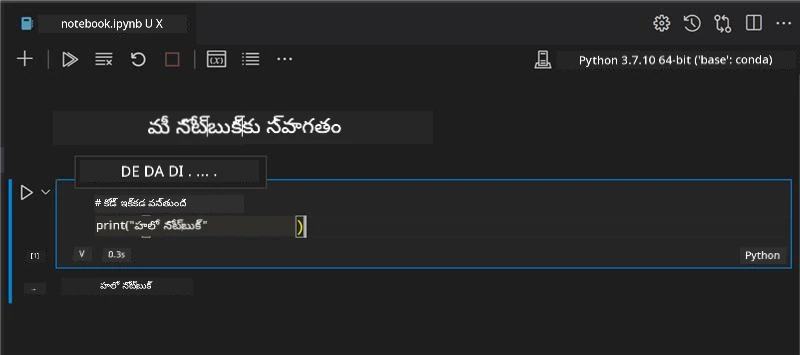
మీ కోడ్ పక్కన వ్యాఖ్యలను జోడించి నోటుబుక్ను స్వయంగా డాక్యుమెంట్ చేయవచ్చు.
✅ వెబ్ డెవలపర్ వాతావరణం మరియు డేటా శాస్త్రవేత్త వాతావరణం ఎంత భిన్నమో ఒక నిమిషం ఆలోచించండి.
స్కైకిట్-లెర్న్తో ప్రారంభం
ఇప్పుడు Python స్థానికంగా సెట్ అయ్యింది, జూపైటర్ నోట్లు బుక్స్తో సౌకర్యంగా ఉన్నారు, స్కైకిట్-లెర్న్తో కూడా సమానంగా సౌకర్యంగా అవ్వండి (ఇది ఎటువంటి శాస్త్రం అని sci అనే ఉచ్చారణ). స్కైకిట్-లెర్న్ ఒక విస్తృత APIని అందిస్తుంది, ఇది మీ ML పనులను చేయడానికి సహాయం చేస్తుంది.
వారి వెబ్సైట్ ప్రకారం, "స్కైకిట్-లెర్న్ ఒక ఓపెన్ సోర్స్ మెషిన్ లెర్నింగ్ లైబ్రరీ, ఇది సూపర్వైజ్డ్ మరియు అన్సూపర్వైజ్డ్ లెర్నింగ్ను మద్దతు ఇస్తుంది. ఇది మోడల్ ఫిట్టింగ్, డేటా ప్రీప్రొసెసింగ్, మోడల్ సెలెక్షన్ మరియు మూల్యాంకన, మరియు ఇతర అనేక పనులకు పరికరాలు అందిస్తుంది."
ఈ కోర్సులో మీరు స్కైకిట్-లెర్న్ మరియు ఇతర పరికరాలను ఉపయోగించి 'పారంపరిక మెషిన్ లెర్నింగ్' పనుల కోసం మోడల్స్ తయారీ చేస్తారు. న్యూరల్ నెట్వర్క్స్ మరియు డీప్ లెర్నింగ్ను దూరంగా ఉంచాము, అవి మాకొస్తున్న 'AI ఫర్ బెగినర్స్' కోర్సులో బాగా కవర్ చేస్తారు.
స్కైకిట్-లెర్న్ మోడల్స్ నిర్మాణం, వాటి ఉపయోగాన్ని సులభతరం చేస్తుంది. ఇది ప్రధానంగా సంఖ్యాత్మక డేటా కోసం మరియు నేర్చుకునేందుకు ఉపయోగించే సిద్ధమైన డేటా సెట్లను కలిగి ఉంది. విద్యార్థులు ప్రయత్నించేందుకు ప్రీ-బిల్ట్ మోడల్స్ కూడా అందుబాటులో ఉన్నాయి. ప్రీ-ప్యాకేజ్డ్ డేటాను లోడ్ చేసి, ఒక ఎస్టిమేటర్ను ఉపయోగించి ప్రాథమిక డేటాతో మీ మొదటి ML మోడల్ సృష్టించే ప్రక్రియను పరిశీలించుకుందాం.
వ్యాయామం - మీ మొదటి స్కైకిట్-లెర్న్ నోట్లు బుక్
ఈ ట్యుటోరియల్ స్కైకిట్-లెర్న్ వెబ్సైట్పై ఉన్న లీనియర్ రిగ్రెషన్ ఉదాహరణనుంచి ప్రేరణ పొందింది.

🎥 ఈ వ్యాయామం కోసం షార్ట్ వీడియో చూడటానికి పై చిత్రం క్లిక్ చేయండి.
ఈ పాఠానికి సంబంధించిన notebook.ipynb ఫైల్లోని అన్ని సెల్స్ను 'trash can' ఐకాన్ నొక్కి ఖాళీ చేయండి.
ఈ సెక్షన్లో, స్కైకిట్-లెర్న్లో శిక్షణ కోసం రూపొందించిన డయాబెటిస్ గురించి చిన్న డేటాసెట్తో మీరు పని చేస్తారు. మీకు డయాబెటిక్ రోగుల చికిత్స పరీక్షించాలని అనుకుంటే, మెషిన్ లెర్నింగ్ మోడల్స్ ఏ రోగులు మెరుగ్గా స్పందించరో నిర్ణయించడానికి సహాయం చేస్తాయి, వివిధ వేరియబుల్స్ కలయిక ఆధారంగా. చాలా ఆధారరహిత రిగ్రెషన్ మోడల్ చూపినప్పుడు, మీరు మీ సిద్దాంత క్లినికల్ ట్రయల్స్ను ఎలా నిర్వహించాలో సమాచారం పొందవచ్చు.
✅ రిగ్రెషన్ పద్ధతులు ఎన్నో ఉంటాయి, మీరు ఎవరైనా ఎంచుకునేది మీరు కోరుకునే సమాధానంపై ఆధారపడి ఉంటుంది. మీరు ఒక వ్యక్తి వయసు కోసం సాద్యమైన ఎత్తు అంచనా వేయాలని అనుకుంటే, లీనియర్ రిగ్రెషన్ ఉపయోగిస్తారు, ఎందుకంటే మీరు సంఖ్యాత్మక విలువ కోరుతున్నారు. మీరు ఏ వంటకాల్ని వెజిటేరియన్ అని భావించవచ్చో తెలుసుకోవాలని ఉంటే, మీరు వర్గీకరణ కోసం చూస్తున్నారు కనుక లాజిస్టిక్ రిగ్రెషన్ వాడుతారు. తర్వాత మీరు లాజిస్టిక్ రిగ్రెషన్ గురించి మరింత నేర్చుకుంటారు. మీకు దత్తాంశం గురించి అడగగల ప్రశ్నలు, వాటికి అనుకూలమైన పద్ధతులు ఏవో ఆలోచించండి.
ఈ పనిని మొదలు పెట్టుదాం.
లైబ్రరీస్ దిగుమతి చేసుకునే ప్రక్రియ
ఈ పనికి కొన్ని లైబ్రరీస్ దిగుమతి చేసుకుంటాం:
- matplotlib. ఇది ఒక ఉపయోగకరమైన గ్రాఫింగ్ టూల్, మెట్లు తెరుస్తుంది.
- numpy. numpy అనేది Pythonలో సంఖ్యాత్మక డేటాను నిర్వహించడానికి ఉపయోగించే లైబ్రరీ.
- sklearn. ఇది స్కైకిట్-లెర్న్ లైబ్రరీ.
మీ పనులకు సహాయం చేయడానికి కొన్ని లైబ్రరీస్ దిగుమతి చేసుకోండి.
-
దిగుమతులు చేర్చడానికి ఈ కోడ్ టైప్ చేయండి:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
మీరు
matplotlib,numpyదిగుమతి చేసుకుంటున్నారు, అంతే కాకsklearnనుంచిdatasets,linear_modelమరియుmodel_selectionను కూడా.model_selectionడేటాను శిక్షణ మరియు పరీక్ష సెట్లుగా విభజించడానికి ఉపయోగపడుతుంది.
డయాబెటిస్ డేటాసెట్
లోడ్ చేసిన డయాబెటిస్ డేటాసెట్ 442 శాంపిల్స్ కలదు, 10 ఫీచర్ వేరియబుల్స్ తో, వాటిలో కొన్ని:
- వయస్సు: సంవత్సరాలలో వయసు
- బిఎంఐ: శరీర ద్రవ్యం సూచిక
- బీపీ: సగటు రక్తపోటు
- s1 tc: టీ కంపెన్ల్స్ (తెల్ల రక్తకణాలు)
✅ ఈ డేటాసెట్ 'లింగం' అనే అంశాన్ని ముఖ్యమైన అంశంగా కలిగి ఉంది, ఇది డయాబెటిస్ పరిశోధనలో కీలకం. చాలా వైద్య డేటాసెట్స్ ఈ రకమైన ద్విభాజన వర్గీకరణ కలిగి ఉంటాయి. ఇలాంటి వర్గీకరణలు జనాభాలోని కొంత భాగాన్ని చికిత్సల నుండి ఎలా తీసివేయవచ్చో ఆలోచించండి.
ఇప్పడు, X మరియు y డేటాను లోడ్ చేయండి.
🎓 జ్ఞాపకం ఉంచుకోండి, ఇది సూపర్వైజ్డ్ లెర్నింగ్, మరియు మనకు పేరుపొందిన 'y' లక్ష్యం అవసరం.
కొత్త కోడ్ సెల్లో load_diabetes() కాల్ చేస్తూ డయాబెటిస్ డేటాసెట్ లోడ్ చేయండి. return_X_y=True అనే ఇన్పుట్ Xని డేటా మ్యాట్రిక్స్ గా, yని రిగ్రెషన్ టార్గెట్ గా సూచిస్తుంది.
-
డేటా మ్యాట్రిక్స్ ఆకారం మరియు మొదటి వస్తువును చూపించేందుకు ప్రింట్ కమాండ్లు చేర్చండి:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
మీరు తిరిగి పొందేది ఒక టుపుల్. ఈ టుపుల్ మొదటి రెండు విలువలను
Xమరియుyగా కేటాయిస్తున్నారు. టుపుల్స్ గురించి మరిన్ని తెలుసుకోండి.మీరు చూడగలరు, ఈ డేటాలో 442 అంశాలు ఉన్నాయి, ప్రతి ఒక్కటి 10 అంశాల అర్రేస్ రూపంలో:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ డేటా మరియు రిగ్రెషన్ టార్గెట్ సంబంధం గురించి ఆలోచించండి. లీనియర్ రిగ్రెషన్ ఫీచర్ X మరియు లక్ష్యం y మధ్య సంబంధాలను అంచనా వేస్తుంది. డయాబెటిస్ డేటాసెట్ లక్ష్యం డాక్యుమెంటేషన్లో ఏది చూడవచ్చు? ఈ డేటాసెట్ ఏం ప్రదర్శిస్తుంది, ఆ లక్ష్యం ఇచ్చిన సందర్భంలో?
-
తరువాత, డేటాసెట్ నుండి భాగాన్ని ఎంపిక చేసుకోండి, 3వ కాలమ్ను ఎంచుకొని. మీరు
:ఆపరేటర్ను ఉపయోగించి అన్ని వరుసలను ఎంచుకుని, 3వ కాలమ్ సూచిక ద్వారా (2), ఎంచుకోవచ్చు. మీరు డేటాను 2D అర్రేగా మార్చవచ్చు - గ్రాఫ్ డ్రా చేయడానికి అవసరం -reshape(n_rows, n_columns)ఉపయోగించి. ఒక పరామితి -1 అయితే, ఆ కొలత ఆటోమేటిక్ గా లెక్కించబడుతుంది.X = X[:, 2] X = X.reshape((-1,1))✅ ఎప్పుడు కావాలంటే డేటా ఆకారం పరిశీలించడానికి ప్రింట్ చేయండి.
-
ఇప్పుడు, మీరు ప్లాట్ చేయడానికి డేటా సిద్ధంగా ఉంటుంది, యాంత్రికంగా ఒక లాజికల్ విభజన ఎంత వరకూ కావచ్చో చూడండి. ఇలా చేయడానికి, డేటా (X) మరియు టార్గెట్ (y) రెండూ పరీక్ష మరియు శిక్షణ సెట్లుగా విభజించాలి. స్కైకిట్-లెర్న్ అందించిన సులభమైన పద్ధతి ద్వారా మీరు టెస్టు డేటాను కచ్చితమైన స్పాట్ వద్ద విభజించవచ్చు.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
ఇప్పుడు మీ మోడల్ ట్రైనింగ్కు సిద్ధం! లీనియర్ రిగ్రెషన్ మోడల్ లోడ్ చేయండి, మీ X మరియు y శిక్షణ సెట్లతో
model.fit()ఉపయోగించి శిక్షణ ఇస్తూ:model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()అనేది TensorFlow వంటి మెషిన్ లెర్నింగ్ లైబ్రరీలలో కనిపించే ఫంక్షన్. -
తర్వాత, టెస్ట్ డేటాను ఉపయోగించి
predict()ఫంక్షన్ ద్వారా అంచనా చేయండి. ఇది డేటా గుంపుల మధ్య రేఖ తెరుస్తుంది.y_pred = model.predict(X_test) -
ఇప్పుడు డేటాను ప్లాట్లో చూపించడానికి సమయం వచ్చింది. matplotlib ఇది ఒక చాలా ఉపయోగకరమైన సాధనం. అన్ని X మరియు y టెస్ట్ డేటాను స్పాటర్ప్లాట్ చేయండి, అంచనా ఉపయోగించి మోడల్స్ డేటా గుంపుల మధ్య సరైన స్థలంలో రేఖ వీస్తుంది.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()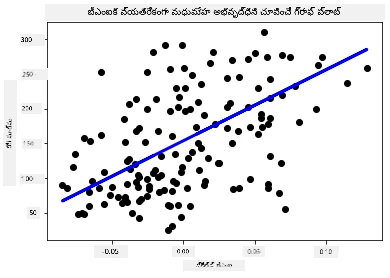
✅ ఇది ఏమి చేస్తున్నది అనేదానిపై ఆలోచించండి. ఒక సరళి అనేక చిన్న డాటా పాయింట్ల మధ్య దూస్తోంది, ఇది ఏం సూచిస్తోంది? ఈ రేఖను ఉపయోగించి కొత్త మరియు చూడని డేటా పాయింట్ ఎక్కడ ఉండాలి అని అంచనా వేయొచ్చు కదా? ఈ మోడల్ యొక్క ప్రాక్టికల్ ఉపయోగం ఏమిటనే దాన్ని మాటలలో వ్యక్తం చేయండి.
అభినందనలు, మీరు మీ మొదటి లీనియర్ రిగ్రెషన్ మోడల్ నిర్మించి, దీని తో అంచనా చేసి, ప్లాట్లో చూపించారు!
🚀చాలెంజ్
ఈ డేటాసెట్ నుండి ఒక వేరొక వేరియబుల్ ప్లాట్ చేయండి. సూచన: ఈ లైన్ మార్చండి: X = X[:,2]. ఈ డేటాసెట్ లక్ష్యం ఆధారంగా, డయాబెటిస్ వ్యాధి పురోగతి గురించి మీరు ఏం తెలుసుకుంటారు?
ఉపన్యాస తర్వాత క్విజ్
సమీక్ష & స్వీయ అధ్యయనం
ఈ ట్యుటోరియల్లో మీరు సింపుల్ లీనియర్ రిగ్రెషన్తో పనిచేశారు, యూనివేరియట్ లేదా మల్టిపుల్ లీనియర్ రిగ్రెషన్ కాకుండా. ఈ పద్ధతుల మధ్య తేడాలపై కొంత చదవండి, లేదా ఈ వీడియో చూడండి
రిగ్రెషన్ సూత్రం గురించి మరింత చదవండి మరియు ఈ సాంకేతికత ద్వారా ఏ రకమైన ప్రశ్నలకు సమాధానం ఇవ్వగలమో ఆలోచించండి. మీ అవగాహనను పెంపొందించడానికి ఈ పాఠం తీసుకోండి.
అసైన్మెంట్
అస్వీకరణ: ఈ పత్రం AI అనువాద సేవ Co-op Translator ఉపయోగించి అనువదించబడింది. మేము ఖచ్చితత్వానికి ప్రయత్నిస్తున్నప్పటికీ, ఆటోమేటెడ్ అనువాదాలు తప్పులు లేదా అసమగ్రతలను కలిగి ఉండవచ్చు. దాని స్వదేశ భాషలో ఉన్న అసలు పత్రాన్ని అధికారం కలిగిన మూలంగా పరిగణించాలి. కీలకమైన సమాచారం కోసం, ప్రొఫెషనల్ మానవ అనువాదాన్ని సిఫారసు చేస్తాము. ఈ అనువాదం ఉపయోగం వల్ల కలిగే ఏవైనా అపార్థాలు లేదా తప్పుదారులు కోసం మేము బాధ్యత వహించము.