
23 KiB
Започните са Python-ом и Scikit-learn-ом за регресионе моделе
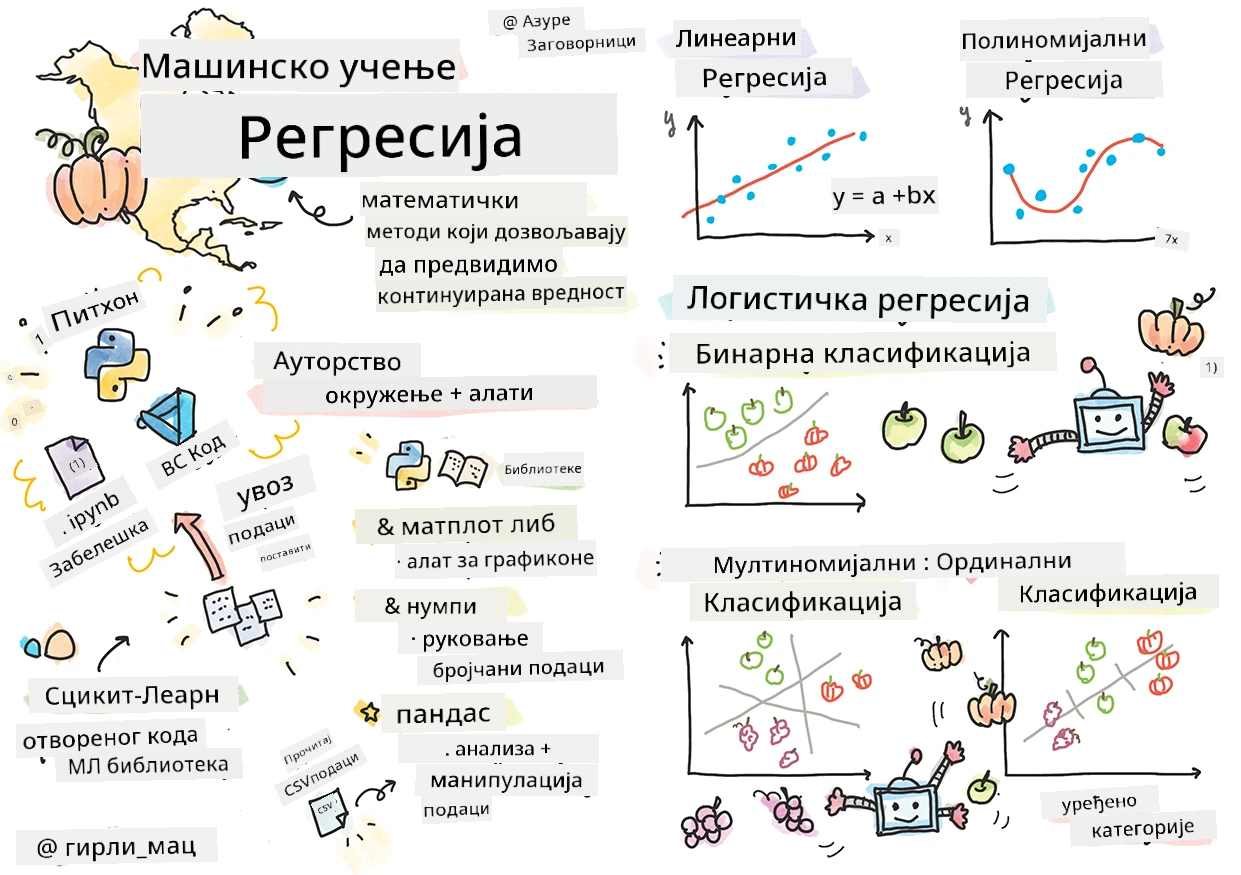
Скичнот од Томоми Имура
Квиз пре предавања
Овај лекција је доступна у R језику!
Увод
У ових четири лекције научићете како да правите регресионе моделе. Ускоро ћемо расправљати чему они служе. Али пре него што било шта урадите, уверите се да имате исправне алате да започнете процес!
У овој лекцији научићете како да:
- Конфигуришете свој рачунар за локалне задатке машинског учења.
- Радите са Јупитер ноутбуцима.
- Користите Scikit-learn, укључујући инсталацију.
- Истражите линеарну регресију уз практичну вежбу.
Инсталације и конфигурације

🎥 Кликните на слику изнад за кратак видео о томе како конфигурисати свој рачунар за машинско учење.
-
Инсталирајте Python. Уверите се да је Python инсталиран на вашем рачунару. Python ћете користити за многе задатке у области науке о подацима и машинског учења. Већина рачунарских система већ има инсталиран Python. Постоје корисни Python кодинг пакети који такође олакшавају подешавање за одређене кориснике.
Међутим, неке употребе Pythona захтевају различите верзије софтвера. Због тога је корисно радити унутар виртуелног окружења.
-
Инсталирајте Visual Studio Code. Уверите се да имате Visual Studio Code инсталиран на вашем рачунару. Пратите упутства за инсталацију Visual Studio Code-а. У овом курсу ћете користити Python у Visual Studio Code-у, па можда желите да се упознате са тим како да конфигуришете Visual Studio Code за развој у Python-у.
Укратко се упознајте са Python-ом кроз ову збирку Learn модула

🎥 Кликните на слику изнад за видео: коришћење Python-а у VS Code-у.
-
Инсталирајте Scikit-learn, пратећи ова упутства. Пошто морате да користите Python 3, препоручује се да користите виртуелно окружење. Ако инсталирате ову библиотеку на M1 Mac, ту су посебна упутства на страници повезаној горе.
-
Инсталирајте Jupyter Notebook. Потребно је да инсталирате Jupyter пакет.
Ваш ML окружење за креирање
Користићете ноутбуке за развој свог Python кода и креирање модела машинског учења. Овај тип фајлова је уобичајен алат за наутичаре података и препознају се по наставку .ipynb.
Ноутбукови су интерактивно окружење које омогућава развојном инжењеру и да кодира и да додаје белешке и докуметацију уз код, што је корисно за експерименталне или истраживачке пројекте.

🎥 Кликните на слику изнад за кратак видео као вежбу.
Вежба - рад са ноутбуком
У овом фолдеру ћете наћи фајл notebook.ipynb.
-
Отворите notebook.ipynb у Visual Studio Code-у.
Јупитер сервер ће се покренути са Python 3+. У ноутбуку ћете пронаћи делове које можете да
run-ујете, делове кода. Код можете покренути тако што ћете изабрати иконицу која изгледа као дугме за репродукцију. -
Изаберите
mdикону и додајте мало markdown-а, и следећи текст # Добродошли у ваш ноутбук.Затим додајте неки Python код.
-
Укуцајте print('hello notebook') у блок кода.
-
Изаберите стрелицу за покретање кода.
Требало би да видите одштампану поруку:
hello notebook
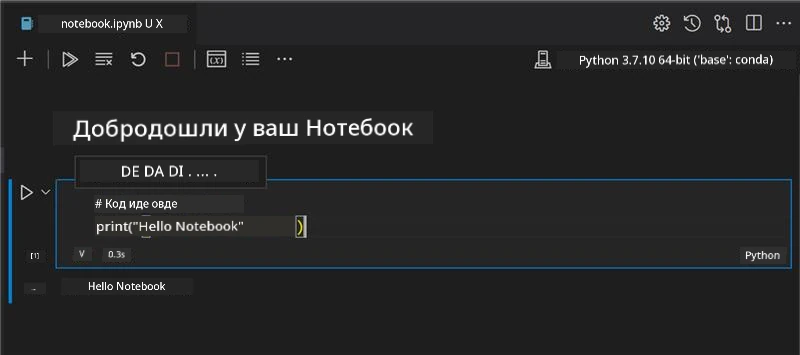
Можете мешати свој код са коментарима да бисте сами документовали ноутбук.
✅ Размислите на минут колико се радно окружење веб програмера разликује од окружења научника за податке.
Покрените се са Scikit-learn-ом
Сада када је Python подешен у вашем локалном окружењу и када сте навикли на Jupyter Notebooks, хајде да се подједнако упознате са Scikit-learn-ом (изговара се сци као у речи сајенс). Scikit-learn пружа обиман API који вам помаже у обављању задатака машинског учења.
Према њиховом сајту, "Scikit-learn је библиотека за машинско учење отвореног кода која подржава надгледано и ненадгледано учење. Такође пружа разне алате за прилагођавање модела, претпрераду података, избор и евалуацију модела и многе друге помоћне алате."
У овом курсу користићете Scikit-learn и друге алате да бисте направили моделе машинског учења за оно што називамо 'традиционалним задацима машинског учења'. Намерно смо избегавали неуронске мреже и дубоко учење јер ће ти бити боље обухваћени у нашем предстојећем курикулуму "AI за почетнике".
Scikit-learn чини једноставним изградњу модела и њихову евалуацију за употребу. Првенствено је фокусиран на коришћење нумеричких података и садржи више спремних скупова података за учење. Такође укључује већ изграђене моделе које студенти могу пробати. Хајде да истражимо процес учитавања предпакованих података и коришћење уграђеног естиматора да направите свој први ML модел са Scikit-learn и основним подацима.
Вежба - ваш први Scikit-learn ноутбук
Овај туторијал је инспирисан примером линеарне регресије са сајта Scikit-learn-ја.

🎥 Кликните на слику изнад за кратак видео који обрађује ову вежбу.
У фајлу notebook.ipynb који је везан за ову лекцију, обришите све ћелије притиском на икону 'канта за смеће'.
У овом делу ћете радити са малим скупом података о дијабетесу који је уграђен у Scikit-learn за потребе учења. Замислите да желите да тестирате третман за пацијенте са дијабетесом. Модели машинског учења могу вам помоћи да одредите који пацијенти боље реагују на третман, на основу комбинација варијабли. Чак и веома основни регресијски модел, када се визуелно прикаже, може показати информације о варијаблама које би вам помогле да организујете своје теоријске клиничке студије.
✅ Постоји много врста регресионх метода, а коју ћете изабрати зависи од одговора који тражите. Ако желите да предвидите вероватну висину особе одређеног узраста, користићете линеарну регресију, јер тражите нумеричку вредност. Ако вас занима да ли неки тип кухиње треба сматрати веганском или не, тражите категоријску класификацију па бисте користили логистичку регресију. О логистичкој регресији ћете касније сазнати више. Размислите мало о питањима која можете поставити подацима и која од ових метода би била прикладнија.
Хајде да започнемо овај задатак.
Увожење библиотека
За овај задатак ћемо увозити неке библиотеке:
- matplotlib. Корисан је алат за графиконе и користићемо га за израду линијског графика.
- numpy. numpy је корисна библиотека за руковање бројчаним подацима у Python-у.
- sklearn. Ово је Scikit-learn библиотека.
Увезите неке библиотеке које ће вам помоћи у задацима.
-
Додајте импорт наредбе укуцавањем следећег кода:
import matplotlib.pyplot as plt import numpy as np from sklearn import datasets, linear_model, model_selectionГорe увозите
matplotlib,numpyи увозитеdatasets,linear_modelиmodel_selectionизsklearn.model_selectionсе користи за раздвајање података на тренинг и тест скуп.
Скуп података о дијабетесу
Уграђени скуп података о дијабетесу укључује 442 узорка података о дијабетесу, са 10 особина, од којих неке укључују:
- age: година
- bmi: индекс телесне масе
- bp: просечан крвни притисак
- s1 tc: Т ћелије (врста белих крвних зрнаца)
✅ Овај скуп података укључује концепт 'пол' као важну варијаблу у истраживању дијабетеса. Многи медицински скупови података укључују овакву бинарну класификацију. Размислите како таква категоризација може искључити одређене делове популације из одређених третмана.
Сада учитајте X и y податке.
🎓 Запамтите, ово је надгледано учење и потребно нам је именовано 'y' као циљ.
У новом коду учитајте скуп података о дијабетесу позивом load_diabetes(). Улаз return_X_y=True сигнализира да ће X бити матрица података, а y циљ регресије.
-
Додајте неке наредбе за штампање да бисте показали облик матрице података и њен први елемент:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Оно што добијате као одговор је тјупл (tuple). Ваша радња је да две прве вредности тјупла доделите променљивим
Xиy. Сазнајте више о тјупловима.Можете видети да ови подаци имају 442 ставке у облику низова са по 10 елемената:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Размислите мало о односу између података и циља регресије. Линеарна регресија предвиђа односе између особина X и циљне варијабле y. Можете ли пронаћи циљ за скуп дијабетес података у документацији? Шта овај скуп података демонстрира, с обзиром на циљ?
-
Затим одаберите део овог скупа података за означавање графика тако што ћете изабрати 3. колону скупа. То можете урадити коришћењем оператора
:да одаберете све редове и потом одаберите 3. колону користећи индекс (2). Можете и преобликовати податке у 2Д низ - како је потребно за графикон - помоћуreshape(n_rows, n_columns). Ако је један од параметара -1, одговарајућа димензија се аутоматски рачуна.X = X[:, 2] X = X.reshape((-1,1))✅ У сваком тренутку одштампајте податке да бисте проверили облик.
-
Сада када имате податке спремне за график, видите да ли машина може помоћи у одређивању логичне поделе међу бројевима у овом скупу. Да бисте то урадили, потребно је да поделите и податке (X) и циљ (y) на тест и тренинг скупове. Scikit-learn има једноставан начин да то урадите; можете поделити тест податке на одређеној тачки.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Сада сте спремни да тренирате свој модел! Учитајте линеарни регресијски модел и обучите га са својим X и y тренинг скупом користећи
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()је функција коју ћете видети у многим ML библиотекама као што је TensorFlow. -
Затим, направите предвиђање користећи тест податке, употребом функције
predict(). Ово ће се користити да нацртате линију између група података.y_pred = model.predict(X_test) -
Сада је време да прикажете податке на графикону. Matplotlib је веома користан алат за овај задатак. Направите дијаграм распршавања свих X и y тест података и користите предвиђање да нацртате линију на најприкладнијем месту, између група моделових података.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()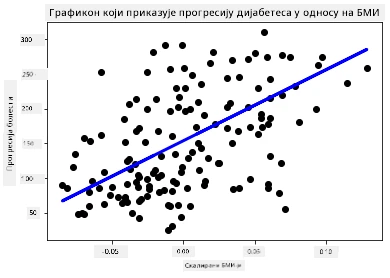
✅ Размислите мало о томе шта се овде дешава. Равно линија пролази кроз много малих тачака података, али шта она тачно ради? Можете ли видети како бисте могли користити ову линију да предвидите где би нова, невидјена тачка података требало да се уклопи у односу на y осу графика? Покушајте да формулишете практичну употребу овог модела.
Честитамо, направили сте свој први модел линеарне регресије, направили предвиђање и приказали га на графикону!
🚀Изазов
Нанесите други параметар из овог скупа података на графикон. Савет: измените ову линију: X = X[:,2]. С обзиром на циљ овог скупа података, шта можете открити о напретку дијабетеса као болести?
Квиз након предавања
Преглед и самостално учење
У овом туторијалу сте радили са једноставном линеарном регресијом, уместо са униваријантном или мултиплом линеарном регресијом. Прочитајте мало о разликама између ових метода, или погледајте овај видео
Прочитајте више о концепту регресије и размислите о томе каква питања ова техника може да одговори. Пређите овај туторијал да бисте продубили своје разумевање.
Задатак
Изјава о одрицању одговорности: Овај документ је преведен коришћењем услуге за аутоматски превод Co-op Translator. Иако тежимо тачности, имајте у виду да аутоматски преводи могу садржати грешке или нетачности. Оригинални документ на његовом изворном језику треба сматрати ауторитативним извором. За критичне информације препоручује се професионални људски превод. Нисмо одговорни за било каква неспоразума или погрешна тумачења која произилазе из коришћења овог превода.