
32 KiB
റിഗ്രഷൻ മോഡലുകൾക്ക് Python-നും Scikit-learn-നും తో തുടക്കം കുറിക്കുക
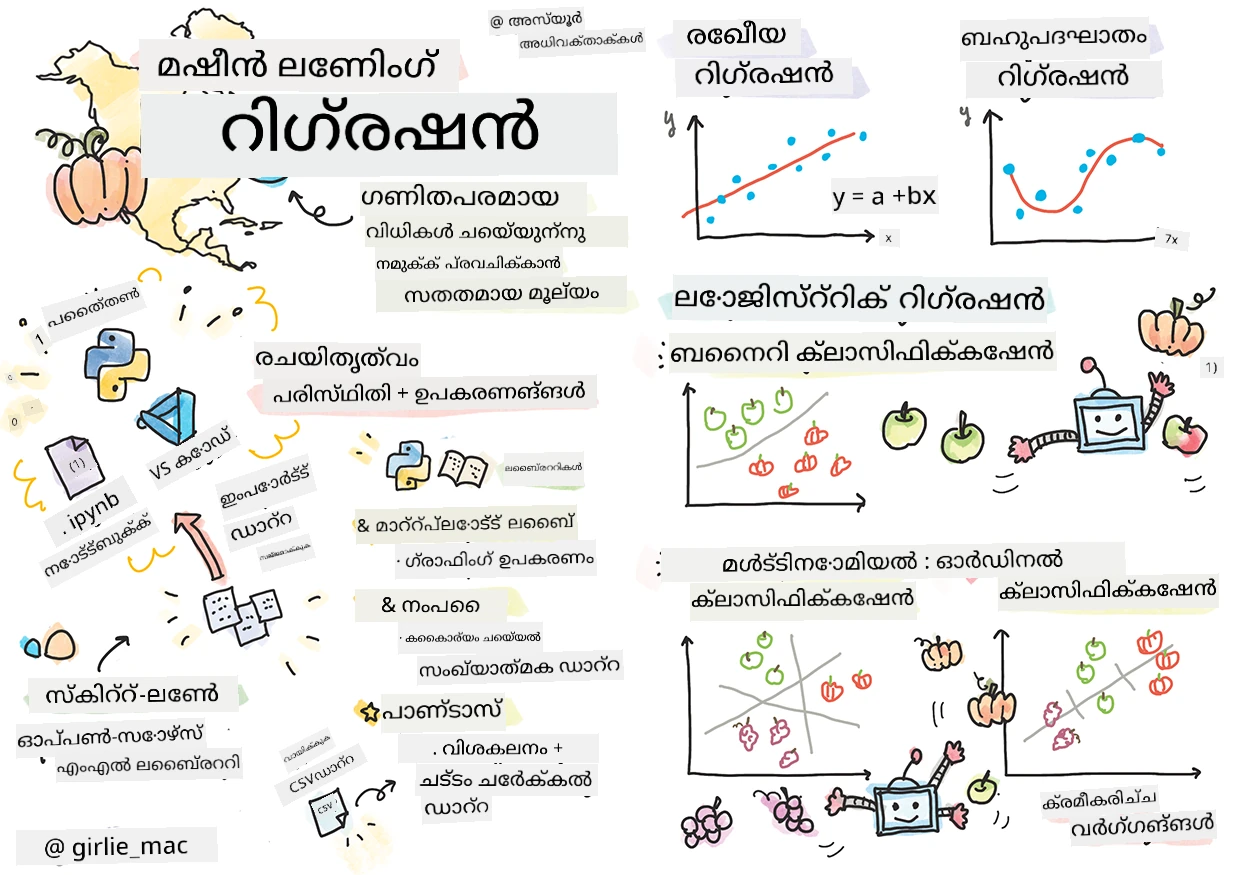
Tomomi Imura രചിച്ച Sketchnote
പ്രീ-ലെക്ചർ ക്വിസ്
ഈ പാഠം R-ൽ ലഭ്യമാണ്!
പരിചയം
ഈ നാല് പാഠങ്ങളിൽ, നിങ്ങൾ റിഗ്രഷൻ മോഡലുകൾ എങ്ങനെ നിർമ്മിക്കാമെന്ന് കാണും. അവ എന്തിനുള്ളതാണെന്ന് നേരെയായി ചർച്ച ചെയ്യും. എന്നാൽ ഒന്നും ചെയ്യുന്നതിന് മുമ്പ്, പ്രക്രിയ ആരംഭിക്കാൻ ആവശ്യമായ ശരിയായ ഉപകരണങ്ങൾ ഉണ്ടെന്ന് ഉറപ്പാക്കുക!
ഈ പാഠത്തിൽ, നിങ്ങൾ പഠിക്കേണ്ടത്:
- നിങ്ങളുടെ കമ്പ്യൂട്ടർ ലോക്കൽ മെഷീൻ ലേണിംഗ് പണികൾക്കായി ക്രമീകരിക്കുന്നത്.
- Jupyter Notebooks ഉപയോഗിക്കുന്നത്.
- ഇൻസ്റ്റാളേഷൻ ഉൾപ്പെടെ Scikit-learn ഉപയോഗിക്കുന്നത്.
- ലൈനിയർ റിഗ്രഷൻ ഒരു പ്രായോഗിക അഭ്യാസത്തിലൂടെ പരിശോധിക്കുക.
ഇൻസ്റ്റാളേഷനുകളും ക്രമീകരണങ്ങളും

🎥 എംഎൽ-ക്കായി നിങ്ങളുടെ കമ്പ്യൂട്ടർ ക്രമീകരിക്കുന്നതിനുള്ള ഒരു ചെറിയ വീഡിയോകൾക്കായി മുകളിലെ ചിത്രം ക്ലിക്ക് ചെയ്യുക.
- Python ഇൻസ്റ്റാൾ ചെയ്യുക. നിങ്ങളുടെ കമ്പ്യൂട്ടറിൽ Python ഇൻസ്റ്റാൾ ചെയ്തിട്ടുണ്ടെന്ന് ഉറപ്പാക്കുക. നിങ്ങൾക്ക് പല ഡാറ്റാ സയൻസും മെഷീൻ ലേണിംഗ് ടാസ്കുകളും Python ഉപയോഗിച്ച് ചെയ്യേണ്ടതുണ്ടാകും. പല കമ്പ്യൂട്ടറുകളിലും മുമ്പേ Python ഇൻസ്റ്റാളുചെയ്യപ്പെട്ടിരിക്കും. ചില ഉപയോക്താക്കൾക്ക് ക്രമീകരണമാറ്റാൻ സഹായകമായ Python Coding Packs ഉണ്ടു.
ചില Python ഉപയോഗങ്ങൾക്ക് ഒരു സോഫ്റ്റ്വെയർ വേർഷൻ ആവശ്യമായിരുന്നെങ്കിൽ മറ്റുചിലക്ക് വേറെ വേർഷൻ ആവശ്യമായിരിക്കും. അതുകൊണ്ടുതന്നെ, ഒരു virtual environment ഉള്ളിൽ പ്രവർത്തിക്കുന്നത് ഉപകാരപ്രദമാണ്.
- Visual Studio Code ഇൻസ്റ്റാൾ ചെയ്യുക. നിങ്ങളുടെ കമ്പ്യൂട്ടറിൽ Visual Studio Code ഇൻസ്റ്റാൾ ചെയ്തിട്ടുണ്ടെന്ന് ഉറപ്പാക്കുക. അടിസ്ഥാന ഇൻസ്റ്റാളേഷനായി Visual Studio Code ഇൻസ്റ്റാൾ ചെയ്യുക എന്ന നിർദ്ദേശങ്ങൾ പാലിക്കുക. ഈ കോഴ്സിൽ Visual Studio Code-ൽ Python ഉപയോഗിക്കാൻ പോകുന്നു, അതിനാൽ Python ഡെവലപ്പ്മെന്റിനായി Visual Studio Code ക്രമീകരിക്കൽ പഠിക്കുക.
Pythonతో സൗകര്യപ്പെടാൻ ഈ Learn modules സീരീസ് വഴി പ്രവർത്തിക്കുക
🎥 VS Code-ൽ Python ഉപയോഗിക്കുന്ന ഒരു വീഡിയോകൾക്കായി മുകളിലെ ചിത്രം ക്ലിക്ക് ചെയ്യുക.

-
Scikit-learn ഇൻസ്റ്റാൾ ചെയ്യുക. ഈ നിർദ്ദേശങ്ങൾ പിന്തുടരുക. Python 3 ഉപയോഗിക്കുന്നുവെന്ന് ഉറപ്പാക്കാൻ virtual environment ഉപയോഗിക്കാൻ ശുപാർശ ചെയ്യുന്നു. M1 Mac-ൽ ഇൻസ്റ്റാളേഷൻ ചെയ്യുന്നുവെങ്കിൽ മുകളിലെ പേജ് കാണുക, പ്രത്യേക നിർദ്ദേശങ്ങൾ ഉണ്ട്.
-
Jupyter Notebook ഇൻസ്റ്റാൾ ചെയ്യുക. Jupyter പാക്കേജ് ഇൻസ്റ്റാൾ ചെയ്യുക.
നിങ്ങളുടെ എംഎൽ എഴുതാനുള്ള അന്തരീക്ഷം
Python കോഡ് വികസിപ്പിക്കാൻ, മെഷീൻ ലേണിംഗ് മോഡലുകൾ സൃഷ്ടിക്കാൻ notebooks ഉപയോഗിക്കും. ഈ ടൈപ്പ് ഫയലുകൾ ഡാറ്റാ സയന്റിസ്റ്റുകൾ പ്രതിരൂപീകരിക്കുന്ന സാധാരണ ഉപകരണമാണ്, സഫിക്സ് അല്ലെങ്കിൽ എക്സ്റ്റൻഷൻ .ipynb വേണ്ട നിറവിൽ തിരിച്ചറിയാം.
Notebooks ഒരു ഇന്ററാക്ടീവ് പരിസരമാണ്, ഡെവലപ്പർക്ക് കോഡ് എഴുതാനും, കോഡിന്റെ ചുറ്റുമുള്ള കുറിപ്പുകൾ ചേർക്കാനും ഡോക്യുമെന്റേഷൻ എഴുതാനും അവസരം നൽകുന്നത്, പ്രത്യേകിച്ചും പരീക്ഷണവിഭാഗ പ്രോജക്ടുകൾക്ക് വളരെ സഹായകരം.

🎥 ഈ അഭ്യാസം ചെയ്യാനുള്ള ഒരു ചെറിയ വീഡിയോകൾക്കായി മുകളിലെ ചിത്രം ക്ലിക്ക് ചെയ്യുക.
അഭ്യാസം - ഒരു നോർക്കിൽ പ്രവർത്തിക്കുക
ഈ ഫോൾഡറിൽ notebook.ipynb ഫയൽ കണ്ടെത്തും.
-
notebook.ipynb Visual Studio Code-യിൽ തുറക്കുക.
Jupyter സെർവർ Python 3+ ഉപയോഗിച്ച് ആരംഭിക്കും. നോർക്കിലെ
runചെയ്യാവുന്ന ഭാഗങ്ങൾ, കോഡ് വെള്ളകളുണ്ടാകും. പ്ലേ ബട്ടണുപോലെ കാണുന്ന ഐകൺ തിരഞ്ഞെടുക്കും, കോഡ് ബ്ലോക്ക് റൺ ചെയ്യാം. -
mdഐകൺ തിരഞ്ഞെടുക്കുക, ചെറിയ മാർക്ക്ഡൗൺ ചേർക്കുക, താഴെക്കൽപ്പെട്ട # Welcome to your notebook എന്ന പാഠങ്ങൾ ചേർക്കുക.പിന്നീട് Python കോഡ് ചേർക്കുക.
-
കോഡ് ബ്ലോക്കിൽ print('hello notebook') ടൈപ്പ് ചെയ്യുക.
-
കോഡ് റൺ ചെയ്യാൻ മൂലി തിരഞ്ഞെടുക്കുക.
ഈ തരം പ്രിന്റ് സ്റ്റേറ്റ്മെന്റ് കാണണം:
hello notebook
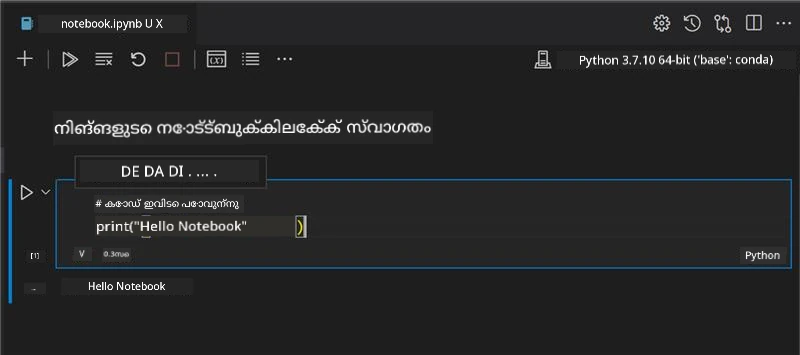
നിങ്ങൾക്ക് കോഡ് കമന്റുകളുമായി നോബുക്കിനെ സ്വയം ഡോക്യുമെന്റ് ചെയ്യാൻ കഴിയും.
✅ ഒരു വെബ് ഡെവലപ്പറുടെ വർക്ക് പരിസരം ഒരു ഡാറ്റാ സയന്റിസ്റ്റിന്റെതുമായി എത്ര വ്യത്യാസമുള്ളതാണ് എന്ന് ഒരു നിമിഷം ചിന്തിക്കുക.
Scikit-learn-ന് കൂടെ പ്രവർത്തനം ആരംഭിക്കുക
ഇപ്പോൾ Python നിങ്ങളുടെ ലൊക്കൽ അന്തരീക്ഷത്തിൽ ക്രമീകരിച്ചിരിക്കുന്നു, Jupyter നോർക്കുകൾക്കൊപ്പം സൗകര്യവത്കരിച്ചിട്ടുണ്ട്, കൂടാതെ Scikit-learn-നെ/sci (സയൻസ് എന്ന് വായിക്കുക) ഉപയോഗിക്കാൻ ഒരുപോലെ സൗകര്യമാകും. Scikit-learn ഏറെയുള്ള മെഷീൻ ലേണിംഗ് ടാസ്ക്കുകൾ നടത്താൻ ഒരു വ്യാപകമായ API നൽകി സഹായിക്കുന്നു.
അവരുടെ വെബ്സൈറ്റ് പ്രകാരം, "Scikit-learn ഒരു ഓപ്പൺ സോഴ്സ് മെഷീൻ ലേണിംഗ് ലൈബ്രറിയാണ്, സൂപ്പർവൈസ്ഡ്, അന്സൂപ്പർവൈസ്ഡ് ലേണിംഗ് പിന്തുണയ്ക്കുന്നു. മോഡൽ ഫിറ്റിംഗ്, ഡാറ്റാ പ്രീപ്രോസസ്സിംഗ്, മോഡൽ തിരഞ്ഞെടുപ്പ് & വിലയിരുത്തൽ എന്നിവർക്കുള്ള വിവിധ ഉപകരണങ്ങൾ നൽകുന്നു."
ഈ കോഴ്സിൽ Scikit-learn എന്നിവയും മറ്റ് ഉപകരണങ്ങളും ഉപയോഗിച്ച് എന്തിൽ 'പാരമ്പര്യ മെഷീൻ ലേണിംഗ്' ടാസ്ക്കുകൾ ചെയ്യാമെന്ന് കാണിക്കും. ന്യുരൽ നെറ്റ്വർക്കുകളും ഡീപ് ലേണിംഗും ഞങ്ങൾ 'AI for Beginners' കോഴ്സിൽ ഉൾപ്പെടുത്താറുണ്ട്.
Scikit-learn മോഡലുകൾ എളുപ്പത്തിൽ നിർമ്മിക്കുന്നതിനും അവ പരിശോധിക്കുന്നതിനും വിധേയമാണ്. ഇത് പ്രധാനമായും സംഖ്യാപരമായ ഡാറ്റയിലേക്കാണ് ലക്ഷ്യമിടുന്നത്, പരിശീലനത്തിനായുള്ള നിരവധി datasets ഉൾപ്പെടുത്തുന്നു. പഠനാർത്ഥം pre-built മോഡലുകളും ഉണ്ട്. പ്രീപാക്കേജ് ചെയ്ത ഡാറ്റ ലോഡ് ചെയ്ത് ഇൻ-ബിൽറ്റ് എസ്റ്റിമേറ്റർ ഉപയോഗിച്ച് ആദ്യ ML മോഡൽ സൃഷ്ടിക്കുന്ന പ്രക്രിയ പരിശോധിക്കാം.
അഭ്യാസം - നിങ്ങളുടെ ആദ്യ Scikit-learn നോബുക്ക്
ഈ ട്യൂട്ടോറിയൽ Scikit-learn വെബ്സൈറ്റിലുള്ള linear regression ഉദാഹരണം പ്രചോദനമായി.

🎥 അഭ്യാസം ചെയ്യാനുള്ള ഒരു ചെറിയ വീഡിയോ അനുഭവം മുകളിലെ ചിത്രം ക്ലിക്ക് ചെയ്യുക.
notebook.ipynb പാഠത്തിന്റെ സാന്ദർഭ്യത്തിൽ, എല്ലാ സെല്ലുകളും 'trash can' ഐകനും നുസരിച്ച് ഇല്ലാതാക്കുക.
ഈ വിഭാഗത്തിൽ, Scikit-learn പഠനാർത്ഥം ഉൾപ്പെടുത്തിയ ഡയബറ്റീസ് എന്ന ചെറിയ dataset-നെ നിങ്ങൾ സമീപിക്കും. ഡയബറ്റിക് രോഗികൾക്ക് ഒരു ചികിത്സാ പരീക്ഷണം നടത്താനായി നിങ്ങൾ ഉദ്ദേശിക്കുന്നുവെന്ന് കണക്കാക്കുക. ML മോഡലുകൾ ഏതൊക്കെയൊ രോഗികൾ بہتر പ്രതികരിക്കും എന്ന് മുൻകൂട്ടി കണ്ടെത്താൻ സഹായിക്കും, വ്യത്യസ്ത വേരിയബിളുകളുടെ സംയോജനം അനുസരിച്ച്. അടിസ്ഥാന റിഗ്രഷൻ മോഡൽ ദൃശ്യീകരിച്ചാൽ, വൈറിയബിളുകളെക്കുറിച്ചുള്ള വിവരങ്ങൾ കാണിക്കാൻ കഴിയും, അത് സിദ്ധാന്ത ക്ലിനിക്കൽ ട്രയലുകൾ ഏകോപിപ്പിക്കാൻ സഹായിക്കും.
✅ റിഗ്രഷൻ മേധോഡുകളുടെ പലതരം ഉണ്ട്, നിങ്ങൾ തിരഞ്ഞെടുക്കുന്നത് നിങ്ങൾ അന്വേഷിക്കുന്ന ചോദ്യ അടിസ്ഥാനമായിരിക്കും. ഒരു വ്യക്തിയുടെ കൊളജ് നീളം പ്രവചിക്കാൻ, ലൈനിയർ റിഗ്രഷൻ ഉപയോഗിക്കും കാരണം നിങ്ങൾ സંખ്യാ മൂല്യം തേടുന്നു. ഒരു ഭക്ഷണശൈലി വെഗൻ ആണോ എന്നറിയാൻ ആഗ്രഹിക്കുന്നുവെങ്കിൽ, നിങ്ങൾ വർഗ്ഗിഫലം തേടുന്നു, അതിനാൽ ലൊജിസ്റ്റിക്ക് റിഗ്രഷൻ വച്ചാണ് ഉപയോഗിക്കുന്നത്. ലൊജിസ്റ്റിക്ക് റിഗ്രഷൻ പിന്നീട് വാലു ചെയ്യും. ഡാറ്റയിൽ ചോദിക്കാവുന്ന ചില ചോദ്യങ്ങൾ അധികം ചിന്തിക്കുക, ഏതു മേധോഡ് കൂടുതൽ അനുയോജ്യമെന്ന് ചിന്തിക്കുക.
ഈ പണി തുടങ്ങാം.
ലൈബ്രററികൾ ആമ്പോർട്ട് ചെയ്യുക
ഈ ജോലി വേണ്ടി ചില ലൈബ്രററികൾ ആമ്പോർട്ട് ചെയ്യാം:
- matplotlib. ഒരു പ്രയോജനമുള്ള ഗ്രാഫിംഗ് ടൂൾ, ലൈനൽ പ്ലോട്ട് സൃഷ്ടിക്കാനായി ഉപയോഗിക്കും.
- numpy. Python-ൽ സംഖ്യാത്മക ഡാറ്റ കൈകാര്യം ചെയ്യാനുള്ള പ്രയോഗശാല numpy.
- sklearn. Scikit-learn ലൈബ്രറി.
നിങ്ങളുടെ ജോലികൾക്കായി ചില ലൈബ്രററികൾ ആമ്പോർട്ട് ചെയ്യുക.
-
താഴെപ്പറയുന്ന കോഡ് ടൈപ്പ് ചെയ്ത് ഇംപോർട്ട് ചേർക്കുക:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
മുകളിൽ
matplotlib,numpyആയും,sklearn-നിന്ന്datasets,linear_model,model_selectionആയും ആമ്പോർട്ട് ചെയ്യുന്നു.model_selectionഡാറ്റ പരിശീലന, ടെസ്റ്റ് സെറ്റുകളായി വിഭജിക്കാൻ ഉപയോഗിക്കുന്നു.
ഡയബറ്റീസ് dataset
ബിൽറ്റ്-ഇൻ ഡയബറ്റിസ് dataset ഡയബറ്റീസുമായി ബന്ധപ്പെട്ട 442 സാമ്പിളുകൾ ഉൾക്കൊള്ളുന്നു, 10 ഫീച്ചർ വേരിയബിളുകളോടുകൂടി, അവയിൽ ചിലത്:
- വയസ്സ്: വയസ്സ്
- bmi: ശരീരത്തിൽ കൃത്യമായ ഭാരം സൂചിപ്പിക്കുന്ന സൂചികയ്
- bp: ശരാശരി രക്തമാണം സമ്മർദ്ദം
- s1 tc: T-Cells (വൈറ്റ്ബ്ലഡ് സെല്ലുകൾ)
✅ ഈ dataset 'sex' എന്ന രണ്ട് വിഭാഗീയമായ ഫീച്ചർ വേരിയബിൾ ഉൾക്കൊള്ളുന്നു, ഡയബറ്റീസ് ഗവേഷണത്തിന് പ്രധാനമാണ്. പല മെഡിക്കൽ dataset-കളും ഇത്തരമൊരു ബൈനറി വർഗ്ഗീകരണം ഉൾക്കൊള്ളുന്നു. ഇത്തരത്തിലുള്ളവർഗ്ഗീകരണങ്ങൾ ജനസംഖ്യയുടെ ചില വിഭാഗങ്ങളെ ചികിത്സയിൽ നിന്ന് ഒഴിവാക്കിയേക്കാമെന്ന് ചിന്തിക്കുക.
ഇപ്പോൾ X, y ഡാറ്റ ലോഡ് ചെയ്യുക.
🎓 ഓർമ്മിക്കുക, ഇത് സൂപ്പർവൈസ്ഡ് ലേണിംഗ് ആണ്; ഉപറിയ്ക്കപ്പെടേണ്ട 'y' ലക്ഷ്യം വേണം.
പുതിയ കോഡ് സെല്ലിൽ load_diabetes() വിളിച്ച് ഡയബറ്റീസ് dataset ലോഡ് ചെയ്യുക. return_X_y=True എന്നത് X ഡാറ്റ മാട്രിക്സ് ആവും, y regression ടാർഗെറ്റ് ആവും എന്ന് സൂചിപ്പിക്കുന്നു.
-
ഡാറ്റ മാട്രിക്സിന്റെ ആകൃതി, അതിന്റെ ആദ്യഘടകം പ്രിന്റ് ചെയ്യാനുള്ള കോമാൻഡുകൾ ചേർക്കുക:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
നിങ്ങൾക്ക് ലഭിക്കുന്നത് ഒരു ട്യൂപ്പിൾ ആണ്. ട്യൂപ്പിലിന്റെ ആദ്യ രണ്ട് മൂല്യങ്ങൾ
Xക്കുംyക്കും അവ വെച്ചു ഇയക്കുന്നു. ട്യൂപ്പിൾ സംബന്ധിച്ച് കൂടുതൽ പഠിക്കൂ about tuples.ഈ ഡാറ്റയ്ക്ക് 442 ഐറ്റംസ് ഉണ്ട്, 10 ഘടകങ്ങളുള്ള അറേകൾ ആൽപ്പിച്ച.
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ ഡാറ്റയും regression ടാർഗറ്റും തമ്മിലുള്ള ബന്ധം കുറിച്ച് ചിന്തിക്കുക. ലൈനിയർ റിഗ്രഷൻ X ഫീച്ചറിന്റെയും y ടാർഗറ്റിന്റെയും ഇടയിൽ ബന്ധം പ്രവചിക്കുന്നു. ഡയബറ്റീസ് dataset-ന്റെ target ഡോക്യുമെന്റേഷനിൽ പകരം കണ്ടുപിടിക്കാമോ? ആ ലക്ഷ്യം പരിഗണിച്ച് ഈ dataset എന്താണ് കാണിക്കുന്നത്?
-
ഇപ്പോഴത്തെ ഡാറ്റയുടെ ഒരു ഭാഗം പ്ലോട്ട് ചെയ്യാൻ, dataset-ന്റെ 3ആം കോളം തിരഞ്ഞെടുക്കുക. എല്ലാ പംക്തികളുമെടുത്ത് ':' ഓപ്പറേറ്റർ ഉപയോഗിച്ച്, 3ആം കോളം (index 2) തിരഞ്ഞെടുക്കാം.
reshape(n_rows, n_columns)ഉപയോഗിച്ച് ഡാറ്റ 2D അറേ ആയി മാറ്റാം - പ്ലോട്ടിങ്ങിന് ആവശ്യമാണ്. പാരാമീറ്ററുകളിൽ ഒന്നെങ്കിലും -1 ആണെങ്കിൽ, അതിന്റെ മൂലം സ്വയം കണക്കാക്കും.X = X[:, 2] X = X.reshape((-1,1))✅ സമയങ്ങളിൽ ഡാറ്റയുടെ ആകൃതി പരിശോധിക്കാൻ പ്രിന്റ് ചെയ്യുക.
-
ഡാറ്റ തയ്യാറായി ആയിരിക്കുന്നു, ഒരു മെഷീൻ പങ്കെടുക്കാനും ഈ dataset-ലെ സംഖ്യകളിൽ ലോഗിക്കൽ വിഭജനം കണ്ടെത്താനുമാകുമെന്നും നോക്കൂ. അതിന്, X (ഡാറ്റ) യും y (ടാർഗറ്റ്) യും ടെസ്റ്റ് - ട്രെയിൻ സെറ്റ് ആയി വിഭജിക്കണം. Scikit-learn അതിനായൊരു ലളിതമായ മാർഗം നൽകുന്നു; ടെസ്റ്റ് ഡാറ്റാ പങ്ക് ഒരു പോയിന്റിൽ വിഭജിയ്ക്കാം.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
ഇപ്പോൾ മോഡൽ ട്രെയിൻ ചെയ്യാൻ തയ്യാറായി! ലൈനിയർ റിഗ്രഷൻ മോഡൽ ലോഡ് ചെയ്ത് X, y ട്രെയിൻ സെറ്റുകളിൽ
model.fit()ഉപയോഗിച്ച് പരിശീലിപ്പിക്കുക:model = linear_model.LinearRegression() model.fit(X_train, y_train)✅ TensorFlow പോലുള്ള പല ML ലൈബ്രററികളിലും കാണുന്ന ഫംഗ്ഷൻ ആണ്
model.fit(). -
തുടർന്ന് ടെസ്റ്റ് ഡാറ്റ ഉപയോഗിച്ച് മേൽപ്രതീക്ഷണം സൃഷ്ടിക്കാനായി
predict()ഫംഗ്ഷൻ ഉപയോഗിക്കുക. ഇത് ഡാറ്റ ഗൃപ്പുകൾ മദ്ധ്യേ ലൈനു ചിത്രീകരിക്കാൻ ഉപയോഗിക്കുംy_pred = model.predict(X_test) -
ഇപ്പോൾ ഡാറ്റ പ്ലോട്ടിൽ പ്രദർശിപ്പിക്കാൻ സമയം. matplotlib ഈ കർമത്തിന് വളരെ പ്രയോജനകരമാണ്. X, y ടെസ്റ്റ് ഡാറ്റയുടെ സ്കാറ്റർ പ്ലോട്ട് സൃഷ്ടിക്കുക, prediction ഉപയോഗിച്ച് ഏറ്റവും അനുയോജ്യമായ സ്ഥലത്ത് മോഡലിന്റെ ഡാറ്റാ ഗ്രൂപ്പിങ് മദ്ധ്യേ ലൈനുകാണിക്കുക.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()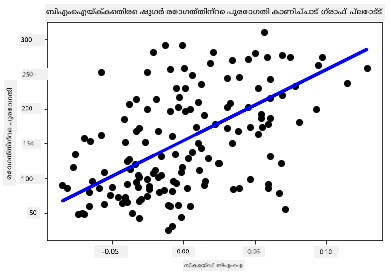
✅ ഇവിടെ നടക്കുന്ന കാര്യം കുറിച്ച് ചിന്തിക്കുക. ഒരു നേരിയ ലൈനാണ് അനേകം ചെറിയ ഡാറ്റാ പോയിന്റുകൾക്കിടയിലാണ്, പക്ഷേ അതർത്ഥം എന്താണ്? ഈ ലൈനുപയോഗിച്ച് പുതിയ, കാണാത്ത ഡാറ്റ പോയിന്റ് പ്ലോട്ടിന്റെ y അക്ഷത്തോടുള്ള ബന്ധത്തിൽ എവിടേക്ക് ഒതുങ്ങുമെന്നു പ്രവചിക്കാം എന്നതു കാണുന്നുണ്ടോ? ഈ മോഡലിന്റെ പ്രായോഗിക ഉപയോഗം വാക്കുകളിൽ വെക്കാൻ ശ്രമിക്കുക.
അഭിനന്ദനങ്ങൾ, നിങ്ങൾ ആദ്യ ലൈനിയർ റിഗ്രഷൻ മോഡൽ സൃഷ്ടിച്ച്, അതുപയോഗിച്ച് പ്രവചനം സൃഷ്ടിച്ച് പ്ലോട്ടിൽ പ്രദർശിപ്പിച്ചു!
🚀ചലഞ്ച്
ഈ dataset-ൽ നിന്നൊരു വ്യത്യസ്ത വേരിയബിൾ പ്ലോട്ട് ചെയ്യുക. സൂചനം: ഈ വരി തിരുത്തുക: X = X[:,2]. ഈ ഡാറ്റാസെറ്റിന്റെ ടാർഗറ്റ് പരിഗണിച്ച്, ഡയബറ്റീസ് ഒരു രോഗമായി എങ്ങനെ പുരോഗമിക്കുന്നു എന്ന് നിങ്ങൾ കണ്ടെത്താൻ കഴിയുമോ?
പോസ്റ്റ്-ലെക്ചർ ക്വിസ്
റിവ്യൂ & സ്വയം പഠനം
ഈ ട്യൂട്ടോറിയലിൽ, നിങ്ങൾ സാധാരണ ലൈനിയർ റിഗ്രഷൻ ഉപയോഗിച്ചു, യൂണിവേരിയേറ്റ് അല്ലെങ്കിൽ മൾട്ടിപ്പിൾ ലൈനിയർ റിഗ്രഷൻ അല്ല. ഈ മേധോഡുകൾ തമ്മിലുള്ള വ്യത്യാസം കുറിച്ച് കുറച്ച് വായിക്കുക, അല്ലെങ്കിൽ ഈ വീഡിയോ കാണുക.
റഗ്രഷൻ എന്ന ആശയം കുറിച്ച് കൂടുതൽ വായിക്കുക, ഈ സാങ്കേതിക വിദ്യ ഉപയോഗിച്ച് എന്ത് തരത്തിലുള്ള ചോദ്യങ്ങൾക്ക് ഉത്തരം കണ്ടെത്താവുന്നതാണെന്ന് ആലോചിക്കുക. നിങ്ങളുടെ അറിവ് വർധിപ്പിക്കാൻ ഈ tutorial എടുത്തുക.
അസൈൻമെന്റ്
അറിയിപ്പ്: ഈ രേഖ AI പരിഭാഷാ സേവനം Co-op Translator ഉപയോഗിച്ച് പരിഭാഷപ്പെടുത്തിയതാണ്. ഞങ്ങൾ കൃത്യതയ്ക്കായി ശ്രമിക്കുന്നുവെങ്കിലും, ഓട്ടോമേറ്റഡ് പരിഭാഷകളിൽ പിഴവുകൾ അല്ലെങ്കിൽ തെറ്റായ വിവരങ്ങൾ ഉണ്ടാകാൻ സാധ്യതയുണ്ട്. അതിന്റെ സ്വാഭാവിക ഭാഷയിലുള്ള അസൽ രേഖയാണ് പ്രാമാണികമായ ഉറവിടമായി പരിഗണിക്കേണ്ടത്. നിർണായകമായ വിവരങ്ങൾക്ക്, പ്രൊഫഷണൽ മനുഷ്യ പരിഭാഷ ശുപാർശ ചെയ്യുന്നു. ഈ പരിഭാഷ ഉപയോഗിച്ച് ഉണ്ടാകുന്ന തെറ്റിദ്ധാരണകൾ അല്ലെങ്കിൽ തെറ്റായ വ്യാഖ്യാനങ്ങൾക്കായി ഞങ്ങൾ ഉത്തരവാദികളല്ല.