
16 KiB
Inizia con Python e Scikit-learn per modelli di regressione
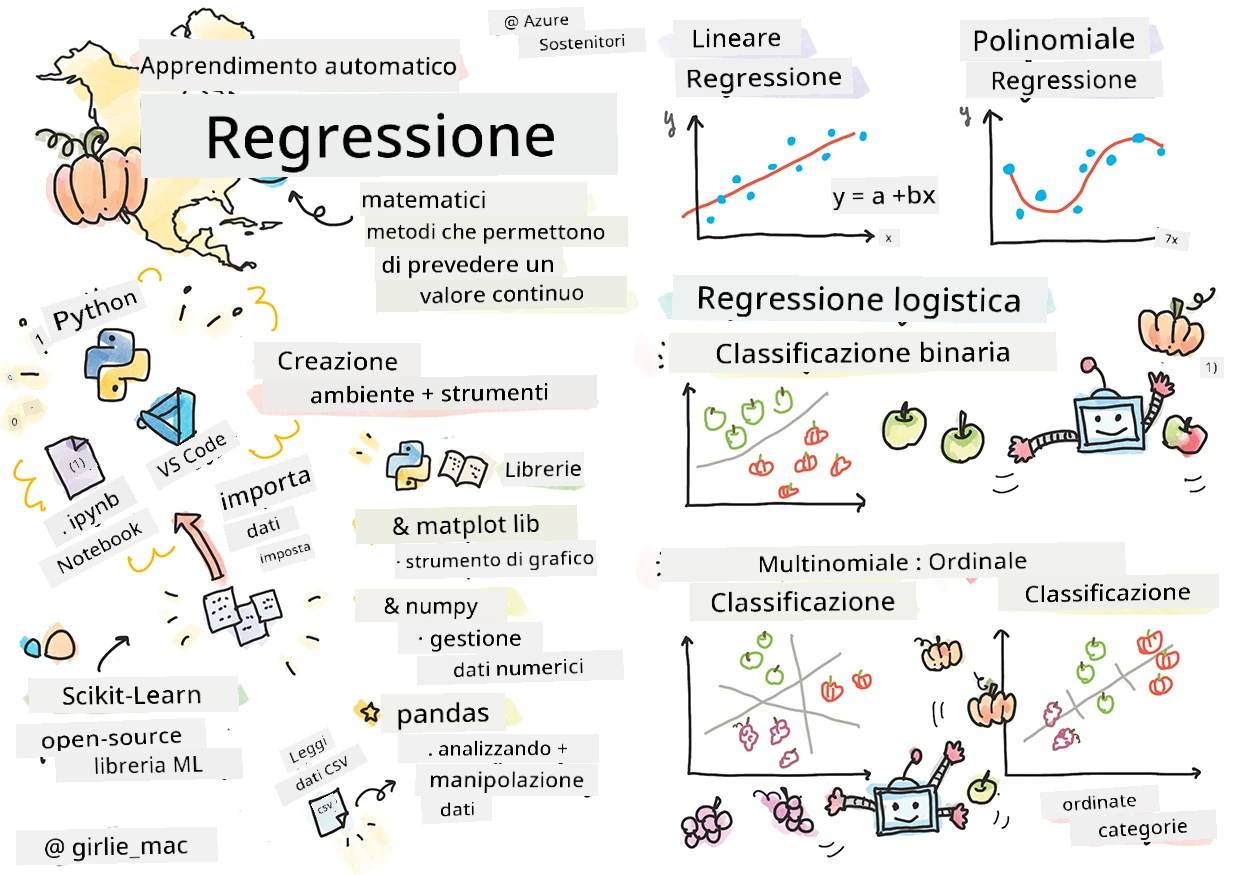
Sketchnote di Tomomi Imura
Quiz pre-lezione
Questa lezione è disponibile in R!
Introduzione
In queste quattro lezioni scoprirai come costruire modelli di regressione. Discuteremo a breve a cosa servono. Ma prima di fare qualsiasi cosa, assicurati di avere gli strumenti giusti per avviare il processo!
In questa lezione imparerai a:
- Configurare il tuo computer per attività di machine learning locali.
- Lavorare con Jupyter Notebooks.
- Usare Scikit-learn, inclusa l’installazione.
- Esplorare la regressione lineare con un esercizio pratico.
Installazioni e configurazioni

🎥 Clicca sull’immagine sopra per un breve video che illustra la configurazione del computer per ML.
-
Installa Python. Assicurati che Python sia installato sul tuo computer. Userai Python per molte attività di data science e machine learning. La maggior parte dei sistemi informatici include già un’installazione di Python. Sono disponibili anche utili pacchetti di codice Python per facilitare la configurazione a certi utenti.
Alcuni usi di Python, però, richiedono una versione del software, mentre altri una versione diversa. Per questo motivo, è utile lavorare all’interno di un ambiente virtuale.
-
Installa Visual Studio Code. Assicurati di avere Visual Studio Code installato sul tuo computer. Segui queste istruzioni per installare Visual Studio Code per l’installazione base. Userai Python in Visual Studio Code in questo corso, quindi potresti voler approfondire come configurare Visual Studio Code per lo sviluppo Python.
Prendi confidenza con Python lavorando su questa raccolta di moduli Learn

🎥 Clicca sull’immagine sopra per un video: usare Python all’interno di VS Code.
-
Installa Scikit-learn, seguendo queste istruzioni. Dal momento che devi assicurarti di usare Python 3, si consiglia di utilizzare un ambiente virtuale. Nota, se stai installando questa libreria su un Mac M1, ci sono istruzioni speciali nella pagina linkata sopra.
-
Installa Jupyter Notebook. Dovrai installare il pacchetto Jupyter.
Il tuo ambiente di creazione ML
Userai notebook per sviluppare il codice Python e creare modelli di machine learning. Questo tipo di file è uno strumento comune per i data scientist, e si riconosce dal suffisso o estensione .ipynb.
I notebook sono un ambiente interattivo che permette allo sviluppatore sia di scrivere codice sia di aggiungere appunti e documentazione attorno al codice, il che è molto utile per progetti sperimentali o orientati alla ricerca.

🎥 Clicca sull’immagine sopra per un breve video che illustra questo esercizio.
Esercizio - lavora con un notebook
In questa cartella, troverai il file notebook.ipynb.
-
Apri notebook.ipynb in Visual Studio Code.
Verrà avviato un server Jupyter con Python 3+ attivo. Troverai aree del notebook che possono essere
run, sezioni di codice. Puoi eseguire un blocco di codice selezionando l’icona che sembra un pulsante di play. -
Seleziona l’icona
mde aggiungi un po’ di markdown, e il testo seguente # Benvenuto al tuo notebook.Poi, aggiungi un po’ di codice Python.
-
Digita print('hello notebook') nel blocco di codice.
-
Seleziona la freccia per eseguire il codice.
Dovresti vedere la stampa della seguente istruzione:
hello notebook
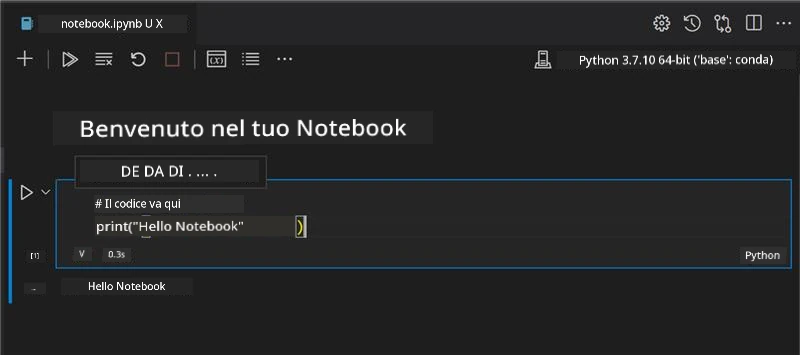
Puoi alternare il tuo codice con commenti per auto-documentare il notebook.
✅ Rifletti per un attimo su quanto sia diverso l’ambiente di lavoro di uno sviluppatore web rispetto a quello di un data scientist.
Avvio con Scikit-learn
Ora che Python è configurato nel tuo ambiente locale, e ti senti a tuo agio con Jupyter Notebooks, diventiamo altrettanto confortevoli con Scikit-learn (pronuncialo sci come in science). Scikit-learn offre un API esteso per aiutarti a svolgere compiti di ML.
Secondo il loro sito web, "Scikit-learn è una libreria open source di machine learning che supporta l’apprendimento supervisionato e non supervisionato. Fornisce anche vari strumenti per l’adattamento di modelli, la pre-elaborazione dei dati, la selezione e valutazione del modello, e molte altre utilità."
In questo corso userai Scikit-learn e altri strumenti per costruire modelli di machine learning per eseguire quello che chiamiamo compiti di 'machine learning tradizionale'. Abbiamo evitato deliberatamente le reti neurali e il deep learning, poiché saranno trattati meglio nel nostro prossimo curriculum 'AI for Beginners'.
Scikit-learn rende semplice costruire modelli e valutarli per l’uso. Si concentra principalmente sull’uso di dati numerici e contiene diversi dataset preconfezionati da usare come strumenti di apprendimento. Include anche modelli predefiniti che gli studenti possono provare. Esploriamo il processo di caricamento di dati preconfezionati e l’uso di uno stimatore integrato per creare il tuo primo modello ML con Scikit-learn e dati basilari.
Esercizio - il tuo primo notebook con Scikit-learn
Questo tutorial è ispirato all’esempio di regressione lineare sul sito di Scikit-learn.

🎥 Clicca sull’immagine sopra per un breve video che illustra questo esercizio.
Nel file notebook.ipynb associato a questa lezione, cancella tutte le celle premendo l’icona del 'cestino'.
In questa sezione lavorerai con un piccolo dataset sul diabete integrato in Scikit-learn a scopo didattico. Immagina di voler testare un trattamento per pazienti diabetici. Modelli di Machine Learning potrebbero aiutarti a determinare quali pazienti risponderebbero meglio al trattamento, basandosi su combinazioni di variabili. Anche un modello di regressione molto basilare, quando visualizzato, potrebbe mostrare informazioni sulle variabili che aiuterebbero a organizzare i tuoi studi clinici teorici.
✅ Esistono molti tipi di metodi di regressione, e quale scegli dipende dalla risposta che cerchi. Se vuoi prevedere l’altezza probabile di una persona a una certa età, useresti la regressione lineare, perché stai cercando un valore numerico. Se sei interessato a scoprire se un tipo di cucina debba essere considerata vegana o no, stai cercando un assegnamento di categoria quindi useresti la regressione logistica. Imparerai di più sulla regressione logistica più avanti. Rifletti un po’ su alcune domande che puoi porre ai dati, e quale di questi metodi sarebbe più appropriato.
Iniziamo questo compito.
Importa librerie
Per questo compito importeremo alcune librerie:
- matplotlib. È uno strumento di grafico utile e lo useremo per creare un grafico a linee.
- numpy. numpy è una libreria utile per gestire dati numerici in Python.
- sklearn. Questa è la libreria Scikit-learn.
Importa alcune librerie per aiutarti nei tuoi compiti.
-
Aggiungi importazioni digitando il seguente codice:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
Sopra stai importando
matplotlib,numpye stai importandodatasets,linear_modelemodel_selectiondasklearn.model_selectionè usato per dividere i dati in set di addestramento e test.
Il dataset diabete
Il dataset diabete integrato include 442 campioni di dati sul diabete, con 10 variabili di feature, alcune delle quali includono:
- età: età in anni
- bmi: indice di massa corporea
- bp: pressione sanguigna media
- s1 tc: cellule T (un tipo di globuli bianchi)
✅ Questo dataset include il concetto di 'sesso' come variabile di feature importante per la ricerca sul diabete. Molti dataset medici includono questo tipo di classificazione binaria. Rifletti un po’ su come categorizzazioni di questo tipo potrebbero escludere certe parti di una popolazione dai trattamenti.
Ora, carica i dati X e y.
🎓 Ricorda, questo è apprendimento supervisionato, e abbiamo bisogno di un target denominato 'y'.
In una nuova cella di codice, carica il dataset diabete chiamando load_diabetes(). L’input return_X_y=True segnala che X sarà una matrice di dati, e y sarà il target di regressione.
-
Aggiungi alcuni comandi print per mostrare la forma della matrice dati e il suo primo elemento:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Ciò che ottieni come risposta è una tupla. Quello che stai facendo è assegnare i due primi valori della tupla rispettivamente a
Xey. Scopri di più sulle tuple.Puoi vedere che questo dato ha 442 elementi formattati in array da 10 elementi ciascuno:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Rifletti un po’ sulla relazione tra i dati e il target di regressione. La regressione lineare predice le relazioni tra la feature X e la variabile target y. Riesci a trovare il target per il dataset diabete nella documentazione? Cosa dimostra questo dataset, dato quel target?
-
Successivamente, seleziona una porzione di questo dataset da plottare scegliendo la terza colonna del dataset. Puoi farlo usando l’operatore
:per selezionare tutte le righe, e poi la terza colonna usando l’indice (2). Puoi anche rimodellare i dati per ottenere un array 2D - come richiesto per il plotting - usandoreshape(n_rows, n_columns). Se uno dei parametri è -1, la dimensione corrispondente viene calcolata automaticamente.X = X[:, 2] X = X.reshape((-1,1))✅ In qualsiasi momento, stampa i dati per controllare la loro forma.
-
Ora che hai dati pronti per il plot, puoi verificare se una macchina può aiutare a determinare una suddivisione logica tra i numeri in questo dataset. Per fare ciò, devi dividere sia i dati (X) sia il target (y) in set di test e di addestramento. Scikit-learn ha un modo facile per farlo; puoi dividere i dati di test in un punto dato.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Ora sei pronto per addestrare il tuo modello! Carica il modello di regressione lineare e addestralo con i tuoi set di addestramento X e y usando
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()è una funzione che vedrai in molte librerie di ML come TensorFlow -
Poi, crea una previsione usando i dati di test, con la funzione
predict(). Verrà usata per disegnare la linea tra i gruppi di datiy_pred = model.predict(X_test) -
Ora è il momento di mostrare i dati in un grafico. Matplotlib è uno strumento molto utile per questo compito. Crea uno scatterplot di tutti i dati di test X e y, e usa la previsione per disegnare una linea nel punto più appropriato, tra i raggruppamenti di dati del modello.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()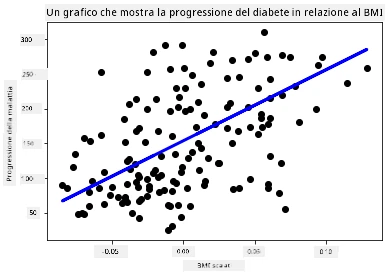
✅ Rifletti un po’ su cosa sta succedendo qui. Una linea retta attraversa molti piccoli punti dati, ma cosa sta facendo esattamente? Riesci a vedere come dovresti poter usare questa linea per prevedere dove un nuovo punto dati non visto dovrebbe inserirsì in relazione all’asse y del plot? Cerca di mettere in parole l’uso pratico di questo modello.
Congratulazioni, hai costruito il tuo primo modello di regressione lineare, creato una previsione con esso, e mostrato tutto in un grafico!
🚀Sfida
Traccia una variabile diversa da questo dataset. Suggerimento: modifica questa riga: X = X[:,2]. Dato il target di questo dataset, cosa riesci a scoprire sulla progressione del diabete come malattia?
Quiz post-lezione
Revisione & Autoapprendimento
In questo tutorial hai lavorato con regressione lineare semplice, piuttosto che regressione lineare univariata o multipla. Leggi un po’ sulle differenze tra questi metodi, o dai un’occhiata a questo video
Leggi di più sul concetto di regressione e rifletti su che tipo di domande possono essere risposte da questa tecnica. Segui questo tutorial per approfondire la tua comprensione.
Compito
Disclaimer: Questo documento è stato tradotto utilizzando il servizio di traduzione AI Co-op Translator. Sebbene ci impegniamo per garantire la precisione, si prega di notare che le traduzioni automatizzate possono contenere errori o imprecisioni. Il documento originale nella sua lingua nativa deve essere considerato la fonte autorevole. Per informazioni critiche, si raccomanda una traduzione professionale effettuata da un essere umano. Non siamo responsabili per eventuali malintesi o interpretazioni errate derivanti dall’uso di questa traduzione.