
27 KiB
Klasterləşdirmə bölməsinə giriş
Klasterləşdirmə, verilən data massivin etiketlənməmiş olduğunu ya da giriş dəyərlərinin öncədən müəyyən olunmuş çıxış dəyərləri ilə uyğunlaşdırılmış olmadığını fərz edən yönləndirilməyən öyrənmənin bir formasıdır. Klasterləşdirmə etiketlənməmiş datanı çeşidləmək və datada tapdığı təkrarlanan nümənələri təmin etmək üçün müxtəlif alqoritmlərdən istifadə edir.
🎥 Videoya keçid üçün yuxarıdakı təsvirə klikləyin. Maşın öyrənməsində klasterləşdirmə bölməsini öyrənərkən Dance Hall janrında olan Nigeriya treklərindən zövq alın - bu mahnı 2014-cü ilin bəyənilən mahnısı olub, P-Square adlı musiqi ikilisinə aiddir.
Mühazirədən əvvəl test
Giriş
Klasterləşdirmə datanın tədqiqi üçün çox faydalıdır. Gəlin bu üsulun Nigeriyalı auditoriyanın üstünlük verdiyi musiqidə tendensiyanı və təkrarlanan nümunələri kəşf etməyə kömək edə bilib bilməyəcəyinə baxaq.
✅ Bir az dayanıb klasterləşdirmənin hansı hallarda istifadə olunduğu haqqında düşünün. Real həyatda bir yığın camaşırdan ailə üzvlərinizin geyimlərini çeşidlədiyiniz zaman klasterləşdirmə etmiş olursunuz 🧦👕👖🩲. Data elmində klasterləşdirməyə nümunə olaraq istifadəçinin üstünlük verdiyi seçimləri analiz etməyi və ya etiketlənməmiş data massivin xarakteristikalarını müəyyən etməyi göstərmək olaraq. Klasterləşdirmə bir növ corab çəkməcəsi kimi qarmaqarışıqlığı anlamağa kömək edir.
🎥 Yuxarıdakı təsvirə toxunmaqla videoya baxın: John Guttag MIT-də klasterləşdirməni təqdim edir
Klasterləşdirmənin daha professional istifadəsinə bazar seqmentasiyasının müəyyən edilməsini, məsələn, hansı yaş qrupunun daha çox nələri aldığını müəyyən etməyi aid etmək olar. Bundan başqa, kredit kartı transaksiyalarının data massivində dələduzluq və bu kimi başqa anomaliyaların aşkarlanmasında klasterləşdirmə faydalı ola bilər. Həmçinin, tibbi təsvirlərdə bədxassəli şişlərin aşkar olunmasında da klasterləşdirməni istifadə etmək mümkündür.
✅ Bir az dayanıb real həyatda, bankçılıqda, elektron ticarətdə ya da biznes şəraitində klasterləşdirmənin istifadəsinə rast gəlmiş ola biləcəyiniz haqqında düşünün.
🎓 Maraqlıdır ki, klaster analizi 1930-cu illərdə Antropologiya və Psixologiya sahələrində meydana çıxmağa başlamışdır. Necə istifadə olunduğunu xəyalınızda canlandıra bilərsinizmi?
Alternativ olaraq, klasterləşdirmədən axtarış nəticələrini qruplaşdırmaq üçün istifadə edə bilərsiniz - məsələn, alış-veriş linkləri, şəkillər ya da rəylər ilə qruplaşdıraraq. Klasterləşdirmə böyük data massivi kiçiltmək və kiçildilmiş massivi detallı analiz etmək istədiyiniz zaman köməyə çatır, ona görə də bu üsul başqa modellər yaratmazdan öncə datanın tədqiqi üçün istifadə oluna bilər.
✅ Datanı klasterlərə yerləşdirdikdən sonra onlara klaster identifikator təyin olunur və bu üsul datanın məxfiliyini qorumaq üçün də istifadə oluna bilər; hər hansı bir verilənə aşkarlana və müəyyən edilə bilən data ilə istinad etməkdənsə klaster identifikator vasitəsilə istinad edə bilərsiniz. Sizcə, başqa hansı səbəblərə görə klasteri fərqləndirmək üçün klaster identifikator istifadə etmək klasterin digər elementlərini istifadə etməkdən üstün tutula bilər?
Bu öyrənmə modulunda klasterləşdirmə üsulları haqqında bildiklərinizi inkişaf etdirin
Klasterləşdirmə bölməsinə başlayırıq
Scikit-learn klasterləşdirməni icra etmək üçün müxtəlif üsullardan ibarət geniş spektr təklif edir. Seçəcəyiniz tip istifadə şərtlərindən asılı olacaq. Dokumentasiyaya əsasən, hər bir metodun müxtəlif faydaları var. Scikit-learn tərəfindən dəstəklənən metodlar və onların müvafiq istifadə ssenariləri aşağıdakı sadələşdirilmiş cədvəldə verilib:
| Method name | Use case |
|---|---|
| K-Means | general purpose, inductive |
| Affinity propagation | many, uneven clusters, inductive |
| Mean-shift | many, uneven clusters, inductive |
| Spectral clustering | few, even clusters, transductive |
| Ward hierarchical clustering | many, constrained clusters, transductive |
| Agglomerative clustering | many, constrained, non Euclidean distances, transductive |
| DBSCAN | non-flat geometry, uneven clusters, transductive |
| OPTICS | non-flat geometry, uneven clusters with variable density, transductive |
| Gaussian mixtures | flat geometry, inductive |
| BIRCH | large dataset with outliers, inductive |
🎓 Klasterləri necə yaratmağımız data nöqtələrini qruplara necə ayırdığımızla çox bağlıdır. Gəlin bəzi terminlərə baxaq:
Transduktiv nəticə, xüsusi test nümunələrinə uyğunlaşdırılan müşahidə edilən təlim nümunələrindən əldə edilir. İnduktiv nəticə yalnız sonra test nümunələrinə tətbiq edilən ümumi qaydalara uyğun gələn təlim nümunələrindən əldə edilir.
Nümunə: Təsəvvür edin ki, sizdə yalnız qismən etiketlənmiş data massiv var. Bəzi şeylər 'qeydlər', bəziləri 'cdlər' olaraq etiketlənmişdir, bəziləri isə boşdur. Öhdəliyiniz qalan hissəni də etiketləməkdir. Əgər induktiv yanaşmanı seçsəniz, modelinizə 'qeydləri' və 'cdləri' axtarmağı öyrədərdiniz və bu etiketləri etiketlənməmiş dataya tətbiq edərdiniz. Bu yanaşma əslində 'kaset' olan şeyləri təsnif etməkdə işə yaramayacaq. Digər tərəfdən transduktiv yanaşma isə bu naməlum məlumatları daha effektiv idarə edir, çünki o, oxşar elementləri birlikdə qruplaşdırmağı hədəfləyir və sonra hər bir qrupa etiket tətbiq edir. Bu halda, klasterlər 'dəyirmi musiqi əşyaları' və 'kvadrat musiqi əşyaları'nı əks etdirə bilər.
🎓 'Qeyri-Evklid' və 'Evklid' həndəsəsi
Riyazi terminlər olan qeyri-Evklid və Evklid həndəsəsi nöqtələr arasındakı məsafələrin 'Evklid' (Evklid) və ya 'qeyri-Evklid' (qeyri-Evklid) həndəsi üsullarla ölçülməsinə aiddir.
Bu kontekstdə 'düz' Evklid həndəsəsinə (hissələri 'müstəvi' həndəsə kimi də bilinir), 'düz olmayan' isə qeyri-Evklid həndəsəsinə aid edilir. Həndəsənin maşın öyrənməsi ilə nə əlaqəsi var? Riyaziyyatda kök salan iki sahə kimi, klasterlərdəki nöqtələr arasındakı məsafələri ölçmək üçün ümumi bir yol olmalıdır və bu, məlumatların xarakterindən asılı olaraq 'düz' və ya 'düz olmayan' şəkildə edilə bilər. Evklid məsafələr iki nöqtə arasındakı xəttin uzunluğu ilə ölçülür. Qeyri-Evklid məsafələr əyri vasitəsilə ölçülür. Əgər vizuallaşdırılmış data müstəvidə mövcud deyilsə, onun üçün xüsusi alqoritmdən istifadə etməli ola bilərsiniz.
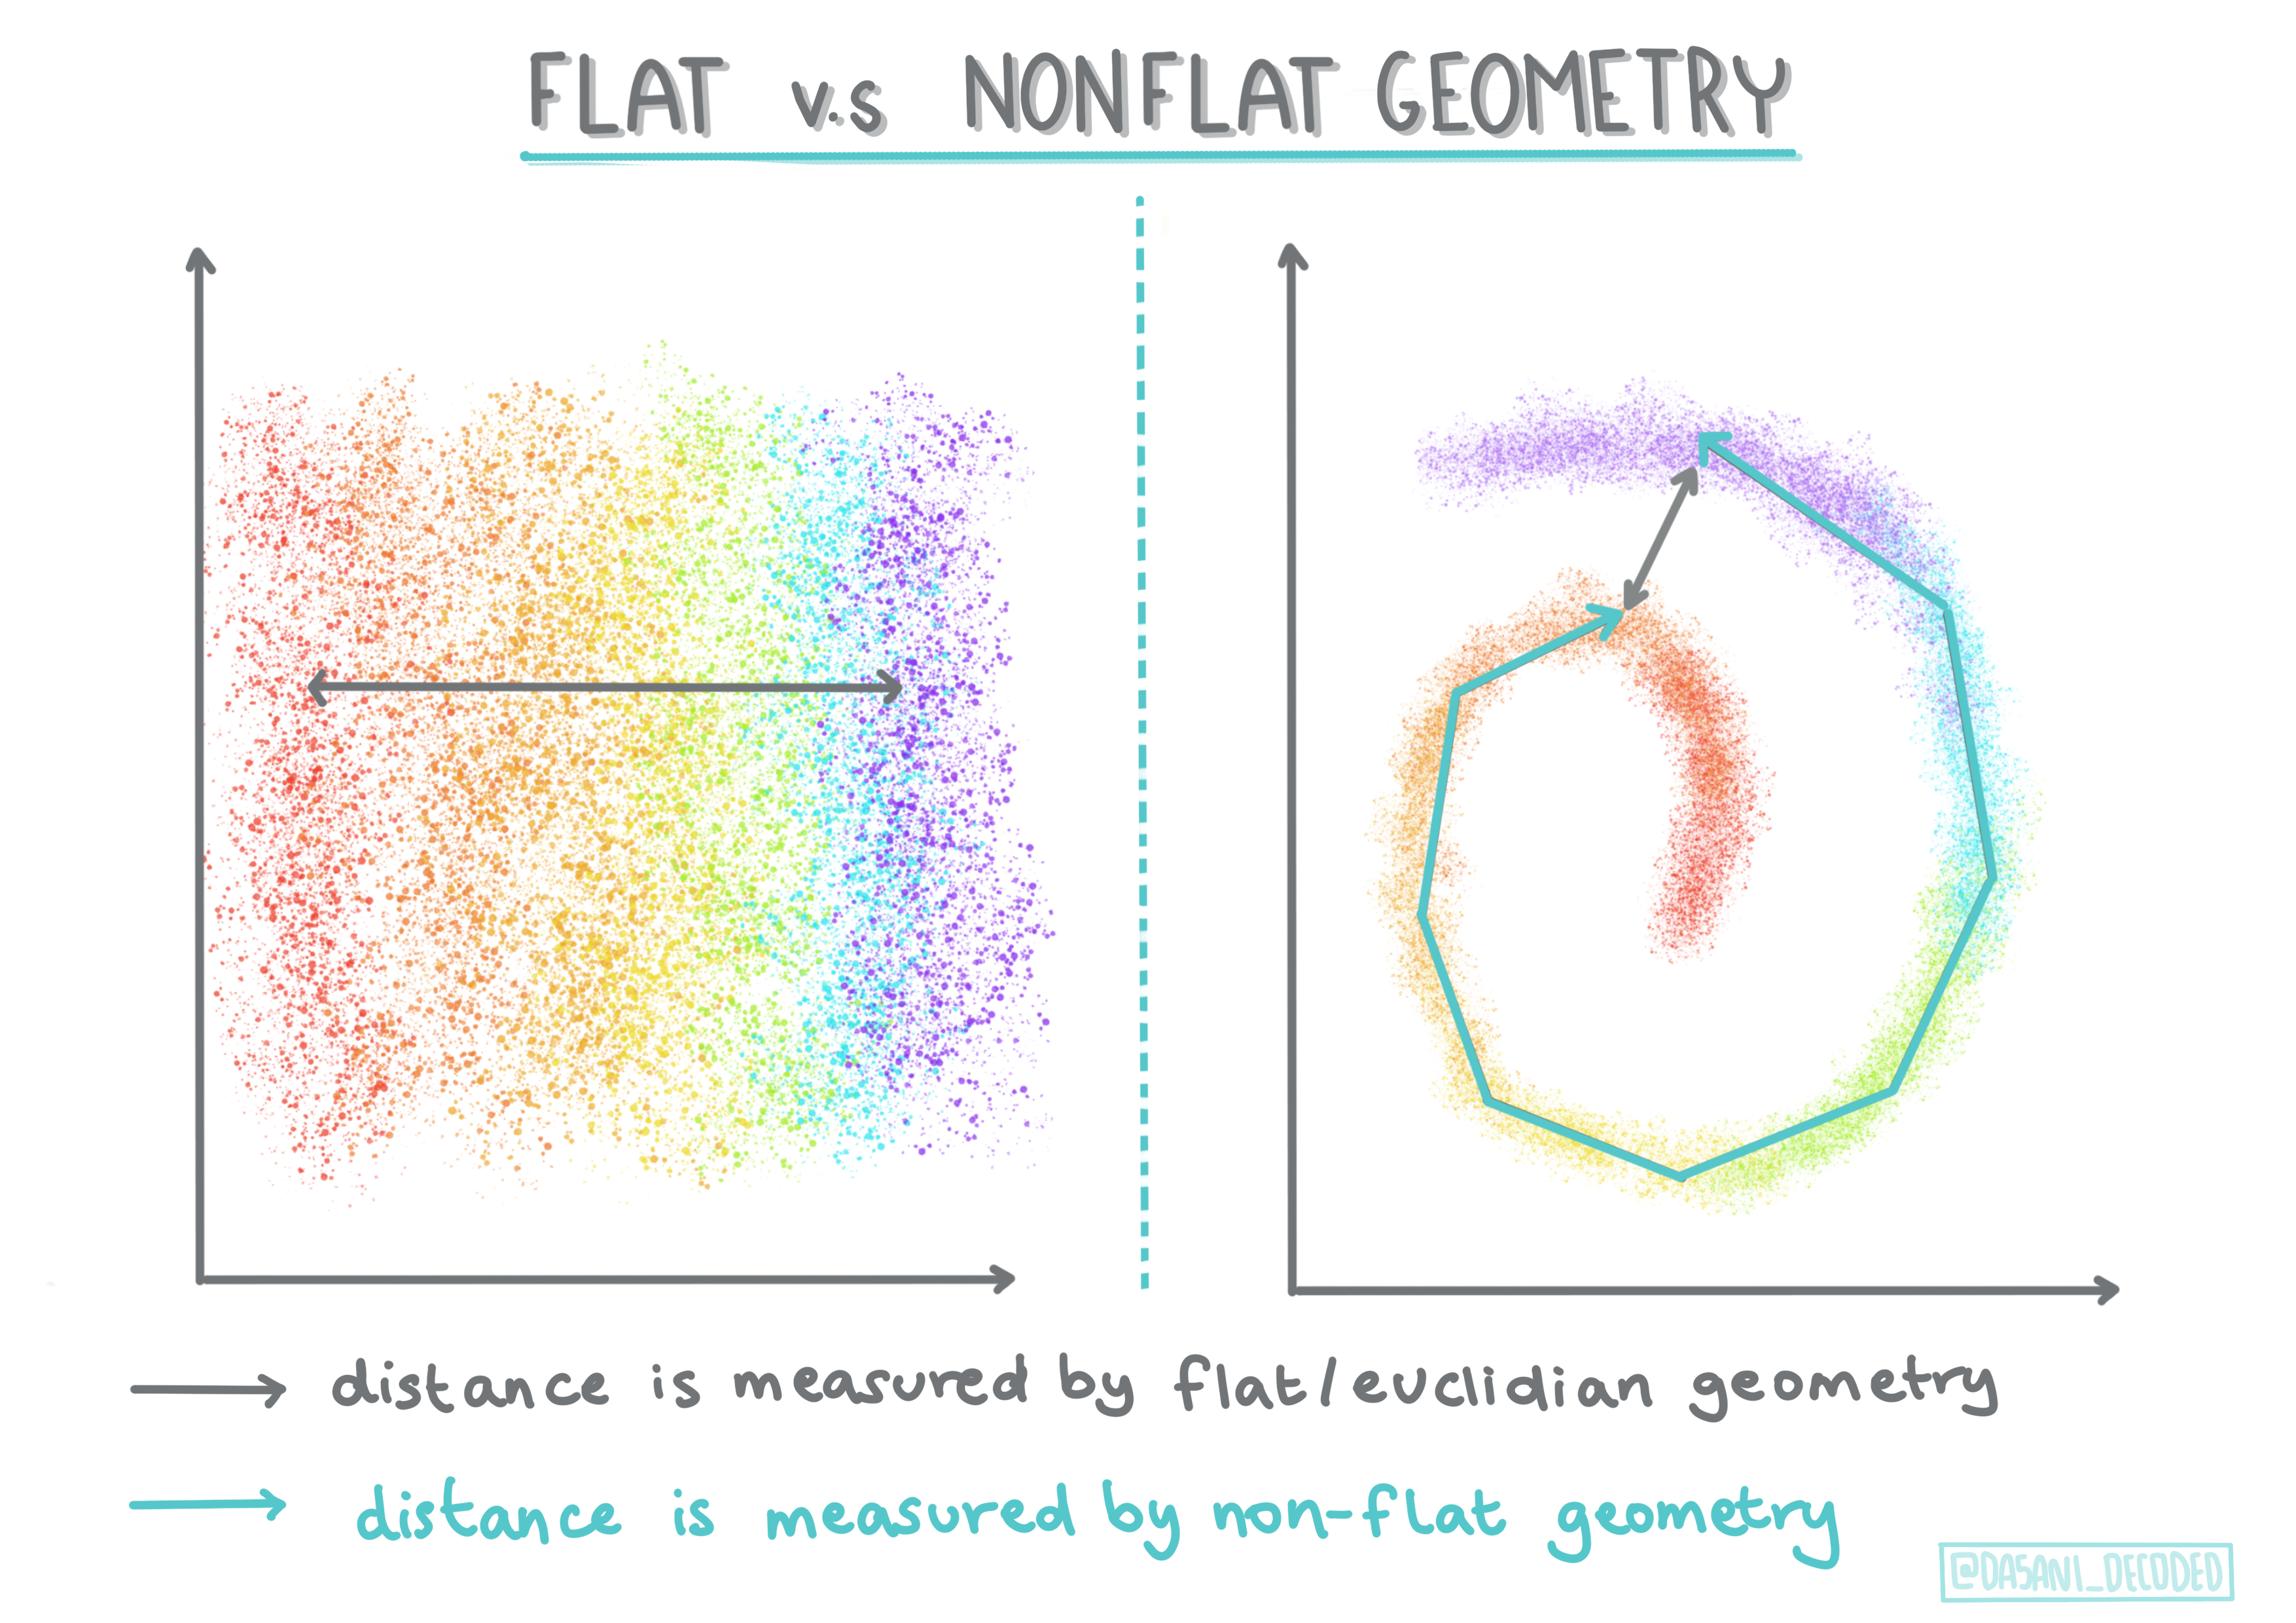
Dasani Madipalli tərəfindən təsvir
Klasterlər onların məsafə matrisi ilə müəyyən edilir, məs. nöqtələr arasındakı məsafələr. Bu məsafəni bir neçə yolla ölçmək olar. Evklid klasterləri nöqtə dəyərlərinin ortalaması ilə müəyyən edilir və onlara 'mərkəz' və ya mərkəz nöqtəsi daxildir. Beləliklə, məsafələr həmin mərkəzə olan məsafə ilə ölçülür. Qeyri-Evklid məsafələri digər nöqtələrə ən yaxın nöqtə olan 'klastroidlərə' aiddir. Klastroidlər öz növbəsində müxtəlif yollarla müəyyən oluna bilər.
Məhdudlaşdırılmış Klasterləşdirmə yönləndirilməmiş üsula 'qismən yönləndirilmiş' öyrənməni tətbiq edir. Nöqtələr arasındakı əlaqələr 'bağlana bilməz' və ya 'bağlanmalıdır' kimi işarələnir, buna görə də bəzi qaydalar data massivdə məcburi olaraq tətbiq olunur.
Nümunə: Əgər alqoritm etiketsiz və ya qismən etiketli verilənlər toplusunda sərbəst buraxılıbsa, onun yaratdığı klasterlər keyfiyyətsiz ola bilər. Yuxarıdakı nümunədə klasterlər 'dəyirmi musiqi əşyaları', 'kvadrat musiqi əşyaları', 'üçbucaqlı şeylər' və 'külçələri'i qruplaşdıra bilər. Bəzi məhdudiyyətlər və ya riayət edilməli qaydalar ('əşya plastikdən hazırlanmalıdır', 'əşya musiqi səsi çıxara bilməlidir') verilərsə, bu, daha yaxşı seçim etmək üçün alqoritmi 'məhdudlaşdırmağa' kömək edə bilər.
🎓 'Sıxlıq'
'Səs-küylü' olan data həmçinin 'sıx' hesab olunur. Belə klasterlərin hər birindəki nöqtələr arasındakı məsafələr yoxlama zamanı az və ya çox sıx və ya 'izdihamlı' ola bilər və buna görə də bu məlumatların müvafiq klasterləşdirmə metodu ilə təhlil edilməsi lazımdır. Bu məqalə qeyri-bərabər klaster sıxlığı ilə səs-küylü verilənlər toplusunu araşdırmaq üçün K-Ortalama klasterləşdirmə ilə HDBSCAN alqoritmlərindən istifadə arasındakı fərqi izah edir.
Klasterləşdirmə alqoritmləri
100-dən çox klasterləşdirmə alqoritmi mövcuddur və onlardan hansının hansı halda istifadə olunması verilən datanın təbiətindən asılıdır. Gəlin ən vacib olanlarının üzərindən keçək:
-
İyerarxik klasterləşdirmə. Əgər obyekt daha uzaqda olan obyektə deyil, yaxınlıqdakı obyektə yaxınlığına görə təsnif edilirsə, klasterlər onların üzvlərindən başqa obyektlərə və başqa obyektlərdən onlara məsafəsinə görə formalaşır. Scikit-learn-ün aqlomerativ klasterləşməsi iyerarxikdir.
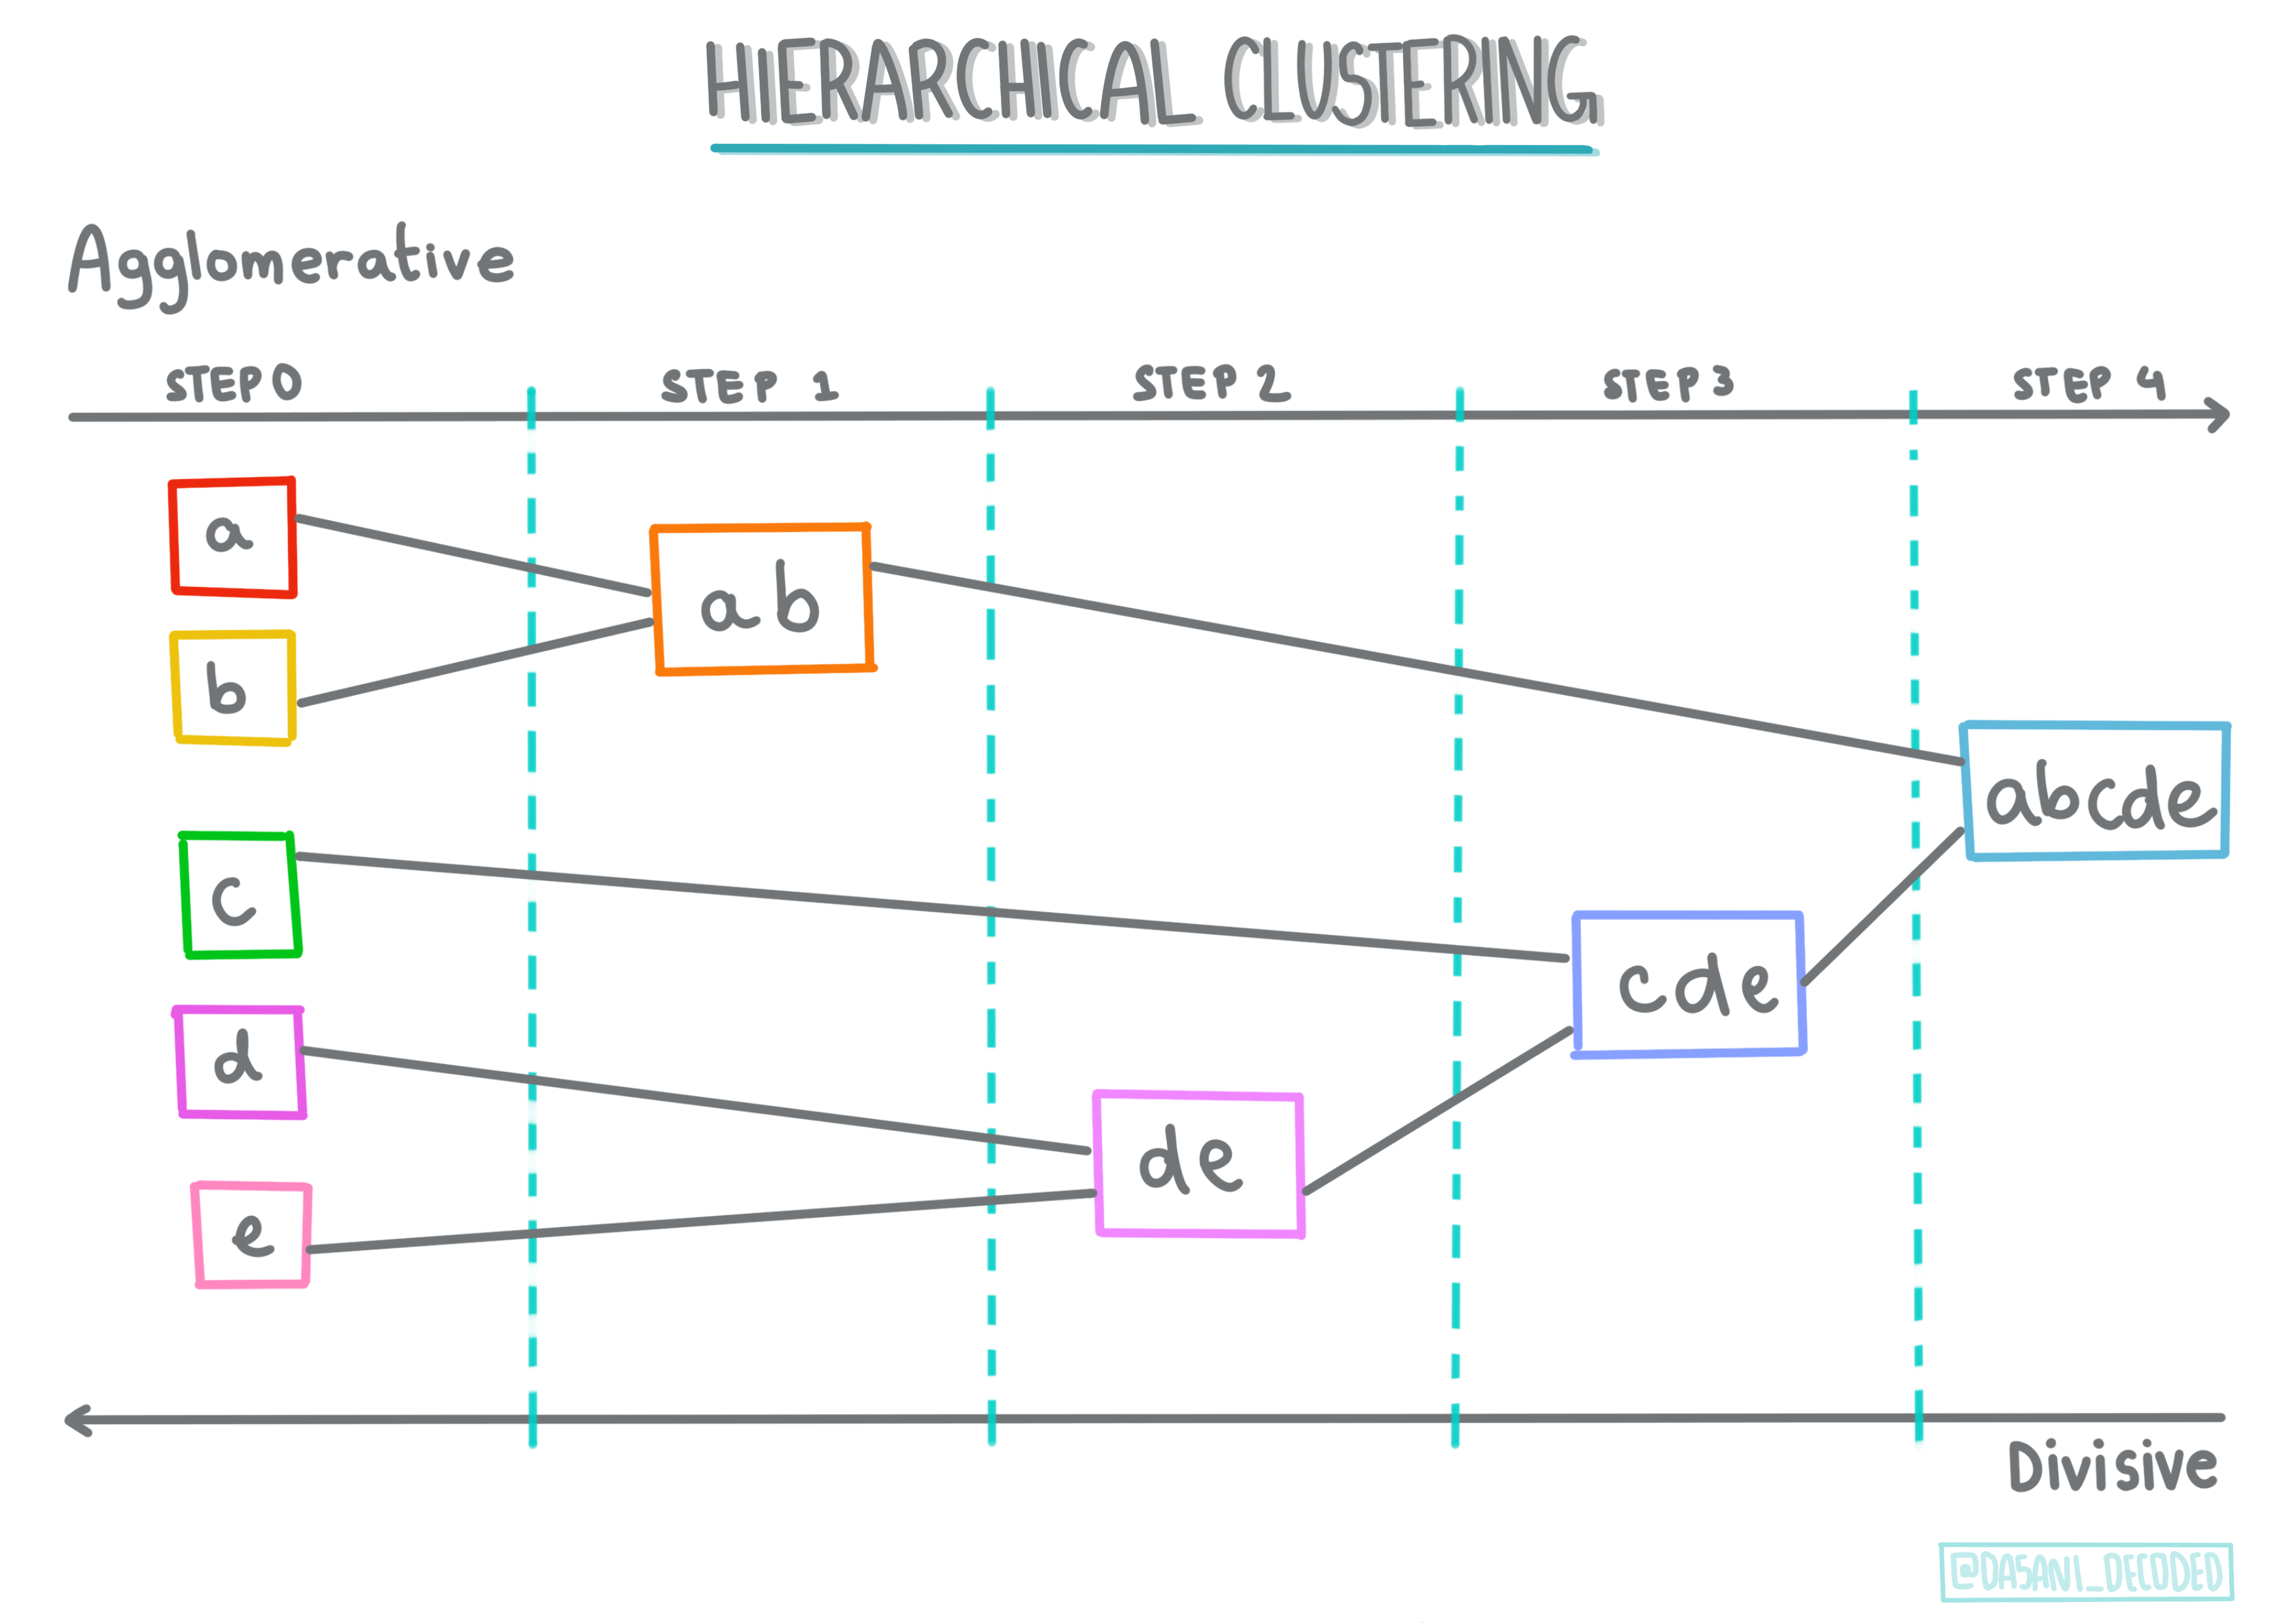
Dasani Madipalli tərəfindən təsvir
-
Mərkəzi klasterləşdirmə. Bu məşhur alqoritm 'k' seçimini və ya formalaşacaq klasterlərin sayını tələb edir, bundan sonra alqoritm klasterin mərkəz nöqtəsini təyin edir və həmin nöqtə ətrafında datanı toplayır. K-Ortalama klasterləşdirmə mərkəzi klasterləşdirmənin məşhur növüdür. Mərkəz ən yaxın orta ilə müəyyən edilir, adını da elə buradan götürmüşdür. Klasterdən kvadrat məsafə minimuma endirilir.
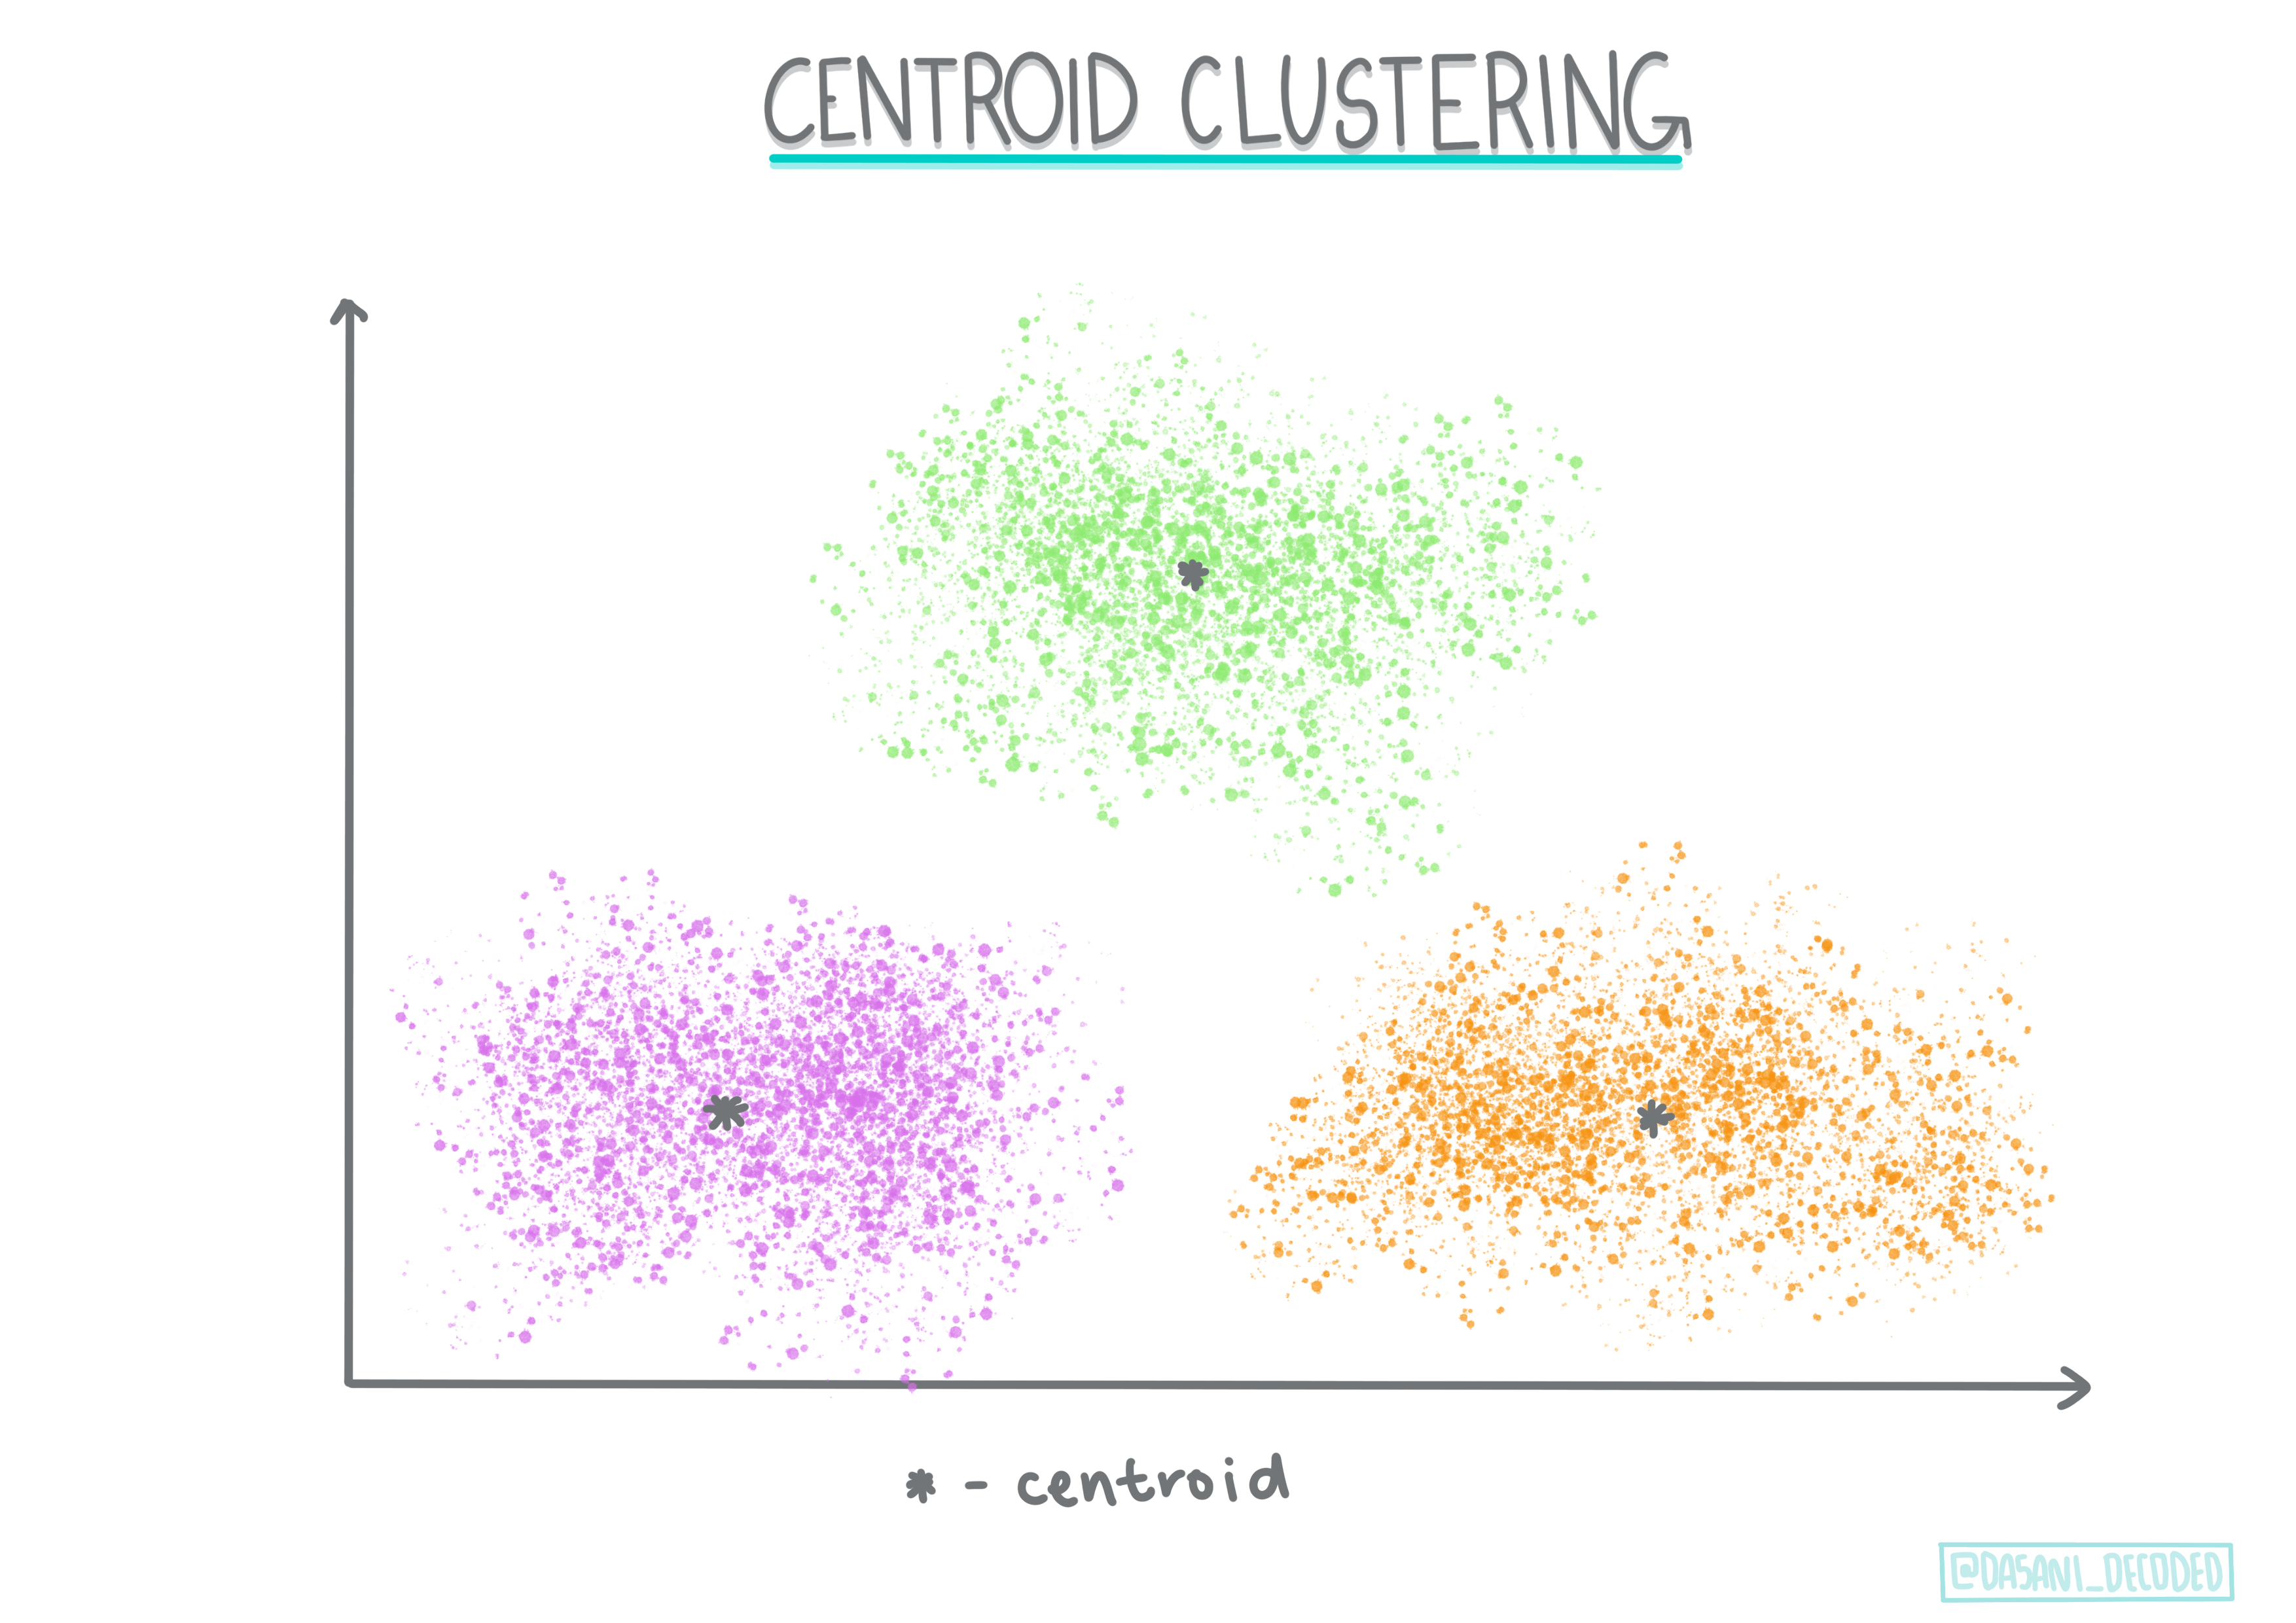
Dasani Madipalli tərəfindən təsvir
-
Paylanmaya əsaslanan klasterləşdirmə. Statistik modelləşdirməyə əsaslanaraq, paylama əsaslı klasterləşmə məlumat nöqtəsinin çoxluğa aid olma ehtimalını müəyyən etmək və müvafiq olaraq təyin etmək üçün mərkəzlər yaradır. 'Gaussian mixture' metodları bu tipə aiddir.
-
Sıxlığa əsaslanan klasterləşdirmə. Data nöqtələri sıxlığına və ya bir-birinin ətrafında qruplaşmasına görə klasterlərə təyin edilir. Qrupdan uzaq olan data nöqtələri kənar və ya səs-küy hesab olunur. 'DBSCAN', 'Mean-shift' və 'OPTICS' bu növ klasterləşdirməyə aiddir.
-
Şəbəkəyə əsaslanan klasterləşmə. Çoxölçülü verilənlər dəstləri üçün şəbəkə yaradılır və məlumatlar şəbəkənin hüceyrələri arasında bölünür və bununla da klasterlər yaradılır.
Tapşırıq - datanızı klasterləşdirin
Bir texnika olaraq klasterləşdirmə düzgün vizuallaşdırma olduqda çox daha dəqiq işləyir, ona görə də gəlin musiqi üçün olan datanı vizuallaşdırmaqla başlayaq. Bu tapşırıq datanın təbiətinə görə klasterləşdirmə üsullarından hansını istifadə etməyin daha səmərəli olduğunu qərar verməyə kömək edəcək.
-
Hazırkı qovluqda olan notebook.ipynb faylını açın.
-
Datanı vizuallaşdırmaq üçün
Seabornkomponentini əlavə edin.!pip install seaborn -
nigerian-songs.csv faylından mahnı datasını köçürün. Mahnılar haqqında məlumatlar olan datafreymi yükləyin. Kitabxanaları köçürərək və məlumatları silməklə bu datanı araşdırmağa hazır olun:
import matplotlib.pyplot as plt import pandas as pd df = pd.read_csv("../data/nigerian-songs.csv") df.head()Datanın bir hissəsinı nəzər salın:
name album artist artist_top_genre release_date length popularity danceability acousticness energy instrumentalness liveness loudness speechiness tempo time_signature 0 Sparky Mandy & The Jungle Cruel Santino alternative r&b 2019 144000 48 0.666 0.851 0.42 0.534 0.11 -6.699 0.0829 133.015 5 1 shuga rush EVERYTHING YOU HEARD IS TRUE Odunsi (The Engine) afropop 2020 89488 30 0.71 0.0822 0.683 0.000169 0.101 -5.64 0.36 129.993 3 2 LITT! LITT! AYLØ indie r&b 2018 207758 40 0.836 0.272 0.564 0.000537 0.11 -7.127 0.0424 130.005 4 3 Confident / Feeling Cool Enjoy Your Life Lady Donli nigerian pop 2019 175135 14 0.894 0.798 0.611 0.000187 0.0964 -4.961 0.113 111.087 4 4 wanted you rare. Odunsi (The Engine) afropop 2018 152049 25 0.702 0.116 0.833 0.91 0.348 -6.044 0.0447 105.115 4 -
info()metodunu çağıraraq datafreym haqqında məlumat əldə edin:df.info()Məlumat aşağıdakı kimi görünəcək:
<class 'pandas.core.frame.DataFrame'> RangeIndex: 530 entries, 0 to 529 Data columns (total 16 columns): # Column Non-Null Count Dtype --- ------ -------------- ----- 0 name 530 non-null object 1 album 530 non-null object 2 artist 530 non-null object 3 artist_top_genre 530 non-null object 4 release_date 530 non-null int64 5 length 530 non-null int64 6 popularity 530 non-null int64 7 danceability 530 non-null float64 8 acousticness 530 non-null float64 9 energy 530 non-null float64 10 instrumentalness 530 non-null float64 11 liveness 530 non-null float64 12 loudness 530 non-null float64 13 speechiness 530 non-null float64 14 tempo 530 non-null float64 15 time_signature 530 non-null int64 dtypes: float64(8), int64(4), object(4) memory usage: 66.4+ KB -
isnull()metodunu çağıraraq və cəmin 0 olmasını yoxlayaraq null dəyərlərin mövcud olub-olmadığını bir daha yoxlayın:df.isnull().sum()Looking good:
name 0 album 0 artist 0 artist_top_genre 0 release_date 0 length 0 popularity 0 danceability 0 acousticness 0 energy 0 instrumentalness 0 liveness 0 loudness 0 speechiness 0 tempo 0 time_signature 0 dtype: int64 -
Datanı təsvir edin:
df.describe()release_date length popularity danceability acousticness energy instrumentalness liveness loudness speechiness tempo time_signature count 530 530 530 530 530 530 530 530 530 530 530 530 mean 2015.390566 222298.1698 17.507547 0.741619 0.265412 0.760623 0.016305 0.147308 -4.953011 0.130748 116.487864 3.986792 std 3.131688 39696.82226 18.992212 0.117522 0.208342 0.148533 0.090321 0.123588 2.464186 0.092939 23.518601 0.333701 min 1998 89488 0 0.255 0.000665 0.111 0 0.0283 -19.362 0.0278 61.695 3 25% 2014 199305 0 0.681 0.089525 0.669 0 0.07565 -6.29875 0.0591 102.96125 4 50% 2016 218509 13 0.761 0.2205 0.7845 0.000004 0.1035 -4.5585 0.09795 112.7145 4 75% 2017 242098.5 31 0.8295 0.403 0.87575 0.000234 0.164 -3.331 0.177 125.03925 4 max 2020 511738 73 0.966 0.954 0.995 0.91 0.811 0.582 0.514 206.007 5
🤔 Əgər yönləndirilməyən öyrənmənin bir forması olan və datanın etiketlənmiş olmağını tələb etməyən klasterləşdirmə üsulundan istifadə ediriksə, niyə bu datanı etiketlərlə göstəririk? Etiketlər datanın tədqiqi mərhələsində köməyə çatsa da, klasterləşdirmə alqoritmlərinin işləyə bilməsi üçün vacib deyil. Belə ki, sütunların başlıqlarını silə və dataya sütunun nömrəsi ilə istinad edə bilərsiniz.
Datanın daha ümumi dəyərlərini nəzərdən keçirin. Note that popularity can be '0', which show songs that have no ranking. Let's remove those shortly.
-
Ən məşhur janrları tapmaq üçün zolaqlı diaqramdan istifadə edin:
import seaborn as sns

top = df['artist_top_genre'].value_counts()
plt.figure(figsize=(10,7))
sns.barplot(x=top[:5].index,y=top[:5].values)
plt.xticks(rotation=45)
plt.title('Top genres',color = 'blue')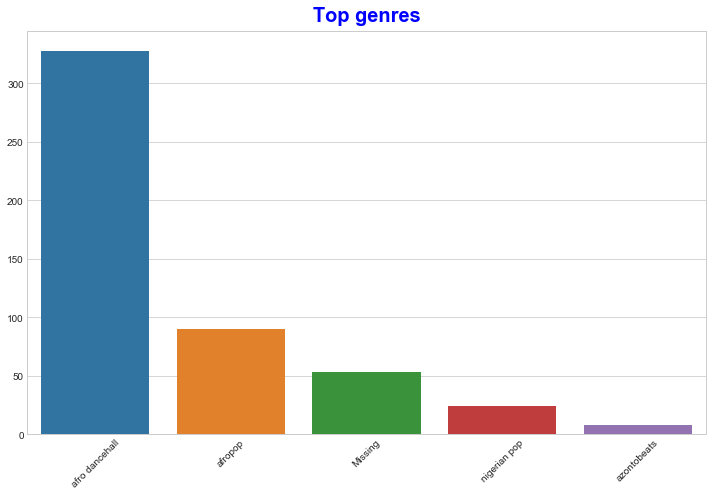
✅ Daha çox üstünlük təşkil edən dəyərləri görmək üçün yuxarıdakı [:5] daha böyük dəyər ilə dəyişdirilməlidir və ya hamısını görmək üçün silinməlidir.
Nəzərə alın ki, əgər ən yaxşı janr "itkin" kimi təsvir olunubsa, bu o deməkdir ki, Spotify onu təsnif etməyib, ona görə də bu məlumatları filtrdən keçirmək lazımdır.
-
Çatışmayan məlumatları filtrdən keçirin
df = df[df['artist_top_genre'] != 'Missing'] top = df['artist_top_genre'].value_counts() plt.figure(figsize=(10,7)) sns.barplot(x=top.index,y=top.values) plt.xticks(rotation=45) plt.title('Top genres',color = 'blue')Janrları yenidən gözdən keçirin:
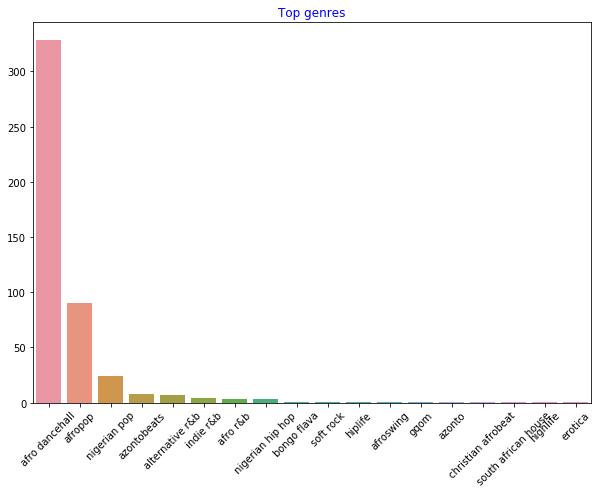
-
İndiyə qədər bu verilənlər bazasında ilk üç janr üstünlük təşkil edir. Gəlin diqqəti “afro dancehall”, “afropop” və “nigerian pop” üzərində cəmləşdirək, əlavə olaraq 0 populyarlıq dəyəri olan hər hansı bir şeyi silmək üçün verilənlər toplusunu süzgəcdən keçirək (bu o deməkdir ki, data populyarlıqla təsnif olunmayıb və tapşırıq üçün səs-küy hesab edilə bilər):
df = df[(df['artist_top_genre'] == 'afro dancehall') | (df['artist_top_genre'] == 'afropop') | (df['artist_top_genre'] == 'nigerian pop')] df = df[(df['popularity'] > 0)] top = df['artist_top_genre'].value_counts() plt.figure(figsize=(10,7)) sns.barplot(x=top.index,y=top.values) plt.xticks(rotation=45) plt.title('Top genres',color = 'blue') -
Verilənlərin hər hansı birinin güclü şəkildə korrelyasiya olub-olmadığını test edin:
corrmat = df.corr()
f, ax = plt.subplots(figsize=(12, 9))
sns.heatmap(corrmat, vmax=.8, square=True)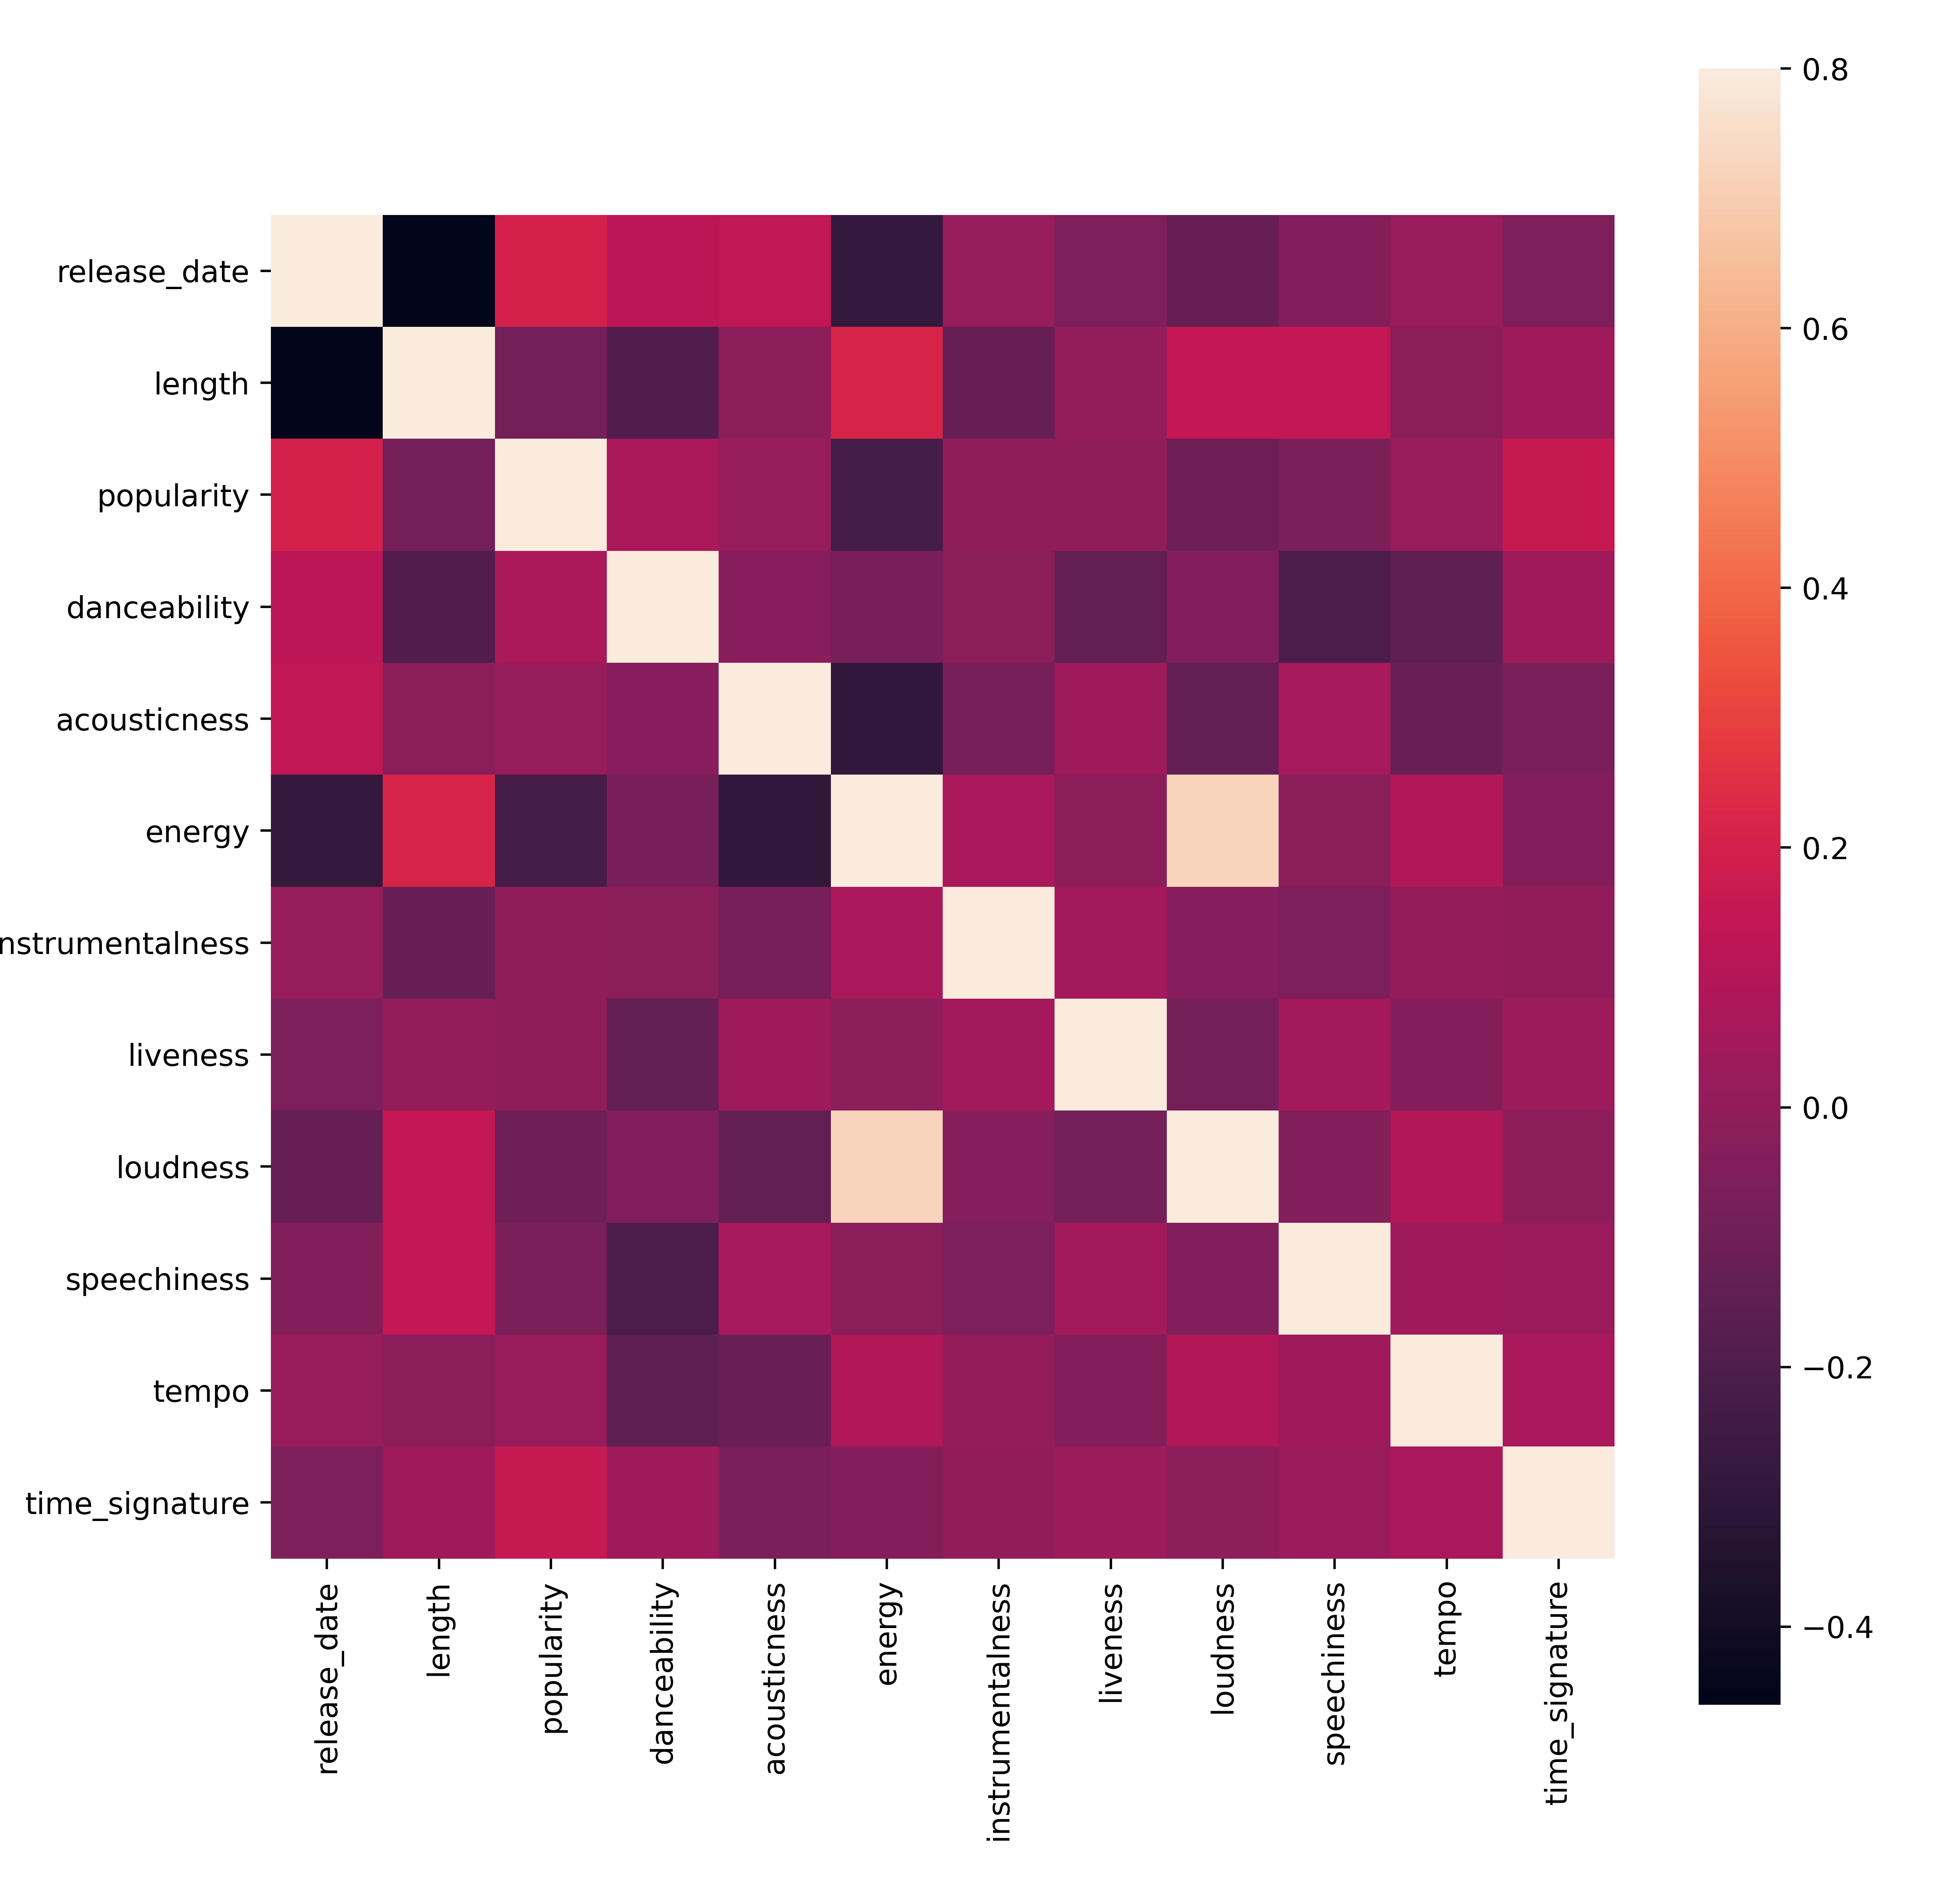
Yeganə güclü əlaqə 'enerji' və 'səs' arasındadır; yüksək səsli musiqinin adətən olduqca enerjili olduğunu nəzərə alsaq, bu çox da təəccüblü deyil. Əks halda, korrelyasiya nisbətən zəifdir. Bir klaster alqoritminin bu məlumatlardan hansı nəticəyə gələ biləcəyini görmək maraqlı olacaq.
🎓 Yadda saxlayın ki, korrelyasiya səbəb-nəticəni nəzərdə tutmur! Korrelyasiya üçün sübut var, lakin səbəb-nəticə üçün sübut yoxdur. Bu əyləncəli veb saytda sözü gedən məqamı vurğulayan bəzi vizuallar var.
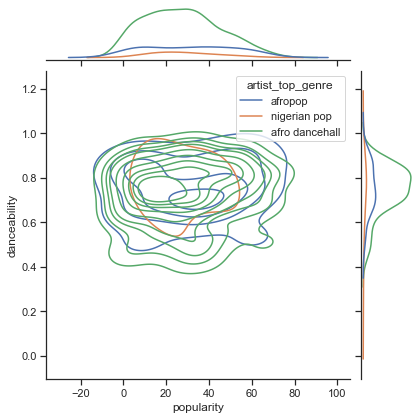
Bu data massivdə mahnının qəbul edilən populyarlığı və oynaqlığı ətrafında hər hansı uyğunluq varmı? FacetGrid göstərir ki, janrdan asılı olmayaraq sıralanan konsentrik dairələr var. Bunun səbəbi Nigeriyalı auditoriyanın zövqlərinin bu janr üçün müəyyən bir oynaqlıq dərəcəsində birləşməsi ola bilərmi?
✅ Fərqli məlumat nöqtələrini (enerji, yüksəklik, nitq) və daha çox və ya fərqli musiqi janrlarını sınayın. Nə kəşf edə bilərsiniz? Məlumat nöqtələrinin ümumi yayılmasını görmək üçün df.describe() cədvəlinə nəzər salın.
Tapşırıq - datanın paylanması
Bu üç janr populyarlıqlarına görə onların oynaqlıq dərəcəsini dərk etmək baxımından əhəmiyyətli dərəcədə fərqlənirmi?
-
Verilən x və y oxu boyunca populyarlıq və oynaqlıq dərəcəsi üzrə ilk üç janr üçün datanın paylanmasını nəzərdən keçirin.
sns.set_theme(style="ticks")

g = sns.jointplot(
    data=df,
    x="popularity", y="danceability", hue="artist_top_genre",
    kind="kde",
)
Nöqtələrin paylanmasını göstərən və ümumi yaxınlaşma nöqtəsi ətrafında olan konsentrik çevrələri görə bilərsiniz.
🎓 Nəzərə alın ki, bu nümunədə davamlı ehtimal sıxlığı əyrisindən istifadə edərək datanı əks etdirən KDE (Kernel Density Estimate) qrafikindən istifadə olunur. Bu, birdən çox paylamalarla işləyərkən datanı şərh etməyə imkan verir.
Ümumilikdə, bu üç janr populyarlıq və oynaqlıq dərəcəsi baxımından biraz sərbəst şəkildə uyğunlaşır. Belə sərbəst uyğunlaşan datada klasterləri müəyyən etmək çətin olacaq:
-
Səpələnmə qrafiki yaradın:
sns.FacetGrid(df, hue="artist_top_genre", size=5) \
   .map(plt.scatter, "popularity", "danceability") \
   .add_legend()
Eyni oxların səpələnmə qrafiki onların yaxınlaşma modeli ilə oxşarlıq təşkil edir
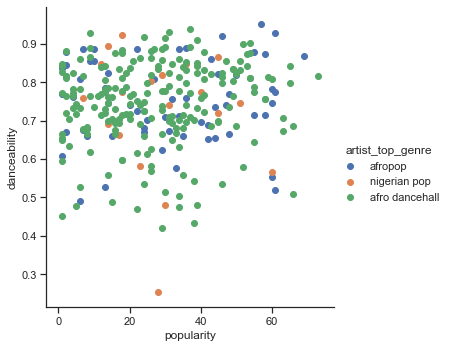
Ümumiyyətlə, datada olan klasterləri müəyyən etmək üçün səpələnmə qrafiklərindən istifadə edə bilərsiniz. Ona görə də bu növ vizuallaşdırmanın mənimsənilməsi çox faydalıdır. Növbəti dərsdə K-Ortalama klasterləşdirməni bu filtrdən keçmiş data üzərində tətbiq edərək datada olan qrupları və onların maraqlı şəkildə üst-üstə düşməsini müşahidə edəcəyik.
🚀Məşğələ
Növbəti dərsə hazırlıq üçün indiyə qədər haqqında öyrənmiş olduğunuz müxtəlif klasterləşdirmə alqoritmlərinin olduğu bir qrafik hazırlayın və onları real mühitdə istifadə edin. Klasterləşdirmə hansı qrup problemləri həll etməyə çalışır?
Mühazirə sonrası quiz
Təkrarlayın və özünüz öyrənin
Öyrəndiyimiz kimi, klasterləşdirmə alqoritmlərini tətbiq etməzdən əvvəl yaxşı olar ki, əlinizdə olan data massivin təbiətini başa düşəsiniz. Bu mövzu haqqında daha ətraflı bu keçidə klikləyərək oxuyun.
Bu faydalı məqalədə göstərilir ki, müxtəlif klasterləşdirmə alqoritmləri fərqli cür formalaşmış data üçün tətbiq edildikdə fərqli nəticələr verə bilir.