
23 KiB
Kateqoriyaları təxmin etmək üçün logistik reqressiya

Mühazirə öncəsi quiz
Bu dərs R proqramlaşdırma dili ilə də mövcuddur!
Giriş
Reqressiyanın bu final hissəsində, klassik maşın öyrənmə texnikası olan Xətti Reqressiyaya nəzər salacayıq. Bu texnikadan ikili kateqoriyalardakı şablonları kəşf etmək üçün istifadə edə bilərsiniz. Bu qənnadı məmulatı şokoladdırmı? Bu xəstəlik yoluxucudurmu? Müştəri bu məhsulu seçəcəkmi?
Bu dərsdə siz:
- Məlumatların vizuallaşdırılması üçün yeni kitabxananı
- Logistik reqressiya texnikalarını
öyrənəcəksiniz.
✅ Bu öyrənmə modulunda olan reqressiya tipləri ilə işləyərək öz biliklərinizi təkmilləşdirin.
İlkin Şərt
Balqabaq məlumatları ilə işlədikdən sonra artıq tanış olduq ki, onunla işləyə biləcəyimiz yalnız bir ədəd ikili kateqoriya-Color mövcuddur.
Gəlin bir neçə dəyişən verilməklə balqabağın hansı rəngdə(narıncı 🎃 və ya ağ 👻) olacağını təxmin edən logistik reqressiya modeli quraq.
Reqressiya barəsində olan dərsdə nə üçün ikili klassifikasiya haqqında danışırıq? Logistik reqressiya əslində, xətti əsaslı olsa da bir klassifikasiya metodudur. Növbəti bölmədə məlumatları təsnifləndirməyin yollarını öyrənəcəksiniz.
Sualı müəyyənləşdirin
İstəklərimiz üzərindən gedərək bunu ikili formasında ifadə edəcəyik: 'Ağ' və ya 'Ağ olmayan'. Data dəstimizdə "zolaqlı" kateqoriya olsa da, bu tip bir neçə nümunə olduğu üçün, ondan istifadə etməyəcəyik. Hər bir halda, data dəstimizdən boş dəyərləri sildikdən sonra yox olacaqlar.
🎃 Maraqlı fakt. Bəzən ağ balqabaqlara 'ruh' balqabaqlar da deyirlər. Onları çərtmək o qədər də asan olmadığı üçün, narıncı balqabaqlar qədər məşhur deyillər. Amma çox gözəl görünürlər! Ona görə də biz sualımızı bir balaca yenidən formalaşdıra bilərik: 'Ruh olan' or 'Ruh olmayan'. 👻
Logistik reqressiya haqqında
Logistik reqressiya, keçən dərslərdə haqqında öyrəndiyiniz xətti reqressiyadan bir neçə vacib yolla fərqlənir.

🎥 Logistik reqressiyanın qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
İkili klassifikasiya
Logistik reqressiya, xətti reqressiyanın təklif etdiyi özəllikləri təklif etmir. Biri ikili kateqoriya("narıncı olan və ya olmayan") haqqında təxminlər irəli sürsə də, digəri balqabağın mənşəyi və yığılma vaxtını nəzərə alsaq, qiymətinin nə qədər yüksələcəyi tipli davamedici dəyərləri təxmin etmək potensialındadır.

Dasani Madipalli tərəfindən çəkilmiş infoqrafik
Digər klassifikasiya
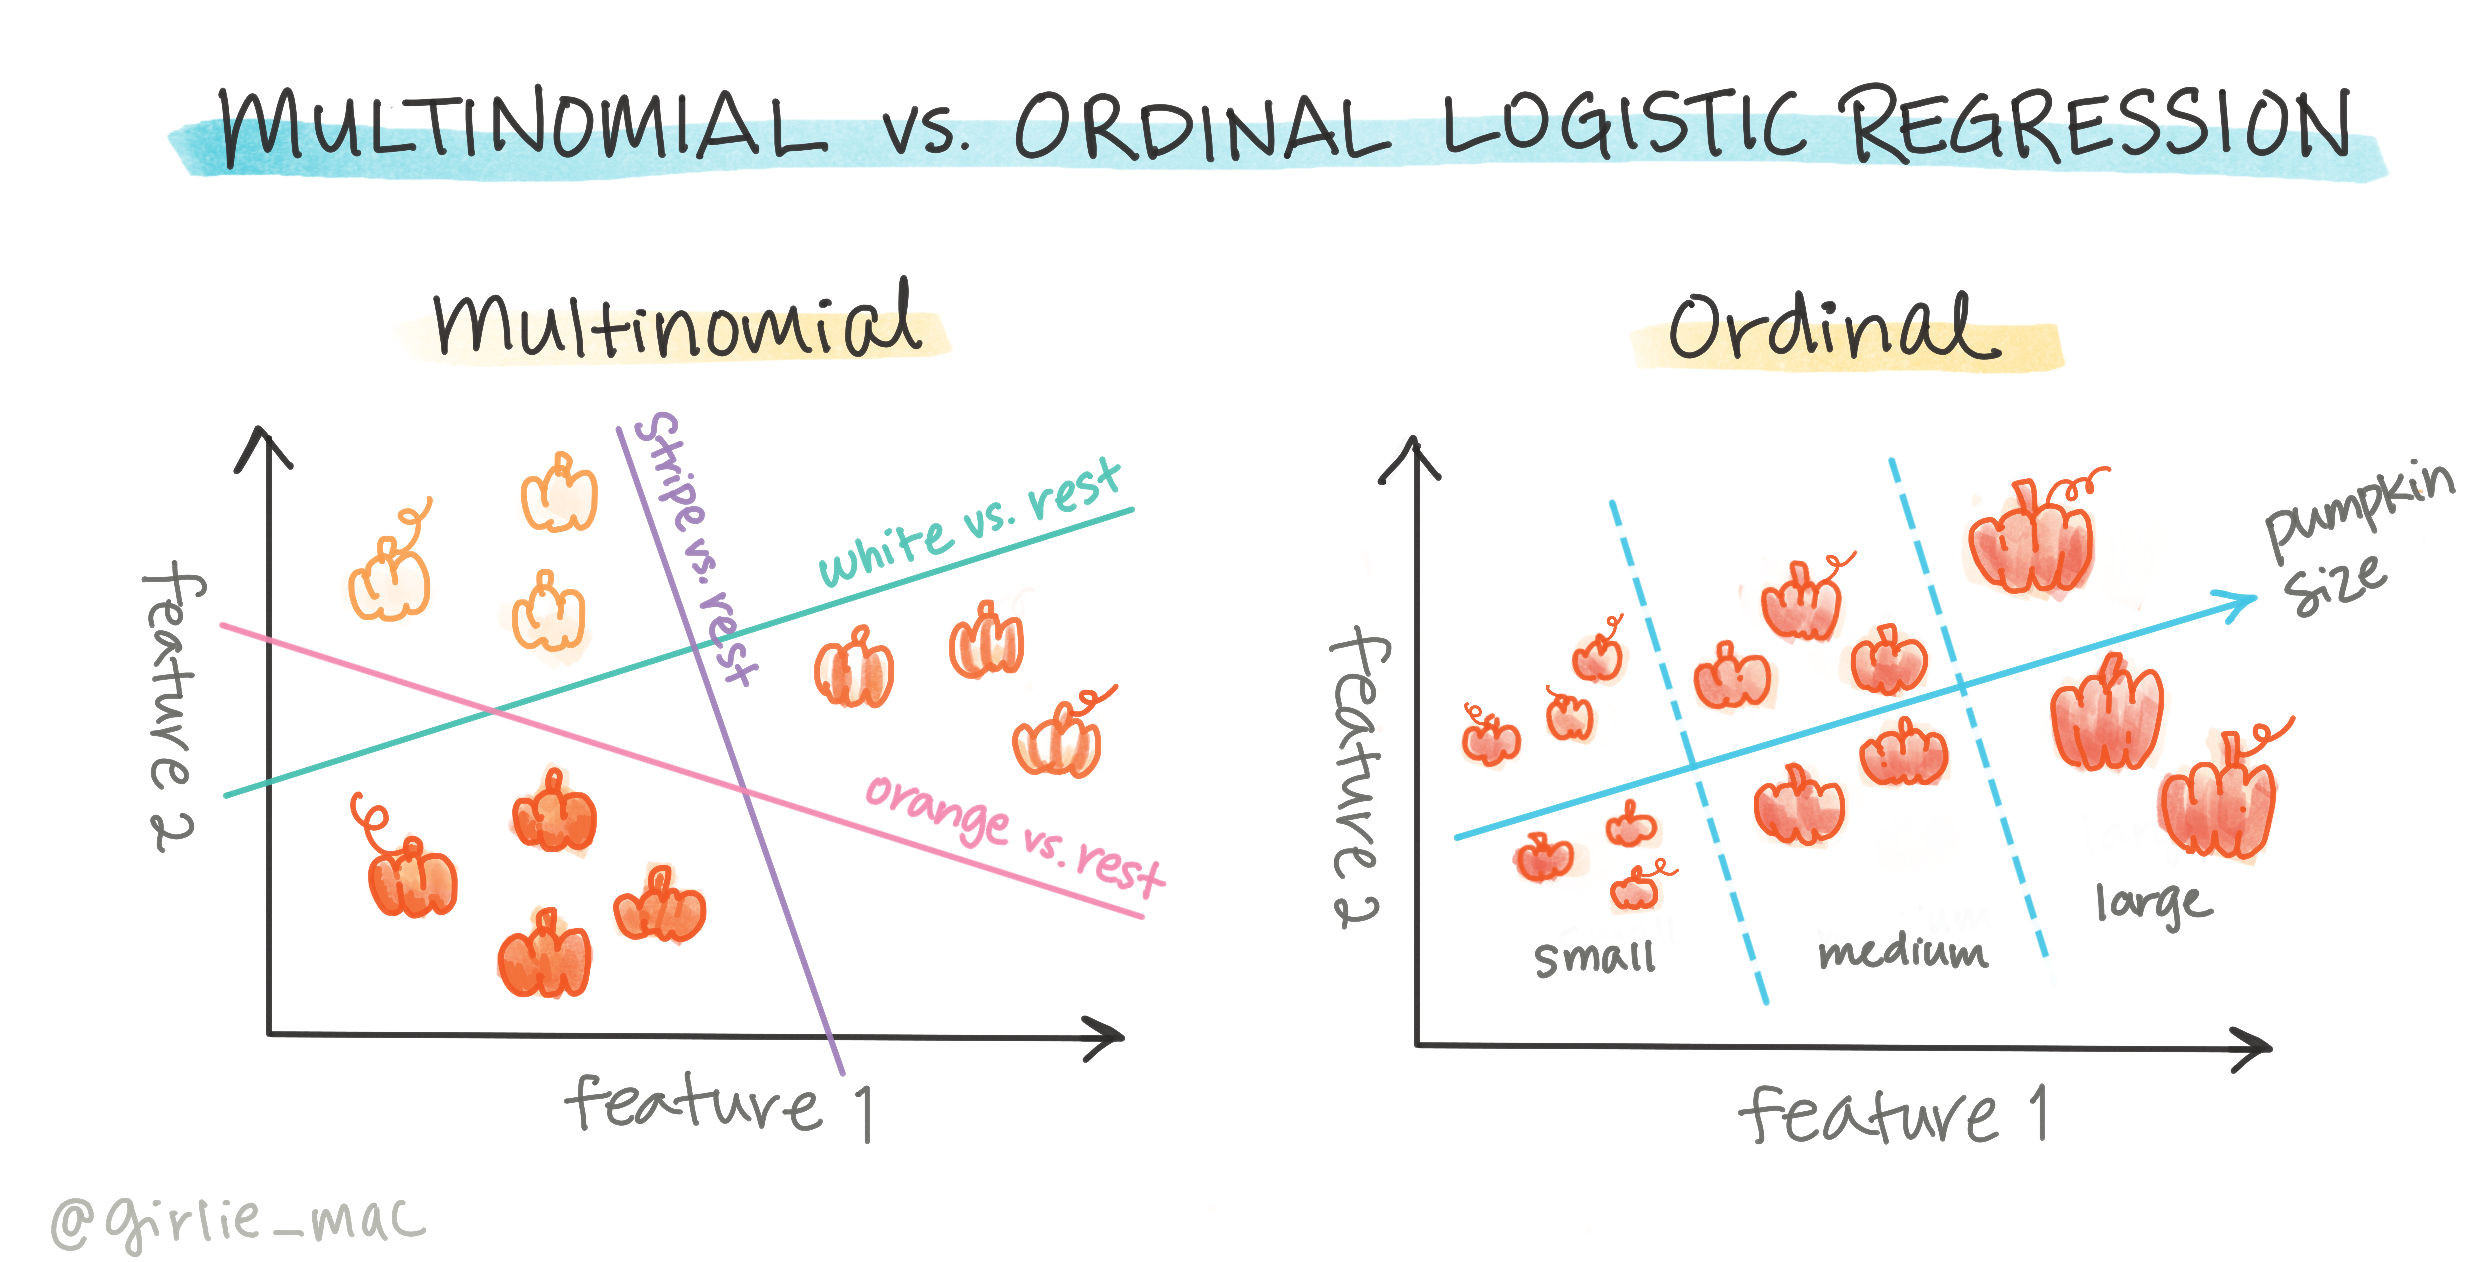
Multinomial və ordinal daxil olmaqla logistik reqressiyanın digər növləri mövcuddur:
- Multinomial özündə daha çox kateqoriyanı ehtiva edir. Məsələn, "Narıncı, Ağ, and Zolaqlı".
- Sıralanmış kateqoriyalardan ibarət olan Ordinal isə, limitli ölçülərə(mini,sm,med,lg,xl,xxl) görə sıranlamış balqabaqlarımız kimi, nəticələrimizi məntiqi olaraq sıralamaq istədikdə faydalıdır.
Dəyişənlər korrelyasiya etməli deyil
Xətti reqressiyanın daha çox korrelyasiyalı dəyişənlərlə necə daha rahat işlədiyini xatırlayırsınızmı? Logistik reqressiyada bunun əksi baş verir. Belə ki, dəyişənlər uyğunlaşmasına ehtiyac yoxdur. Ona görə də, zəif korrelyasiyaları olan bu datamız üçün işə yarardır.
Çoxlu təmiz dataya ehtiyacınız var
Xətti reqressiya daha çox data istifadə etdikcə daha dəqiq nəticələr verəcək. Bizim balaca data dəstimizin bu tapşırıq üçün o qədər də optimal olmadığını unutmayın.
🎥 Logistik reqressiya üçün datanın hazırlanması barədə qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
✅ Logistik reqressiya üçün tam uyğun olan data tipləri haqqında düşünün
Tapşırıq - datanı səliqəyə salın
İlkin olaraq datanı biraz təmizləyək, boş dəyərləri kənarlaşdıraq və bəzi sütunları seçək:
-
Aşağıdakı kodu əlavə edin:
columns_to_select = ['City Name','Package','Variety', 'Origin','Item Size', 'Color']
pumpkins = full_pumpkins.loc[:, columns_to_select]

pumpkins.dropna(inplace=True)
Hər zaman öz datafreyminizə nəzər yetirə bilərsiniz:
pumpkins.info
Vizuallaşdırma - kateqorik qrafik
Artıq bir neçə dəfə başlanğıc dəftərçəsini yükləmiş və Color dəyişəni də daxil olmaqla bir neçə dəyişən qalacaq şəkildə onu təmizləmisiniz. Gəlin dəftərçədə datafreymimizi fərqli kitabxanadan-Seaborn-dan istifadə edərək vizuallaşdıraq. Bu kitabxana əvvəlki dərslərdə istifadə etmiş olduğumuz Matplotlib kitabxanası üzərinə qurulmuşdur.
-
catplotfunksiyasından,pumpkinsadlı balqabaq datamızdan istifadə etməklə və hər balqabaq kateqoriyası (narıncı və ya ağ) üçün rəng xəritəsini təyin etməklə belə bir qrafik yaradın:import seaborn as sns palette = { 'ORANGE': 'orange', 'WHITE': 'wheat', } sns.catplot( data=pumpkins, y="Variety", hue="Color", kind="count", palette=palette, )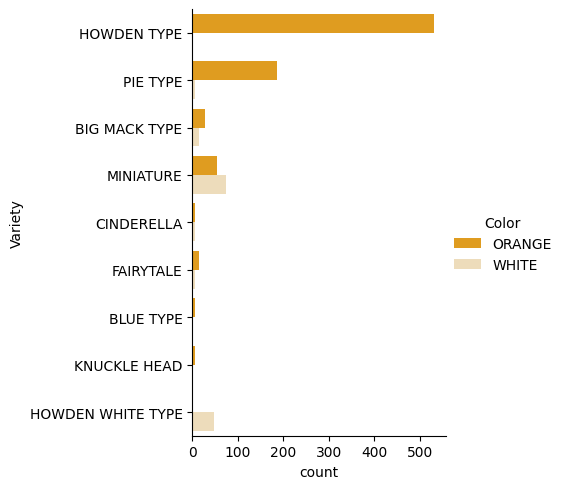
Bu datanı müşahidə edərək rənglərlə növlərin bir birinə necə təsir etdiyini görə bilərsiniz.
✅ Bu kateqorik qrafikə nəzər yetirdikdə ağlınıza hansı maraqlı yeni fikirlər gəlir?
Datanın ön-emalı özəllik və etiket kodlaşdırılması
Bizim balqabaq datalarımızdakı bütün sütunlar mətni dəyərlərdən ibarətdir. Kateqorik datalarla işləmək insanlar üçün intuitiv olsa da, maşınlar üçün bu belə deyil. Maşın öyrənmə alqoritmləri rəqəmlərlə yaxşı işləyir. Buna görə də kodlaşdırma bizə kateqoriyalı məlumatları heç bir məlumatı itirmədən ədədi məlumatlara çevirməyə imkan verdiyi üçün dataların önemalı mərhələsində çox vacib bir addımdır. Yaxşı kodlaşdırma yaxşı bir model yaratmağa səbəb olur.
Özəlliklərin kodlaşdırılması üçün kodlaşdırıcıların 2 əsas tipi var:
-
Ordinal şifrələyicilər data dəstimizdəki
Item Sizesütununda olduğu kimi müəyyən məntiqi sıralamanı izləyən ordinal dəyişənlər üçün uyğundur. Bu şifrələyici, hər kateqoriyanı aid olduğu kateqoriyanın sütun sırasına uyğun ədədlə ifadə edən bir əlaqə yaradır.from sklearn.preprocessing import OrdinalEncoder item_size_categories = [['sml', 'med', 'med-lge', 'lge', 'xlge', 'jbo', 'exjbo']] ordinal_features = ['Item Size'] ordinal_encoder = OrdinalEncoder(categories=item_size_categories) -
Kateqorik şifrələyicilər isə date dəstimizdə
Item Size-ı çıxmaq şərtilə digər özəlliklər kimi heç bir məntiqi qanunauyğunluğu izləməyən kateqorik dəyişlənlər üçün uyğundur. Bu tək-aktiv növ şifrələmədir. Bu növ şifrələmədə hər kateqoriya ikili sütunla ifadə olunur. Əgər balqabaq həmin növə aiddirsə 1, deyilsə şifrələnmiş dəyişən 0-a bərabər olur.from sklearn.preprocessing import OneHotEncoder categorical_features = ['City Name', 'Package', 'Variety', 'Origin'] categorical_encoder = OneHotEncoder(sparse_output=False)
Daha sonra bir neçə şifrələyicini 1 addımda birləşdirmək və müvafiq sütuna tətbiq etmək üçün ColumnTransformer-dən istifadə olunur.
    from sklearn.compose import ColumnTransformer

    ct = ColumnTransformer(transformers=[
        ('ord', ordinal_encoder, ordinal_features),
        ('cat', categorical_encoder, categorical_features)
        ])

    ct.set_output(transform='pandas')
    encoded_features = ct.fit_transform(pumpkins)
Digər tərəfdən etiketi kodlaşdırmaq üçün, onları yalnız 0 və siniflərin_sayı-1(burada 0 və 1-dir) arasında olan dəyərlərlə normallaşdıran scikit-learn-ün LabelEncoder sinifindən istifadə edəcəyik.
    from sklearn.preprocessing import LabelEncoder

    label_encoder = LabelEncoder()
    encoded_label = label_encoder.fit_transform(pumpkins['Color'])
Özəllikləri və etikətləri kodlaşdırdıqdan sonra onları yeni encoded_pumpkins adlı datafreymə birləşdirə bilərik.
encoded_pumpkins = encoded_features.assign(Color=encoded_label)
Item Size sütunu üçün ordinal şifrələyicilərdən istifadə etməyin üstünlükləri nədir?
Dəyişənlər arasındakı əlaqəni analiz edin
Artıq dəyişənlərimizi öncədən emal etdiyimizə görə, modelin verilən özəlliklərə uyğun etiketi nə qədər düzgün təxmin edə biləcəyi barədə fikir sahibi ola bilərik. Bunun üçün özəlliklərlə etiketlər arasındakı əlaqələri analiz edə bilərik.
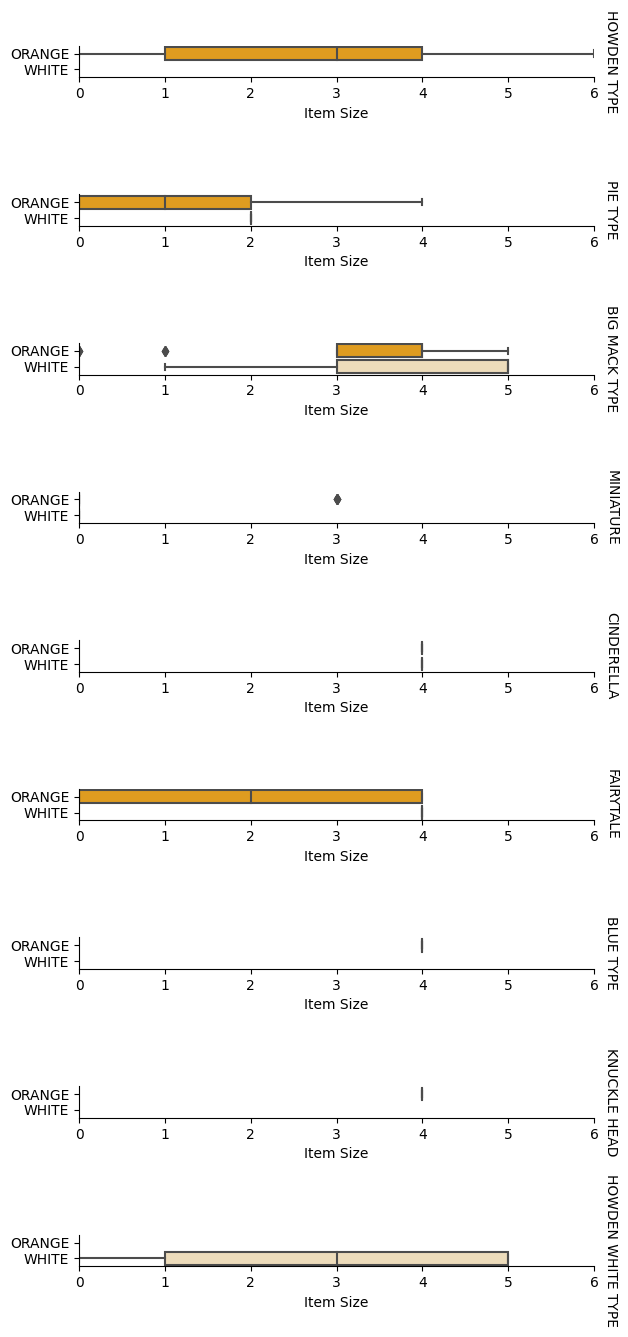
Bu tip analizləri aparmağın ən yaxşı yolu onları qrafikləşdirməkdir. Bu dəfə də kateqorik qrafikdə Item Size, Variety və Color arasındakı əlaqəni vizuallaşdırmaq üçün Seaborn-un catplot funksiyasından istifadə edəcəyik. Datanı daha yaxşı vizuallaşdırmaq üçün şifrələnmiş Item Size və şifrələnməmiş Variety sütunlarını istifadə edirik.
    palette = {
    'ORANGE': 'orange',
    'WHITE': 'wheat',
    }
    pumpkins['Item Size'] = encoded_pumpkins['ord__Item Size']

    g = sns.catplot(
        data=pumpkins,
        x="Item Size", y="Color", row='Variety',
        kind="box", orient="h",
        sharex=False, margin_titles=True,
        height=1.8, aspect=4, palette=palette,
    )
    g.set(xlabel="Item Size", ylabel="").set(xlim=(0,6))
    g.set_titles(row_template="{row_name}")
Sürü qrafikindən istifadə edin
Color ikili kateqoriya(Ağ və ya Ağ olmayan) olduğu üçün vizuallaşdırma üçün xüsusi yanaşmaya ehtiyacı var. Bu kateqoriyanın digər dəyişənlərlə olan əlaqəsini vizuallaşdırmaq üçün başqa yollar da mövcuddur.
Dəyişənləri yanaşı formada Seaborn qrafikləri ilə vizuallaşdıra bilərsiniz.
-
Dəyərlərin paylanmasını göstərmək üçün 'swarm' qrafikini yoxlayın:
palette = {
0: 'orange',
1: 'wheat'
}
sns.swarmplot(x="Color", y="ord__Item Size", data=encoded_pumpkins, palette=palette)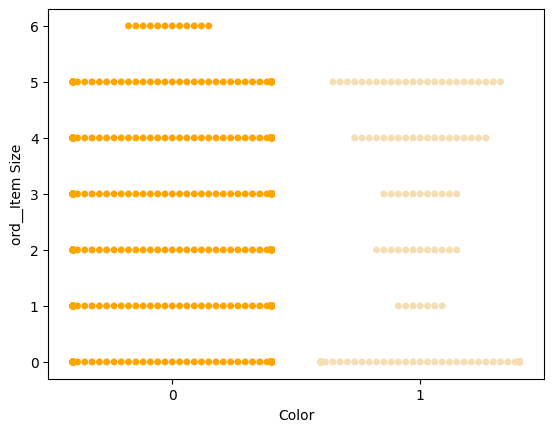
Diqqət edin: Seaborn bu qədər çox məlumat nöqtəsini sürü qrafiki ilə göstərməyi bacara bilmədiyi üçün yuxarıdakı kod bir xəbərdarlıq göstərə bilər. Problemin potensial həlli, 'size' parametrindən istifadə edərək işarələyicinin ölçüsünü azaltmaqdır. Amma nəzərə alın ki, bu qrafikin oxunaqlılığını aşağı salacaq.
🧮 Mənə riyaziyyatı göstərin
Logistik reqressiya siqmoid funksiyalarından istifadə edən 'maksimum bənzərlik' konseptinə əsaslanır. Qrafiki formada 'Siqmoid Funksiyası' 'S' hərfinə oxşayır. Bu funksiya bir dəyər götürür və onu 0 və 1 arasındakı bir qiymətə köçürür. Qrafiki əyrisi isə 'logistik əyri' də adlanır. Düsturu isə bu formadadır:
siqmoidin orta nöqtəsi x-in 0 nöqtəsində olduğu nöqtədə L əyrinin maksimum dəyəri, k isə əyrinin dikliyidir. Əgər funksiyanın nəticəsi 0.5-dən çoxdursa, etiketə ikili seçimin '1' sinifi veriləcək, əks halda '0' olaraq sinifləndiriləcəkdir.
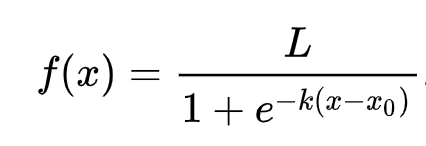
Modelinizi qurun
Həmin ikili klassifikasiyanı tapmaq üçün bir model qurmaq Scikit-learn-də təəccüblü dərəcədə sadədir.
🎥 Logistik reqressiya modelinin qurulmasını göstərən qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
-
Təsnifat modelində istifadə istifadə etmək istədiyiniz dəyişənləri seçin və
train_test_split()-i çağıraraq onları öyrənmə və test dəstlərinə ayırın.from sklearn.model_selection import train_test_split X = encoded_pumpkins[encoded_pumpkins.columns.difference(['Color'])] y = encoded_pumpkins['Color'] X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0) -
Artıq
fit()-i öyrənmə dataları ilə çağıraraq modelinizi öyrədə və nəticəni ekrana çap edə bilərsiniz:from sklearn.metrics import f1_score, classification_report from sklearn.linear_model import LogisticRegression model = LogisticRegression() model.fit(X_train, y_train) predictions = model.predict(X_test) print(classification_report(y_test, predictions)) print('Predicted labels: ', predictions) print('F1-score: ', f1_score(y_test, predictions))Qiymətlər tablosuna nəzər yetirin. Yalnız 1000 sətirlik datanızın olduğunu nəzərə alsaq, o qədər də pis görünmür:
                   precision    recall  f1-score   support

                0       0.94      0.98      0.96       166
                1       0.85      0.67      0.75        33

    accuracy                                0.92       199
    macro avg           0.89      0.82      0.85       199
    weighted avg        0.92      0.92      0.92       199

    Predicted labels:  [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 1 0 0 0 0 0 0 0 0 1 0 0 0 0
    0 0 0 0 0 1 0 1 0 0 1 0 0 0 0 0 1 0 1 0 1 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0
    1 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 1 0 1 0 0 0 0 0 0 0 1 0
    0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0 0 0 1 0 0 0 1 1 0
    0 0 0 0 1 0 0 0 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1
    0 0 0 1 0 0 0 0 0 0 0 0 1 1]
    F1-score:  0.7457627118644068
Xəta matrisi vasitəsilə daha yaxşı başa düşmə
Yuxarıdakıları ekrana çap edərək bir xal tablosu reportu əldə edə bilsəniz də, modelinizin necə bir performans göstərməsini xəta matrisi istifadə edərək daha rahat başa düşə bilərsiniz.
🎓 'Xəta matrisi' təxminlərin dəqiqliyini ölçən, modelinizin pozitiv və neqativ olmaqla, doğru və yanlışları göstərən bir cədvəldir.
-
Xəta matirisini işlətmək üçün
confusion_matrix()-i çağırın:from sklearn.metrics import confusion_matrix confusion_matrix(y_test, predictions)Take a look at your model's confusion matrix:
array([[162,   4],
       [ 11,  22]])
Scikit-learn-də, xəta matrisində Cərgələr(0 oxu) əsl etiketlər, sütunlar(1 oxu) isə təxmin edilənləri göstərir.
| 0 | 1 | |
|---|---|---|
| 0 | TN | FP |
| 1 | FN | TP |
Burada nə baş verir? Misal üçün modelimizdən balqabaqları 2 ikili kateqoriya-'ağ' və 'ağ olmayan' üzrə təsnifləndirməyi istəmişik.
- Modeliniz balqabağın ağ olmadığını təxmin edirsə və o, reallıqda 'ağ olmayan' kateqoriyasına aiddirsə, biz onu yuxarı sol rəqəmlə göstərilən doğru neqativ adlandırırıq.
- Modeliniz balqabağı ağ kimi təxmin edirsə və o, reallıqda 'ağ olmayan' kateqoriyasına aiddirsə, biz onu aşağı sol nömrə ilə göstərilən yanlış neqativ adlandırırıq.
- Modeliniz balqabağın ağ olmadığını təxmin edirsə və o, reallıqda 'ağ' kateqoriyasına aiddirsə, biz onu yuxarı sağ nömrə ilə göstərilən yanlış pozitiv adlandırırıq.
- Modeliniz balqabağı ağ kimi təxmin edirsə və o, reallıqda 'ağ' kateqoriyasına aiddirsə, biz onu aşağı sağ rəqəmlə göstərilən doğru pozitiv adlandırırıq.
Təxmin etdiyiniz kimi, daha çox sayda doğru pozitiv və doğru neqativlərə və daha az sayda yanlış pozitiv və yanlış neqativlərə üstünlük verilir. Bu da modelin daha yaxşı performans göstərdiyini göstərir.
Xəta matrisinin dəqiqlik və xatırlatma ilə necə bir əlaqəsi var? Yuxarıda çap edilmiş təsnifat hesabatın dəqiqliyini (0,85) və xatırlamanı isə (0,67) olaraq göstərdiyini unutmayın.
Dəqiqlik = tp / (tp + fp) = 22 / (22 + 4) = 0.8461538461538461
Xatırlama = tp / (tp + fn) = 22 / (22 + 11) = 0.6666666666666666
✅ Sual: Xəta matrisinə əsasən, bizim modelimiz necə işlədi? Cavab: O qədər də pis deyildi. Nəzərəçarpacaq qədər doğru neqativlər olmasına baxmayaraq, az da olsa yanlış neqativlər var.
TP/TN və FP/FN-nin xəta matrisinin xəritələşdirilməsinin köməyi ilə əvvəllər gördüyümüz şərtlərə yenidən baxaq:
🎓 Dəqiqlik: TP/(TP + FP) Alınmış nümunələr arasında müvafiq nümunələrin payı (məsələn, hansı etiketlər düzgün etiketlənib)
🎓 Xatırlama: TP/(TP + FN) Yaxşı etiketlənmiş və ya etiketlənməmiş fərqi olmadan, əldə edilmiş müvafiq nümunələrin bir hissəsi
🎓 f1-balı: (2 * dəqiqlik * Xatırlama)/(dəqiqlik + xatırlatma) Ən yaxşısı 1, ən pisi isə 0 olmaqla dəqiqlik və xatırlatmanın çəkili ortalaması
🎓 Dəstək: Alınan hər bir etiketin təkrarlanma sayı
🎓 Dəqiqlik: (TP + TN)/(TP + TN + FP + FN) Nümunə üçün dəqiq proqnozlaşdırılmış etiketlərin faizi.
🎓 Makro Ortalama: Etiket balanssızlığını nəzərə almadan hər bir etiket üçün ölçülməmiş orta göstəricilərin hesablanması.
🎓 Çəkili Ortalama: Hər bir etiket üçün orta göstəricilərin hesablanması, etiket balanssızlığının hesaba qatılması və dəstəklərinə(hər etiket üçün doğru nümunələrin sayı) görə çəkiləndirilməsidir.
✅ Modelinizin yanlış neqativlərinin sayını azaltmaq istədikdə hansı ölçümü izləməli olduğunuzu düşünürsünüz?
Bu modelin ROC əyrisini vizuallaşdırın

🎥 ROC əyrilərinin qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
'ROC' adlandırılan əyrini görmək üçün gəlin daha bir vizuallaşdırma edək:
from sklearn.metrics import roc_curve, roc_auc_score
import matplotlib
import matplotlib.pyplot as plt
%matplotlib inline

y_scores = model.predict_proba(X_test)
fpr, tpr, thresholds = roc_curve(y_test, y_scores[:,1])

fig = plt.figure(figsize=(6, 6))
plt.plot([0, 1], [0, 1], 'k--')
plt.plot(fpr, tpr)
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve')
plt.show()
Matplotlib-dən istifadə edərək modelin Receiving Operating Characteristic(Qəbul Əməliyyatlarının Xarakteristikası) və ya ROC əyrisini qrafikləşdirək. ROC əyriləri daha çox bir klassifikatorun nəticəsinin doğru və ya yanlış pozitivləri baxımından bir təsvirini yaratmaq üçün istifadə olunur. "ROC əyrilərində doğru pozitivlərin nisbəti Y oxu üzrə, yanlış pozitivlərin nisbəti isə X oxu üzrə göstərilir." Əyrinin dikliyi və qrafikin orta xətti ilə əyri arasındakı məsafə önəm daşıdığına görə, sürətlə yuxarı doğru çıxan və xətti keçən bir əyri istəyirsiniz. Bizim situasiyada, başlanğıcda yanlış pozitivlər var və daha sonra əyri düzgün bir şəkildə yuxarı və aşağı doğru gedir.
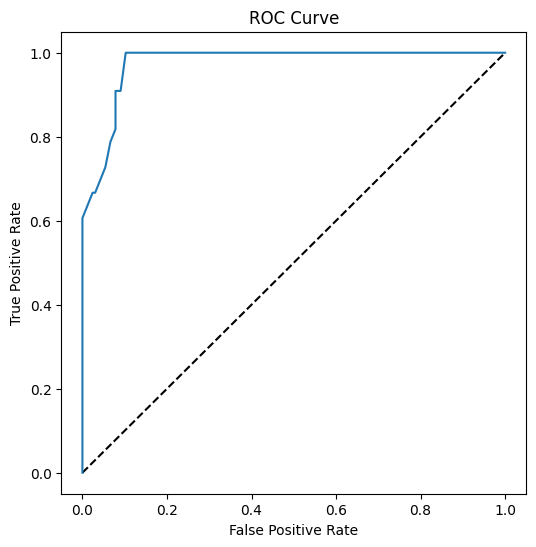
Yekun olaraq 'Əyrinin Aşağısındakı Sahə'-ni (ƏAS) hesablamaq üçün Scikit-learn-ün roc_auc_score metodundan istifadə edin:
auc = roc_auc_score(y_test,y_scores[:,1])
print(auc)
Nəticə 0.9749908725812341-ə bərabərdir. ƏAS əmsalının 0 ilə 1 arasında dəyişdiyini və 100% düzgün işləyən modelin ƏAS əmsalının 1-ə bərabər olduğunu nəzərə alsaq, daha yüksək xal istəməyiniz normaldır. İndiki durumda modelimiz çox yaxşıdır.
Klassifikasiya ilə bağlı gələcək dərslərdə, modelin balını yüksəltmək üçün necə iterasiyalar etməyi öyrənəcəksiniz. Amma indilik bu qədər bəsdir. Reqressiya dərslərini bitirdiyinizə görə sizi təbrik edirik!
🚀Məşğələ
Logistik reqressiya mövzusunda öyrəniləsi hələ çox şey var. Amma ən yaxşı öyrənmə təcrübə etməkdir. Bunun üçün dərsdəki analizə bənzər bir data dəsti tapın və onunla bir model qurun. Nə öyrəndiniz? Maraqlı data dəstləri üçün Kaggle-ı yoxlaya bilərsiniz.
Mühazirə sonrası quiz
Təkrarlayın və özünüz öyrənin
Logistik reqressiyanın praktiki istifadələri haqqında olan bu məqalənin ilk bir neçə səhifəsini oxuyun. İndiyə qədər öyrəndiyimiz bu və ya digər növ reqressiya tapşırıqları üçün daha uyğun olan istifadə halları haqqında düşünün. Ən yaxşısı hansı olardı?