
11 KiB
Mətbəx Qruplaşdırıcıları - 2. hissə
İkinci qruplaşdırma dərsində siz, ədədi dataları qruplaşdırmaq üçün olan əlavə yolları kəşf edəcəksiniz. Bundan əlavə olaraq isə bir qruplaşdırıcını digəri ilə əvəz etməyin nəticələri haqqında öyrənəcəksiniz.
Mühazirədən əvvəl test
İlkin şərt
Əvvəlki dərsi bitirdiyinizi və 4-cü dərsin ana qovluğunda yerləşən data qovluğunda, cleaned_cuisines.csv adlı data setinizin olduğunu güman edirik.
Hazırlıq
notebook.ipynb faylınızı təmizlənmiş data set ilə yükləyib, X və y datafreymlərinə bölərək model qurulması prosesi üçün hazır vəziyyətə gətirmişik.
Qruplaşdırma xəritəsi
Öncədən, Microsoft-un yaddaş vərəqindən datanın qruplaşdırmağın müxtəlif növləri haqqında öyrənmisiniz. Scikit-learn də buna oxşar, amma təxminedicilərinizi(qruplaşdırıcıların digər adı) daha dəqiq təyin etmənizdə sizə yardım edəcək bir yaddaş vərəqəsi təklif edir:
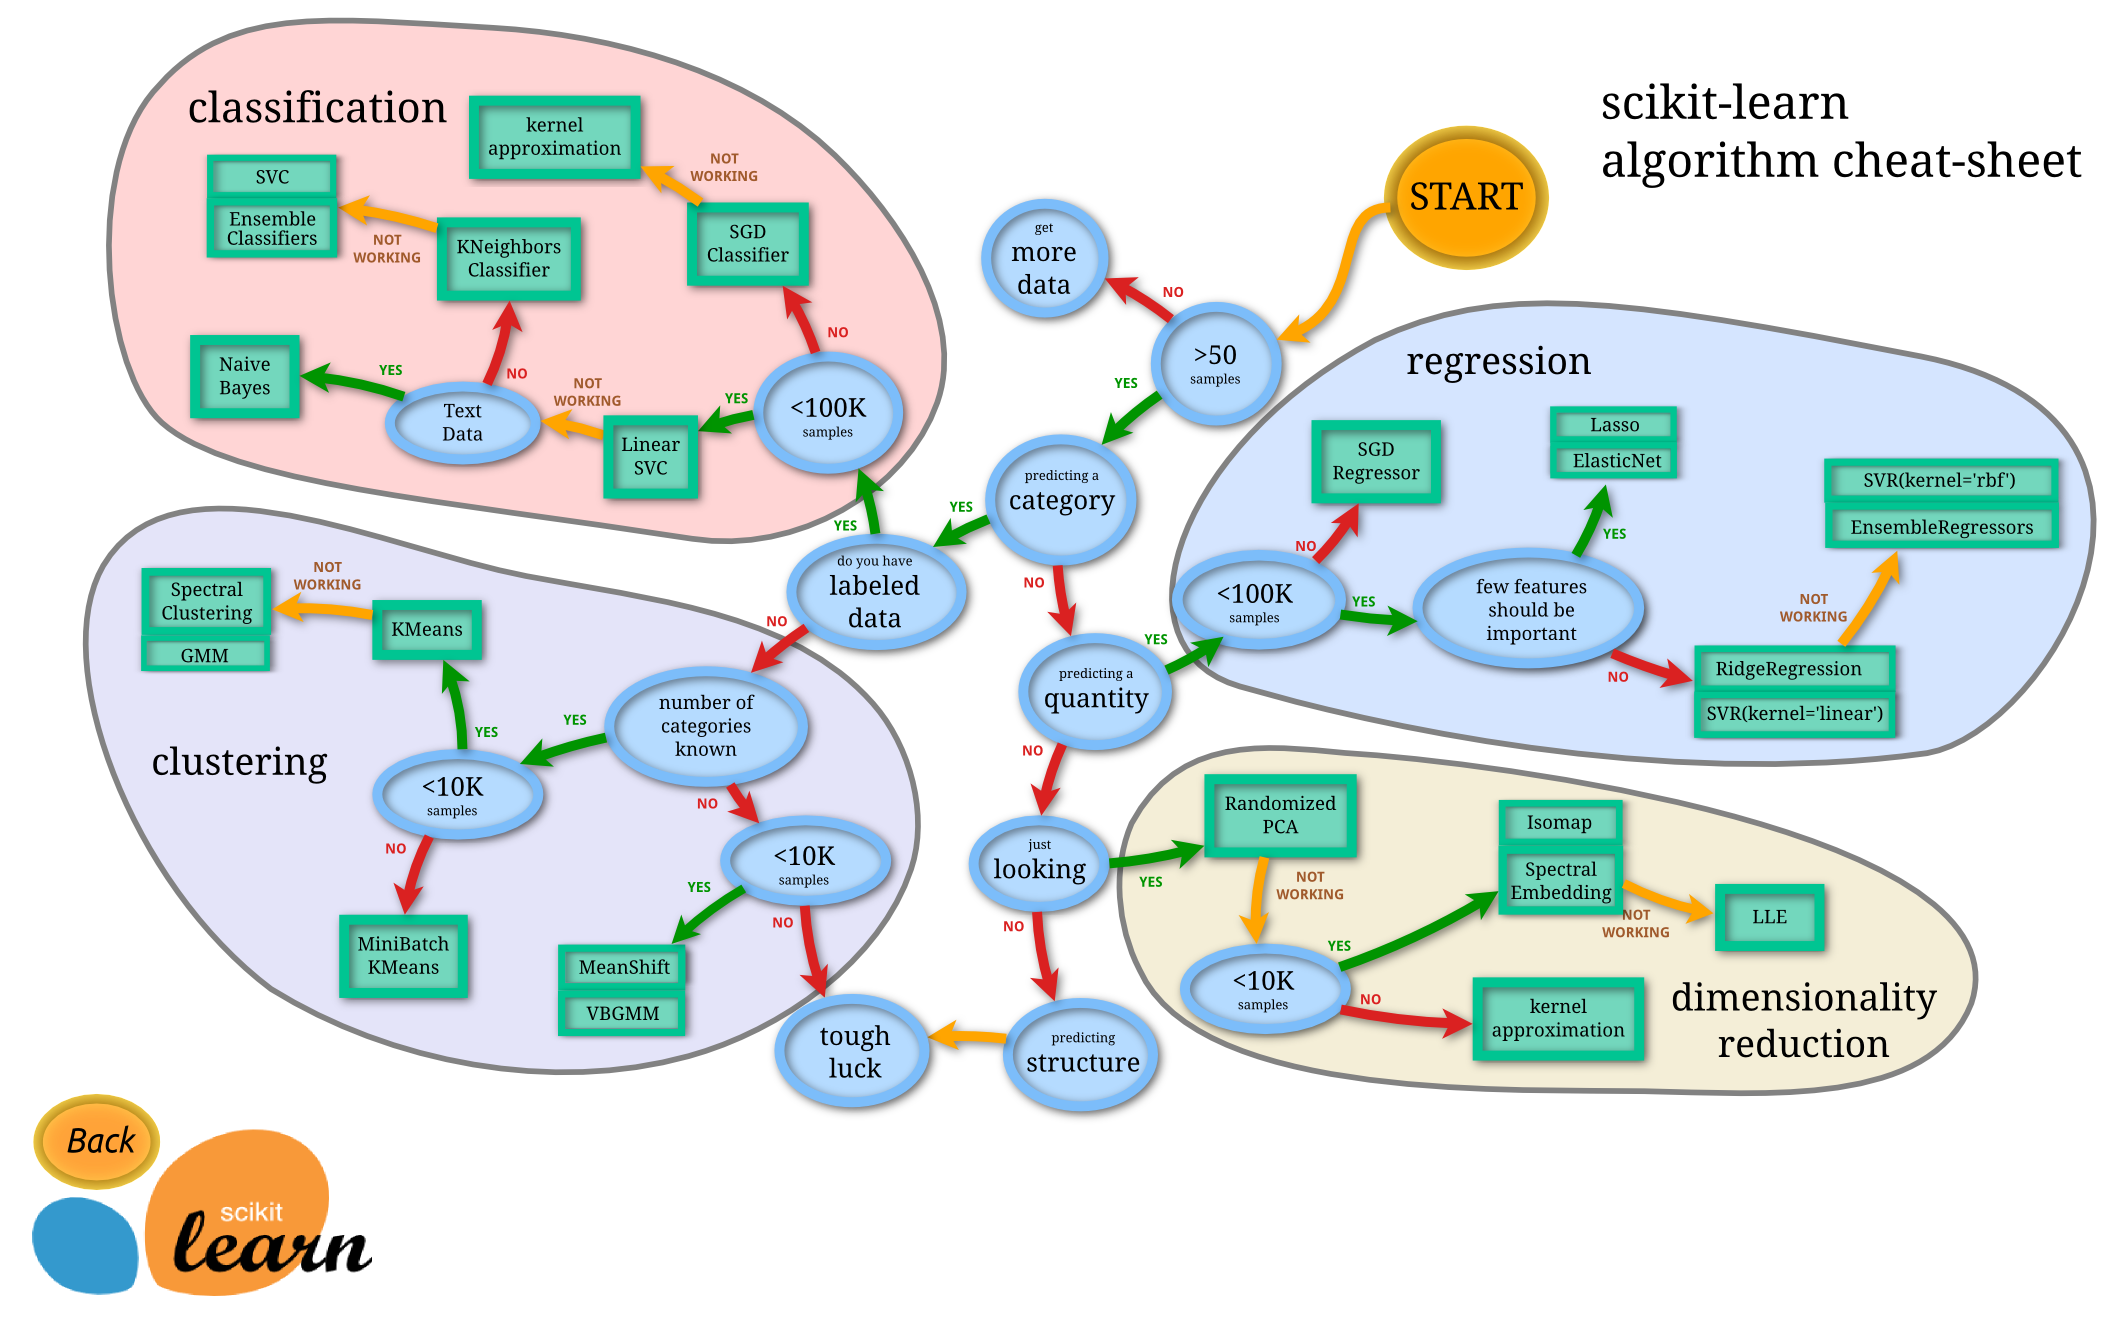
Tövsiyyə: Bu xəritəyə onlayn formada baxaraq, cığırlar üzrə hərəkət edərkən üzərlərinə klik edərək dokumentasiyaları oxuya bilərsiniz.
Plan
Datanız haqqında aydın fikirləriniz olduğu zaman bu xəritə sizə çox kömək edəcək. Cığırlar boyunca 'gəzdikcə' yekun nəticəyə gələcəksiniz:
- 50-dən çox nümunəmiz var
- Kateqoriyanı təxmin etmək istəyirik
- Etiketlənmiş datamız var
- 100 mindən daha az nümunəmiz var
- ✨ Xətti DVQ(Dəstək-Vektor Qruplaşdırıcı)-i seçə bilərik
- Ədədi datamız olduğuna görə, əgər işinizə yaramazsa
- ✨ K-Qonşu Qruplaşdırıcını yoxlaya bilərik
- Əgər bu da işinizə yaramazsa, ✨ DVQ və ✨ Ansambl Qruplaşdırıcılarını yoxlayın.
- ✨ K-Qonşu Qruplaşdırıcını yoxlaya bilərik
Bu izləyə biləcəyiniz çox faydalı bir yoldur.
Tapşırıq - datanı ayırmaq
Həmin cığırı izləyərək, istifadə etmək üçün bəzi kitabxanaları idxal edərək başlamalıyıq.
-
Tələb olunan kitabxanaları idxal edin:
from sklearn.neighbors import KNeighborsClassifier from sklearn.linear_model import LogisticRegression from sklearn.svm import SVC from sklearn.ensemble import RandomForestClassifier, AdaBoostClassifier from sklearn.model_selection import train_test_split, cross_val_score from sklearn.metrics import accuracy_score,precision_score,confusion_matrix,classification_report, precision_recall_curve import numpy as np -
Öyrədilmə və test datalarını ayırın:
X_train, X_test, y_train, y_test = train_test_split(cuisines_feature_df, cuisines_label_df, test_size=0.3)
Xətti DVQ(Dəstək-Vektor Qruplaşdırıcı)
Dəstək-Vektor klasterləşmə, MÖ texnikalarından(aşağıda bu haqda ətraflı öyrənə bilərsiniz) olan Dəstək-Vektor maşınları ailəsinin bir üzvüdür. Bu metodda siz etiketləri klasterləşdirmək üçün 'kernel(özək)' seçə bilərsiniz. 'C' parametri, parametrlərin təsirini nizamlayan 'regularization(nizamlama)'-ı bildirir. Özək bunlardan biri ola bilər. Burada biz xətti DVQ-ı istifadə edəcəyimizə görə onun da 'xətti' olaraq təyin etmişik. Ehtimalın öz standart olaraq təyin olunmuş dəyəri 'false(yanlış)'-dur. Amma burada ehtimal haqqında təxminlər toplamağımız üçün onu 'true(doğru)'-a dəyişmişik. Random state-i(Random vəziyyəti) isə, ehtimalları datanı qarışdıraraq əldə etmək üçün '0'-a bərabər etmişik.
Tapşırıq - xətti DVQ-i tətbiq edin
Qruplaşdırıcılardan ibarət bir massiv yaratmaqla başlayın. Testlər apardıqca, bu massivə əlavələr edəcəksiniz.
-
Xətti DVQ ilə başlayın:
C = 10 # Create different classifiers. classifiers = { 'Linear SVC': SVC(kernel='linear', C=C, probability=True,random_state=0) } -
Xətti DVQ istifadə edərək modeli öyrədin və reportu ekrana çap edin:
n_classifiers = len(classifiers)

for index, (name, classifier) in enumerate(classifiers.items()):
    classifier.fit(X_train, np.ravel(y_train))

    y_pred = classifier.predict(X_test)
    accuracy = accuracy_score(y_test, y_pred)
    print("Accuracy (train) for %s: %0.1f%% " % (name, accuracy * 100))
    print(classification_report(y_test,y_pred))
Nəticə kifayət qədər yaxşıdır:
Accuracy (train) for Linear SVC: 78.6%
              precision    recall  f1-score   support

     chinese       0.71      0.67      0.69       242
      indian       0.88      0.86      0.87       234
    japanese       0.79      0.74      0.76       254
      korean       0.85      0.81      0.83       242
        thai       0.71      0.86      0.78       227

    accuracy                           0.79      1199
   macro avg       0.79      0.79      0.79      1199
weighted avg       0.79      0.79      0.79      1199
K-Qonşu qruplaşdırıcısı
K-Qonşu, MÖ metodlarının həm nəzarətli, həm də nəzarətsiz öyrənmə üçün istifadə edilən "qonşular" ailəsinin bir hissəsidir. Bu metodda, öncədən təyin olunan sayda data nöqtələri yaradılır və datalar bu nöqtələr ətrafında məlumatlar üçün ümumiləşdirilmiş etiketlər proqnozlaşdırıla bilinəcəyi formada toplanılır.
Tapşırıq - K-Qonşu qruplaşdırıcısını tətbiq edin
Öncəki qruplaşdırıcı yaxşı idi və data ilə əla işlədi. Amma daha yuxarı dəqiqlik əldə edə bilərik. K-Qonşu qruplaşdırıcısını yoxlayın.
-
Qruplaşdırıcı massivinizə yeni sətir əlavə edin (Xətti DVQ-dən sonra vergül qoyun):
'KNN classifier': KNeighborsClassifier(C),Nəticə bir az pisdir:
Accuracy (train) for KNN classifier: 73.8%
              precision    recall  f1-score   support

     chinese       0.64      0.67      0.66       242
      indian       0.86      0.78      0.82       234
    japanese       0.66      0.83      0.74       254
      korean       0.94      0.58      0.72       242
        thai       0.71      0.82      0.76       227

    accuracy                           0.74      1199
   macro avg       0.76      0.74      0.74      1199
weighted avg       0.76      0.74      0.74      1199
✅ K-Qonşular haqqında ətraflı öyrənin
Dəstək-Vektor Qruplaşdırıcısı
Dəstək-Vektor qruplaşdırıcıları, MÖ metodlarının qruplaşdırma və reqressiya tapşırıqları üçün istifadə edilən Dəstək-Vektor Maşını ailəsinin bir hissəsidir. DVM-lər iki kateqoriya arasındakı məsafəni maksimallaşdırmaq üçün "öyrətmə nümunələrini fəzadakı nöqtələrə köçürür". Sonrakı datalar kateqoriyalarının müəyyən olunması üçün bu fəzaya köçürülür.
Dəstək Vektor Qruplaşdırıcısını tətbiq edin
Gəlin Dəstək Vektor Qruplaşdırıcı ilə daha dəqiq nəticə əldə etməyə çalışaq.
-
K-Qonşu-dan sonra vergül qoyun və bu sətri əlavə edin:
'SVC': SVC(),Nəticə kifayət qədər yaxşıdır!
Accuracy (train) for SVC: 83.2%
              precision    recall  f1-score   support

     chinese       0.79      0.74      0.76       242
      indian       0.88      0.90      0.89       234
    japanese       0.87      0.81      0.84       254
      korean       0.91      0.82      0.86       242
        thai       0.74      0.90      0.81       227

    accuracy                           0.83      1199
   macro avg       0.84      0.83      0.83      1199
weighted avg       0.84      0.83      0.83      1199
✅ Support-Vectors haqqında ətraflı öyrənin
Ansambl Qruplaşdrıcıları
Gəlin cığırı əvvəlki testimiz kifayət qədər yaxşı olsa da axıra qədər izləyək. 'Ansambl Qruplaşdırıcılarını, xüsusilə Random Meşə və AdaBoost-u' yoxlayaq:
  'RFST': RandomForestClassifier(n_estimators=100),
  'ADA': AdaBoostClassifier(n_estimators=100)
Nəticələr kifayət qədər yaxşıdır. Xüsusilə Random Forest üçün:
Accuracy (train) for RFST: 84.5%
              precision    recall  f1-score   support

     chinese       0.80      0.77      0.78       242
      indian       0.89      0.92      0.90       234
    japanese       0.86      0.84      0.85       254
      korean       0.88      0.83      0.85       242
        thai       0.80      0.87      0.83       227

    accuracy                           0.84      1199
   macro avg       0.85      0.85      0.84      1199
weighted avg       0.85      0.84      0.84      1199

Accuracy (train) for ADA: 72.4%
              precision    recall  f1-score   support

     chinese       0.64      0.49      0.56       242
      indian       0.91      0.83      0.87       234
    japanese       0.68      0.69      0.69       254
      korean       0.73      0.79      0.76       242
        thai       0.67      0.83      0.74       227

    accuracy                           0.72      1199
   macro avg       0.73      0.73      0.72      1199
weighted avg       0.73      0.72      0.72      1199
✅ Ansambl Qruplaşdırıcıları haqqında ətraflı öyrənin
Maşın Öyrənməsinin bu metodu, modelin keyfiyyətini artırmaq üçün 'bir neçə təxminedicilərin təxminlərini özündə birləşdirir'. Nümunəmizdə, Random Ağacları və AdaBoost-u istifadə etdik.
-
Random Forest, ortalama hesablayan bir metod olaraq, həddən artıq uyğunlaşmamaq üçün təsadüfiliklə doldurulmuş 'qərarvermə ağaclarından' təşkil olunmuş 'meşə' yaradır. n_estimators parametri, ağacların sayını bildirir.
-
AdaBoost isə qruplaşdırıcını data setə uyğunlaşdırır və daha sonra öz surətlərini həmin datasetə uyğunlaşdırır. O yanlış qruplaşdırılmış qruplaşdırıcıların çəkilərinə fokuslanır və bir sonrakı qruplaşdırıcının düzəltməsi üçün uyğunluğa düzəlişlər edir.
🚀Məşğələ
Bu texnikaların hər birinin dəyişiklər edə biləcəyiniz çox sayda parametrləri mövcuddur. Hər birinin standart olaraq təyin edilmiş parametrlərini araşdırın və bu parametrlərin dəyişdirilməsinin modelin keyfiyyəti üçün önəmi haqqında düşünün.
Mühazirə sonrası quiz
Təkrarlayın və özünüz öyrənin
Bu dərslərdə çoxlu jarqon sözlər mövcuddur. Ona görə də bir dəqiqənizi ayıraraq, praktiki terminologiyaların olduğu bu siyahıya nəzər yetirin.