
16 KiB
Qruplaşdırıcı bölməsinə giriş
Bu bölmədəki 4 dərsdə ənənəvi maşın öyrənməsinin fundamental mövzusu olan qruplaşdırıcı haqqında öyrənəcəksiniz. Biz Asiyanın və Hindistanın möhtəşəm mətbəxləri üçün olan data massivi istifadə edərək müxtəlif qruplaşdırıcı alqoritmlərinin üzərindən keçəcəyik. Ümid edək ki, acsınız!
Bu dərslərdə pan-Asiya mətbəxlərini qeyd edin! Jen Looper tərəfindən təsvir
Qruplaşdırıcı nəzarətli öyrənmənin bir formasıdır və reqressiya texnikaları ilə çoxlu ortaq cəhətləri var. Əgər desək ki, maşın öyrənməsi dəyərləri proqnozlaşdırmaqdan və obyektləri etiketləməkdən ibarətdir, o zaman qruplaşdırıcını ümumi 2 qrupa ayıra bilərik: ikili qruplaşdırıcı və çox sinifli qruplaşdırıcı.
🎥 Yuxarıdakı təsvirə klikləməklə videoya baxın: John Guttag MIT-də qruplaşdırıcı mövzusunu təqdim edir
Yadda saxlayın:
- Xətti reqressiya sizə dəyişənlər arasındakı əlaqəni proqnozlaşdırmağa və yeni məlumatın həmin xəttə nəzərən harada yerləşəcəyi barədə həqiqətə yaxın olan təxminlər etməyə kömək etdi. Beləliklə siz, balqabağın Sentyabrdakı qiyməti ilə Dekabrdakı qiymətinin arasındakı fərq nə qədər olar kimi suallara təxmini cavablar verə biləcəksiniz.
- Lojistik reqressiya sizə "ikili kateqoriyaları" aydınlaşdırmağa kömək etdi: bu qiymət nöqtəsində balqabaq narıncıdır, yoxsa narıncı deyil?
Qruplaşdırıcı müxtəlif alqoritmləri istifadə edərək verilənin etiketini və ya sinfini təyin etmək üçün başqa yollar tapmağa imkan verir. Gəlin inqrediyentləri analiz etməklə mətbəxin aid olduğu yeri tapa bilib-bilməyəcəyimizi görmək üçün mətbəx datası ilə işləyək.
Mühazirədən əvvəl test
Bu dərs R proqramlaşdırma dili ilə də əlçatandır!
Giriş
Qruplaşdırıcı bir maşın öyrənmə tədqiqatçısının və bir data mühəndisinin ən əsas fəaliyyətlərindən biridir. İkili dəyərin qruplaşdırılması ("bu imeyl spamdır, yoxsa spam deyil?") kimi sadə məsələlərdən komputer görüşü istifadə edərək qarışıq şəkillərin qruplaşdırılması və seqmentasiyası məsələlərinə qədər datanı siniflərə ayırmaq və data haqqında suallar verə bilmək hər zaman faydalıdır.
Prosesi daha elmi dildə izah etsək, sizin qruplaşdırıcı metodunuz praqnozlaşdırıcı bir model yaradaraq sizə giriş və çıxış dəyərləri arasında əlaqəni təsvir etməyə imkan verir.
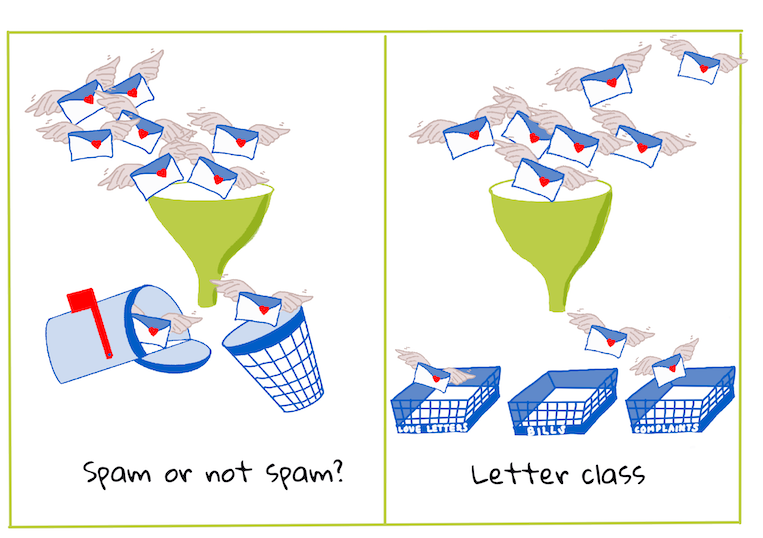
Qruplaşdırıcı alqoritmlərinin həll etməli olduğu ikili və çox sinifli qruplaşdırıcı problemləri. Jen Looper tərəfindən infoqraf
Datanı təmizləməyə, vizuallaşdırmağa və ML tapşırıqlarımız üçün hazırlamağa başlamazdan əvvəl gəlin, maşın öyrənməsinin hansı üsullarla datanı qruplaşdırmaq üçün istifadə edilə biləcəyini öyrənək.
Ənənəvi maşın öyrənməsi vasitəsilə qruplaşdırıcı əsasını statistikadan alır və _X xəstəliyinin yaranma ehtimalı_nı müəyyən etmək üçün siqaret çəkən, çəki və yaş kimi xarakteristikalardan istifadə edir. Nəzarətli öyrənmə metodu olduğuna görə daha əvvəl yerinə yetirdiyiniz reqressiya tapşırıqlarında olduğu kimi datanız etiketlənir və ML alqoritmləri datasetin siniflərini (ya da 'xarakteristikalar'ını) qruplaşdırmaq və proqnozlaşdırmaq, həmçinin onları qruplara bölmək və ya nəticə çıxarmaq üçün həmin etiketlərdən istifadə edir.
✅ Bir anlıq mətbəxlər haqqında dataset təsəvvür edin. Çox sinifli model nələrə cavab verə bilərdi? İkili model nələrə cavab verə bilərdi? Əgər verilən mətbəxdə samanlıq güldəfnəsinin istifadə olunub olunmadığını müəyyən etmək istəsəniz nə baş verəcək? Deyək ki, bir ərzaq çantasında sizə ulduz anis, ənginar, gül kələmi və yaban turpu təqdim olunur və siz bu ərzaqlardan ənənəvi Hindistan yeməyi hazırlaya bilib bilməyəcəyinizi öyrənmək istəyirsiniz. Bu zaman nə baş verəcək?
🎥 Yuxarıdakı təsvirə klikləməklə videoya baxın. 'Chopped' proqramının xülasəsini belə verə bilərik: Aşpazlar 'sirli səbət'də olan təsadüfi seçilmiş inqrediyentlərdən yemək hazırlamalıdırlar. Şübhəsiz ki, burada ML modeli köməyə çatardı!
Salam 'qruplaşdırıcı'
Bu mətbəx dataseti haqqında soruşmaq istədiyimiz sual həqiqətən də çox sinifli məsələ sualıdır, çünki biz bir neçə mümkün milli mətbəx ilə işləyə bilərik. İnqrediyentlər verilərsə, data bu siniflərdən hansına uyğun gələr?
Scikit-learn, həll etmək istədiyiniz məsələdən asılı olaraq datanı qruplaşdırıcı üçün bir neçə müxtəlif alqoritm təklif edir. Növbəti iki dərsdə bu alqoritmlərdən bir neçəsi haqqında öyrənəcəksiniz.
Tapşırıq - datanı təmizləyin və balanslaşdırın
Layihəyə başlamazdan öncə yerinə yetirilməli olan ilk tapşırıq - daha yaxşı nəticələr əldə etmək məqsədilə datanı təmizləmək və balanslaşdırmaqdır. Olduğunuz qovluqla eyni qovluqda olan boş notebook.ipynb faylı ilə başlayın.
Quraşdırılmalı olan ilk komponent imblearn-dür. Bu, datanı daha yaxşı balanslaşdırmağa imkan verən Scikit-learn komponentidir (bu tapşırıq haqqında az sonra öyrənəcəksiniz).
-
imblearnkomponentini quraşdırmaq üçün,pip installkomandasını icra edin:pip install imblearn -
Datanızı köçürmək və vizuallaşdırmaq üçün lazım olan komponentləri köçürün. Həmçinin
imblearn-dənSMOTE-u köçürün.import pandas as pd import matplotlib.pyplot as plt import matplotlib as mpl import numpy as np from imblearn.over_sampling import SMOTEArtıq datanı oxuyaraq köçürmək üçün hazırsınız.
-
Növbəti tapşırıq datanı köçürmək olacaq:
df = pd.read_csv('../data/cuisines.csv')read_csv()funksiyasını çağırmaq cusines.csv faylının içindəkiləri oxuyacaq və onlarıdfverilənində yerləşdirəcək. -
Datanın formasına baxaq:
df.head()İlk 5 sətir aşağıdakı kimidir:
| | Unnamed: 0 | cuisine | almond | angelica | anise | anise_seed | apple | apple_brandy | apricot | armagnac | ... | whiskey | white_bread | white_wine | whole_grain_wheat_flour | wine | wood | yam | yeast | yogurt | zucchini | | --- | ---------- | ------- | ------ | -------- | ----- | ---------- | ----- | ------------ | ------- | -------- | --- | ------- | ----------- | ---------- | ----------------------- | ---- | ---- | --- | ----- | ------ | -------- | | 0 | 65 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | | 1 | 66 | indian | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | | 2 | 67 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | | 3 | 68 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | | 4 | 69 | indian | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | -
Bu data haqqında məlumat əldə etmək üçün
info()funksiyasını çağırın:df.info()Nəticə aşağıdakı kimi olacaq:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 2448 entries, 0 to 2447
Columns: 385 entries, Unnamed: 0 to zucchini
dtypes: int64(384), object(1)
memory usage: 7.2+ MB
Tapşırıq - mətbəxlər haqqında öyrənin
Tapşırıq getdikcə maraqlı olmağa başlayır. Gəlin datanın mətbəxlər üzrə necə paylandığını tapaq
-
barh()funksiyasını çağırmaqla datanın zolaqlı diaqram kimi təsvirini əldə edin:df.cuisine.value_counts().plot.barh()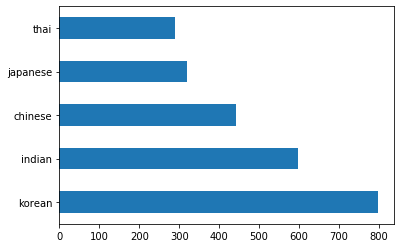
Datada olan mətbəxlərin sayı azdır, lakin data bərabər paylanmayıb. Bunu düzəldə bilərsiniz! Başlamazdan əvvəl biraz daha araşdırın.
-
Hər mətbəx üçün nə qədər data olduğunu tapın və onları çap edin:
thai_df = df[(df.cuisine == "thai")]
japanese_df = df[(df.cuisine == "japanese")]
chinese_df = df[(df.cuisine == "chinese")]
indian_df = df[(df.cuisine == "indian")]
korean_df = df[(df.cuisine == "korean")]

print(f'thai df: {thai_df.shape}')
print(f'japanese df: {japanese_df.shape}')
print(f'chinese df: {chinese_df.shape}')
print(f'indian df: {indian_df.shape}')
print(f'korean df: {korean_df.shape}')
Nəticə aşağıdakı kimi olacaq:
thai df: (289, 385)
japanese df: (320, 385)
chinese df: (442, 385)
indian df: (598, 385)
korean df: (799, 385)
İnqrediyentləri kəşf edin
Artıq datanı daha dərindən analiz edib hər mətbəxdə daha çox istifadə olunan inqrediyentləri öyrənə bilərsiniz. Mətbəxlər arasındakı qarışıqlığı aradan qaldırmaq üçün təkrarlanan datanı təmizləməlisiniz, gəlin bunun haqqında öyrənək.
-
İnqrediyentlərin cədvəlini yaratmaq üçün
create_ingredient_df()adlı Python funksiyası yaradın. Bu funksiya lazımsız olan sütunu çıxarmaqla başlayacaq və inqrediyentləri saylarına görə sıralayacaq:def create_ingredient_df(df): ingredient_df = df.T.drop(['cuisine','Unnamed: 0']).sum(axis=1).to_frame('value') ingredient_df = ingredient_df[(ingredient_df.T != 0).any()] ingredient_df = ingredient_df.sort_values(by='value', ascending=False, inplace=False) return ingredient_dfBundan sonra bu funksiyanı mətbəx üzrə ən çox istifadə olunan 10 inqrediyenti tapmaq üçün istifadə edə bilərsiniz.
-
create_ingredient_df()funksiyasını çağırın və nəticənin diaqramını əldə etmək üçünbarh()funksiyasını çağırın:thai_ingredient_df = create_ingredient_df(thai_df) thai_ingredient_df.head(10).plot.barh()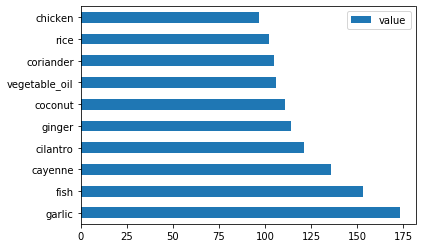
-
Eynisini Yapon mətbəxi datası üçün edin:
japanese_ingredient_df = create_ingredient_df(japanese_df)
japanese_ingredient_df.head(10).plot.barh()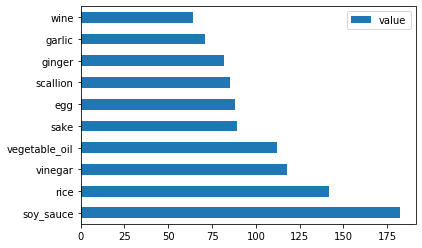
-
Çin mətbəxində istifadə olunan inqrediyentlər üçün də:
chinese_ingredient_df = create_ingredient_df(chinese_df)
chinese_ingredient_df.head(10).plot.barh()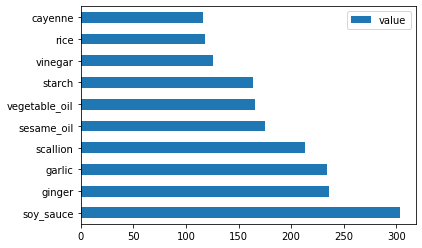
-
Hindistan mətbəxində istifadə olunan inqrediyentlər üçün də:
indian_ingredient_df = create_ingredient_df(indian_df)
indian_ingredient_df.head(10).plot.barh()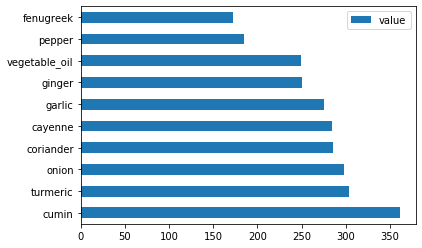
-
Son olaraq, Koreya mətbəxində istifadə olunan inqrediyentlər üçün:
korean_ingredient_df = create_ingredient_df(korean_df)
korean_ingredient_df.head(10).plot.barh()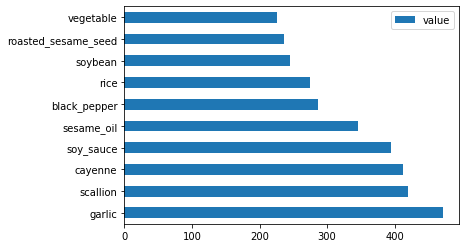
-
Növbəti addımda
drop()funksiyasını çağıraraq ən çox istifadə olunan və ayrı mətbəxlər arasında qarışıqlıq yaradan inqrediyentləri çıxarın:Hamı düyünü, sarımsağı və zəncəfili sevir!
feature_df= df.drop(['cuisine','Unnamed: 0','rice','garlic','ginger'], axis=1)
labels_df = df.cuisine #.unique()
feature_df.head()
Dataseti balanslaşdırın
Datanı təmizlədikdən sonra, onu balanslaşdırmaq üçün SMOTE - "Synthetic Minority Over-sampling Technique" - istifadə edin.
-
fit_resample()funksiyasını çağırın. Bu funksiya interpolyasiya üsulu ilə yeni nümunələr yaradır.oversample = SMOTE() transformed_feature_df, transformed_label_df = oversample.fit_resample(feature_df, labels_df)Datanı balanslaşdırdırdan sonra onu qruplaşdırarkən daha yaxşı nəticələr əldə edəcəksiniz. İkili qruplaşdırıcını nümunə götürün. Əgər datanızın böyük bir hissəsi bir sinfə aiddirsə, həmin sinfə aid daha çox data olduğu üçün ML modeli həmin sinfi daha yüksək tezliklə proqnozlaşdıracaq. Datanı balanslaşdırmaq bu data əyrilərini yox edərək tarazsızlığı aradan qaldırır.
-
Artıq hər bir inqrediyent üzrə etiketlərin sayına baxa bilərsiniz:
print(f'new label count: {transformed_label_df.value_counts()}')
print(f'old label count: {df.cuisine.value_counts()}')
Nəticəniz belə olacaq:
new label count: korean 799 chinese 799 indian 799 japanese 799 thai 799 Name: cuisine, dtype: int64 old label count: korean 799 indian 598 chinese 442 japanese 320 thai 289 Name: cuisine, dtype: int64Artıq data təmiz, balanslı və çox ləzzətlidir!
-
Sonuncu addım balanslaşdırılmış datanı etiketlər və xarakteristikalar da daxil olmaqla fayla eksport oluna bilən bir halda saxlamaqdır:
transformed_df = pd.concat([transformed_label_df,transformed_feature_df],axis=1, join='outer') -
transformed_df.head()vətransformed_df.info()funksiyalarını çağırmaqla dataya sonuncu dəfə nəzər sala bilərsiniz. Bu datanın bir nüsxəsini gələcək dərslərdə istifadə etmək üçün saxlayın:transformed_df.head() transformed_df.info() transformed_df.to_csv("../data/cleaned_cuisines.csv")Bu yeni faylı artıq data qovluğunda tapa bilərsiniz.
🚀 Məşğələ
Bu proqramda bir neçə maraqlı dataset var. data qovluqlarına baxın. Bu qovluqlardan hansısa birində ikili və çox sinifli qruplaşdırıcı üçün uyğun ola biləcək datasetlər varmı? Onlar haqqında hansı sualları verərdiniz?
Mühazirə sonrası test
Təkrarlayın və özünüz öyrənin
SMOTE API-ni tədqiq edin. Bu ən çox hansı hallarda istifadə olunur? Hansı problemləri həll edir?