
14 KiB
Scikit-learn ilə reqressiya modelləri qurun: datanı hazırlayın və vizuallaşdırın
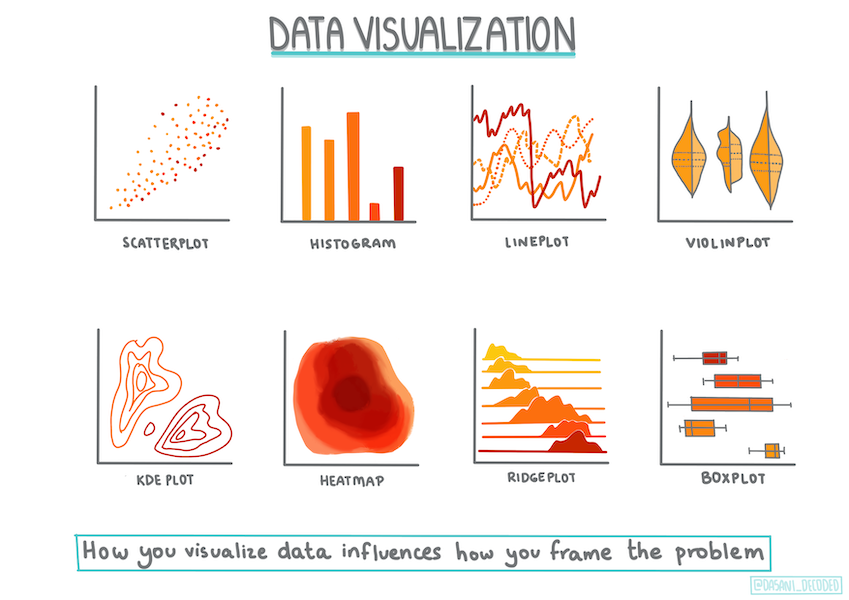
Dasani Madipalli tərəfindən yaradılmış infoqraf
Mühazirədən əvvəl test
Bu dərs R proqramlaşdırma dili ilə də mövcuddur!
Giriş
Artıq Scikit-learn ilə maşın öyrənməsi modelləri qurmaq üçün lazım olan alətləri quraşdırdığınız üçün datanız haqqında suallar soruşmağa hazırsınız. Data ilə işləyərkən və maşın öyrənməsi həlləri tətbiq edərkən data setinizin potensialını düzgün formada ortaya çıxarmağınız üçün düzgün sualı necə verməli olduğunuzu başa düşmək çox vacibdir.
Bu dərsdə siz:
- Datanızı model qurulması necə hazırlamağı
- Matplotlib data vizuallaşdırması üçün necə istifadə etməyi
öyrənəcəksiniz.
Datanızla bağlı sualı düzgün formada soruşmaq
Cavablayacağınız sual sizin hansı növ ML alqoritmlərindən faydalanacağınızı müəyyən edəcək. Alacağınız cavabın keyfiyyəti isə bilavasitə datanızın təbiətindən asılı olacaqdır.
Bu dərs üçün verilmiş dataya nəzər salın. Bu .csv faylını VS Code ilə aça bilərsiniz. Sürətli bir gözdən keçirmə ilə məlum olur ki, fayl boşluqlar, mətn və ədədi dataların qarışığından ibarətdir. Bundan əlavə, cədvəldə 'sacks', 'bins' və digər dəyərlərin qarışığından ibarət 'Package' adlı qəribə bir sütun da mövcuddur. Data, əslində, biraz qarışıqdır.
🎥 Bu dərs üçün datanın hazırlanmasının üzərindən keçən qısa video üçün yuxarıdakı şəkilin üzərinə klikləyin.
Faktiki olaraq, ML modeli qurmaq üçün tamamilə istifadəyə hazır bir data seti ilə təmin olunmaq o qədər də geniş yayılmayıb. Bu dərsdə siz xam data setini standart Python kitabxanalarının köməyi ilə necə hazır formaya gətirəcəyinizi öyrənəcəksiniz. Bundan əlavə, həmin dataların vizuallaşdırma texnikalarını da öyrənmiş olacaqsınız.
Araşdırma: 'balqabaq bazarı'
Bu qovluqda yerləşən data adlı qovluğunda siz, şəhərlər üzrə sıralanmış balqabaqlar bazarı haqqında 1757 sətirdən ibarət US-pumpkins.csv faylını tapacaqsınız. Bu xam data Amerika Birləşmiş Ştatlarının Kənd Təsərrüfatı Nazirliyi tərəfindən dərc olunmuş Xüsusi Bitkilər Terminal Bazarlarının Standart Hesabatlarından götürülmüşdür.
Datanın hazırlanması
Bu data publik domendə yerləşir. O Amerika Birləşmiş Ştatlarının Kənd Təsərrüfatı Nazirliyinin vebsaytından şəhərlər üzrə ayrı-ayrı fayllar olaraq yüklənilə bilər. Çoxlu ayrı-ayrı fayllardan yayınmaq üçün biz bütün şəhərlər üzrə olan dataları bir cədvələ yerləşdirmişik. Bununla az da olsa datanı hazırlamışıq. Növbəti addımda gəlin məlumatları daha diqqətlə nəzərdən keçirək.
Balqabaqlar datası - ilkin nəticələr
Bu məlumatlar barədə nələr diqqətinizi çəkdi? Artıq siz faylda kəsb etdiyi mənanı başa düşməli olduğunuz sözlər, ədədlər, boşluqlar və qəribə dəyərlərin qarışığını görmüsünüz.
Reqressiya metodundan istifadə edərək, bu data ilə bağlı hansı sualları soruşa bilərsiniz? Məsələn, "Müəyyən bir ay üçün balqabaqların satış qiymətini təxmin edin". Dataya yenidən nəzər yetirdikdə məlum olur ki, bu tapşırıq üçün lazım olan data strukturunu qurmaq üçün onun üzərində bəzi dəyişikliklər edilməlidir.
Tapşırıq - balqabaqlar datasını analiz edin
Gəlin bu balqabaqlar datasını analiz etmək və hazır formaya gətirmək üçün Pandas, (açılışı Python Data Analysis kimidir) alətindən istifadə edək.
Birinci, boş buraxılmış tarixləri yoxlayın
Boş buraxılan tarixləri yoxlamaq üçün ilk öncə bir neçə addımı icra etməliyik:
- Tarixləri ay formatına keçirdək (bu tarixlər ABŞ tarixləri olduğu üçün onların formatı
MM/DD/YYYYkimidir). - Ayı başqa sütuna köçürün.
notebook.ipynb faylını Visual Studio Code-da açın və cədvəli yeni Pandas datafreyminə köçürün.
-
İlk beş sətirə baxmaq üçün
head()funksiyasını istifadə edin.import pandas as pd pumpkins = pd.read_csv('../data/US-pumpkins.csv') pumpkins.head()✅ Son beş sətirə baxmaq üçün hansı funksiyadan istifadə edərsiniz?
-
Cari datafreymdə boş datanın olub-olmadığını yoxlayın:
pumpkins.isnull().sum()Boş datalar olsa da, düşünürük ki, hazırki tapşırıqda bunun bir önəmi olmayacaq.
-
Datafreym ilə işləməyi asanlaşdırmaq üçün orijinal datafreymdən sətirlər qrupunu (birinci parametr kimi ötürülür) və sütunları (ikinci parametr kimi ötürülür) çıxaran
locfunksiyasından istifadə edərək yalnız sizə lazım olan sütunları seçin. Nümunədəki:ifadəsi "bütün sətirlər" deməkdir.columns_to_select = ['Package', 'Low Price', 'High Price', 'Date'] pumpkins = pumpkins.loc[:, columns_to_select]
İkinci, balqabağın orta qiymətini təyin edin
Verilən ayda balqabağın orta qiymətini necə təyin edəcəyiniz barədə biraz düşünün. Bu tapşırıq üçün hansı sütunları seçəcəksiniz? İpucu: 3 sütuna ehtiyacınız olacaq.
Həll: yeni Price sütununu doldurmaq üçün Low Price və High Price sütunlarının ortalama dəyərini götürün və Date sütununu yalnız ayları göstərəcək formaya çevirin. Xoşbəxtlikdən, yuxarıdakı yoxlanışa görə tarixlər və qiymətlər üzrə boş data yoxdur.
-
Ortalamanı hesablamaq üçün aşağıdakı kodu əlavə edin:
price = (pumpkins['Low Price'] + pumpkins['High Price']) / 2

month = pd.DatetimeIndex(pumpkins['Date']).month
✅ İstədiyiniz datanı ekrana çap etdirmək üçün
print(month)istifadə edə bilərsiniz. -
İndi isə çevrilmiş datanızı Pandas datafreyminə kopyalayın:
new_pumpkins = pd.DataFrame({'Month': month, 'Package': pumpkins['Package'], 'Low Price': pumpkins['Low Price'],'High Price': pumpkins['High Price'], 'Price': price})Datafreyminizi ekrana çap etdirdikdə yeni reqressiya modeli qura biləcəyiniz təmiz, səliqəli bir data seti görəcəksiniz.
Amma gözləyin! Burada nəsə düz deyil
Package sütununa baxdıqda, balqabaqların fərqli konfiqurasiyalarda satıldığını görürük. Bəziləri '1 1/9 bushel' ölçüdə, bəziləri isə '1/2 bushel' ölçülərdə, bəziləri balqabaq başına, bəziləri funtla, bəziləri isə müxtəlif eni olan böyük qutularda satılır.
Görünür balqabaqları standart formada çəkmək çox çətindir.
İlkin məlumatlara nəzər yetirdikdə, Unit of Sale ilə 'EACH' və ya 'PER BIN'-ə bərabər olan hər şeyin həm də hər ədədinə, qab başına və ya 'hər biri' tipli Package növü var. Balqabaqları standart formada çəkmək çox çətin olduğu üçün, gəlin onları Package sütununda yalnız 'bushel' sətri olan balqabaqları seçərək filtirləyək.
-
Faylın başlıq hissəsinə, ilkin .csv köçürməsi etdiyiniz hissənin aşağısına filteri əlavə edin:
pumpkins = pumpkins[pumpkins['Package'].str.contains('bushel', case=True, regex=True)]Əgər indi datanı ekrana çap etdirsəniz, yalnız 415 sətiri və ya buşel ilə çəkilən balqabaqlardan ibarət data sıralarını görəcəksiniz.
Amma gözləyin! Ediləsi daha bir işimiz var
Hər sıraya görə buşelin miqdarının fərqləndiyinin fərqinə vardınız? Hər buşel başına düşən qiyməti göstərə bilməyiniz üçün riyaziyyatdan istifadə edərək normallaşdırma etməlisiniz.
-
new_pumpkins adlı datafreymi yaratdığınız hissədən sonra bu sətirləri əlavə edin:
new_pumpkins.loc[new_pumpkins['Package'].str.contains('1 1/9'), 'Price'] = price/(1 + 1/9)

new_pumpkins.loc[new_pumpkins['Package'].str.contains('1/2'), 'Price'] = price/(1/2)
✅ The Spruce Eats-ə görə bir buşelin ağırlığı, həcm ölçülməsi olduğu üçün məhsulun növündən asılı olaraq dəyişir. "Misal üçün, 1 buşel pomidor təxminən 56 funt gəldiyi halda, yarpaqlar və göyərtilər az çəki ilə daha çox yer tutduqları üçün, 1 buşel ispanaq 20 funt gəlir." Kifayət qədər mürəkkəbdir! Gəlin özümüzü buşeldən-funta köçürməsi ilə yükləməyək. Bunun əvəzinə, buşelə görə qiymət təyin edək. Bu buşellə balqabaq araşdırması sizə öz datanızın təbiətini başa düşməyinizin nə qədər vacib olduğunu göstərir.
Artıq siz, buşel ölçülərinə əsasən qiymətləri analiz edə bilərsiniz. Dataları yenidən ekrana çap etdirsəniz, onların necə standartlaşdırıldığını görəcəksiniz.
✅ Yarım buşel olaraq satılan balqabaqların çox baha olduğunun fərqinə vardınız? Səbəbini tapa bilərsiniz? İpucu: kiçik balqabaqların böyüklərdən qat-qat baha olmasının səbəbi, çox güman ki, bir böyük balqabağın buşeldə yaratdığı boş sahə ilə müqayisədə balaca balqabaqlardan həmin buşelə daha çox yerləşmələridir.
Vizuallaşdırma Texnikaları
Data mühəndislərinin vəzifələrinin bir hissəsi də üzərində işlədikləri datanın keyfiyyət və təbiətini göstərə bilmələridir. Bunu etmək üçün onlar tez-tez maraqlı vizuallar, datanın müxtəlif aspektlərini göstərmək məqsədilə qrafiklər qururlar. Bu yolla onlar, tapılması çətin olan əlaqələri və boşluqları vizual olaraq göstərməyə çalışırlar.
🎥 Bu dərs üçün datanın vizuallaşdırılmasının üzərindən keçən qısa video üçün yuxarıdakı şəkilin üzərinə klikləyin.
Vizuallaşdırma data üçün ən uyğun maşın öyrənməsi texnikasının təyin olunmasında da yardımçı olur. Məsələn, düz xətt üzrə inkişaf edən paylanma qrafiki bu datanın xətti reqressiya üçün uyğun namizəd olduğuna işarə edir.
Jupyter notbukları ilə əla formada işləyən data vizuallaşdırma kitabxanası Matplotlib-dir(keçən dərsdə gördüyünüz).
Bu təlimatlar ilə data vizuallaşdırılması ilə bağlı təcrübənizi artırın.
Tapşırıq - Matplotlib ilə təcrübə
Yaratdığınız datafreymi vizuallaşdırmaq üçün bir neçə qrafik yaratmağa çalışın.
-
Faylın başlıq hissəsində, Pandas-ı köçürdüyünüz hissənin aşağısında Matplotlib-i köçürün:
import matplotlib.pyplot as plt -
Yenilənmə üçün notbuku yenidən başladın.
-
Notbukun aşağı hissəsinə datanı qutu formasında təsvir etməsi üçün yeni xana əlavə edin:
price = new_pumpkins.Price
month = new_pumpkins.Month
plt.scatter(price, month)
plt.show()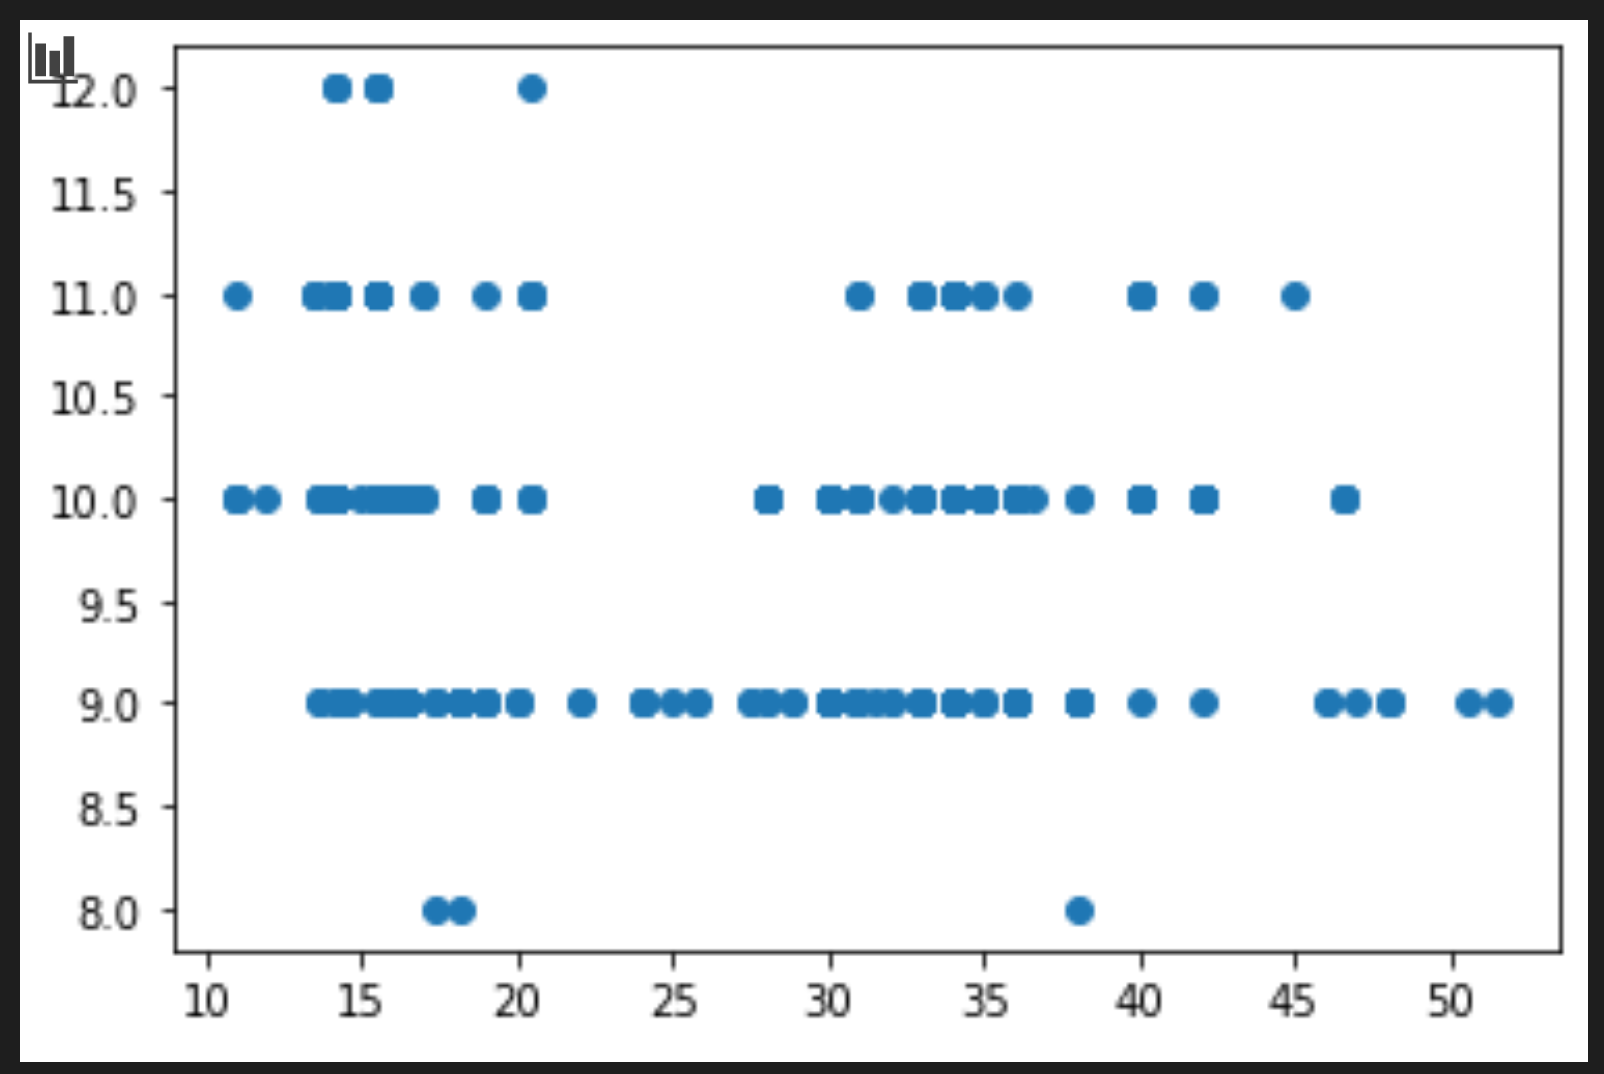
Bu qrafik faydalıdırmı? Sizi təəccübləndirən bir şey varmı?
Etdiyi tək şey datanızı verilən aylar üzrə nöqtələr toplusu kimi göstərmək olduğu üçün o qədər də faydalı hesab olunmur.
Onu faydalı et
Qrafiklərin yararlı informasiya göstərə bilməsi üçün adətən dataları hansısa yolla qruplaşdırmanıza ehtiyac yaranır. Gəlin y oxunun ayları, dataların isə məlumatın yayılmasını göstərdiyi bir qrafik qurmağa çalışaq.
-
Qruplaşdırılmış barqraf yaratmaq üçün yeni xana yaradın:
new_pumpkins.groupby(['Month'])['Price'].mean().plot(kind='bar')
plt.ylabel("Pumpkin Price")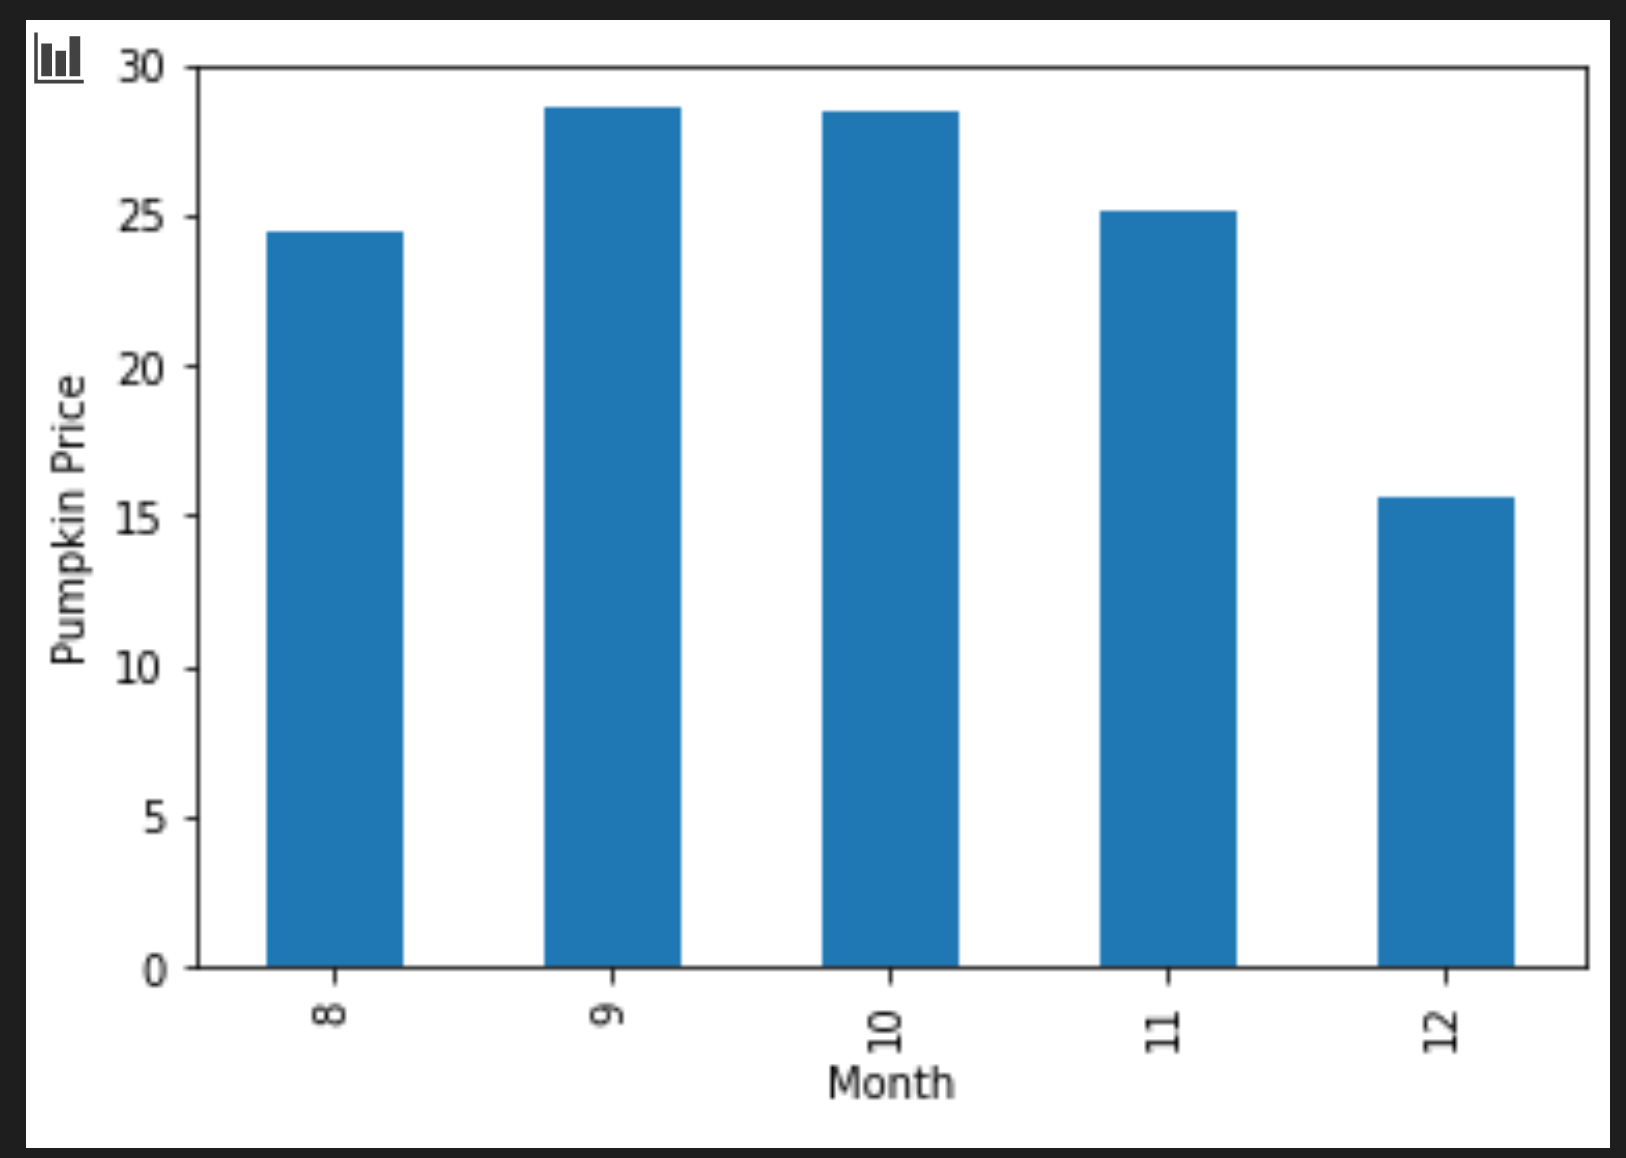
Bu daha faydalı data vizuallaşdırılması oldu! Deyəsən, balqabağın ən yüksək qiyməti sentyabr və oktyabr aylarına təsadüf edir. Bu sizin gözləntilərinizi qarşılayırmı? Niyə hə və ya niyə yox?
🚀 Məşğələ
Matplotlib-in təklif etdiyi müxtəlif vizuallaşdırma tiplərini araşdırın. Hansılar reqressiya problemləri üçün ən uyğunudur?
Mühazirə sonrası test
Təkrarlayın və özünüz öyrənin
Datanı vizuallaşdırmağın bir çox yolunu nəzərdən keçirin. Mövcud olan müxtəlif kitabxanaların siyahısını tərtib edin və verilən tapşırıq tipləri üçün ən yaxşısını qeyd edin. Məsələn, 2D və 3D vizuallaşdırma. Nə kəşf edirsiniz?