
16 KiB
Einstieg in Python und Scikit-learn für Regressionsmodelle
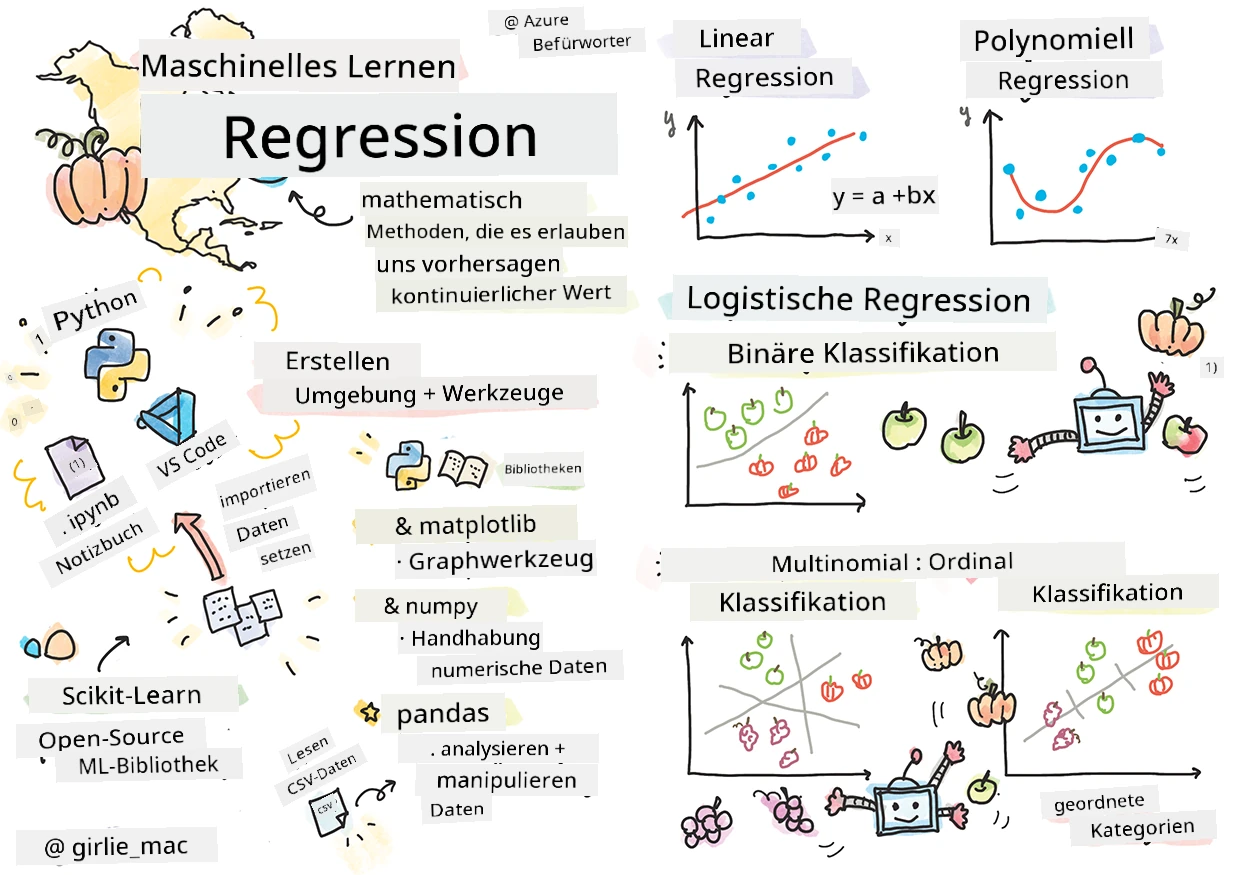
Sketchnote von Tomomi Imura
Quiz vor der Vorlesung
Diese Lektion ist auch in R verfügbar!
Einführung
In diesen vier Lektionen werden Sie entdecken, wie man Regressionsmodelle erstellt. Wir werden gleich besprechen, wozu diese dienen. Aber bevor Sie irgendetwas tun, stellen Sie sicher, dass Sie die richtigen Werkzeuge haben, um zu starten!
In dieser Lektion lernen Sie:
- Wie Sie Ihren Computer für lokale Machine Learning Aufgaben konfigurieren.
- Wie Sie mit Jupyter Notebooks arbeiten.
- Wie Sie Scikit-learn verwenden, einschließlich Installation.
- Wie Sie lineare Regression mit einer praktischen Übung erkunden.
Installationen und Konfigurationen

🎥 Klicken Sie auf das obige Bild für ein kurzes Video, das die Konfiguration Ihres Computers für ML erklärt.
- Installieren Sie Python. Stellen Sie sicher, dass Python auf Ihrem Computer installiert ist. Sie werden Python für viele Data Science und Machine Learning Aufgaben nutzen. Die meisten Computersysteme haben bereits eine Python-Installation. Es gibt auch nützliche Python Coding Packs, die einigen Nutzern die Einrichtung erleichtern.
Einige Anwendungen von Python erfordern jedoch unterschiedliche Softwareversionen. Daher ist es sinnvoll, innerhalb einer virtuellen Umgebung zu arbeiten.
- Installieren Sie Visual Studio Code. Stellen Sie sicher, dass Visual Studio Code auf Ihrem Computer installiert ist. Folgen Sie diesen Anweisungen, um Visual Studio Code zu installieren für die grundlegende Installation. Sie werden in diesem Kurs Python in Visual Studio Code verwenden, daher könnte es hilfreich sein, sich anzuschauen, wie man Visual Studio Code für die Python-Entwicklung konfiguriert.
Machen Sie sich mit Python vertraut, indem Sie diese Sammlung von Lernmodulen durcharbeiten.
🎥 Klicken Sie auf das obige Bild für ein Video: Python innerhalb von VS Code verwenden.

-
Installieren Sie Scikit-learn, indem Sie diesen Anweisungen folgen. Da Sie sicherstellen müssen, dass Sie Python 3 verwenden, wird empfohlen, eine virtuelle Umgebung zu nutzen. Beachten Sie, dass es spezielle Anweisungen für die Installation auf einem M1 Mac gibt, auf die oben verlinkte Seite verweist.
-
Installieren Sie Jupyter Notebook. Sie müssen das Jupyter-Paket installieren.
Ihre ML-Entwicklungsumgebung
Sie werden Notebooks verwenden, um Ihren Python-Code zu entwickeln und Machine Learning Modelle zu erstellen. Diese Dateitypen sind ein übliches Werkzeug für Data Scientists und sind an ihrer Endung .ipynb zu erkennen.
Notebooks sind eine interaktive Umgebung, die es dem Entwickler erlauben, sowohl Code zu schreiben als auch Notizen und Dokumentationen rund um den Code hinzuzufügen, was besonders hilfreich für experimentelle oder forschungsorientierte Projekte ist.

🎥 Klicken Sie auf das obige Bild für ein kurzes Video, das Sie durch diese Übung führt.
Übung - Arbeiten mit einem Notebook
In diesem Ordner finden Sie die Datei notebook.ipynb.
-
Öffnen Sie notebook.ipynb in Visual Studio Code.
Ein Jupyter-Server startet mit Python 3+. In dem Notebook finden Sie Bereiche, die Sie
ausführenkönnen, Codeabschnitte. Um einen Codeblock auszuführen, wählen Sie das Symbol, das wie ein Play-Button aussieht. -
Wählen Sie das
md-Icon und fügen Sie etwas Markdown hinzu, und folgenden Text # Willkommen in Ihrem Notebook.Fügen Sie anschließend etwas Python-Code ein.
-
Tippen Sie print('hello notebook') in den Codeblock.
-
Wählen Sie den Pfeil, um den Code auszuführen.
Sie sollten die gedruckte Anweisung sehen:
hello notebook
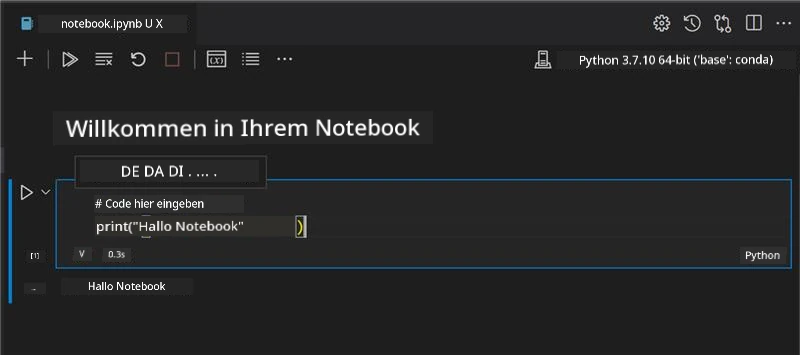
Sie können Ihren Code mit Kommentaren durchziehen, um das Notebook selbst zu dokumentieren.
✅ Denken Sie einen Moment darüber nach, wie unterschiedlich die Arbeitsumgebung eines Webentwicklers im Vergleich zu der eines Data Scientists ist.
Startklar mit Scikit-learn
Jetzt, da Python in Ihrer lokalen Umgebung eingerichtet ist und Sie mit Jupyter Notebooks vertraut sind, lassen Sie uns die gleiche Sicherheit mit Scikit-learn gewinnen (ausgesprochen sci wie in science). Scikit-learn bietet eine umfangreiche API, um Ihnen bei ML-Aufgaben zu helfen.
Laut ihrer Webseite ist "Scikit-learn eine Open-Source-Machine-Learning-Bibliothek, die überwachte und unüberwachte Lernmethoden unterstützt. Sie bietet auch verschiedene Werkzeuge zur Modellanpassung, Datenvorverarbeitung, Modellauswahl und -bewertung sowie viele weitere Hilfsmittel."
In diesem Kurs verwenden Sie Scikit-learn und andere Werkzeuge, um Machine Learning Modelle zu erstellen, die sogenannte „traditionelle Machine Learning“-Aufgaben durchführen. Wir vermeiden bewusst neuronale Netze und Deep Learning, da diese besser in unserem bald erscheinenden „KI für Anfänger“-Lehrplan behandelt werden.
Scikit-learn macht es einfach, Modelle zu bauen und zu evaluieren. Es konzentriert sich hauptsächlich auf die Nutzung numerischer Daten und enthält mehrere fertige Datensätze als Lernwerkzeuge. Außerdem beinhaltet es vorgefertigte Modelle, die die Studierenden ausprobieren können. Lassen Sie uns den Prozess erkunden, vorverpackte Daten zu laden und einen eingebauten Schätzer zu verwenden, um mit einigen Basisdaten Ihr erstes ML-Modell in Scikit-learn zu erstellen.
Übung - Ihr erstes Scikit-learn Notebook
Dieses Tutorial wurde inspiriert von dem Lineare Regression Beispiel auf der Scikit-learn-Webseite.

🎥 Klicken Sie auf das obige Bild für ein kurzes Video, das Sie durch diese Übung führt.
Im notebook.ipynb-Datei, die zu dieser Lektion gehört, löschen Sie alle Zellen, indem Sie das 'Mülleimer'-Symbol drücken.
In diesem Abschnitt arbeiten Sie mit einem kleinen Datensatz über Diabetes, der zu Lernzwecken in Scikit-learn eingebaut ist. Stellen Sie sich vor, Sie wollten eine Behandlung für Diabetiker testen. Machine Learning Modelle könnten Ihnen helfen zu bestimmen, welche Patienten besser auf die Behandlung reagieren würden, basierend auf Kombinationen von Variablen. Selbst ein sehr einfaches Regressionsmodell kann, wenn es visualisiert wird, Informationen über Variablen zeigen, die Ihnen helfen könnten, Ihre theoretischen klinischen Studien zu organisieren.
✅ Es gibt viele Arten von Regressionsmethoden, und welche Sie wählen, hängt von der Antwort ab, die Sie suchen. Wenn Sie die wahrscheinliche Körpergröße einer Person eines gegebenen Alters vorhersagen wollen, verwenden Sie lineare Regression, da Sie einen numerischen Wert suchen. Wenn Sie herausfinden wollen, ob eine Art von Küche als vegan angesehen werden sollte oder nicht, suchen Sie eine Kategoriezuteilung, dann würden Sie logistische Regression verwenden. Später lernen Sie mehr über logistische Regression. Denken Sie ein bisschen über Fragen nach, die Sie an Daten stellen können, und welche dieser Methoden dafür besser geeignet wären.
Lassen Sie uns mit dieser Aufgabe beginnen.
Bibliotheken importieren
Für diese Aufgabe importieren wir einige Bibliotheken:
- matplotlib. Es ist ein nützliches Graphing-Tool und wir werden es verwenden, um ein Liniendiagramm zu erstellen.
- numpy. numpy ist eine nützliche Bibliothek für die Verarbeitung numerischer Daten in Python.
- sklearn. Das ist die Scikit-learn Bibliothek.
Importieren Sie einige Bibliotheken, die Ihnen bei Ihren Aufgaben helfen.
-
Fügen Sie Importe hinzu, indem Sie den folgenden Code eintippen:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
Oben importieren Sie
matplotlib,numpyund aussklearnimportieren Siedatasets,linear_modelundmodel_selection.model_selectionwird verwendet, um Daten in Trainings- und Testsets aufzuteilen.
Der Diabetes-Datensatz
Der eingebaute Diabetes-Datensatz enthält 442 Stichproben zu Diabetes, mit 10 Merkmalvariablen, darunter:
- Alter: Alter in Jahren
- bmi: Body-Mass-Index
- bp: durchschnittlicher Blutdruck
- s1 tc: T-Zellen (eine Art von weißen Blutkörperchen)
✅ Dieser Datensatz enthält das Konzept „Geschlecht“ als wichtige Merkmalsvariable für die Diabetesforschung. Viele medizinische Datensätze beinhalten diese Art binärer Klassifikation. Denken Sie darüber nach, wie solche Kategorisierungen bestimmte Teile der Bevölkerung möglicherweise von Behandlungen ausschließen.
Laden Sie nun die Daten X und y.
🎓 Denken Sie daran, dies ist überwachtes Lernen, und wir benötigen eine benannte Zielvariable „y“.
Laden Sie in einer neuen Code-Zelle den Diabetes-Datensatz durch den Aufruf von load_diabetes(). Der Parameter return_X_y=True signalisiert, dass X eine Datenmatrix ist und y das Regressionsziel.
-
Fügen Sie einige print-Befehle hinzu, um die Form der Datenmatrix und ihr erstes Element anzuzeigen:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Was Sie als Antwort zurückbekommen, ist ein Tupel. Sie weisen die beiden ersten Werte des Tupels
Xundyzu. Lernen Sie mehr über Tupel.Sie sehen, dass diese Daten 442 Elemente enthalten, die in Arrays mit 10 Elementen geformt sind:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Denken Sie ein wenig über die Beziehung zwischen den Daten und dem Regressionsziel nach. Lineare Regression sagt Beziehungen zwischen dem Merkmal X und der Zielvariable y voraus. Können Sie das Ziel für den Diabetes-Datensatz in der Dokumentation finden? Was zeigt dieser Datensatz, basierend auf diesem Ziel?
-
Wählen Sie nun einen Teil dieses Datensatzes für das Plotten aus, indem Sie die 3. Spalte des Datensatzes auswählen. Sie können dies tun, indem Sie
:verwenden, um alle Zeilen zu wählen, und dann die 3. Spalte mit dem Index (2) auswählen. Sie können die Daten auch in ein 2D-Array umformen – wie für das Plotten erforderlich – mitreshape(n_rows, n_columns). Wenn einer der Parameter -1 ist, wird die entsprechende Dimension automatisch berechnet.X = X[:, 2] X = X.reshape((-1,1))✅ Geben Sie jederzeit die Daten aus, um deren Form zu überprüfen.
-
Jetzt, da Sie Daten zum Plotten bereit haben, sehen Sie, ob eine Maschine helfen kann, eine logische Aufteilung zwischen den Zahlen in diesem Datensatz zu bestimmen. Dafür müssen Sie die Daten (X) und das Ziel (y) in Test- und Trainingssets aufteilen. Scikit-learn bietet einen einfachen Weg dazu; Sie können Ihre Testdaten an einem gegebenen Punkt aufteilen.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Jetzt sind Sie bereit, Ihr Modell zu trainieren! Laden Sie das lineare Regressionsmodell und trainieren Sie es mit Ihren X- und y-Trainingssets mit
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()ist eine Funktion, die Sie in vielen ML-Bibliotheken wie TensorFlow sehen werden. -
Erstellen Sie dann eine Vorhersage mit Testdaten mittels der Funktion
predict(). Diese wird verwendet, um die Linie zwischen den Datengruppen zu zeichnen.y_pred = model.predict(X_test) -
Nun ist es Zeit, die Daten in einem Diagramm anzuzeigen. Matplotlib ist hierfür ein sehr nützliches Werkzeug. Erstellen Sie ein Streudiagramm aller X- und y-Testdaten und verwenden Sie die Vorhersage, um eine Linie an der passendsten Stelle zwischen den Datencluster des Modells zu zeichnen.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()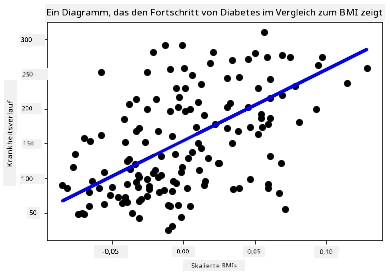
✅ Denken Sie ein wenig darüber nach, was hier passiert. Eine gerade Linie läuft durch viele kleine Datenpunkte, aber was tut sie genau? Können Sie erkennen, wie Sie diese Linie verwenden können, um vorherzusagen, wo ein neuer, ungesehener Datenpunkt in Bezug auf die y-Achse des Plots passen sollte? Versuchen Sie, den praktischen Nutzen dieses Modells in Worte zu fassen.
Herzlichen Glückwunsch, Sie haben Ihr erstes lineares Regressionsmodell gebaut, eine Vorhersage erstellt und diese in einem Diagramm dargestellt!
🚀Herausforderung
Plotten Sie eine andere Variable aus diesem Datensatz. Tipp: Bearbeiten Sie diese Zeile: X = X[:,2]. Was können Sie über den Verlauf von Diabetes als Krankheit herausfinden, basierend auf dem Ziel dieses Datensatzes?
Quiz nach der Vorlesung
Rückblick & Selbststudium
In diesem Tutorial haben Sie mit einfacher linearer Regression gearbeitet, nicht mit univariater oder multipler linearer Regression. Lesen Sie ein wenig über die Unterschiede zwischen diesen Methoden oder sehen Sie sich dieses Video an.
Lesen Sie mehr über das Konzept der Regression und überlegen Sie, welche Arten von Fragen mit dieser Technik beantwortet werden können. Nehmen Sie an diesem Tutorial teil, um Ihr Verständnis zu vertiefen.
Aufgabe
Haftungsausschluss: Dieses Dokument wurde mit dem KI-Übersetzungsdienst Co-op Translator übersetzt. Obwohl wir uns um Genauigkeit bemühen, beachten Sie bitte, dass automatisierte Übersetzungen Fehler oder Ungenauigkeiten enthalten können. Das Originaldokument in seiner Ursprungssprache gilt als maßgebliche Quelle. Bei kritischen Informationen wird eine professionelle menschliche Übersetzung empfohlen. Wir übernehmen keine Haftung für Missverständnisse oder Fehlinterpretationen, die aus der Verwendung dieser Übersetzung entstehen.