
5.0 KiB
Gücləndirilmiş öyrənməyə giriş
Gücləndirilmiş öyrənmə, RL(Reinforcment Learning), nəzarətli və nəzarətsiz öyrənmənin yanında əsas maşın öyrənmə paradiqmalarından biri kimi qeyd olunur. RL qərarlar haqqındadır: düzgün qərarları vermək və ya ən azı onlardan öyrənmək.
Təsəvvür edin ki, birja kimi simulyasiya edilmiş bir mühitiniz var. Müəyyən bir tənzimləmə tətbiq etsəniz nə baş verər? Bunun müsbət və ya mənfi təsirləri varmı? Mənfi bir şey baş verərsə, bu mənfi gücləndirməni götürməli, ondan dərs almalı və kursu dəyişməlisiniz. Əgər bu müsbət nəticədirsə, siz həmin müsbət gücləndirməyə əsaslanmalısınız.
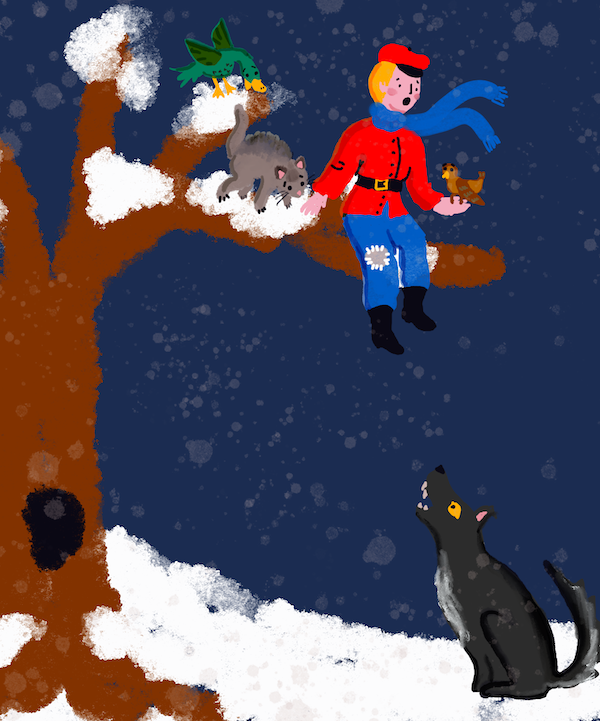
Piter və onun dostları ac canavardan qaçmalıdırlar! Şəkili Jen Looper çəkmişdir.
Regional mövzu: Piter və Qurd (Rusiya)
Piter və Qurd — rus bəstəkarı Sergei Prokofyev tərəfindən yazılmış musiqili nağıldır. O canavarı qovmaq üçün cəsarətlə evindən çıxaraq meşənin təmizlənməsinə gedən gənc pioner Piter haqqındadır. Bu bölmədə biz Piterə kömək edəcək maşın öyrənmə alqoritmlərini öyrədəcəyik:
- Ətrafı araşdırın və optimal naviqasiya xəritəsi qurun
- Daha sürətli hərəkət etmək üçün skeytborddan necə istifadə etməyi və onun üzərində tarazlığı qorumağı öyrənin.
🎥 Prokofyevin Piter və Qurd musiqisini dinləmək üçün yuxarıdakı şəkilə klikləyin
Gücləndirilmiş öyrənmə
Əvvəlki bölmələrdə siz maşın öyrənmə problemlərinin iki nümunəsini görmüsünüz:
- Nəzarət edilən öyrənmədə həll etmək istədiyimiz problemə nümunə həllər təklif edən verilənlər bazamız var idi. Təsnifat və reqressiya nəzarət edilən öyrənmə tapşırıqlarıdır.
- Nəzarətsiz öyrənmədə isə bizim etiketli təlim datalarımız yoxdur. Nəzarətsiz öyrənmənin əsas nümunəsi Klasterləşdirmə-dir.
Bu bölmədə biz sizi etiketli təlim məlumatı tələb etməyən yeni tip öyrənmə problemi ilə tanış edəcəyik. Belə problemlərin bir neçə növü var:
- Yarı nəzarətli öyrənmədə modeli əvvəlcədən öyrətmək üçün istifadə edilə bilən çoxlu etiketlənməmiş datamız var.
- Gücləndirilmiş öyrənmədə isə, agent simulyasiya edilmiş mühitdə eksperimentlər həyata keçirərək özünü necə aparmağı öyrənir.
Nümunə - kompüter oyunu
Tutaq ki, siz kompüterə şahmat və ya Super Mario kimi oyun oynamağı öyrətmək istəyirsiniz. Kompüterin oyun oynaması üçün ona oyun vəziyyətlərinin hər birində hansı hərəkəti edəcəyini proqnozlaşdırmaq lazımdır. Bu təsnifat problemi kimi görünsə də, belə deyil - çünki bizdə vəziyyətlər və müvafiq hərəkətlər olan verilənlər bazası yoxdur. Mövcud şahmat matçları və ya Super Mario oynayan oyunçuların qeydə alınması kimi bəzi məlumatlarımız olsa da, çox güman ki, bu məlumatlar kifayət qədər çox sayda mümkün vəziyyəti əhatə etməyəcək.
Mövcud oyun datalarını axtarmaq əvəzinə, Gücləndirilmiş Öyrənmə (RL) kompüteri dəfələrlə oynatmaq və nəticəni müşahidə etmək ideyasına əsaslanır. Beləliklə, Gücləndirilmiş Öyrənmə tətbiq etmək üçün bizə iki şey lazımdır:
-
Bir mühit və bir simulyator bizə dəfələrlə oyun oynamağa imkan verir. Bu simulyator bütün oyun qaydalarını, eləcə də mümkün vəziyyətləri və hərəkətləri müəyyən edəcək.
-
Mükafat funksiyası, bu, bizə hər bir hərəkət və ya oyun zamanı nə qədər yaxşı etdiyimizi bildirir.
Maşın öyrənmənin digər növləri ilə RL arasındakı əsas fərq ondan ibarətdir ki, RL-də biz adətən oyunu bitirənə qədər qalib və ya uduzduğumuzu bilmirik. Buna görə də, hansısa bir hərəkətin yaxşı olub olmadığını deyə bilmərik. Çünki yalnız oyunun sonunda mükafat alırıq və bizim məqsədimiz qeyri-müəyyən şəraitdə modeli öyrətməyə imkan verəcək alqoritmləri qurmaqdır. Biz Q-öyrənməsi adlı bir RL alqoritmini öyrənəcəyik.
Dərslər
Tövhə verənlər
"Gücləndirilmiş öyrənməyə giriş" Dmitri Soşnikov tərəfindən ♥️ ilə yazılmışdır.