
15 KiB
Dəstək vektor reqressoru ilə zaman seriyalarının proqnozlaşdırılması
Əvvəlki dərsdə ARIMA modeli istifadə etməklə necə zaman seriyalarını proqnozlaşdıra biləcəyini öyrəndin. İndi isə Dəstək vektor reqressor modeli ilə davalı datanın gələcəyini təxmin etməyə baxacaqsan.
Mühazirə öncəsi quiz
Giriş
Bu dərsdə sən DVM: Dəstək Vektor Maşını(SVM: Support Vector Machine) istifadə etməklə reqressiya və ya SVR: Dəstək Vektor Reqressiyası üçün xüsusi modellər qurmağı öyrənəcəksən.
Zaman seriyası məsələlərində SVR 1
SVR-ın zaman seriyaları proqnozlarında vacibliyini başa düşməzdən əvvəl bəzi vacib anlayışları bilməyin lazımdır:
-
Reqressiya: Verilmiş dəyərlər toplusundan davamlı dəyərlərin proqnozlaşdırılması üçün nəzarətli öyrənmə texnikasıdır. Burda əsas məqsəd maksimum sayda data nöqtələrinin uyğunluq əyrisinə (və ya xəttinə) yaxın olmasıdır. Daha ətraflı məlumat üçün bura klikləyin.
-
Dəstək Vektor Maşını (SVM): Bu qruplaşdırma, reqressiya və uyğunsuzluqların təyin olunması üçün istifadə olunan nəzarətli maşın öyrənmə modellərindən biridir. Bu model funksiya fəzasında hiperplandır, hansı ki, qruplaşdırma tətbiqində sərhəd kimi və reqressiyada isə ən uyğun xətt kimi rol oynayır. SVM-də Kernel funksiyası əsasən dataseti çöx ölçülü fəzaya çevirmək üçün istifadə olunur, beləliklə onları bölmək daha asan olur. SVM-lər baərdə daha ətralı məlumat üçün bura bura klikləyin.
-
Dəstək Vektor Reqressoru (SVR): Maksimum sayda data nöqtəsinin ən uyğun gələn xətti (SVM halında hiperplan) tapmaq üçün istifadə olunan SVM tiplərindən biridir.
Nə üçün SVR? 1
Son dərsdə zaman seriya datalarının proqnozlaşdırılması üçün tətbiq olunan uğurlu statistik xətti üsul ARIMA barədə öyrəndin. Lakin, bir çox hallarda zaman seriya dataları qeyri-xətti olurlar və onları xətti modellərlə uyğunlaşdırmaq olmur Bu hallarda SVM-in qeyri-xətti dataların reqressiya tapşırıqlarda bacarıqlarını nəzərə alaraq SVR-ı zaman seriyası proqnozlaşdırılmasında da uğurla istifadə etmək olar.
Tapşırıq - SVR modeli qur
Data hazırlanmasında ilk addımlar əvvəlki ARIMA dərsindəki kimidir.
Bu dərsin /working qovluğunu açın və notebook.ipynb faylını tapın.2
-
Notbuku icra edin və lazımi kitabxanaları daxil edin: 2
import sys
sys.path.append('../../')
import os import warnings import matplotlib.pyplot as plt import numpy as np import pandas as pd import datetime as dt import math from sklearn.svm import SVR from sklearn.preprocessing import MinMaxScaler from common.utils import load_data, mape -
/data/energy.csvfaylından dataları Pandas datablokuna yığın və nəticəyə baxın: 2energy = load_data('../../data')[['load']] -
2012-ci il yanvar ayından 2014-ci il dekabr ayına kimi olan bütün enerji datalarının qrafikini çəkin: 2
energy.plot(y='load', subplots=True, figsize=(15, 8), fontsize=12)
plt.xlabel('timestamp', fontsize=12)
plt.ylabel('load', fontsize=12)
plt.show()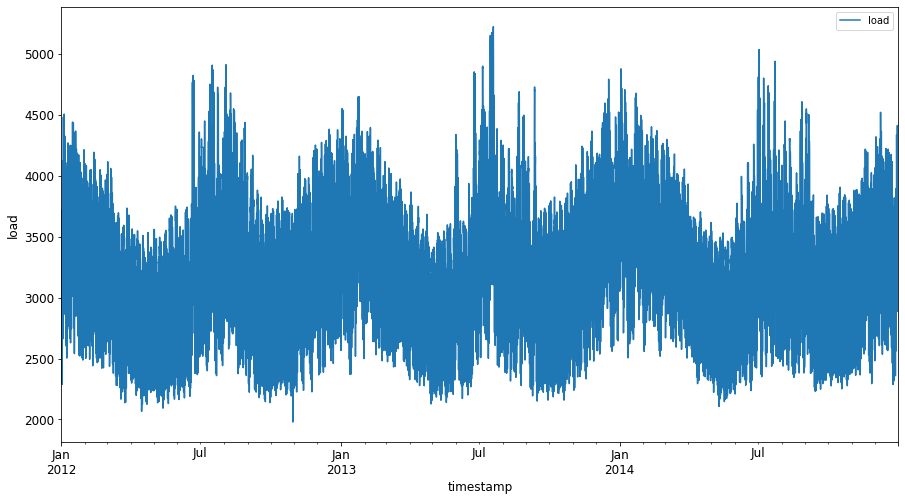
İndi isə SVR modelini quraq.
Öyrətmə və test datasetlərini yaradın
İndi data yüklənib və sən onu öyrətmə və test qruplarına ayıra bilərsən. Sonra sənin datanı SVR üçün lazım olan zaman attımları ilə ayrılmış datasetə çevirməyin lazım olacaq. Modelini öyrətmə seti ilə öyrədəcəksən. Model öyrənməsi bitdikdən sonra onun dəqiqliyini əvvəlcə öyrənmə və test seti ilə, sonra isə bütün dataset ilə yoxlayıb ümumi performansını ölçəcəksən. Sən əmin olmalısan ki, test setin öyrənmə setinin əhatə etdiyi zaman periodundan gələcəyi də əhatə edir və modelin gələcək zamandan informasiya almır 2 (bu vəziyyətə Overfitting deyilir).
-
2014-cü il sentabrın 1-dən oktyabrın 31-ə kimi 2 aylıq periodu öyrənmə seti kimi ayır. Test setin isə növbəti iki ayı, noyabrın 1-dən dekabrın 31-ə kimi olan dataları əhatə edəcək: 2
train_start_dt = '2014-11-01 00:00:00' test_start_dt = '2014-12-30 00:00:00' -
Fərqi göstər: 2
energy[(energy.index < test_start_dt) & (energy.index >= train_start_dt)][['load']].rename(columns={'load':'train'}) \
    .join(energy[test_start_dt:][['load']].rename(columns={'load':'test'}), how='outer') \
    .plot(y=['train', 'test'], figsize=(15, 8), fontsize=12)
plt.xlabel('timestamp', fontsize=12)
plt.ylabel('load', fontsize=12)
plt.show()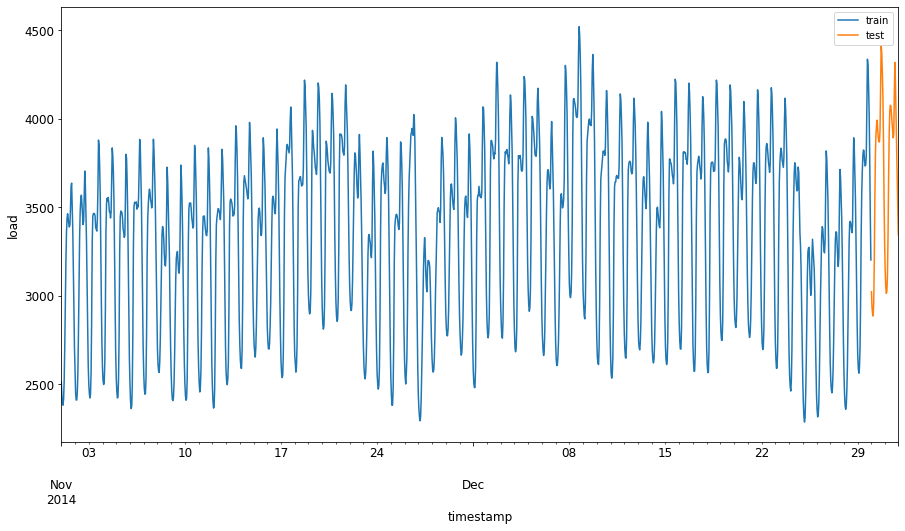
Öyrətmə üçün data hazırla
İnsi sənin datanı filtrasiya və miqyasını dəyişmə əməliyyatları tətbiq etməklə öyrətmə üçün data hazırlamağın lazımdır. Dataseti filtrasiya edərək yalnız lazım olan zaman periodları və sütunlarını saxla və datanın 0 ilə 1 arasında yerləşdiyinə əmin olacaq şəkildə miqyasını dəyiş.
-
Verilan dataseti əvvəl nəzərdə tutulan zaman periodlarına əsasən filtr et və lazım olan 'load' və tarix sütunlarını saxla: 2
train = energy.copy()[(energy.index >= train_start_dt) & (energy.index < test_start_dt)][['load']]
test = energy.copy()[energy.index >= test_start_dt][['load']]

print('Training data shape: ', train.shape)
print('Test data shape: ', test.shape)
Training data shape: (1416, 1) Test data shape: (48, 1) -
Öyrətmə datasetini (0, 1) miqyasına çevir: 2
scaler = MinMaxScaler() train['load'] = scaler.fit_transform(train) -
İndi isə test datasetini miqyasını dəyiş: 2
test['load'] = scaler.transform(test)
Zaman addımları ilə data yarat 1
SVR üçün verilən datanı [batch, timesteps] formatına çevirməyin lazımdır. İndi sən mövcud olan train_data və test_data datasetlərinin formasını yeni ölçüdə - zaman addımları ilə bölünmüş formaya çevirməyin lazımdır.
# Converting to numpy arrays
train_data = train.values
test_data = test.values
Bu nümunədə biz timesteps = 5 parametrini istifadə edirik. Yəni verilən dataların ilk 4 zaman addımındakı datalar modelə giriş kimi istifadə olunacaq və nəticə 5-cü addım üçün data olacaq.
timesteps=5
Öyrətmə datasını iç-içə yığılmış siyahıdan istifadə etməklə 2D tensor formasına çeviririk:
train_data_timesteps=np.array([[j for j in train_data[i:i+timesteps]] for i in range(0,len(train_data)-timesteps+1)])[:,:,0]
train_data_timesteps.shape
(1412, 5)
Test datasını 2D tensora çevirik:
test_data_timesteps=np.array([[j for j in test_data[i:i+timesteps]] for i in range(0,len(test_data)-timesteps+1)])[:,:,0]
test_data_timesteps.shape
(44, 5)
Öyrətmə və test datalarından giriş və çıxış dəyərlərini seçirik:
x_train, y_train = train_data_timesteps[:,:timesteps-1],train_data_timesteps[:,[timesteps-1]]
x_test, y_test = test_data_timesteps[:,:timesteps-1],test_data_timesteps[:,[timesteps-1]]

print(x_train.shape, y_train.shape)
print(x_test.shape, y_test.shape)
(1412, 4) (1412, 1)
(44, 4) (44, 1)
SVR tətbiq et 1
İndi SVR tətbiq etmək zamanıdır. Bu tətbiq barədə daha ətraflı məlumat üçün bu sənədə baxa bilərsiniz. Bizim tətbiq üçün bu addımları izləmək lazımdır:
SVR()çağıraraq modeli təyin et və modelə bu hiperparametrləri ötür: kernel, gamma, c və epsilonfit()funksiyası ilə modeli öyrətmə datası üçün hazırla- Proqnozları
predict()funksiyasını çağırmaqla əldə edə bilərsən
Biz artıq SVR modeli hazırladıq. Burada biz RBF kerneli istifadə etdik, gamma, C və epsilon hiperparametrlərinə 0.5, 10 və 0.05 dəyərlərini verdik.
model = SVR(kernel='rbf',gamma=0.5, C=10, epsilon = 0.05)
Öyrətmə datasına modeli uyğunlaşdırmaq 1
model.fit(x_train, y_train[:,0])
SVR(C=10, cache_size=200, coef0=0.0, degree=3, epsilon=0.05, gamma=0.5,
    kernel='rbf', max_iter=-1, shrinking=True, tol=0.001, verbose=False)
Modeldən proqnozlar əldə edin 1
y_train_pred = model.predict(x_train).reshape(-1,1)
y_test_pred = model.predict(x_test).reshape(-1,1)

print(y_train_pred.shape, y_test_pred.shape)
(1412, 1) (44, 1)
Sən SVR modeli yaratdın! Bizə onun dəqiqliyini ölçmək lazımdır.
Modelin dəqiqliyini ölç 1
Yoxlama üçün biz birinci olaraq datanı əvvəlki miqyasına geri qaytarmalıyıq. SOnra performansı yoxlamaq üçün biz əsl və proqnozlaşdırılan zaman seriyalarının qrafikini çəkəcəyik və MAPE nəticələrini konsola yazacağıq.
Proqnozlaşdırılmış və orijinal datanın miqyasını dəyiş:
# proqnozların miqyasının dəyişdirilməsi
y_train_pred = scaler.inverse_transform(y_train_pred)
y_test_pred = scaler.inverse_transform(y_test_pred)

print(len(y_train_pred), len(y_test_pred))
# orijinal dəyərlərin miqyasının dəyişdirilməsi
y_train = scaler.inverse_transform(y_train)
y_test = scaler.inverse_transform(y_test)

print(len(y_train), len(y_test))
Modelin performansını öyrətmə və yoxlama datası ilə yoxla 1
Biz datasetdən zaman məlumatlarını qrafikin x xəttində göstərmək üçün götürmüşük. Nəzərə al ki biz birinci timesteps-1 dəyərlərini birinci çıxış dəyərlərini hesablamağa giriş kimi istifadə etmişik, yəni bundan sonrakı zaman dəyərləri əsas çıxış dəyərləri üçün istifadə olunacaq.
train_timestamps = energy[(energy.index < test_start_dt) & (energy.index >= train_start_dt)].index[timesteps-1:]
test_timestamps = energy[test_start_dt:].index[timesteps-1:]

print(len(train_timestamps), len(test_timestamps))
1412 44
Öyrətmə datası üzərindən proqnozları qrafikdə çək:
plt.figure(figsize=(25,6))
plt.plot(train_timestamps, y_train, color = 'red', linewidth=2.0, alpha = 0.6)
plt.plot(train_timestamps, y_train_pred, color = 'blue', linewidth=0.8)
plt.legend(['Actual','Predicted'])
plt.xlabel('Timestamp')
plt.title("Training data prediction")
plt.show()
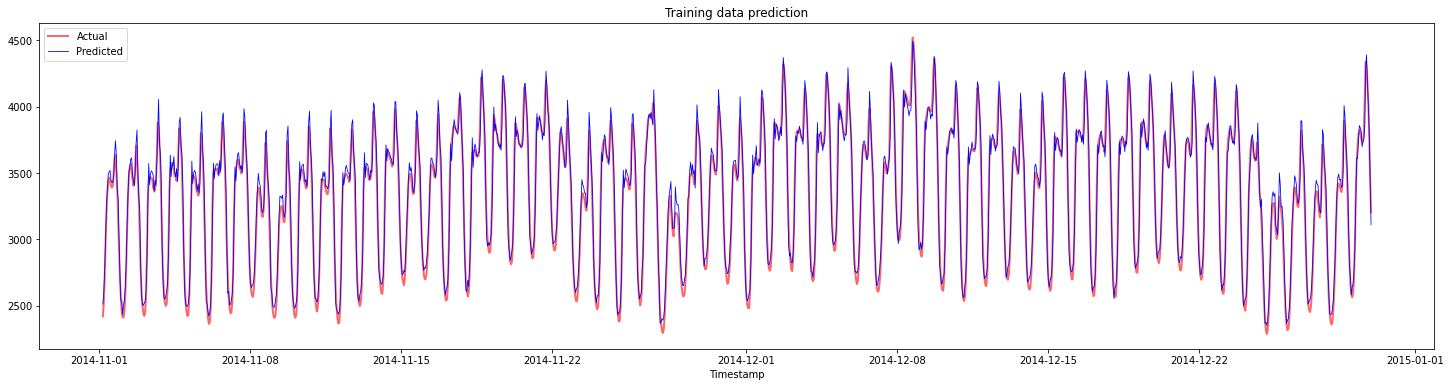
Öyrətmə datası üçün MAPE dəyərini çap et:
print('MAPE for training data: ', mape(y_train_pred, y_train)*100, '%')
MAPE for training data: 1.7195710200875551 %
Yoxlama datası üçün proqnozları qrafikdə çək:
plt.figure(figsize=(10,3))
plt.plot(test_timestamps, y_test, color = 'red', linewidth=2.0, alpha = 0.6)
plt.plot(test_timestamps, y_test_pred, color = 'blue', linewidth=0.8)
plt.legend(['Actual','Predicted'])
plt.xlabel('Timestamp')
plt.show()
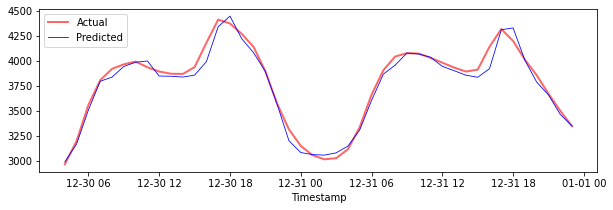
Yoxlama datası üçün MAPE dəyərini çap et:
print('MAPE for testing data: ', mape(y_test_pred, y_test)*100, '%')
MAPE for testing data: 1.2623790187854018 %
🏆 Sən yoxlama dataseti üçün çox yaxşı nəticə əldə etmisən!
Modelin performansını bütün dataset üzərindən yoxla 1
# yüklənmiş datanı numpy array-ə çevrilməsi
data = energy.copy().values

# miqyasın dəyişdirilməsi
data = scaler.transform(data)

# modelin giriş tələblərinə uyğun 2D tensora çevirmək
data_timesteps=np.array([[j for j in data[i:i+timesteps]] for i in range(0,len(data)-timesteps+1)])[:,:,0]
print("Tensor shape: ", data_timesteps.shape)

# datadan giriş və çıxış dəyərlərinin seçilməsi
X, Y = data_timesteps[:,:timesteps-1],data_timesteps[:,[timesteps-1]]
print("X shape: ", X.shape,"\nY shape: ", Y.shape)
Tensor shape:  (26300, 5)
X shape:  (26300, 4)
Y shape:  (26300, 1)
# model proqnozları hesabla
Y_pred = model.predict(X).reshape(-1,1)

# miqyası geri qaytar və formasını dəyiş
Y_pred = scaler.inverse_transform(Y_pred)
Y = scaler.inverse_transform(Y)
plt.figure(figsize=(30,8))
plt.plot(Y, color = 'red', linewidth=2.0, alpha = 0.6)
plt.plot(Y_pred, color = 'blue', linewidth=0.8)
plt.legend(['Actual','Predicted'])
plt.xlabel('Timestamp')
plt.show()
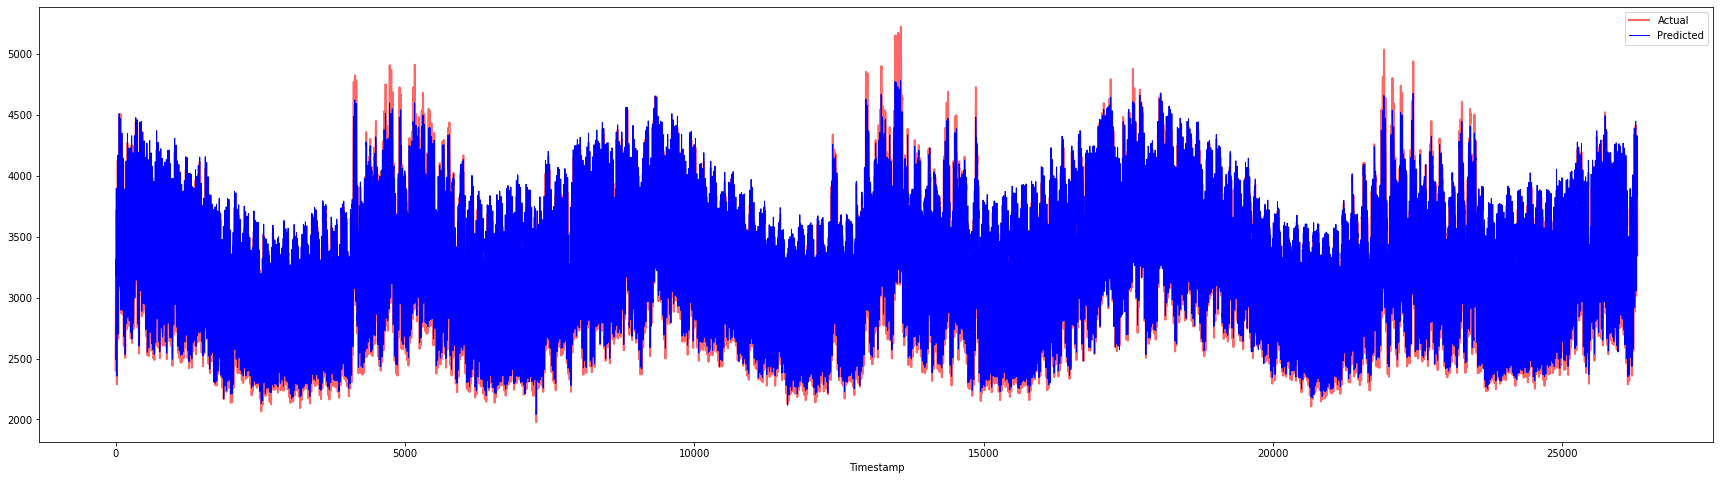
print('MAPE: ', mape(Y_pred, Y)*100, '%')
MAPE: 2.0572089029888656 %
🏆 Çox gözəl qrafiklər modelin yaxşı dəqiqlikdə olduğunu göstərir. Əla!
🚀 Məşğələ
- Model yaradarkən və data üzərində yoxlayarkən hiperparameterləri (gamma, C, epsilon) dəyişməyi yoxla və hansı dəyərlər çoxluğunun yoxlama datası ilə daha yaxşı nəticə əldə etdiyini görəsən. Bu hiperparametrlər barədə daha çox öyrənmək üçün bu sənədə baxa bilərsən.
- Model üçün fərqli kernel funksiyaları yoxla və onların dataset üzərində performanslarını analiz et. Bu sənəd çox faydalı ola bilər.
timestepsüçün fərqli dəyərlər yoxla və modelin proqnozlarına diqqət et.
Mühazirə sonrası test
Təkrarlayın və özünüz öyrənin
Bu dərs zaman seriyalarında proqnozlaşdırma üçün SVR modelinin tətbiqinə giriş idi. SVR haqqında daha çox oxumaq üçün bu bloqa baxa bilərsən. scikit-learn-də bu texniki sənəd SVM-lər barədə ümumi olaraq çox detallı məlumatlar verir. Əlavə olaraq SVR-lar və fərqli kernel funksiyalarının başqa tətbiqləri və parametrləri barədə ətraflı məlumatı da əldə edə bilərsiniz.
Tapşırıq
İstinadlar
-
Bu bölmənin mətni, kodu və nəticələri@AnirbanMukherjeeXD tərəfindən töhfə verilib ↩︎
-
Bu bölmənin mətni, kodu və nəticələri ARIMA-dan götürülüb ↩︎