
25 KiB
Scikit-learn istifadə edərək reqressiya modeli qurun: reqressiyanın dörd yolu
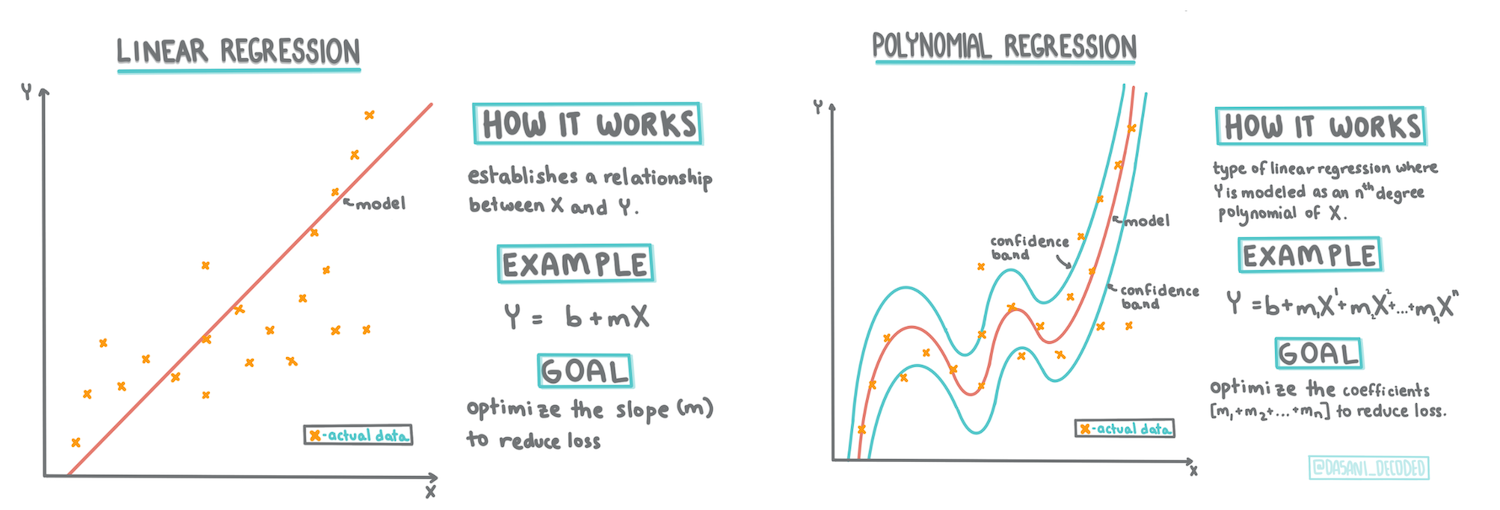
Dasani Madipalli tərəfindən çəkilmiş infoqrafik
Mühazirə öncəsi quiz
Bu dərs R proqramlaşdırma dili ilə də mövcuddur!
İndiyədək və bu dərs ərzində istifadə edəcəyimiz balqabaq qiymətlərinin data seti ilə reqressiyanın nə olduğunu araşdırmısınız. Həmçinin, Matplotlib ilə də onu vizuallaşdırmısınız.
Artıq maşın öyrənməsi üçün reqressiyanın dərinliklərinə enməyə hazırsınız. Vizuallaşdırma sizə datadan məna çıxarmaqda yardımçı olsa da, maşın öyrənməsi gücünü öyrətmə modellərindən alır. Modellər, data asılılıqlarını avtomatik olaraq tutmaq üçün keçmiş datalar üzərində öyrədilir və sizə modelin daha əvvəllər görmədiyi yeni datalar üçün proqnozlar verməyə imkan verirlər.
Bu dərsdə siz reqressiyanın daha 2 növü olan sadə xətti reqressiya ilə polinom reqressiya, və onların arxasında dayanan riyazi texnikalar haqqında öyrənəcəksiniz. Bu modellər bizə fərqli giriş datalarından asılı olaraq balqabaq qiymətlərini proqnozlaşdırmağa imkan verəcək.
🎥 Xətti reqressiyanın qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
Bu kurikulum boyunca biz sizin minimal riyazi biliklərə sahib olduğunuzu güman edirik və bunu digər sahələrdən gələn tələbələr üçün də əlçatan etməyə çalışırıq. Ona görə də başa düşmənizə yardımçı olacaq qeydlərə, 🧮 izahlara, diaqramlara və digər öyrənmə alətlərinə nəzər yetirə bilərsiniz.
İlkin Şərt
Araşdırdığımız balqabaq datalarının strukturu ilə artıq tanış olmalısınız. Siz onu bu dərsin notebook.ipynb faylında əvvəlcədən yüklənmiş və təmizlənmiş şəkildə tapa bilərsiniz. Faylda balqabağın qiyməti yeni datafreymdə buşel ilə göstərilmişdir. Bu notbukları Visual Studio Code-da işlədə bildiyinizdən əmin olun.
Hazırlıq
Bu dataları sual vermək üçün yüklədiyinizi xatırlatmaq istəyirik.
- Balqabaq almaq üçün ən yaxşı vaxt nə zamandır?
- Bir qab miniatür balqabaqdan nə qədər qiymət gözləyə bilərəm?
- Onları yarım buşellik səbətlərlə, yoxsa 1 1/9 buşellik qutularda almalıyam? Gəlin bu dataları araşdırmağa davam edək.
Bundan öncəki dərsdə siz Pandas-da yeni datafreym yaradaraq onu orijinal data setinin bir hissəsi ilə doldurdunuz və qiymətləri buşellə standartlaşdırdınız. Amma bunu etməklə siz ancaq payız ayları üçün təxminən 400 data nöqtəsi toplaya bildiniz.
Bu dərsi müşayiət edən notbuka yüklədiyimiz datalara nəzər salın. Məlumatlar əvvəlcədən yüklənilmiş və paylanma qrafiki aylarla bağlı datanı göstərəcək formada çəkilmişdir. Bu datanı biraz da təmizləyərək onun təbiəti haqqında az da olsa əlavə məlumat ala bilərik.
Xətti reqressiya xətti
1-ci dərsdə öyrəndiyiniz kimi, xətti reqressiya tapşırığının məqsədi aşağıdakılara bir xətt çəkə bilməkdir:
- Dəyişənlər arası əlaqəni göstərmək. Dəyişənlər arasındakı əlaqəni göstərin.
- Təxminlər irəli sürmək. Yeni data nöqtəsinin həmin xəttlə əlaqədə olduğu yer haqqında dəqiq təxminlər irəli sürün.
Bu tip bir xətt çəkmək Ən Kiçik Kvadratlar Reqressiyasının tipik bir nümunəsidir. 'Ən kiçik kvadratlar' ifadəsinin mənası reqressiya xəttini əhatələyən bütün nöqtələrinin kvadratlarının cəmlənməsi deməkdir. Az sayda xəta və ya ən kiçik kvadratlar istədiyimiz üçün, ideal formada, alınan cəm mümkün qədər kiçik olur.
Bütün məlumat nöqtələrimizdən ən az məcmu məsafəyə malik olan xətti modelləşdirmək istədiyimiz üçün bunu edirik. Biz onun istiqaməti deyil, böyüklüyü ilə maraqlandığımıza görə şərtləri də əlavə etməzdən əvvəl kvadratlaşdırırıq.
🧮 Mənə riyaziyyatı göstərin
Ən uyğun xətt adlanan bu xətt, tənliklə ifadə oluna bilər:
Y = a + bX
X'izahedici dəyişən',Y'asılı dəyişəndir'.b, xəttin bucaq əmsalı,aisəX = 0olduqdaYdəyərinə istinad edən y-kəsənidir.
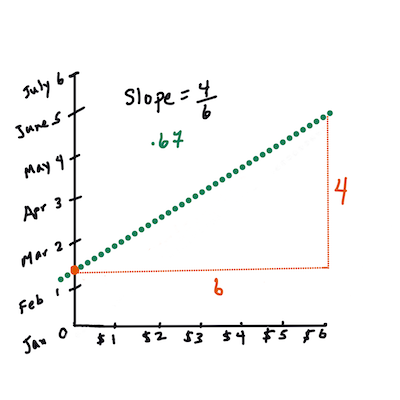
İlk olaraq
bbucaq əmsalını hesablayın. Jen Looper tərəfindən çəkilmiş infoqrafik.Digər sözlə və balqabaq datasının orijinal sualına-"bir buşel balqabağın ay üzrə qiymətini təxmin edin" istinad etsək,
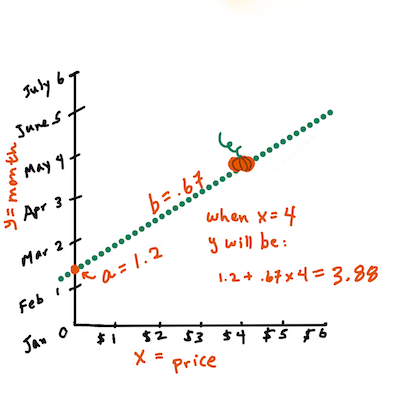
Xqiymətə,Yisə aylıq satışa istinad edə bilər.
Y-in dəyərini hesablayın. Əgər 4$ ətrafında ödəyirsinizsə, bu Aprel ayı olmalıdır! Jen Looper tərəfindən çəkilən infoqrafik. Xətti hesablayan riyazi əməliyyat kəsəndən və ya
X = 0olduqdaY-in bərabər olduğu dəyərdən asılı olan bucaq əmsalını göstərməlidir. Bu dəyərlərin hesablanması üçün olan metodlara Math is Fun vebsaytından baxa bilərsiniz. Ədədlərin sahib olduğu dəyərin xəttə necə təsir etməsinə baxmaq üçün isə Least-squares calculator saytına keçid edin.
Korrelyasiya
Başa düşməniz lazım olan daha bir ifadə isə X və Y dəyişənləri arasındakı korrelyasiya əmsalıdır. Paylanma qrafikindən istifadə edərək bu əmsalları tez bir şəkildə vizuallaşdıra bilərsiniz. Aydın bir xətt üzrə səpələnmiş data nöqtələri olan qarifikin yüksək korrelyasiyası, hər yerə səpələnmiş data nöqtələri olan qrafikin isə aşağı korrelyasiyası olur.
Yaxşı bir reqresiyya modeli, reqressiya xətti ilə Ən Kiçik Kvadratlar Reqresiyyası metodundan istifadə olunmuş yüksək (0-dan fərqli, 1-ə yaxın) Korrelyasiya Əmsalı olan model hesab olunacaq.
✅ Bu dərsi müşayiət edən notbuku işə salın və Ay-Qiymət paylanma qrafikinə baxın. Paylanma qrafikinin vizual təsvirinə əsasən balqabaq satışı üçün Ay ilə Qiyməti əlaqələndirən datanın yüksək yoxsa aşağı korrelyasiyası var? Ay əvəzinə daha dəqiq ölçüdən, məsələn ilin günündən(məsələn, il başlayandan keçən günlərin sayı) istifadə etsəniz dəyişiklik olacaqmı?
Aşağıdakı kodda, biz datanı təmizlədiyimizi və aşağıdakı formaya bənzər new_pumpkins adlı datafreymini əldə etdiyimizi fərz edirik:
| ID | Month | DayOfYear | Variety | City | Package | Low Price | High Price | Price |
|---|---|---|---|---|---|---|---|---|
| 70 | 9 | 267 | PIE TYPE | BALTIMORE | 1 1/9 bushel cartons | 15.0 | 15.0 | 13.636364 |
| 71 | 9 | 267 | PIE TYPE | BALTIMORE | 1 1/9 bushel cartons | 18.0 | 18.0 | 16.363636 |
| 72 | 10 | 274 | PIE TYPE | BALTIMORE | 1 1/9 bushel cartons | 18.0 | 18.0 | 16.363636 |
| 73 | 10 | 274 | PIE TYPE | BALTIMORE | 1 1/9 bushel cartons | 17.0 | 17.0 | 15.454545 |
| 74 | 10 | 281 | PIE TYPE | BALTIMORE | 1 1/9 bushel cartons | 15.0 | 15.0 | 13.636364 |
Datanı təmizləmək üçün istifadə olunan kodlara
notebook.ipynbfaylından baxa bilərsiniz. Keçən dərsdəki eyni təmizləmə addımlarını icra etmişik vəDayOfYearadlı sütunu aşağıdakı ifadə ilə hesablamışıq:
day_of_year = pd.to_datetime(pumpkins['Date']).apply(lambda dt: (dt-datetime(dt.year,1,1)).days)
Artıq xətti reqressiyanın arxasında dayanan riyaziyyatı başa düşdüyünüz üçün, gəlin hansı balqabaq paketinin ən yaxşı qiymətə malik olduğunu Reqressiya modeli quraraq təxmin edək. Bu məlumatı bayram üçün balqabaq alan alıcı öz xərclərini optimallaşdırmaq üçün istəyə bilər.
Korrelyasiyanı axtarırıq
🎥 Korrelyasiyanın qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
Keçən dərsdən çox güman ki, balqabağın aylar üzrə ortalama qiymətinin bu formada olduğunu görmüsünüz:
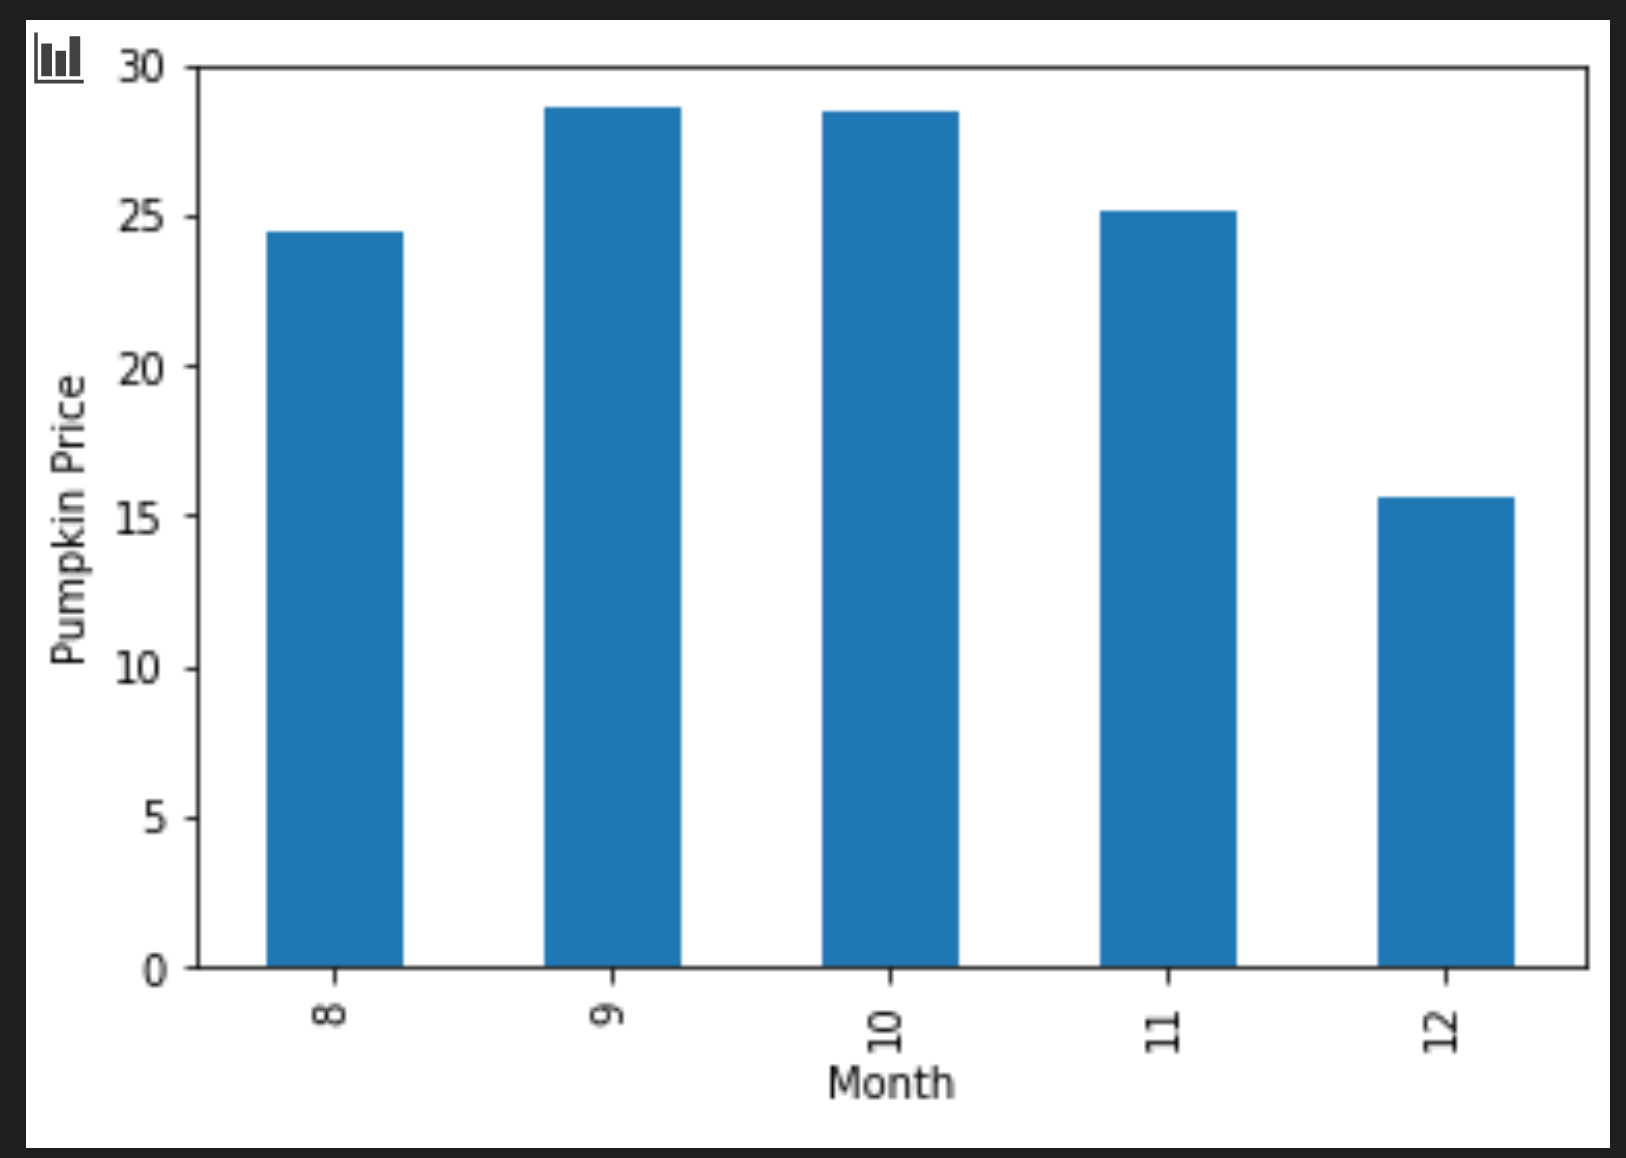
Bu şəkil bizə biraz korrelyasiyaya ehtiyac olduğuna işarə edir. Biz Month və Price, və yaxud DayOfYear və Price arasındakı əlaqəni təxmin etmək üçün reqressiya modellərimizi öyrədə bilərik. İkinci əlaqəni göstərən paylanma qrafiki:
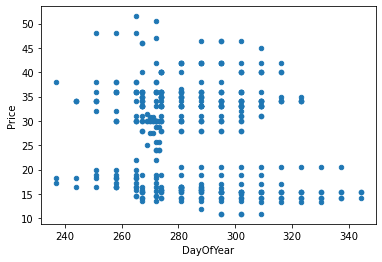
Gəlin corr funksiyasından istifadə etməklə korrelyasiyanın mövcud olub olmadığına baxaq:
print(new_pumpkins['Month'].corr(new_pumpkins['Price']))
print(new_pumpkins['DayOfYear'].corr(new_pumpkins['Price']))
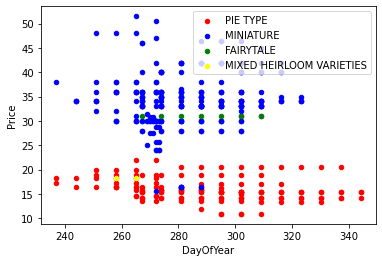
Belə görünür ki, Month üzrə korrelyasiya -0.15, DayOfMonth üzrə isə -0.17 olmaqla çox kiçik dəyərə malikdir. Amma burada daha mühüm əlaqə ola bilər. Görünən odur ki, fərqli balqabaq növləri üzrə fərqli qiymət yığınları mövcuddur. Bu hipotezisi isbat etmək üçün, gəlin hər balqabaq kateqoriyasının qrafikini fərqli bir rənglə çəkək. ax-i scatter adlı qrafik çəkən funksiyaya ötürməklə biz eyni qrafik üzərində bütün nöqtələri göstərə bilərik:
ax=None
colors = ['red','blue','green','yellow']
for i,var in enumerate(new_pumpkins['Variety'].unique()):
    df = new_pumpkins[new_pumpkins['Variety']==var]
    ax = df.plot.scatter('DayOfYear','Price',ax=ax,c=colors[i],label=var)
Gəlin bir müddət yalnız 'yeməli növ' balqabaq sortuna fokuslanaq and tarixin onun qiyməti üzərindəki təsirinə baxaq:
pie_pumpkins = new_pumpkins[new_pumpkins['Variety']=='PIE TYPE']
pie_pumpkins.plot.scatter('DayOfYear','Price')
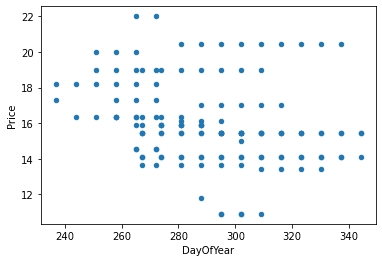
Əgər indiki halda corr funksiyasında istifadə edərək Price və DayOfYear arasındakı korrelyasiyanı hesablasaq, təxminən -0.27-ə bərabər olan bir qiymət alarıq. Bu da o deməkdir ki, bizim təxminedici model daha məntiqli təxminlər verməyə başlayır.
Xətti reqressiyanı öyrətməzdən öncə datamızın təmiz olduğundan əmin olmalıyıq. Xətti reqressiya boş qiymətlərlə o qədər də yaxşı işləmədəyi üçün boş xanalardan qurtulmağımızda fayda var:
pie_pumpkins.dropna(inplace=True)
pie_pumpkins.info()
Başqa bir yanaşma, həmin boş dəyərləri müvafiq sütundakı orta qiymətlərlə doldurmaq olardı.
Sadə xətti reqressiya
🎥 Xətti və polinom reqresiyyaların qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
Xətti Reqressiya modelimizi öyrətmək üçün Scikit-learn kitabxanasından istifadə edəcəyik.
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split
İlkin olaraq giriş(özəlliklər) və çıxış(label) dəyərlərini fərqli setlərə ayıraraq başlayırıq:
X = pie_pumpkins['DayOfYear'].to_numpy().reshape(-1,1)
y = pie_pumpkins['Price']
Diqqət edin ki, Xətti Reqressiya paketinin giriş datasını düzgün başa düşməsi üçün onu reshape(yenidən formalaşdırmaq) etməli olduq. Xətti reqressiya giriş parametri olaraq hər sırasının giriş özəlliklərindən ibarət vektora uyğun olduğu 2 ölüçülü set gözləyir. Bizim situasiyada yalnız bir giriş olduğu üçün N×1 formalı setə ehtiyacımız olacaq. Buradakı N data setinin ölçüsünü bildirir.
Öyrətmədən sonra modelimizi validasiya etməyimiz üçün datanı öyrətmə və test data setlərinə ayırmağa ehtiyacımız var:
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)
Yekunda Xətti Reqressiya modelini öyrətmək 2 sətirlik kod tələb etmiş olur. LinearRegression adlı bir obyekt yaradaraq onu fit metodundan istifadə etməklə öz datamıza uyğunlaşdırırıq:
lin_reg = LinearRegression()
lin_reg.fit(X_train,y_train)
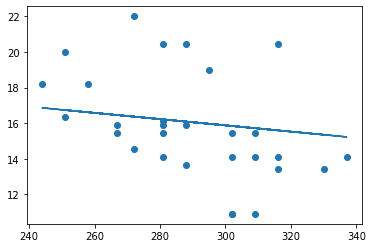
.coef_ istifadə edərək LinearRegression obyektinin fit ilə uyğunlaşdırılandan sonra özündə saxladığı bütün reqressiya əmsallarına baxa bilərsiniz. Bizim situasiyada yalnız bir əmsal var ki, o da -0.017 civarında olmalıdır. Bu da o deməkdir ki, qiymətlər zamanla düşsə də, bu düşüş çox yox, təxminən günə 2 sent civarında dəyişir. Həmçinin reqressiyanın Y oxu ilə kəsişmə nöqtəsinə lin_reg.intercept ilə baxa bilərik. O isə bizim situasiyada 21 aralığında olacaq ki, bu da ilin əvvəlindəki qiyməti göstərir.
Modelimizin nə dərəcə dəqiq olduğunu görmək üçün test data setində qiymətləri təxmin edib, daha sonra onların gözlənilən qiymətlərə nə dərəcə yaxın olduğunu ölçə bilərik. Bunu orta kvadratik xəta (OKX), daha aydın formada desək, bütün gözlənilən və təxmin olunan dəyərlər arasındakı fərqin kvadratları cəminin ədədi ortası ölçümü ilə həll edə bilərik.
pred = lin_reg.predict(X_test)

mse = np.sqrt(mean_squared_error(y_test,pred))
print(f'Mean error: {mse:3.3} ({mse/np.mean(pred)*100:3.3}%)')
Görünür ki, xətamız 2 xal civarındadır, bu da ~17%-dir. O qədər də yaxşı deyil. Modelin keyfiyyət göstəricilərindən biri olan determinasiya əmsalı isə bu formada əldə olunur:
score = lin_reg.score(X_train,y_train)
print('Model determination: ', score)
Əgər qiymət 0-a bərabərdirsə, bu o deməkdir ki, model giriş datalarını nəzərə almır və ən pis xətti təxminedici rolunu oynayaraq, nəticənin orta qiymətinə bərabər olur. 1 dəyəri isə bizim bütün gözlənilən dəyərləri mükəmməl bir şəkildə təxmin edə biləcəyimiz mənasına gəlir. Bizim situasiyada əmsal kifayət qədər aşağı, 0.06 civarındadır.
Reqressiyanın necə işlədiyini görmək üçün reqressiya xətti ilə birgə test datasını da qrafikləşdirə bilərik:
plt.scatter(X_test,y_test)
plt.plot(X_test,pred)
Polinom Reqressiya
Xətti Reqressiyanın digər bir növü Polinom Reqressiyadır. Bəzən dəyişənlər arasındakı əlaqə xətti(balqabaq nə qədər böyük olarsa, qiyməti də o qədər yüksək olacaq) olsa da, bəzən düz xətt və ya müstəvi formasında qrafikləşdirilə bilinməyən əlaqələr də olur.
✅ Burada olan data nümunələrində Polinom Reqressiyadan istifadə oluna bilər.
Date və Price arasındakı əlaqəyə fərqli bucaqdan baxmağa çalışın. Sizcə bu paylanma qrafiki mütləq şəkildə hansısa bir düz xətt ilə analiz olunmalıdırmı? Qiymətlər dəyişə bilməzmi? Bu durumda polinom reqressiyanı yoxlaya bilərsiniz.
✅ Polinomlar bir və ya bir neçə dəyişən və əmsallardan ibarət olan riyazi ifadələrə deyilir.
Polinom reqressiya qeyri-xətti datalara daha yaxşı uyğunlaşmaq üçün əyri xətt yaradır. İndiki situasiyada, DayOfYear dəyişəninin kvadratını giriş datasına daxil etsək, datamızı parabolik əyriyə uyğunlaşdıra bilərik. Bunun sayəsində il ərzindəki hansısa nöqtədə minimum dəyərə malik olacağıq.
Scikit-learn-də data emalının müxtəlif addımlarını birləşdirmək üçün payplayn API mövcuddur. Payplayn, təxminedicilərdən formalaşan bir zəncirdir. Bizim situasiyada ilk öncə polinom özəllikləri modelimizə əlavə edən payplaynı yaradacayıq və daha sonra reqressiyanı öyrədəcəyik:
from sklearn.preprocessing import PolynomialFeatures
from sklearn.pipeline import make_pipeline

pipeline = make_pipeline(PolynomialFeatures(2), LinearRegression())

pipeline.fit(X_train,y_train)
PolynomialFeatures(2) istifadə edilməsi, bizim giriş datasındakı bütün ikinci dərəcəli polinomları daxil edəcəyimizi bildirir. Bizim vəziyyətimizdə bu, sadəcə DayOfYear2 mənasını verəcək, amma iki giriş dəyişəni, X və Y verildikdə isə, bu, X2, XY və Y2-ni əlavə edəcək. İstəyə bağlı olaraq daha yüksək dərəcəli polinom da istifadə edə bilərik.
Payplaynlar orijinal LinearRegression obyektində olduğu kimi, eyni üsulla istifadə oluna bilər. Məsələn, payplaynı fit ilə uyğunlaşdıra, daha sonra isə təxmin nəticələrini əldə etmək üçün predict istifadə edə bilərik. Aşağıdakı qrafikdə test datası və təxmin əyrisi göstərilmişdir:
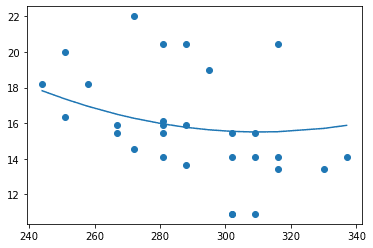
Polinom Reqressiyadan istifadə etməklə biz nəzərəçarpacaq qədər olmasa da, nisbətən daha aşağı OKX(orta kvadratik xəta) və yüksək dəqiqlik əldə edə bilərik. Unutmayın ki, digər özəllikləri də nəzərə almalıyıq!
Artıq balqabağın Hellouin ərəfəsində minimum qiymətə düşdüyünü müşahidə edə bilərsiniz. Bunu necə izah edə bilərsiniz?
🎃 Təbrik edirik, siz indicə yeməli növ balqabaqların qiymətini proqnozlaşdırmağa kömək edə biləcək bir model yaratdınız. Böyük ehtimalla eyni prosedurları digər balqabaq növləri üçün də təkrarlaya bilərsiniz. Amma bu yorucu olacaq. Gəlin balqabaq növünü modelimizdə necə nəzərə alacağımızı öyrənək!
Kateqorik Xüsusiyyətlər
İdeal şəraitdə eyni modeldən istifadə edərək fərqli balqabaq növləri üçün təxminlər istəyə bilərik. Amma Variety sütunu qeyri-ədədi dəyərlərdən ibarət olduğu üçün Month sütunundan fərqlənir. Bu tip sütunlar kateqorik adlandırılır.
🎥 Kateqorik xüsusiyyətlərdən istifadəsi barədə qısa icmal videosu üçün yuxarıdakı şəkilin üzərinə klikləyin.
Burada ortalama qiymətin növdən asılılığını görə bilərsiniz:
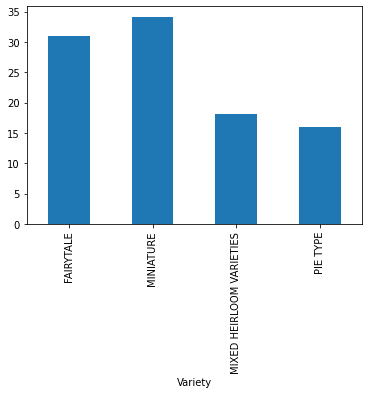
Növləri nəzərə alsaq, ilk olaraq biz onu ədədi formaya çevirməli və yaxud kodlaşdırmalıyıq. Bunu etməyimiz üçün müxtəlif yollar vardır:
-
Sadə ədədi kodlaşdırma müxtəlif növlərdən ibarət bir cədvəl quracaq və növün adını həmin cədvəldəki indeksi ilə əvəzləyəcək. Bu xətti reqressiya üçün yaxşı fikir deyil, çünki xətti reqressiya indeksin cari qiymətini alaraq onu hansısa əmsala vurub, nəticəyə əlavə edir. Bizim situasiyada isə indeks və qiymət arasındakı əlaqə elementlərin hansısa bir yol ilə sıralansa belə, bariz şəkildə qeyri-xəttidir.
-
Tək-aktiv kodlaşdırma
Varietysütununu, hər növ üçün bir ədəd olmaqla 4 fərqli sütunla əvəz edəcək. Hər sütun əgər müvafiq sıra verilən növə uyğundursa1-dən, deyilsə0-dan ibarət olacaq. Bu da o deməkdir ki, xətti reqressiyada hər balqabaq növü üçün həmin növün "başlanğıc qiymətindən" (və ya "əlavə qiymət") məsul olan 4 əmsal olacaq.
Aşağıdakı kodda növü necə tək-aktiv kodlaşdıra biləcəyimiz göstərilmişdir:
pd.get_dummies(new_pumpkins['Variety'])
| ID | FAIRYTALE | MINIATURE | MIXED HEIRLOOM VARIETIES | PIE TYPE |
|---|---|---|---|---|
| 70 | 0 | 0 | 0 | 1 |
| 71 | 0 | 0 | 0 | 1 |
| ... | ... | ... | ... | ... |
| 1738 | 0 | 1 | 0 | 0 |
| 1739 | 0 | 1 | 0 | 0 |
| 1740 | 0 | 1 | 0 | 0 |
| 1741 | 0 | 1 | 0 | 0 |
| 1742 | 0 | 1 | 0 | 0 |
Xətti reqressiyanı tək aktiv kodlaşdırmanın giriş olaraq istifadə edərək öyrətmək üçün X və y datalarını düzgün formada başlatmalıyıq:
X = pd.get_dummies(new_pumpkins['Variety'])
y = new_pumpkins['Price']
Kodun qalan hissəsi yuxarıda Xətti Reqressiyanı öyrətməyimiz üçün istifadə olunan kodlarla eynidir. Əgər yoxlasanız, orta kvadratik xətanın eyni olduğunu, amma determinasiya əmsalının çox daha yüksək(~77%) olduğunu görəcəksiniz. Daha da dəqiq təxminlər əldə etmək üçün, Month və ya DayOfYear tipli ədədi özəllikləri də nəzərə ala bilərik. Özəlliklərdən ibarət böyük bir set əldə etmək üçün join istifadə edə bilərik:
X = pd.get_dummies(new_pumpkins['Variety']) \
        .join(new_pumpkins['Month']) \
        .join(pd.get_dummies(new_pumpkins['City'])) \
        .join(pd.get_dummies(new_pumpkins['Package']))
y = new_pumpkins['Price']
Burada bizə 2.84 (10%) OKX (orta kvadratik xəta), 0.94 determinasiya qaytaran City və Package tiplərini də nəzərə alırıq!
Hamısını bir araya gətirərək
Ən yaxşı modeli qurmaq üçün, biz mürəkkəb (tək-aktiv kodlaşdırılmış kateqorik + ədədi) dataları Polinom Reqressiya ilə birlikdə istifadə edə bilərik. İşinizi asanlaşdırmaq üçün kod nümunəsini aşağıda yerləşdirmişik:
# set up training data
X = pd.get_dummies(new_pumpkins['Variety']) \
        .join(new_pumpkins['Month']) \
        .join(pd.get_dummies(new_pumpkins['City'])) \
        .join(pd.get_dummies(new_pumpkins['Package']))
y = new_pumpkins['Price']

# make train-test split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# setup and train the pipeline
pipeline = make_pipeline(PolynomialFeatures(2), LinearRegression())
pipeline.fit(X_train,y_train)

# predict results for test data
pred = pipeline.predict(X_test)

# calculate MSE and determination
mse = np.sqrt(mean_squared_error(y_test,pred))
print(f'Mean error: {mse:3.3} ({mse/np.mean(pred)*100:3.3}%)')

score = pipeline.score(X_train,y_train)
print('Model determination: ', score)
Bu bizə 97%-lə ən yaxşı determinasiya əmsalını, və OKX=2.23 (~8% təxmin xətası) verəcək.
| Model | MSE | Determination |
|---|---|---|
DayOfYear Linear |
2.77 (17.2%) | 0.07 |
DayOfYear Polynomial |
2.73 (17.0%) | 0.08 |
Variety Linear |
5.24 (19.7%) | 0.77 |
| All features Linear | 2.84 (10.5%) | 0.94 |
| All features Polynomial | 2.23 (8.25%) | 0.97 |
🏆 Əla! Siz bir dərsdə 4 Reqressiya modeli yaratdınız və modelin keyfiyyətini 97%-ə qədər artırdınız. Reqressiyanın final bölməsində kateqoriyaları müəyyənləşdirmək üçün olan Logistik Reqressiya haqqında öyrənəcəksiniz.
🚀 Məşğələ
Bu notbukda bir neçə fərqli dəyişəni test edərək korrelyasiyanın modelin dəqiqliyinə necə təsir etdiyini izləyin.
Mühazirə sonrası test
Təkrarlayın və özünüz öyrənin
Bu dərsdə Xətti Reqressiya haqqında öyrəndiniz. Reqressiyanın başqa vacib növləri də mövcuddur. Stepwise, Ridge, Lasso və Elasticnet texnikaları barədə oxuyun. Daha ətraflı öyrənə biləcəyiniz yaxşı kurs Stenford Statistik Öyrənmə kursudur.