
26 KiB
ساخت راهحلهای یادگیری ماشین با هوش مصنوعی مسئولانه
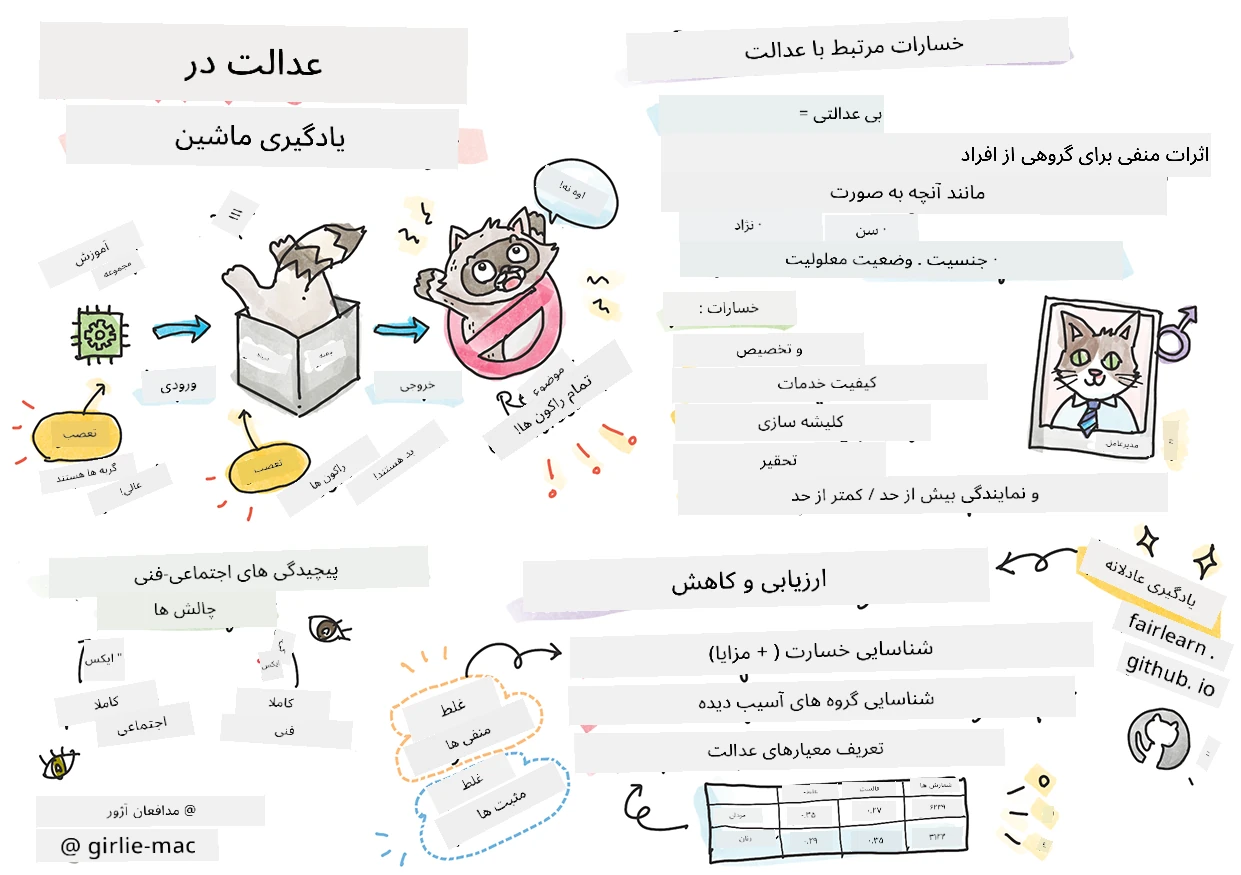
نقشه ذهنی توسط Tomomi Imura
آزمون پیش از درس
مقدمه
در این برنامه آموزشی، شما شروع به کشف چگونگی تأثیر یادگیری ماشین بر زندگی روزمره ما خواهید کرد. حتی اکنون، سیستمها و مدلها در وظایف تصمیمگیری روزانه مانند تشخیصهای مراقبتهای بهداشتی، تصویب وام یا تشخیص تقلب دخیل هستند. بنابراین، مهم است که این مدلها به خوبی کار کنند تا نتایجی قابل اعتماد ارائه دهند. مانند هر برنامه نرمافزاری، سیستمهای هوش مصنوعی ممکن است نتوانند انتظارات را برآورده کنند یا نتیجهای نامطلوب داشته باشند. به همین دلیل، فهمیدن و توضیح دادن رفتار یک مدل هوش مصنوعی ضروری است.
تصور کنید زمانی که دادههایی که برای ساخت این مدلها استفاده میکنید فاقد گروههای جمعیتی خاصی مانند نژاد، جنسیت، دیدگاه سیاسی، دین باشد یا به صورت نامتناسب نمایانگر این گروهها باشد، چه خواهد شد؟ وقتی خروجی مدل به نفع برخی گروههای جمعیتی تفسیر میشود چه اتفاقی میافتد؟ پیامد آن برای برنامه چیست؟ علاوه بر این، وقتی مدل نتیجهای نامطلوب دارد و به مردم آسیب میرساند، چه میشود؟ چه کسی مسئول رفتار سیستمهای هوش مصنوعی است؟ اینها برخی از سوالاتی هستند که در این برنامه آموزشی بررسی خواهیم کرد.
در این درس، شما:
- آگاهی خود را نسبت به اهمیت انصاف در یادگیری ماشین و آسیبهای مرتبط با عدالت افزایش دهید.
- با روش بررسی نقاط پرت و سناریوهای غیرمعمول برای اطمینان از قابلیت اطمینان و ایمنی آشنا شوید.
- درک نیاز به توانمندسازی همه افراد با طراحی سیستمهای فراگیر را کسب کنید.
- اهمیت حفاظت از حریم خصوصی و امنیت دادهها و مردم را بررسی کنید.
- اهمیت داشتن رویکرد جعبه شیشهای برای توضیح رفتار مدلهای هوش مصنوعی را مشاهده کنید.
- مراقب چگونگی اهمیت پاسخگویی برای ایجاد اعتماد در سیستمهای هوش مصنوعی باشید.
پیشنیاز
به عنوان پیشنیاز، لطفاً مسیر یادگیری "اصول هوش مصنوعی مسئولانه" را طی کنید و ویدیوی زیر را در این موضوع تماشا کنید:
درباره هوش مصنوعی مسئولانه بیشتر بدانید با دنبال کردن این مسیر یادگیری

🎥 برای ویدیو کلیک کنید: رویکرد مایکروسافت به هوش مصنوعی مسئولانه
انصاف
سیستمهای هوش مصنوعی باید با همه منصفانه رفتار کنند و از تأثیرگذاری متفاوت روی گروههای مشابه خودداری کنند. برای مثال، وقتی سیستمهای هوش مصنوعی راهنمایی در درمان پزشکی، درخواست وام یا استخدام ارائه میدهند، باید به همه با نشانهها، شرایط مالی یا صلاحیتهای حرفهای مشابه، توصیههای یکسانی بدهند. هر کدام از ما به عنوان انسانها تعصبات ذاتی داریم که بر تصمیمات و اقدامات ما تأثیر میگذارند. این تعصبات ممکن است در دادههایی که برای آموزش سیستمهای هوش مصنوعی استفاده میکنیم آشکار باشند. گاهی اوقات این دستکاری به صورت ناخواسته رخ میدهد. معمولاً دشوار است که به طور آگاهانه بدانیم چه زمانی تعصب را وارد دادهها میکنیم.
«ناعدالتی» شامل تأثیرات منفی یا «آسیبها» برای گروهی از افراد است، مانند آنهایی که از نظر نژاد، جنسیت، سن یا وضعیت معلولیت تعریف میشوند. آسیبهای اصلی مرتبط با انصاف میتوانند به شرح زیر دستهبندی شوند:
- تخصیص، اگر مثلاً جنسیت یا قومیت خاصی نسبت به دیگری ترجیح داده شود.
- کیفیت خدمات. اگر دادهها را برای یک سناریوی خاص آموزش دهید اما واقعیت بسیار پیچیدهتر باشد، منجر به خدمت ضعیف میشود. برای نمونه، یک دستگاه توزیعکننده صابون که به نظر نمیرسد بتواند افراد با پوست تیره را شناسایی کند. مرجع
- تحقیر. انتقاد ناعادلانه و برچسب زدن به چیزی یا کسی. برای مثال، فناوری برچسبگذاری تصاویر به طور نادرستی تصاویر افراد با پوست تیره را به عنوان گوریل برچسب زد.
- بیشنمایی یا کمنمایی. ایده این است که یک گروه خاص در یک حرفه خاص دیده نمیشود، و هر سرویس یا عملکردی که این را ادامه دهد به آسیب کمک میکند.
- کلیشهسازی. ارتباط دادن یک گروه خاص با ویژگیهای پیشفرض. برای مثال، سیستم ترجمه زبان بین انگلیسی و ترکی ممکن است نواقصی داشته باشد به دلیل کلماتی که با کلیشههای جنسیتی مرتبط هستند.
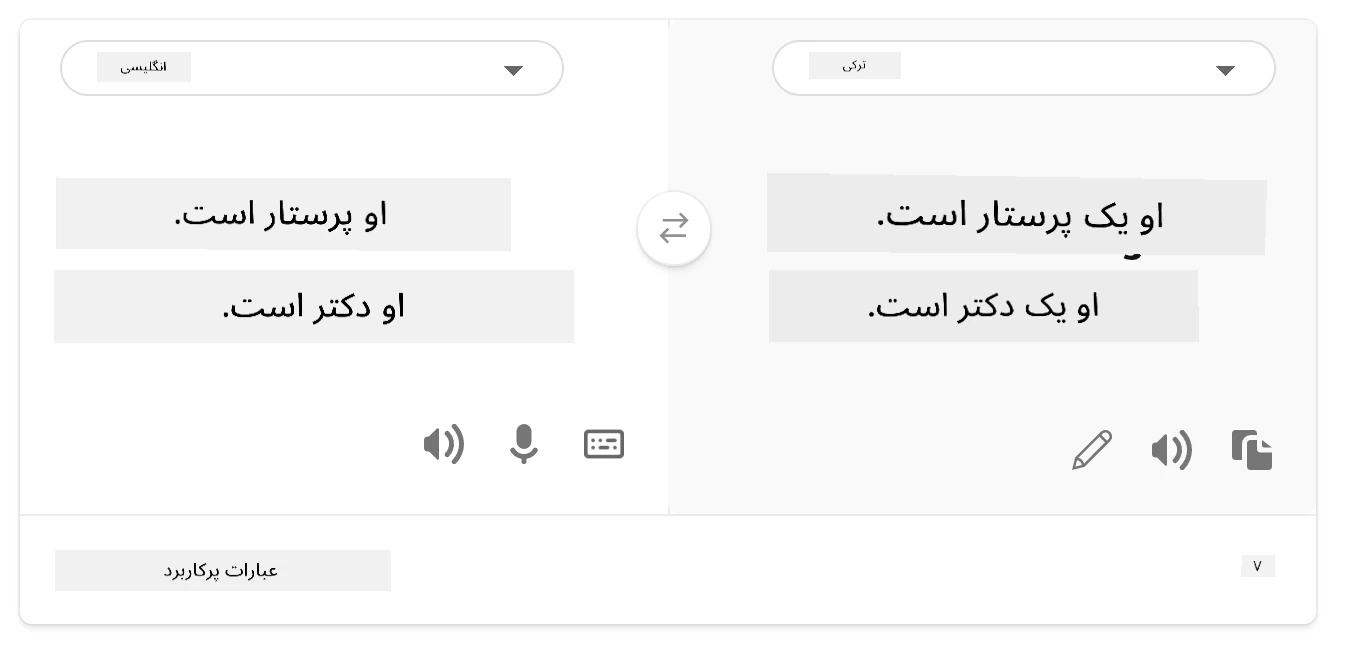
ترجمه به ترکی
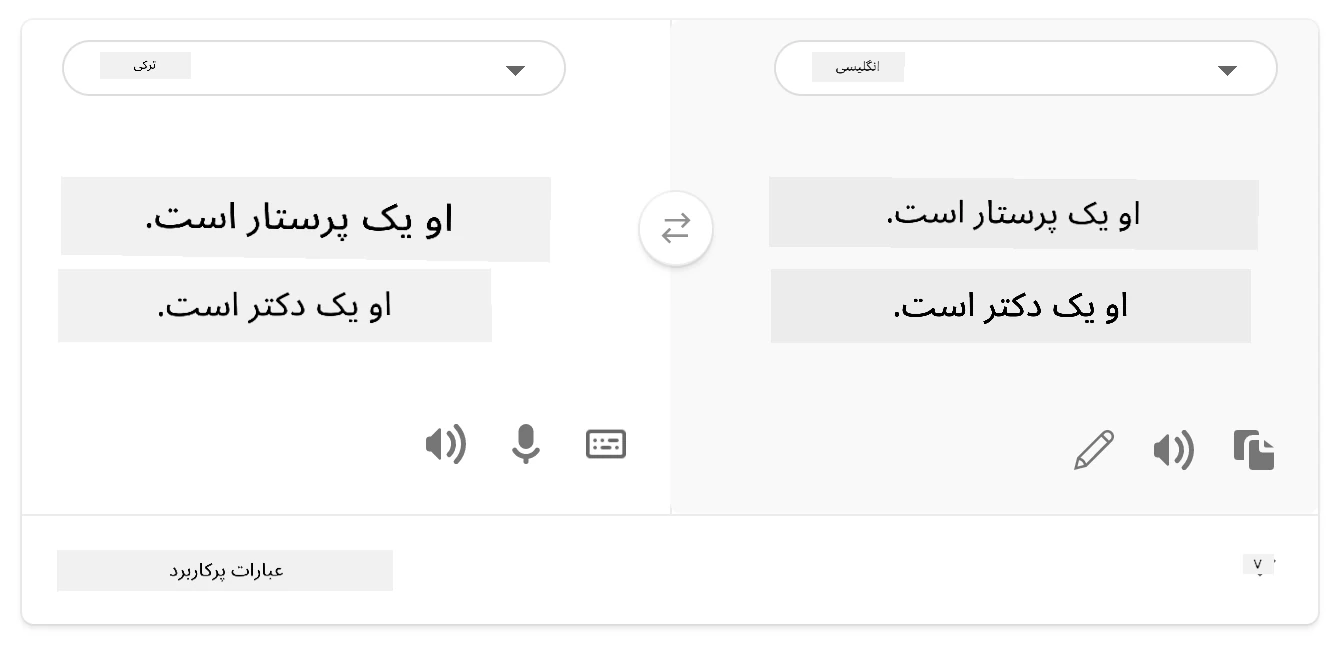
ترجمه بازگشتی به انگلیسی
هنگام طراحی و آزمایش سیستمهای هوش مصنوعی، باید تضمین کرد که هوش مصنوعی منصفانه است و برای گرفتن تصمیمات جانبدارانه یا تبعیضآمیز برنامهریزی نشده است، تصمیماتی که انسانها نیز مجاز به گرفتن آنها نیستند. تضمین انصاف در هوش مصنوعی و یادگیری ماشین همچنان چالشی پیچیده اجتماعی-فنی است.
قابلیت اطمینان و ایمنی
برای ایجاد اعتماد، سیستمهای هوش مصنوعی باید در شرایط عادی و غیرمنتظره قابل اعتماد، ایمن و سازگار باشند. مهم است که بدانیم سیستمهای هوش مصنوعی در موقعیتهای مختلف، بهویژه وقتی که دادههای پرت هستند، چگونه رفتار خواهند کرد. هنگام ساخت راهحلهای هوش مصنوعی، باید تمرکز زیادی بر نحوه مدیریت مجموعه وسیعی از شرایطی که راهحلهای هوش مصنوعی با آن مواجه خواهند شد وجود داشته باشد. برای مثال، یک خودروی خودران باید ایمنی مردم را در اولویت قرار دهد. به همین دلیل، هوش مصنوعی که خودرو را راهبری میکند باید همه سناریوهای ممکن مانند شب، رعد و برق یا بوران، عبور کودکان از خیابان، حیوانات خانگی، ساخت و ساز جاده و غیره را در نظر بگیرد. توانایی سیستم هوش مصنوعی در مدیریت گستره وسیعی از شرایط به طور قابل اعتماد و ایمن منعکسکننده میزان پیشبینی دانشمند داده یا توسعهدهنده هوش مصنوعی در طی طراحی یا آزمایش سیستم است.
🎥 برای ویدیو کلیک کنید: قابلیت اطمینان و ایمنی در هوش مصنوعی
فراگیری
سیستمهای هوش مصنوعی باید به گونهای طراحی شوند که همه را درگیر و توانمند سازند. هنگام طراحی و پیادهسازی سیستمهای هوش مصنوعی، دانشمندان داده و توسعهدهندگان هوش مصنوعی موانع احتمالی در سیستم را شناسایی و برطرف میکنند که ممکن است ناخواسته برخی افراد را کنار بگذارند. برای نمونه، حدود ۱ میلیارد نفر با ناتوانی در سراسر جهان وجود دارند. با پیشرفت هوش مصنوعی، آنها میتوانند به طیف گستردهای از اطلاعات و فرصتها در زندگی روزمره خود آسانتر دسترسی پیدا کنند. با رفع موانع، این فرصتها ایجاد میشود که محصولات هوش مصنوعی با تجربه بهتر و منافع برای همه نوآوری و توسعه یابند.
امنیت و حریم خصوصی
سیستمهای هوش مصنوعی باید ایمن باشند و به حریم خصوصی افراد احترام بگذارند. مردم به سیستمهایی که حریم خصوصی، اطلاعات یا زندگیشان را به خطر میاندازند کمتر اعتماد میکنند. هنگام آموزش مدلهای یادگیری ماشین، ما برای تولید بهترین نتایج روی دادهها تکیه میکنیم. در این فرآیند، منشا دادهها و صحت آنها باید در نظر گرفته شود. برای مثال، آیا دادهها توسط کاربر ارسال شدهاند یا به صورت عمومی در دسترس بودهاند؟ سپس، در هنگام کار با دادهها، توسعه سیستمهای هوش مصنوعی که میتوانند اطلاعات محرمانه را محافظت کنند و در برابر حملات مقاومت داشته باشند، بسیار حیاتی است. با گسترش هوش مصنوعی، حفاظت از حریم خصوصی و تأمین امنیت اطلاعات شخصی و تجاری مهمتر و پیچیدهتر شده است. مسائل مربوط به حریم خصوصی و امنیت دادهها به خصوص برای هوش مصنوعی نیازمند توجه ویژه هستند، زیرا دسترسی به دادهها برای سیستمهای هوش مصنوعی ضروری است تا پیشبینیها و تصمیمگیریهای دقیق و آگاهانه درباره افراد انجام دهند.
- ما به عنوان یک صنعت، پیشرفتهای قابل توجهی در حریم خصوصی و امنیت داشتهایم که عمدتاً به واسطه مقرراتی مانند GDPR (مقررات عمومی حفاظت از داده) بوده است.
- با این حال، در سیستمهای هوش مصنوعی باید تنش بین نیاز به دادههای شخصی بیشتر برای شخصیتر و مؤثرتر کردن سیستمها و حریم خصوصی را به رسمیت بشناسیم.
- درست همانند تولد رایانههای متصل به اینترنت، شاهد افزایش چشمگیر مشکلات امنیتی مربوط به هوش مصنوعی نیز هستیم.
- در عین حال، دیدهایم که هوش مصنوعی برای بهبود امنیت استفاده میشود. به عنوان مثال، اکثر اسکنرهای ضدویروس مدرن امروزه بر اساس هئورستیکهای هوش مصنوعی عمل میکنند.
- ما باید اطمینان حاصل کنیم که فرآیندهای علوم داده ما با جدیدترین روشهای امنیت و حفظ حریم خصوصی بهصورت هماهنگ ترکیب میشوند.
شفافیت
سیستمهای هوش مصنوعی باید قابل فهم باشند. بخش حیاتی شفافیت، توضیح رفتار سیستمهای هوش مصنوعی و اجزای آنها است. بهبود درک سیستمهای هوش مصنوعی مستلزم آن است که ذینفعان بدانند چگونه و چرا این سیستمها کار میکنند تا بتوانند مشکلات عملکردی احتمالی، نگرانیهای ایمنی و حریم خصوصی، سوگیریها، روشهای تبعیضآمیز یا پیامدهای ناخواسته را شناسایی کنند. ما همچنین معتقدیم که کسانی که از سیستمهای هوش مصنوعی استفاده میکنند باید صادق و شفاف باشند درباره زمان، دلایل و نحوه استفاده از این سیستمها، و همچنین محدودیتهای سیستمهای مورد استفاده خود. به عنوان مثال، اگر یک بانک از یک سیستم هوش مصنوعی برای پشتیبانی از تصمیمات وامدهی به مصرفکنندگان استفاده میکند، مهم است که نتایج را بررسی کرده و بفهمیم کدام دادهها توصیههای سیستم را تحت تأثیر قرار میدهند. دولتها در حال آغاز تنظیم قوانین هوش مصنوعی در صنایع مختلف هستند، بنابراین دانشمندان داده و سازمانها باید توضیح دهند آیا سیستم هوش مصنوعی مطابق با مقررات است، به ویژه زمانی که نتیجه نامطلوبی رخ میدهد.
- به دلیل پیچیدگی سیستمهای هوش مصنوعی، درک نحوه عملکرد آنها و تفسیر نتایج دشوار است.
- این کمبود درک بر نحوه مدیریت، به کارگیری عملیاتی و مستندسازی این سیستمها تأثیر میگذارد.
- و مهمتر از همه، بر تصمیماتی که با استفاده از نتایج تولید شده توسط این سیستمها گرفته میشود اثر میگذارد.
پاسخگویی
افرادی که سیستمهای هوش مصنوعی را طراحی و به کار میگیرند باید مسئول نحوه عملکرد سیستمهای خود باشند. نیاز به پاسخگویی به ویژه در فناوریهای حساس مانند تشخیص چهره بسیار حیاتی است. اخیراً تقاضا برای فناوری تشخیص چهره، به ویژه از سوی سازمانهای اجرای قانون که پتانسیل فناوری را در کاربردهایی مانند یافتن کودکان گم شده میبینند، افزایش یافته است. با این حال، این فناوریها ممکن است توسط یک دولت برای به خطر انداختن آزادیهای اساسی شهروندان، به عنوان مثال با امکان نظارت مداوم بر افراد خاص، مورد استفاده قرار گیرند. بنابراین، دانشمندان داده و سازمانها باید مسئول تاثیر سیستم هوش مصنوعی خود بر افراد یا جامعه باشند.
🎥 برای دیدن ویدئو هشدارهای مربوط به نظارت گسترده از طریق تشخیص چهره، روی تصویر بالا کلیک کنید
در نهایت، یکی از بزرگترین سوالات نسل ما، به عنوان اولین نسلی که هوش مصنوعی را به جامعه میآورد، این است که چگونه اطمینان حاصل کنیم رایانهها مسئولیتپذیر باقی میمانند و چگونه سازندگان رایانهها نسبت به همه دیگران پاسخگو بمانند.
ارزیابی تأثیر
قبل از آموزش یک مدل یادگیری ماشین، مهم است که یک ارزیابی تأثیر انجام شود تا هدف سیستم هوش مصنوعی، نحوه استفاده مورد نظر، محل استقرار و کسانی که با سیستم تعامل خواهند داشت مشخص شود. این موارد برای بررسیکننده(های) سیستم یا آزمایشکنندگان مفید است تا بدانند هنگام شناسایی خطرات احتمالی و پیامدهای مورد انتظار چه مواردی باید در نظر گرفته شود.
موارد زیر حوزههای تمرکز در هنگام انجام ارزیابی تأثیر هستند:
- تأثیر منفی بر افراد. آگاهی از هر گونه محدودیت یا نیاز، استفاده نادرست یا هر گونه محدودیت شناخته شده که عملکرد سیستم را مختل میکند، برای اطمینان از عدم استفاده سیستم به گونهای که به افراد آسیب بزند حیاتی است.
- نیازهای داده. درک نحوه و محل استفاده سیستم از دادهها به بازبینان این امکان را میدهد تا هر گونه نیازمندی دادهای (مانند مقررات GDPR یا HIPAA) را مد نظر قرار دهند. همچنین باید بررسی شود که منبع یا مقدار داده برای آموزش کافی باشد.
- خلاصه تأثیر. لیستی از آسیبهای احتمالی ناشی از استفاده از سیستم جمعآوری شود. در طول چرخه عمر یادگیری ماشین، بررسی شود که آیا مشکلات شناسایی شده کاهش یافته یا رسیدگی شدهاند.
- اهداف قابل اجرا برای هر یک از شش اصل اصلی. ارزیابی شود که آیا اهداف هر یک از اصول تحقق یافتهاند و آیا شکافهایی وجود دارد.
اشکالزدایی با هوش مصنوعی مسئولانه
مشابه اشکالزدایی یک برنامه نرمافزاری، اشکالزدایی سیستم هوش مصنوعی فرآیندی ضروری برای شناسایی و رفع مشکلات سیستم است. عوامل زیادی وجود دارند که میتوانند باعث عملکرد نامطلوب یا غیرمسئولانه یک مدل شوند. اکثر معیارهای عملکرد مدل سنتی، جمعبندیهای کمی از عملکرد مدل هستند که برای تحلیل نقض اصول هوش مصنوعی مسئولانه کافی نیستند. علاوه بر این، مدل یادگیری ماشین یک جعبه سیاه است که درک رانندههای نتایج آن یا ارائه توضیح هنگام اشتباه دشوار است. در ادامه این دوره، خواهیم آموخت که چگونه از داشبورد هوش مصنوعی مسئولانه برای کمک به اشکالزدایی سیستمهای هوش مصنوعی استفاده کنیم. این داشبورد ابزار جامعی برای دانشمندان داده و توسعهدهندگان هوش مصنوعی فراهم میکند تا:
- تحلیل خطا. برای شناسایی توزیع خطا در مدل که میتواند بر انصاف یا قابلیت اطمینان سیستم تأثیر بگذارد.
- بررسی کلی مدل. برای کشف نابرابریهای عملکرد مدل در میان گروههای مختلف داده.
- تحلیل داده. برای درک توزیع داده و شناسایی هر گونه سوگیری احتمالی در داده که میتواند منجر به مشکلات مربوط به انصاف، فراگیری و قابلیت اطمینان گردد.
- توضیحپذیری مدل. برای درک عواملی که بر پیشبینیهای مدل تأثیر میگذارند. این امر در توضیح رفتار مدل که برای شفافیت و مسئولیتپذیری ضروری است، کمک میکند.
🚀 چالش
برای پیشگیری از ایجاد آسیبها در وهله اول، باید:
- در تیمهای توسعه سیستمها، تنوعی از پیشینهها و دیدگاهها وجود داشته باشد
- در دادههایی سرمایهگذاری شود که تنوع جامعه ما را منعکس کنند
- روشهای بهتری در طول چرخه عمر یادگیری ماشین برای شناسایی و اصلاح هوش مصنوعی غیرمسئولانه زمانی که رخ میدهد توسعه یابد
درباره سناریوهای واقعی فکر کنید که بیاعتمادی یک مدل در ساخت و استفاده از مدل آشکار است. چه نکات دیگری باید در نظر بگیریم؟
آزمون پس از درس
بازبینی و مطالعه خودآموز
در این درس، با برخی مبانی مفاهیم عدالت و بیعدالتی در یادگیری ماشین آشنا شدهاید.
این کارگاه را تماشا کنید تا عمیقتر با موضوعات آشنا شوید:
- در پی هوش مصنوعی مسئولانه: آوردن اصول به عمل توسط بسمیرا نوشی، مهرنوش سمیعی و آمیت شارما

🎥 برای دیدن ویدیو، روی تصویر بالا کلیک کنید: جعبهابزار RAI: چارچوب متنباز برای ساخت هوش مصنوعی مسئولانه توسط بسمیرا نوشی، مهرنوش سامکی، و آمیت شارما
همچنین بخوانید:
-
مرکز منابع RAI مایکروسافت: منابع هوش مصنوعی مسئول – هوش مصنوعی مایکروسافت
-
گروه تحقیقات FATE مایکروسافت: FATE: انصاف، پاسخگویی، شفافیت، و اخلاق در هوش مصنوعی - تحقیقات مایکروسافت
جعبهابزار RAI:
درباره ابزارهای Azure Machine Learning برای تضمین انصاف بخوانید:
تکلیف
سلب مسئولیت: این سند با استفاده از سرویس ترجمه هوش مصنوعی Co-op Translator ترجمه شده است. در حالی که ما در تلاش برای دقت هستیم، لطفاً توجه داشته باشید که ترجمههای خودکار ممکن است شامل خطاها یا نادرستیهایی باشند. سند اصلی به زبان مادری خود باید به عنوان منبع معتبر در نظر گرفته شود. برای اطلاعات حیاتی، ترجمه حرفهای انسانی توصیه میشود. ما در قبال هرگونه سوء تفاهم یا برداشت نادرست ناشی از استفاده از این ترجمه مسئولیتی نداریم.