
 localizeflow[bot]
4e2f9e9b38 |
3 weeks ago | |
|---|---|---|
| .. | ||
| solution | 8 months ago | |
| README.md | 3 weeks ago | |
| assignment.md | 8 months ago | |
| notebook.ipynb | 1 year ago | |
README.md
회귀 모델을 위한 Python 및 Scikit-learn 시작하기
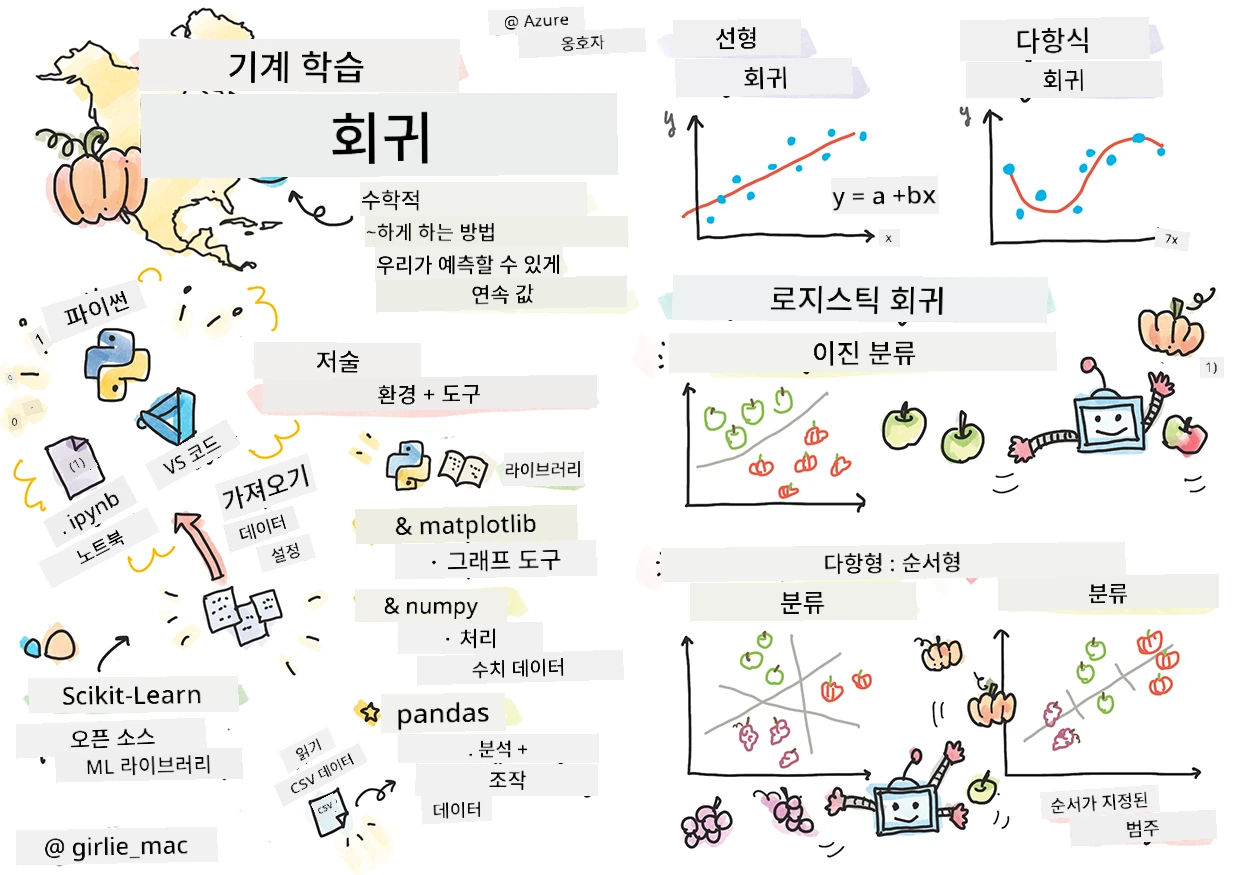
스케치노트 작성자: Tomomi Imura
강의 전 퀴즈
이 강의는 R 버전도 제공됩니다!
소개
이 네 강의에서 회귀 모델을 만드는 방법을 배우게 됩니다. 곧 회귀 모델이 무엇인지에 대해 설명할 예정입니다. 하지만 시작하기 전에, 작업을 시작할 수 있도록 적절한 도구가 준비되어 있는지 꼭 확인하세요!
이 강의에서는 다음을 배우게 됩니다:
- 로컬 머신러닝 작업을 위한 컴퓨터 설정.
- 주피터 노트북 사용 방법.
- Scikit-learn 설치 및 사용법.
- 핸즈온 실습을 통해 선형 회귀 탐색.
설치 및 설정

🎥 위 이미지를 클릭하면 컴퓨터를 머신러닝용으로 설정하는 과정을 담은 짧은 영상을 볼 수 있습니다.
-
Python 설치. 컴퓨터에 Python이 설치되어 있는지 확인하세요. Python은 많은 데이터 과학 및 머신러닝 작업에 사용됩니다. 대부분의 컴퓨터 시스템에는 이미 Python이 설치되어 있습니다. 일부 사용자를 위해 유용한 Python 코딩 팩도 제공됩니다.
다만, Python 사용 용도에 따라 소프트웨어 버전이 서로 다를 수 있으므로, 가상 환경에서 작업하는 것이 유용합니다.
-
Visual Studio Code 설치. 컴퓨터에 Visual Studio Code가 설치되어 있는지 확인하세요. 기본 설치를 위해 Visual Studio Code 설치 방법을 참고하세요. 이 과정에서는 Visual Studio Code에서 Python을 사용할 예정이므로, Visual Studio Code를 Python 개발용으로 설정하기에 익숙해지는 것이 좋습니다.
이 학습 모듈을 통해 Python을 익숙하게 다뤄보세요.

🎥 위 이미지를 클릭하면 VS Code 내 Python 사용법 영상이 나옵니다.
-
Scikit-learn 설치는 이 안내에 따라 진행하세요. Python 3을 사용해야 하므로 가상 환경을 사용하는 것이 권장됩니다. M1 Mac에서 설치할 경우 별도의 특별 안내가 상기 링크에 있습니다.
-
Jupyter Notebook 설치. Jupyter 패키지 설치가 필요합니다.
ML 작성 환경
Python 코드를 개발하고 머신러닝 모델을 만들기 위해 노트북을 사용할 예정입니다. 노트북 파일은 데이터 과학자들이 자주 사용하는 도구로, .ipynb 확장자로 구분됩니다.
노트북은 코드 작성과 함께 코드 주석, 문서 작성이 가능한 상호작용 환경으로, 실험이나 연구 중심 프로젝트에 매우 유용합니다.

🎥 위 이미지를 클릭하면 이번 실습 과정을 담은 짧은 영상을 볼 수 있습니다.
실습 - 노트북과 작업하기
이 폴더 안에 notebook.ipynb 파일이 있습니다.
-
Visual Studio Code에서 notebook.ipynb 파일을 엽니다.
Python 3+가 실행되는 Jupyter 서버가 시작됩니다. 노트북 내에는
run가능한 코드 블록들이 있습니다. 플레이 버튼 모양의 아이콘을 눌러 코드 블록을 실행할 수 있습니다. -
md아이콘을 선택하고 마크다운을 입력한 다음 다음 텍스트를 추가하세요: # Welcome to your notebook.다음으로 Python 코드를 추가해 보겠습니다.
-
코드 블록에 print('hello notebook')을 입력하세요.
-
코드를 실행하려면 화살표 아이콘을 선택하세요.
출력문이 다음과 같이 나타납니다:
hello notebook
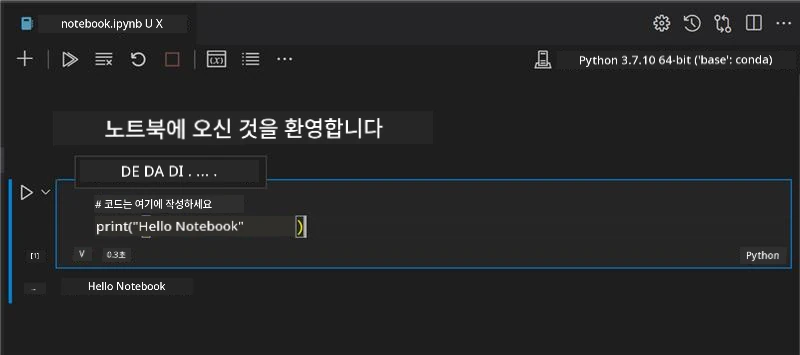
코드를 주석과 함께 사용하여 노트북을 자체 문서화할 수 있습니다.
✅ 웹 개발자의 작업 환경과 데이터 과학자의 작업 환경이 어떻게 다를지 잠시 생각해 보세요.
Scikit-learn 시작하기
이제 Python이 로컬 환경에 설치되고 Jupyter 노트북 사용에 익숙해졌으니, Scikit-learn 도구에도 익숙해져 봅시다(sci는 science처럼 발음). Scikit-learn은 머신러닝 작업을 수행할 수 있도록 광범위한 API를 제공합니다.
공식 웹사이트에 따르면, "Scikit-learn은 감독학습과 비감독학습을 지원하는 오픈소스 머신러닝 라이브러리입니다. 모델 피팅, 데이터 전처리, 모델 선택 및 평가 등 다양한 도구를 제공합니다."
이 강의에서는 Scikit-learn과 기타 도구를 사용하여 전통적인 머신러닝 작업을 수행하는 모델을 만듭니다. 신경망이나 딥러닝은 우리 차후의 'AI 초보자 과정'에서 다루기 때문에 여기서는 의도적으로 제외했습니다.
Scikit-learn은 모델 구축과 평가 과정을 간단하게 해줍니다. 주로 수치 데이터를 사용하며, 학습용으로 쓸 수 있는 여러 내장 데이터셋과 학생들이 시도할 수 있는 사전 구축 모델을 포함합니다. 이제 기본 데이터를 사용해 사전 패키지 데이터를 불러오고 내장 추정기를 활용해 첫 ML 모델을 만들어봅시다.
실습 - 첫 Scikit-learn 노트북
이 튜토리얼은 Scikit-learn 공식 웹사이트의 선형 회귀 예제에서 영감을 받았습니다.

🎥 위 이미지를 클릭하면 이번 실습 과정을 담은 짧은 영상으로 이동합니다.
notebook.ipynb 파일에서 휴지통 아이콘을 눌러 모든 셀을 삭제하세요.
이번 섹션에서는 Scikit-learn에 내장된 당뇨병에 관한 작은 데이터셋으로 작업할 것입니다. 당뇨병 환자 치료법을 테스트하고자 한다고 가정해 보세요. 머신러닝 모델은 변수들의 조합을 기반으로 어떤 환자가 치료에 더 반응할지 판단하는 데 도움을 줄 수 있습니다. 간단한 회귀 모델이라도 시각화하면 이론적인 임상시험 설계에 도움이 될 변수 정보를 보여줄 수 있습니다.
✅ 회귀 방법은 여러 가지가 있으며, 어떤 방법을 골라야 할지는 찾으려는 답에 따라 달라집니다. 예를 들어, 특정 나이의 사람 키를 예측하려면 수치 값을 찾는 것이므로 선형 회귀를 사용합니다. 반면 어떤 요리가 비건인지 아닌지를 분류하려면 범주 할당을 원하므로 로지스틱 회귀를 사용합니다. 로지스틱 회귀는 나중에 더 자세히 배울 것입니다. 데이터에서 던질 수 있는 질문과 적합한 방법을 생각해 보세요.
그럼 바로 시작해 봅시다.
라이브러리 임포트
이 작업을 위해 다음 라이브러리를 임포트합니다:
- matplotlib. 유용한 그래프 도구로 선 그래프를 만듭니다.
- numpy. Python에서 숫자 데이터를 다루는 데 유용한 numpy 라이브러리입니다.
- sklearn. Scikit-learn 라이브러리입니다.
작업을 돕기 위한 라이브러리를 임포트하세요.
-
다음 코드를 입력해 임포트합니다:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
위에서
matplotlib,numpy를 임포트하고,sklearn에서datasets,linear_model,model_selection을 임포트합니다.model_selection은 데이터를 훈련 세트와 테스트 세트로 나누는 용도입니다.
당뇨병 데이터셋
내장된 당뇨병 데이터셋에는 442개의 당뇨병 관련 샘플과 10개의 특징 변수들이 포함되어 있습니다. 그중 일부는 다음과 같습니다:
- age: 나이(년 단위)
- bmi: 체질량 지수
- bp: 평균 혈압
- s1 tc: T-세포(백혈구의 일종)
✅ 이 데이터셋에는 당뇨병 연구에 중요한 특징 변수인 ‘성별’ 개념이 포함되어 있습니다. 많은 의학 데이터셋에 이진 분류가 포함되는데, 이런 분류가 인구 일부를 치료에서 배제하는 방식이 될 수 있다는 점도 생각해 보세요.
이제 X와 y 데이터를 로드합니다.
🎓 이 학습은 감독 학습입니다. 이름 붙은 'y' 타깃이 필요합니다.
새 코드 셀에서 load_diabetes()를 호출하여 당뇨병 데이터셋을 불러옵니다. return_X_y=True는 X가 데이터 행렬이고 y가 회귀 타깃임을 의미합니다.
-
데이터 행렬의 형태와 첫 번째 요소를 출력하는 명령을 추가합니다:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
반환되는 응답은 튜플입니다. 튜플의 첫 두 값을 각각
X와y에 할당하는 것입니다. 튜플에 대해 더 알아보기.이 데이터가 442개의 아이템으로 구성되며 각 배열은 10개의 요소로 되어 있음을 알 수 있습니다:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ 데이터와 회귀 타깃 간 관계를 잠시 생각해 보세요. 선형 회귀는 특징 X와 타깃 y 간 관계를 예측합니다. 당뇨병 데이터셋 설명서에서 타깃을 찾아보고, 이 데이터셋이 보여주는 것이 무엇인지 생각해 보세요.
-
이 데이터셋에서 3번째 컬럼 데이터를 선택하여 플로팅할 부분 데이터를 뽑습니다. 모든 행을 선택하려면
:연산자를 사용하고, 인덱스 2를 써서 3번째 컬럼을 선택합니다. 2차원 배열로 재구성하려면reshape(n_rows, n_columns)를 사용하세요. 파라미터 중 하나가 -1이면 해당 차원이 자동 계산됩니다.X = X[:, 2] X = X.reshape((-1,1))✅ 언제든 데이터를 출력해 형태를 확인하세요.
-
데이터를 플로팅할 준비가 되었으니, 머신러닝을 통해 데이터 집단 간 논리적 분할을 찾을 수 있는지 봅시다. 이를 위해 데이터(X)와 타깃(y)을 테스트 및 훈련 세트로 나누어야 합니다. Scikit-learn은 간단하게 이 작업을 지원합니다; 원하는 시점에 테스트 데이터를 나눌 수 있습니다.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
이제 모델을 학습시킬 차례입니다! 선형 회귀 모델을 불러와
model.fit()으로 X와 y 훈련 세트를 사용하여 훈련합니다:model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()은 TensorFlow 같은 많은 ML 라이브러리에서 볼 수 있는 함수입니다. -
이어서 테스트 데이터를 사용해
predict()함수를 통해 예측값을 생성합니다. 이 값이 데이터 그룹 간 선을 그릴 때 사용됩니다.y_pred = model.predict(X_test) -
이제 데이터를 플롯으로 표현할 시간입니다. Matplotlib은 이 작업에 매우 유용합니다. 테스트 X와 y의 점을 산점도로 그리고, 모델 예측값을 사용해 데이터 그룹 간 가장 적절한 위치에 선을 그리세요.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()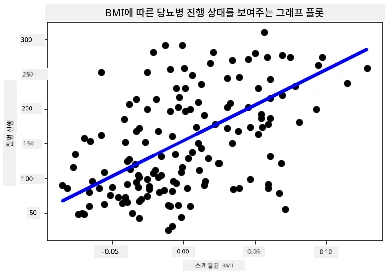
✅ 여기서 무슨 일이 일어나고 있는지 생각해 보세요. 직선이 무수한 작은 데이터 점 위를 통과하는데, 이 직선은 정확히 무엇을 하고 있을까요? 이 선을 사용해 새로 본 적 없는 데이터 지점이 플롯의 y축 상에서 어디에 속하는지 예측할 수 있음을 알 수 있나요? 이 모델의 실용적 사용법을 말로 표현해 보세요.
축하합니다! 첫 번째 선형 회귀 모델을 만들고, 예측을 수행하며, 플롯으로 결과를 표현했습니다!
🚀도전 과제
이 데이터셋에서 다른 변수를 플롯해 보세요. 힌트: 이 줄을 편집하세요: X = X[:,2]. 이 데이터셋의 타깃을 고려할 때, 당뇨병이라는 질병 진행 과정에 대해 어떤 점을 발견할 수 있나요?
강의 후 퀴즈
복습 및 자기 주도 학습
이 튜토리얼에서는 단변량이나 다변량 선형 회귀가 아니라 간단한 선형 회귀로 작업했습니다. 이 방법들 간 차이에 대해 읽어보거나 이 영상을 참고하세요.
회귀 개념에 대해 더 읽고 이 기법으로 어떤 종류의 질문에 답할 수 있는지 생각해 보세요. 이해를 깊게 하기 위해 이 튜토리얼을 진행해 보세요.
과제
면책 조항: 이 문서는 AI 번역 서비스 Co-op Translator를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역은 오류나 부정확한 부분이 있을 수 있음을 유의하시기 바랍니다. 원본 문서의 원어본이 권위 있는 자료로 간주되어야 합니다. 중요한 정보의 경우, 전문가의 인간 번역을 권장합니다. 이 번역 사용으로 인해 발생하는 오해나 잘못된 해석에 대해 당사는 책임을 지지 않습니다.