
 localizeflow[bot]
473353ea75 |
3 weeks ago | |
|---|---|---|
| .. | ||
| solution | 8 months ago | |
| README.md | 3 weeks ago | |
| assignment.md | 8 months ago | |
| notebook.ipynb | 1 year ago | |
README.md
شروع به کار با پایتون و Scikit-learn برای مدلهای رگرسیون
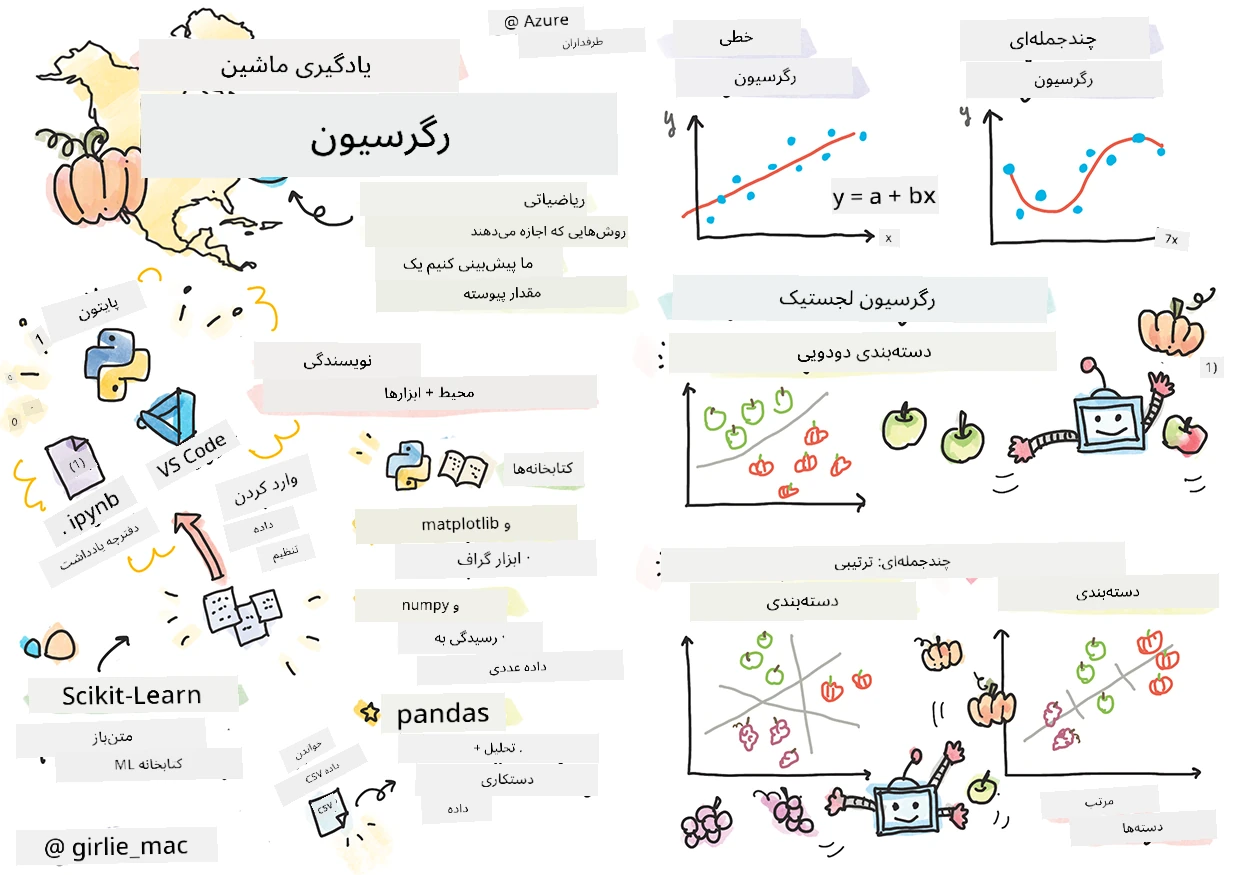
اسکچنوت توسط تومومی ایمورا
آزمون پیش از درس
این درس به زبان R نیز موجود است!
مقدمه
در این چهار درس، شما خواهید آموخت چگونه مدلهای رگرسیون بسازید. به زودی خواهیم گفت این مدلها برای چه کاری هستند. اما قبل از هر کاری، مطمئن شوید ابزارهای مناسب برای شروع فرآیند را در اختیار دارید!
در این درس، خواهید آموخت که چگونه:
- کامپیوتر خود را برای انجام وظایف یادگیری ماشین محلی پیکربندی کنید.
- با دفترچههای یادداشت Jupyter کار کنید.
- از Scikit-learn استفاده کنید، شامل نصب آن.
- رگرسیون خطی را با یک تمرین عملی بررسی کنید.
نصبها و پیکربندیها

🎥 روی تصویر بالا کلیک کنید تا یک ویدیوی کوتاه درباره پیکربندی کامپیوتر برای یادگیری ماشین ببینید.
-
نصب پایتون. اطمینان حاصل کنید که پایتون روی کامپیوتر شما نصب شده است. شما برای بسیاری از کارهای دادهکاوی و یادگیری ماشین از پایتون استفاده خواهید کرد. اکثر سیستمهای کامپیوتری از قبل پایتون را دارند. همچنین بستههای کدنویسی پایتون مفیدی برای آسانتر کردن نصب در دسترس هستند.
با این حال، برخی کاربردهای پایتون نیاز به نسخه خاصی از نرمافزار دارند، در حالی که دیگر کاربردها نسخهای دیگر را میطلبند. به همین دلیل، کار در یک محیط مجازی مفید است.
-
نصب Visual Studio Code. مطمئن شوید که Visual Studio Code روی کامپیوتر شما نصب شده است. این دستورالعملها را برای نصب Visual Studio Code دنبال کنید. در این دوره قرار است از پایتون در Visual Studio Code استفاده کنید، بنابراین ممکن است بخواهید نحوه پیکربندی Visual Studio Code برای توسعه پایتون را یاد بگیرید.
با مجموعهای از ماژولهای آموزش کار کنید تا با پایتون راحتتر شوید.

🎥 روی تصویر بالا کلیک کنید تا ویدیویی درباره استفاده از پایتون در VS Code ببینید.
-
نصب Scikit-learn، با دنبال کردن این دستورالعملها. با توجه به نیاز به استفاده از پایتون ۳، توصیه میشود از یک محیط مجازی استفاده کنید. توجه داشته باشید، اگر این کتابخانه را روی مک M1 نصب میکنید، دستورالعملهای خاصی در صفحه بالا وجود دارد.
-
نصب Jupyter Notebook. نیاز دارید که بسته Jupyter را نصب کنید.
محیط نویسندگی یادگیری ماشین شما
شما قرار است برای توسعه کدهای پایتون خود و ساخت مدلهای یادگیری ماشین از دفترچههای یادداشت استفاده کنید. این نوع فایل ابزار رایجی برای دانشمندان داده است و از طریق پسوند .ipynb شناخته میشود.
دفترچههای یادداشت محیط تعاملی هستند که به برنامهنویس اجازه میدهند هم کد بنویسد و هم یادداشت و مستندات پیرامون کد اضافه کند که برای پروژههای آزمایشی یا پژوهشی بسیار مفید است.

🎥 روی تصویر بالا کلیک کنید تا ویدیویی کوتاه درباره انجام این تمرین ببینید.
تمرین - کار با یک دفترچه یادداشت
در این پوشه، فایل notebook.ipynb را خواهید دید.
-
فایل notebook.ipynb را در Visual Studio Code باز کنید.
یک سرور Jupyter با پایتون ۳+ راهاندازی خواهد شد. بخشهایی از دفترچه وجود دارد که میتوانید آنها را
runکنید، بخشهایی از کد. برای اجرای یک بخش کد، روی آیکونی که شبیه دکمه پخش است کلیک کنید. -
آیکون
mdرا انتخاب کنید و کمی markdown اضافه کنید و متن زیر را بنویسید: # خوش آمدید به دفترچه یادداشت شما.سپس کمی کد پایتون اضافه کنید.
-
عبارت print('hello notebook') را در بلوک کد تایپ کنید.
-
فلش را انتخاب کنید تا کد اجرا شود.
باید عبارت چاپ شده زیر را مشاهده کنید:
hello notebook
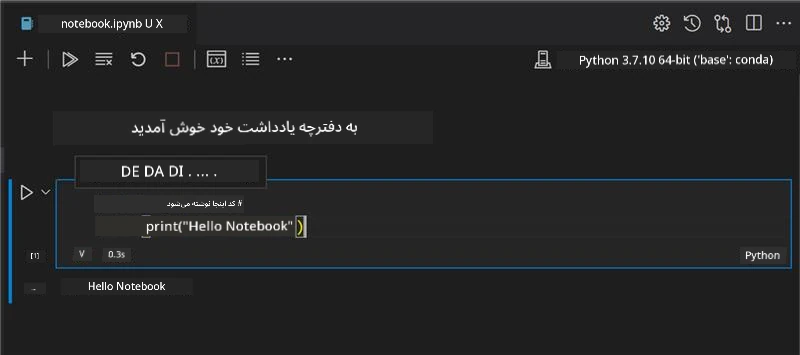
شما میتوانید کدهای خود را با کامنتها ترکیب کنید تا دفترچه یادداشت خودمستندسازی شود.
✅ یک لحظه فکر کنید که محیط کاری یک توسعهدهنده وب چقدر با محیط کار یک دانشمند داده متفاوت است.
راهاندازی و آمادهسازی Scikit-learn
حال که پایتون در محیط محلی شما نصب شده و با Jupyter Notebooks راحت هستید، بیایید با Scikit-learn هم آشنا شویم (تلفظ آن به صورت سای مثل علم است). Scikit-learn یک API گسترده برای کمک به انجام کارهای یادگیری ماشین فراهم میکند.
طبق وبسایتشان، "Scikit-learn یک کتابخانه متنباز یادگیری ماشین است که یادگیری نظارتشده و نظارتنشده را پشتیبانی میکند. همچنین ابزارهای مختلفی برای تناسب مدل، پیشپردازش داده، انتخاب مدل و ارزیابی آن، و بسیاری ابزارهای دیگر فراهم میکند."
در این دوره، شما از Scikit-learn و ابزارهای دیگر برای ساخت مدلهای یادگیری ماشینی استفاده خواهید کرد که کارهای یادگیری ماشین سنتی را انجام میدهند. ما عمداً از شبکههای عصبی و یادگیری عمیق پرهیز کردهایم، زیرا این موارد بهتر در دوره 'هوش مصنوعی برای مبتدیان' ما پوشش داده میشوند.
Scikit-learn ساخت مدلها و ارزیابی آنها برای استفاده را ساده میکند. تمرکز اصلی آن بر دادههای عددی است و چندین مجموعه داده آماده برای یادگیری دارد. همچنین مدلهای آمادهای دارد که دانشآموزان میتوانند امتحان کنند. بیایید فرآیند بارگذاری دادههای بستهبندیشده و استفاده از یک برآوردگر داخلی برای ساخت اولین مدل یادگیری ماشین با Scikit-learn را با دادههای پایه بررسی کنیم.
تمرین - نخستین دفترچه یادداشت Scikit-learn شما
این آموزش از مثال رگرسیون خطی در وبسایت Scikit-learn الهام گرفته است.

🎥 روی تصویر بالا کلیک کنید تا ویدیویی کوتاه درباره انجام این تمرین ببینید.
در فایل notebook.ipynb مربوط به این درس، با زدن آیکون 'سطل آشغال' تمام سلولها را پاک کنید.
در این بخش، شما با یک مجموعه داده کوچک درباره دیابت کار خواهید کرد که داخل Scikit-learn برای اهداف یادگیری تعبیه شده است. فرض کنید میخواهید درمانی برای بیماران دیابتی آزمایش کنید. مدلهای یادگیری ماشین ممکن است به شما کمک کنند تا تعیین کنید چه بیمارانی بهتر به درمان پاسخ میدهند، بر اساس ترکیبی از متغیرها. حتی یک مدل رگرسیون ساده، وقتی تجسمی شود، ممکن است اطلاعاتی درباره متغیرها ارائه دهد که به شما در سازماندهی آزمایشات بالینی نظری کمک کند.
✅ انواع مختلفی از روشهای رگرسیون وجود دارد و انتخاب هر کدام به پاسخی که میخواهید بستگی دارد. اگر میخواهید قد احتمالی یک فرد در سن معین را پیشبینی کنید، از رگرسیون خطی استفاده میکنید، زیرا دنبال یک مقدار عددی هستید. اگر میخواهید بدانید یک نوع غذا باید به عنوان وگان در نظر گرفته شود یا خیر، دنبال یک دستهبندی هستید و بنابراین از رگرسیون لجستیک استفاده میکنید. درباره رگرسیون لجستیک بعداً بیشتر خواهید آموخت. کمی فکر کنید به سوالاتی که میتوانید از دادهها بپرسید و کدام یک از این روشها مناسبتر است.
بیایید با این کار شروع کنیم.
وارد کردن کتابخانهها
برای این کار برخی کتابخانهها را وارد خواهیم کرد:
- matplotlib. این یک ابزار نمودارسازی مفید است و ما از آن برای رسم نمودار خطی استفاده میکنیم.
- numpy. numpy کتابخانهای مفید برای کار با دادههای عددی در پایتون است.
- sklearn. این همان کتابخانه Scikit-learn است.
کتابخانههایی را وارد کنید که به شما در انجام وظایف کمک کنند.
-
افزودن واردسازیها با تایپ کد زیر:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
در بالا
matplotlibوnumpyرا وارد میکنید و همچنین ازsklearn، ماژولهایdatasets،linear_modelوmodel_selectionرا وارد میکنید.model_selectionبرای تقسیم دادهها به مجموعههای آموزش و آزمایش استفاده میشود.
مجموعه داده دیابت
مجموعه داده داخلی دیابت شامل ۴۴۲ نمونه داده درباره دیابت است، با ۱۰ متغیر ویژگی، برخی از آنها شامل:
- سن: سن به سال
- bmi: شاخص توده بدن
- فشار خون: فشار خون متوسط
- s1 tc: سلولهای T (نوعی از گلبول سفید)
✅ این مجموعه داده، مفهوم «جنسیت» را به عنوان یک متغیر ویژگی مهم برای پژوهشهای مربوط به دیابت دربر دارد. بسیاری از مجموعههای داده پزشکی شامل این نوع دستهبندی دودویی هستند. کمی فکر کنید که چگونه چنین دستهبندیهایی ممکن است بخشهایی از جمعیت را از دسترسی به درمانها محروم کنند.
حال دادههای X و y را بارگذاری کنید.
🎓 به یاد داشته باشید، این یادگیری نظارتشده است و نیاز به یک هدف نامگذاری شده 'y' داریم.
در یک سلول کد جدید، مجموعه داده دیابت را با فراخوانی load_diabetes() بارگذاری کنید. ورودی return_X_y=True به این معنی است که X ماتریس دادهها خواهد بود و y هدف رگرسیون است.
-
چند دستور print اضافه کنید تا شکل ماتریس دادهها و اولین عنصر آن را نشان دهند:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
چیزی که به عنوان پاسخ دریافت میکنید یک tuple است. کاری که انجام میدهید این است که دو مقدار اول tuple را به ترتیب به
Xوyاختصاص میدهید. درباره tuple ها بیشتر بیاموزید.میبینید که این دادهها ۴۴۲ آیتم دارند که در آرایههایی با ۱۰ عنصر شکل گرفتهاند:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ کمی درباره رابطه دادهها و هدف رگرسیون فکر کنید. رگرسیون خطی رابطه بین ویژگی X و متغیر هدف y را پیشبینی میکند. آیا میتوانید هدف target مجموعه داده دیابت را در مستندات پیدا کنید؟ این مجموعه داده با توجه به آن هدف چه چیزی را نشان میدهد؟
-
سپس، بخشی از این مجموعه داده را برای ترسیم انتخاب کنید، با انتخاب ستون سوم مجموعه داده. میتوانید با استفاده از عملگر
:برای انتخاب همه ردیفها و سپس انتخاب ستون سوم با اندیس (۲)، این کار را انجام دهید. همچنین میتوانید دادهها را به شکل آرایه دو بعدی – که برای ترسیم لازم است – با استفاده ازreshape(n_rows, n_columns)تغییر شکل دهید. اگر یکی از پارامترها -۱ باشد، بعد مربوطه به طور خودکار محاسبه میشود.X = X[:, 2] X = X.reshape((-1,1))✅ در هر مرحله، دادهها را چاپ کنید تا شکل آنها را بررسی کنید.
-
اکنون که دادهها برای ترسیم آماده شدهاند، ببینید آیا یک ماشین میتواند یک تقسیم منطقی بین اعداد این مجموعه داده مشخص کند یا خیر. برای این کار، باید دادهها (X) و هدف (y) را به مجموعههای آزمایش و آموزش تقسیم کنید. Scikit-learn راهی ساده برای این کار دارد؛ میتوانید دادههای آزمایش خود را در یک نقطه مشخص تقسیم کنید.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
حالا آماده آموزش مدل خود هستید! مدل رگرسیون خطی را بارگذاری کنید و آن را با مجموعههای آموزش X و y با
model.fit()آموزش دهید:model = linear_model.LinearRegression() model.fit(X_train, y_train)✅ تابع
model.fit()در بسیاری از کتابخانههای یادگیری ماشین مانند TensorFlow وجود دارد -
سپس با دادههای آزمایشی پیشبینیای با استفاده از تابع
predict()ایجاد کنید. این برای کشیدن خط بین گروههای داده استفاده میشود.y_pred = model.predict(X_test) -
حالا وقت نمایش دادهها در یک نمودار است. Matplotlib ابزاری بسیار مفید برای این کار است. یک نمودار پراکندگی از تمام دادههای آزمایش X و y ایجاد کنید و از پیشبینی برای کشیدن خط در مناسبترین مکان، بین گروههای داده مدل استفاده کنید.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()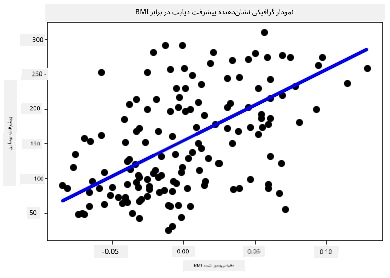
✅ کمی فکر کنید که در اینجا چه اتفاقی میافتد. یک خط صاف از میان بسیاری از نقاط کوچک داده عبور میکند، اما دقیقاً چه کاری انجام میدهد؟ آیا میتوانید ببینید چگونه باید بتوانید از این خط برای پیشبینی محل قرارگیری یک نقطه داده جدید و ندیده استفاده کنید، نسبت به محور y نمودار؟ تلاش کنید کاربرد عملی این مدل را به زبان بیاورید.
تبریک، شما اولین مدل رگرسیون خطی خود را ساختید، پیشبینیای ایجاد کردید و آن را در یک نمودار نمایش دادید!
🚀چالش
متغیری متفاوت از این مجموعه داده را ترسیم کنید. راهنما: این خط را ویرایش کنید: X = X[:,2]. با توجه به هدف این مجموعه داده، چه چیزهایی درباره پیشرفت دیابت به عنوان یک بیماری میتوانید کشف کنید؟
آزمون پس از درس
مرور و مطالعه خودآموز
در این آموزش، با رگرسیون خطی ساده کار کردید، نه رگرسیون خطی تک متغیره یا چند متغیره. کمی درباره تفاوتهای این روشها بخوانید، یا به این ویدیو نگاهی بیندازید.
درباره مفهوم رگرسیون بیشتر بخوانید و فکر کنید که با این تکنیک چه نوع سوالاتی میتوان پاسخ داد. این آموزش را برای درک عمیقتر خود انجام دهید.
تمرین
سلب مسئولیت: این سند با استفاده از سرویس ترجمه هوش مصنوعی Co-op Translator ترجمه شده است. در حالی که ما در تلاش برای دقت هستیم، لطفاً توجه داشته باشید که ترجمههای خودکار ممکن است شامل خطاها یا نادرستیهایی باشند. سند اصلی به زبان مادری خود باید به عنوان منبع معتبر در نظر گرفته شود. برای اطلاعات حیاتی، ترجمه حرفهای انسانی توصیه میشود. ما در قبال هرگونه سوء تفاهم یا برداشت نادرست ناشی از استفاده از این ترجمه مسئولیتی نداریم.