
 localizeflow[bot]
381c672660 |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
建立具負責任 AI 的機器學習解決方案

手繪筆記由 Tomomi Imura 製作
課前測驗
簡介
在這個課程中,您將開始探索機器學習如何影響及正在影響我們的日常生活。即使是現在,系統和模型也參與每日的決策任務,例如醫療診斷、貸款核准或詐騙偵測。因此,這些模型必須運作良好,提供值得信賴的結果。正如任何軟體應用一樣,AI 系統也可能未達預期或產生不良結果。因此,了解和解釋 AI 模型的行為至關重要。
想像一下,當用於建立這些模型的數據缺少某些人口統計資料,例如種族、性別、政治觀點、宗教,或不成比例代表這些人口統計資料時會發生什麼情況?又或者模型的輸出被解讀為偏袒某些人口統計?應用後果是什麼?此外,當模型產生負面結果並對人們造成傷害時會怎樣?誰應該對 AI 系統的行為負責?這些問題將會在本課程中探討。
本課程中,您將:
- 提升您對機器學習中公平性及與公平相關傷害重要性的認識。
- 熟悉探索異常值和不尋常情況以確保可靠性和安全性的做法。
- 了解設計包容性系統以賦權所有人的必要性。
- 探索保護數據及人員隱私和安全的重要性。
- 理解採用透明方法解釋 AI 模型行為的重要性。
- 了解問責制如何成為建立 AI 系統信任的關鍵。
先決條件
作為先決條件,請完成「負責任 AI 原則」學習路徑並觀看以下相關主題影片:
透過此學習路徑深入了解負責任 AI

🎥 點擊上方圖片觀看影片:Microsoft 對負責任 AI 的方法
公平性
AI 系統應公平對待每個人,避免對類似群體採取不同對待。例如,當 AI 系統提供醫療治療、貸款申請或聘用建議時,應對具有相似症狀、財務狀況或專業資格的人給出相同建議。每個人都帶有影響決策與行動的偏見,而這些偏見可能表現在用來訓練 AI 系統的數據中。有時這種操控是無意的,且往往難以有意識地察覺自己何時在數據中引入了偏見。
「不公平」 涵蓋對特定族群(如按種族、性別、年齡或殘障狀態定義的群體)造成的負面影響或「傷害」。主要與公平相關的傷害可分為:
- 分配,例如偏袒某性別或種族。
- 服務品質。若訓練資料僅針對特定場景,但現實情況更複雜,會導致服務表現不佳。例如,一款洗手液自動感應器無法正確感應深色皮膚的人。 參考
- 貶損。對某人或某事不公平地批評和標籤。例如,一些影像標註技術曾錯誤標記深色皮膚人士的照片為黑猩猩。
- 過度或不足代表。某族群在特定職業中缺乏代表性,持續推廣此種不平衡的服務或功能就是造成傷害。
- 刻板印象。將特定族群與預設屬性聯繫起來。例如,一個英語與土耳其語的翻譯系統可能因詞語帶有性別刻板印象而產生不準確情況。
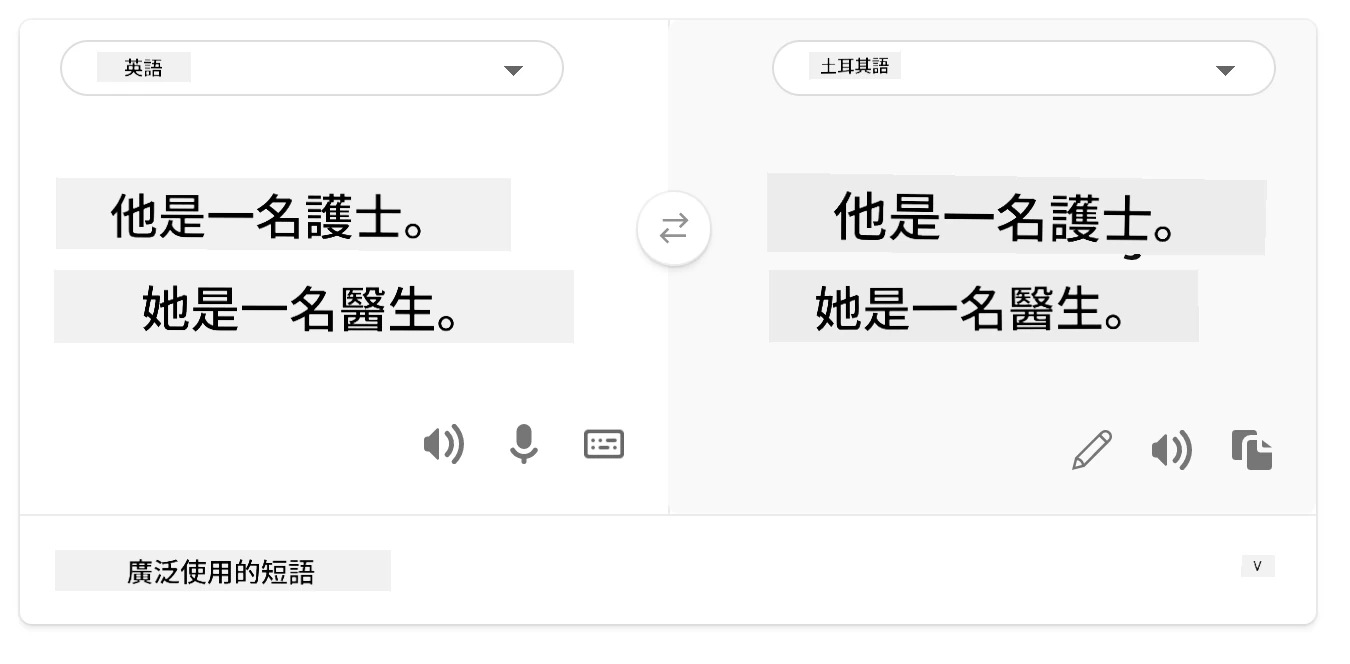
土耳其語翻譯
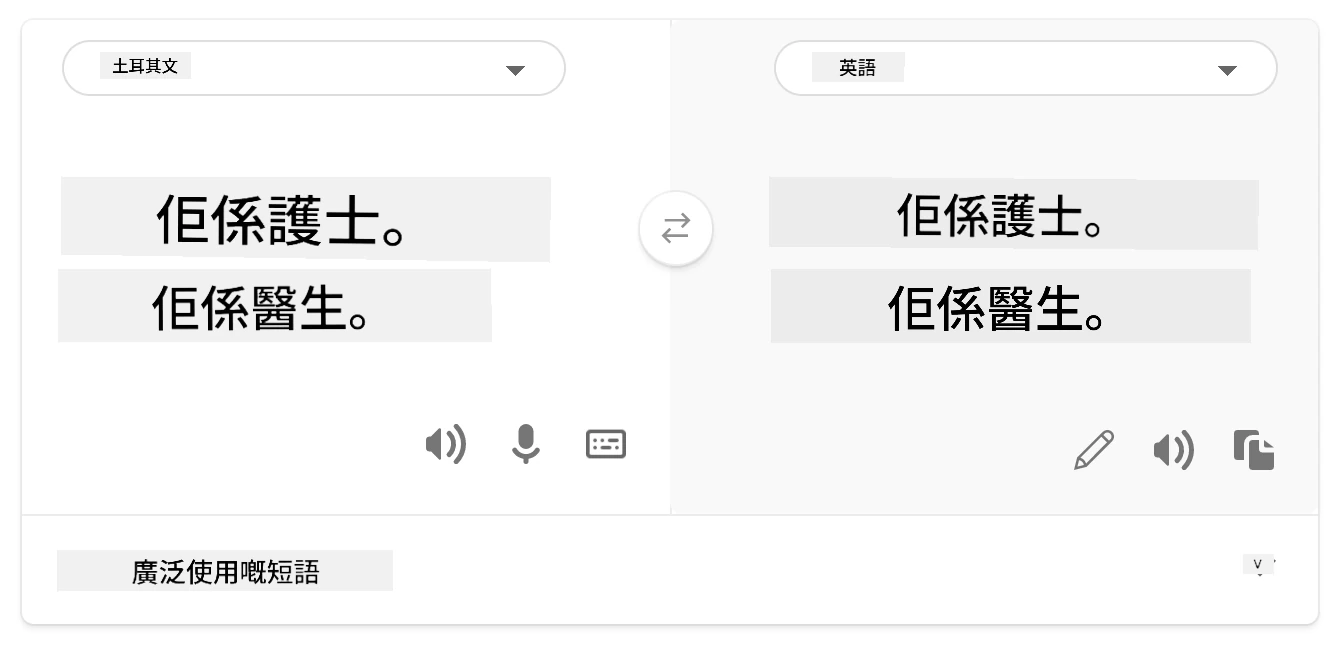
翻譯回英語
設計與測試 AI 系統時,我們需確保 AI 公平且不被程式化以作出偏頗或歧視性決策,這是人類亦不應做的。確保 AI 與機器學習的公平性始終是一項複雜的社會技術挑戰。
可靠性與安全性
為建立信任,AI 系統需在正常及意外狀況下保持可靠、安全和一致。了解 AI 系統在各種情況下的表現(尤其是異常狀況)很重要。建構 AI 解決方案時,須大量關注如何處理 AI 可能遇到的各種狀況。例如,自駕車必須將人身安全置於首位,因此驅動自駕車的 AI 需考慮夜晚、雷暴或暴雪、突然衝出馬路的小孩、寵物、道路施工等各種場景。AI 系統能多可靠安全地處理廣泛狀況,反映了數據科學家或 AI 開發者在系統設計或測試期間的預見程度。
包容性
AI 系統應被設計為包容並賦予每個人權力。設計與實施 AI 系統時,數據科學家及 AI 開發者會辨識並解決系統中可能無意排除人的障礙。例如,全球約有 10 億殘障人士,隨著 AI 進步,他們能在日常生活中更輕鬆獲取豐富資訊與機會。解決這些障礙創造了創新與開發更佳體驗的 AI 產品的機會,造福所有人。
安全與隱私
AI 系統應安全且尊重使用者隱私。使用者對威脅其隱私、資訊或生命安全的系統信任度較低。訓練機器學習模型時,我們依賴數據產出最佳結果,因此必須考慮數據的來源與完整性。例如,數據是用戶提交的還是公開可得的?接著,在處理數據時,必須開發能保護機密資訊並抵抗攻擊的 AI 系統。隨著 AI 更普及,保護隱私及保障重要個人和企業資訊變得更關鍵與複雜。隱私與資料安全在 AI 中尤需密切注意,因為数据是 AI 系統作出精準且有根據預測與決策的關鍵。
- 作為產業,我們在隱私與安全方面取得顯著進展,這很大程度受到像是 GDPR(通用資料保護條例)等規範的推動。
- 然而面對 AI 系統,我們必須承認在需要更多個人數據以達到系統個人化和高效性與隱私保護之間存在的張力。
- 就像網際網路連接電腦誕生時一樣,AI 安全相關問題也大幅增加。
- 同時,我們見證 AI 被用來提升安全性。例如,當代大多數防毒軟體掃描器如今由 AI 啟發的啟發式方法驅動。
- 我們需確保資料科學流程與最新隱私和安全實務和諧融合。
透明度
AI 系統應易於理解。透明度的要素之一是解釋 AI 系統及其組件的行為。提升對 AI 系統的理解,需讓利益關係人明白它們如何與為何運作,從而辨識可能的性能問題、安全與隱私疑慮、偏見、排除性做法或非預期結果。我們也相信使用 AI 系統的人應誠實坦白說明何時、為何及如何選擇部署它們,以及所用系統的限制。例如,若銀行使用 AI 系統支援消費者貸款決策,重要的是檢視結果並瞭解哪些數據影響系統建議。政府已開始規管各行業的 AI,故數據科學家與組織必須能解釋 AI 系統是否符合法規,尤其當結果不如預期時。
- 由於 AI 系統極為複雜,難以瞭解其運作原理及解釋結果。
- 這種理解欠缺影響該系統的管理、部署及文件框架。
- 更重要的是,這種理解缺失影響根據系統產出結果所作判決。
問責制
設計與部署 AI 系統的人必須為其系統的運作負責。問責制對於敏感技術如臉部辨識尤為重要。近期,臉部辨識技術需求增加,尤其來自執法部門,他們看中該技術在尋找失蹤兒童等用途上的潛力。但這些技術可能被政府用以威脅公民基本自由,例如持續監控特定個人。因此,數據科學家與組織須對 AI 系統對個人或社會造成的影響負責。
🎥 點擊圖片觀看影片:透過臉部辨識的大規模監控警告
最終,我們這一代作為第一代將 AI 帶入社會的人,最大且最關鍵的問題之一是如何確保電腦持續對人類負責,及設計電腦的人如何確保對所有人負責。
影響評估
在訓練機器學習模型前,進行影響評估非常重要,以了解 AI 系統的目的、預期用途、部署地點及使用者。這有助於評審或測試者在評估系統時知道該考慮哪些因素來判斷潛在風險與預期後果。
進行影響評估時的重點領域包括:
- 對個體的負面影響。了解任何限制或要求,未支持的用途或已知的限制,這對確保系統不會以可能傷害個體的方式被使用十分重要。
- 數據需求。了解系統將如何及在哪裡使用數據,促使評審探討必須注意的數據需求(例如 GDPR 或 HIPAA 數據條例)。此外,審查數據來源與數量是否足以用於訓練。
- 影響摘要。彙整使用系統可能引發的潛在傷害。機器學習整個生命週期中,需要檢視已識別的問題是否有被緩解或解決。
- 適用目標。評估六項核心原則中每項原則的目標是否達成,以及是否存在缺口。
負責任 AI 的偵錯
與軟體應用偵錯相似,偵錯 AI 系統是識別和解決系統問題的必要流程。許多因素會影響模型未達預期或不負責任的表現。多數傳統模型性能指標是模型表現的定量總結,但不足以分析模型如何違反負責任 AI 原則。此外,機器學習模型是黑箱,難以理解其產出原因或在出錯時提供解釋。本課程稍後將學習如何使用負責任 AI 儀表板協助偵錯 AI 系統。該儀表板為數據科學家和 AI 開發者提供整合工具,執行:
- 錯誤分析。辨識模型錯誤分布,評估對系統公平性或可靠性的影響。
- 模型概覽。發現模型在不同數據群組中的性能差異。
- 數據分析。理解數據分布並識別可能導致公平性、包容性及可靠性問題的偏見。
- 模型可解釋性。了解影響模型預測的因素,有助於解釋模型行為,對透明度與問責制至關重要。
🚀 挑戰
為防止傷害的產生,我們應該:
- 聘用具有多元背景與觀點的人才參與系統開發
- 投資能反映社會多元性的數據集
- 在整個機器學習生命週期中,開發更佳方法以偵測及修正不負責任的 AI 行為
想想現實中有關模型建造和使用時不可信的情況,我們還應該考慮什麼?
課後測驗
複習與自學
在本課中,您已學習機器學習中公平與不公平的基本概念。
觀看以下工作坊以深入了解相關主題:
- 追求負責任 AI:將原則付諸實踐,由 Besmira Nushi、Mehrnoosh Sameki 與 Amit Sharma 主講

🎥 點擊上方圖片觀看影片:責任型人工智能工具箱:由Besmira Nushi、Mehrnoosh Sameki和Amit Sharma介紹的用於構建責任型人工智能的開源框架
另外,請閱讀:
-
微軟的責任型人工智能資源中心:Responsible AI Resources – Microsoft AI
-
微軟的FATE研究小組:FATE: 公平性、問責制、透明性與倫理在人工智能中的應用 - 微軟研究院
RAI工具箱:
閱讀有關Azure機器學習確保公平性的工具:
任務
免責聲明: 本文件使用 AI 翻譯服務 Co-op Translator 進行翻譯。雖然我們力求準確,但請注意,自動翻譯可能包含錯誤或不準確之處。原始文件的母語版本應被視為權威來源。對於重要資訊,建議尋求專業人工翻譯。我們不對因使用本翻譯而引起的任何誤解或曲解承擔責任。