
 localizeflow[bot]
b7c2a4a7f1 |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Прављење решења машинског учења са одговорном вештачком интелигенцијом

Скетчноут од Tomomi Imura
Преквизни тест
Увод
У овом курикулуму ћете почети да откривате како машинско учење може и како утиче на наше свакодневне животе. Чак и сада, системи и модели су укључени у свакодневне задатке доношења одлука, као што су медицинске дијагнозе, одобрења кредита или откривање преваре. Због тога је важно да ти модели добро функционишу како би пружили резултате којима се може веровати. Баш као и сваки софтверски апликација, AI системи могу испасти испод очекивања или имати непожељне последице. Зато је кључно разумети и објаснити понашање AI модела.
Замислите шта се може догодити када подаци које користите за изградњу ових модела недостају одређене демографске групе, као што су раса, пол, политички став, религија, или када те демографије нису пропорционално заступљене. Шта је са тим када се излаз модела тумачи у корист неке демографске групе? Које су последице по апликацију? Поред тога, шта се дешава када модел има штетан исход који је опасан за људе? Ко је одговоран за понашање AI система? Ово су нека од питања која ћемо истражити у овом курикулуму.
У овој лекцији ћете:
- Подићи свест о важности праведности у машинском учењу и штетама везаним за неправедност.
- Упознати се са праксом испитивања уочених и необичних сценарија како би се обезбедила поузданост и безбедност.
- Стекнути разумевање о потреби да сви буду оснажени дизајнирањем инклузивних система.
- Истражити колико је важно штитити приватност и безбедност података и људи.
- Видети важност приступа "прозирне кутије" за објашњење понашања AI модела.
- Обратити пажњу на то како је одговорност есенцијална за изградњу поверења у AI системе.
Предуслови
Као предуслов, молимо вас да прођете „Принципе одговорне вештачке интелигенције“ кроз Learning Path и погледате видео испод на ову тему:
Сазнајте више о одговорној вештачкој интелигенцији пратећи овај Learning Path

🎥 Кликните на горњу слику за видео: Microsoft's Approach to Responsible AI
Праведност
AI системи треба да поступају праведно према свима и избегавају да утичу различито на сличне групе људи. На пример, када AI системи пружају смернице о медицинском лечењу, захтевима за кредитом или запошљавању, требало би да препоручују исте поступке свима са сличним симптомима, финансијским околностима или професионалним квалификацијама. Сваки од нас као човек носи у себи урођене предрасуде које утичу на наше одлуке и поступке. Ове предрасуде могу бити видљиве у подацима које користимо за обуку AI система. Таква манипулација понекад може бити ненамерна. Често је тешко свесно знати када уносите пристрасност у податке.
„Неправедност“ обухвата негативне ефекте или „штете“ по групу људи, као што су оне дефинисане у смислу расе, пола, старости или стања инвалидитета. Главне штете везане за праведност могу се класификовати као:
- Додела, ако се пола или етничка припадност, на пример, фаворизују у односу на други.
- Квалитет услуге. Ако обучавате податке за један специфичан сценарио, али је стварност много сложенија, то доводи до лоше функционишуће услуге. На пример, диспенсер за сапун који није могао да препозна људе са тамном кожом. Референца
- Понижавање. Неправедно критиковање и означавање нечега или некога. На пример, технологија за означавање слика погрешно је означила слике људи тамне коже као гориле.
- Прекомерно или недовољно заступање. Идеја је да одређена група није видљива у одређеној професији, а свака услуга или функција која то наставља да промовише доприноси штети.
- Стереотипизација. Повезивање одређене групе са унапред додељеним особинама. На пример, систем за превод језика између енглеског и турског може имати нетачности због речи које имају стереотипне асоцијације са полом.
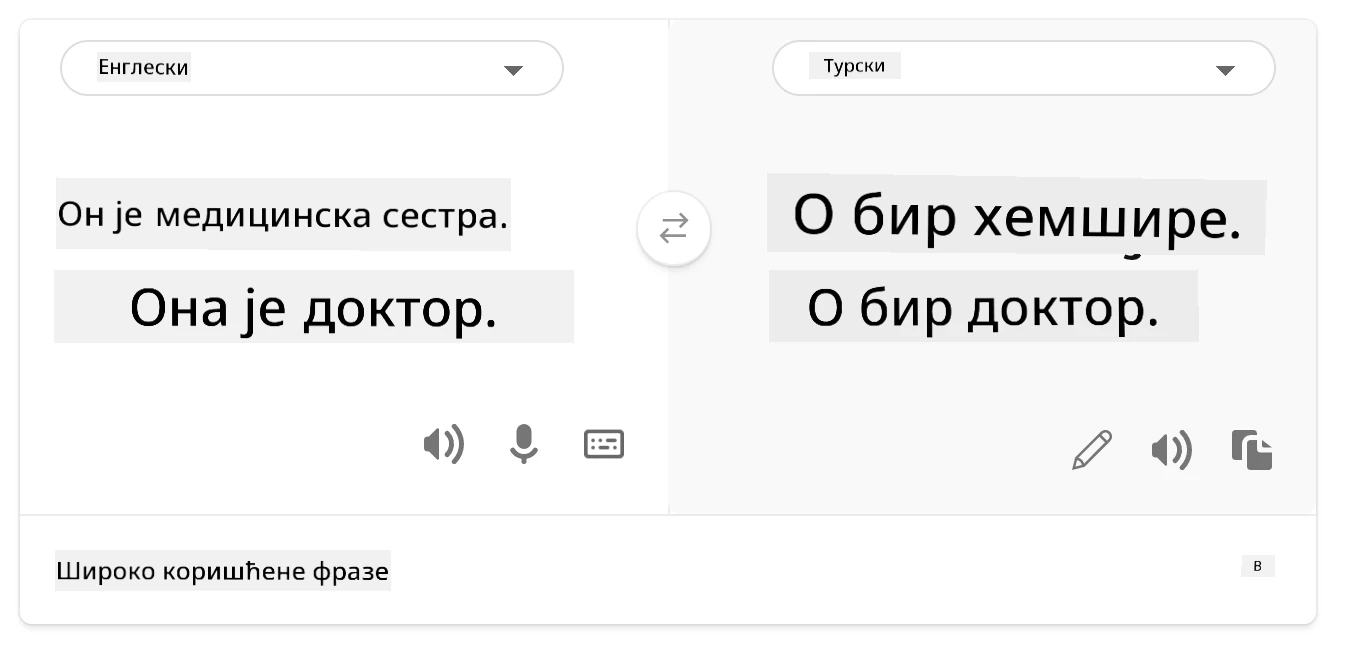
превод на турски
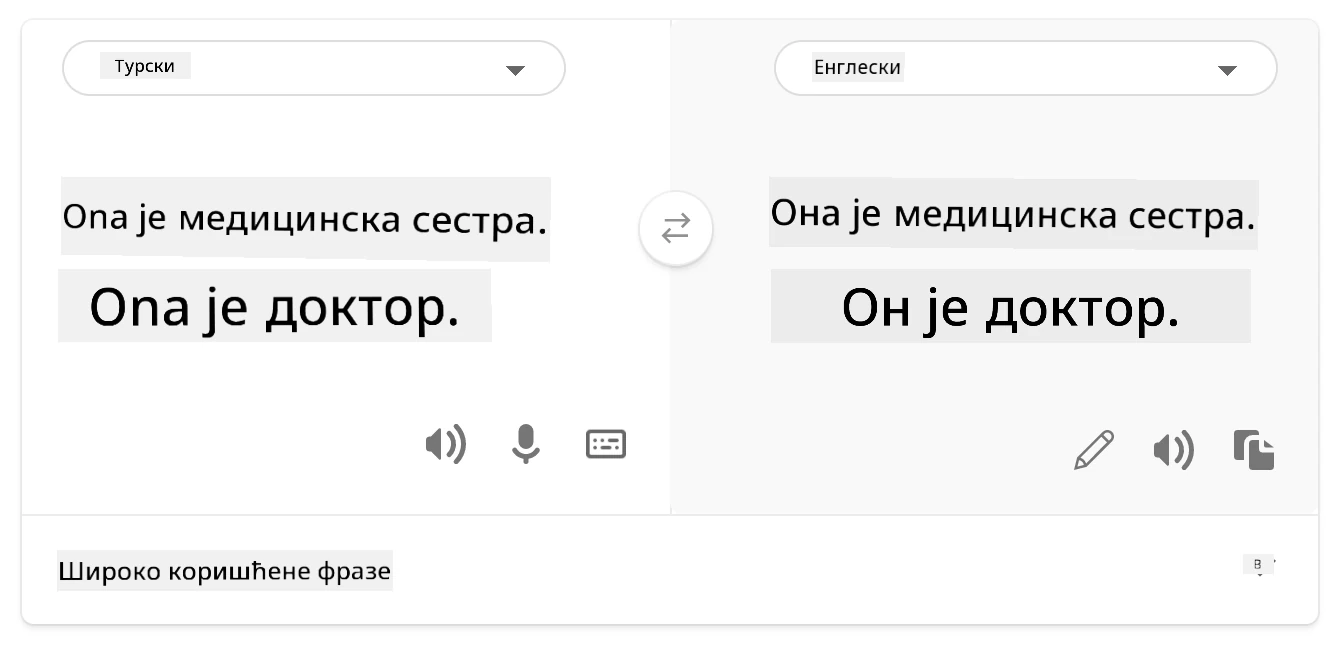
превод назад на енглески
Када дизајнирамо и тестирањем AI система, морамо осигурати да AI буде праведан и да није програмиран да доноси пристрасне или дискриминаторне одлуке, што је и људима забрањено. Гарантовање праведности у AI и машинском учењу остаје сложен социотехнички изазов.
Поузданост и безбедност
Да би изградили поверење, AI системи морају бити поуздани, безбедни и доследни у нормалним и неочекиваним условима. Важно је знати како ће се AI системи понашати у разним ситуацијама, посебно када су у питању изузеци. При прављењу AI решења мора се посветити значајна пажња томе како се носити са широким спектром околности на које AI решења могу наићи. На пример, самовозећи аутомобил мора ставити безбедност људи на прво место. Као резултат, AI који управља аутомобилом мора размотрити све могуће сценарије са којима може да се сусретне, као што су ноћ, олује или бурићи, деца која трче преко пута, кућни љубимци, путне радове итд. Колико добро AI систем може поуздано и безбедно да се носи са таквим условима одражава степен предвиђања који је стручњак за податке или AI програмер имао током дизајна или тестирања система.
Инклузивност
AI системи треба да буду дизајнирани тако да укључе и оснаже све. При дизајнирању и имплементацији AI система, стручњаци за податке и AI развојни инжењери идентификују и решавају потенцијалне баријере у систему које могу ненамерно искључити људе. На пример, у свету постоји 1 милијарда особа са инвалидитетом. Са напретком AI, они могу лакше приступити широком спектру информација и прилика у свакодневном животу. Решавањем тих баријера, стварају се могућности за иновације и развој AI производа са бољим искуствима која користе свима.
Безбедност и приватност
AI системи треба да буду безбедни и да поштују приватност људи. Људи имају мање поверења у системе који угрожавају њихову приватност, информације или животе. Када обучавамо моделе машинског учења, ослањамо се на податке да бисмо постигли најбоље резултате. При томе је важно узети у обзир порекло података и њихов интегритет. На пример, да ли су подаци достављени од корисника или су јавни? Затим, током рада са подацима, кључно је развити AI системе који могу заштитити поверљиве информације и одолети нападима. Како AI постаје све распрострањенији, заштита приватности и обезбеђење важних личних и пословних информација постаје све важнија и сложенија. Питања приватности и безбедности података захтевају посебну пажњу у AI јер је приступ подацима суштински за AI системе да би направили тачна и информисана предвиђања и одлуке о људима.
- Као индустрија смо остварили значајан напредак у области приватности и безбедности, нарочито захваљујући регулативама као што је GDPR (Општа уредба о заштити података).
- Ипак, са AI системима морамо признати тензију између потребе за више личних података ради личнијих и ефикаснијих система – и приватности.
- Баш као са рођењем повезаних рачунара са интернетом, такође видимо огроман пораст питања безбедности везаних за AI.
- Истовремено, видели смо да AI помаже у побољшању безбедности. На пример, већина савремених антивирусних скенера данас користи AI хеуристику.
- Морамо осигурати да наши процеси Data Science-а хармонично интегришу најновије праксе у области приватности и безбедности.
Транспарентност
AI системи треба да буду разумљиви. Кључни део транспарентности је објашњавање понашања AI система и њихових компонената. Побољшање разумевања AI система захтева да заинтересоване стране схвате како и зашто они функционишу, како би могли да идентификују потенцијалне проблеме у перформансама, безбедносне и приватне бриге, пристрасности, искључивајуће праксе или нежељене последице. Такође верујемо да они који користе AI системе треба да буду искрени и отворени о томе када, зашто и како их користе, као и о ограничењима тих система. На пример, ако банка користи AI систем који подржава одлуке о потрошачким кредитима, важно је испитати резултате и разумети који подаци утичу на препоруке система. Владе почињу да регулишу AI у различитим индустријама, тако да стручњаци за податке и организације морају објаснити да ли AI систем испуњава регулаторне захтеве, посебно када постоји непожељан исход.
- Пошто су AI системи веома сложени, тешко је разумети како раде и тумачити резултате.
- Овај недостатак разумевања утиче на начин на који се ти системи управљају, оперативизују и документују.
- Још важније, овај недостатак разумевања утиче на одлуке донесене на основу резултата које ти системи производе.
Одговорност
Људи који дизајнирају и имплементирају AI системе морају бити одговорни за то како њихови системи функционишу. Потреба за одговорношћу је посебно важна код осетљивих технологија као што је препознавање лица. У последње време постоји све већа потражња за технологијом препознавања лица, посебно од страна органа реда који виде потенцијал технологије у коришћењу као што је проналажење нестале деце. Међутим, ове технологије би могле потенцијално бити искоришћене од стране владе да угроже основне слободе својих грађана, на пример, омогућавајући стални надзор одређених појединаца. Зато стручњаци за податке и организације морају бити одговорни за то како њихов AI систем утиче на појединце или друштво.
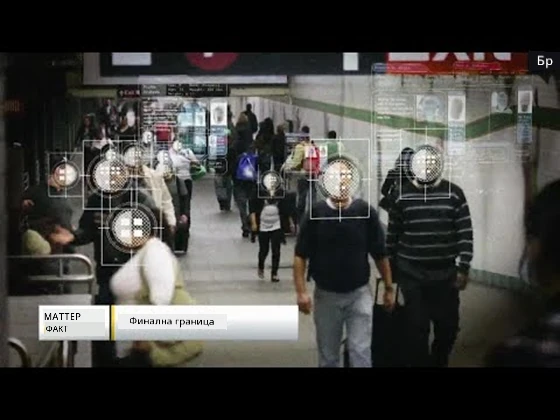
🎥 Кликните на слику изнад за видео: Упозорења о масовном надзору путем препознавања лица
На крају, једно од највећих питања за нашу генерацију, као прву генерацију која уводи AI у друштво, је како осигурати да рачунари остану одговорни људима и како осигурати да људи који дизајнирају рачунаре остану одговорни према свима осталима.
Процена утицаја
Пре тренинга модела машинског учења, важно је извршити процену утицаја да би се разумела сврха AI система; која је намењена употреба; где ће бити примењен; и ко ће га користити. Ово је корисно рецензентима или тестерима који процењују систем да знају на које факторе да обрате пажњу при идентификовању потенцијалних ризика и очекиваних последица.
Следећи су области фокуса приликом извођења процене утицаја:
- Негативан утицај на појединце. Бити свестан свих ограничења или захтева, несупротстављене употребе или познатих ограничења која ометају перформансе система је витално да се обезбеди да систем не буде коришћен на начин који може наудити појединцима.
- Захтеви за податке. Разумевање како и где ће систем користити податке омогућава рецензентима да испитају било какве захтеве за податке (нпр. GDPR или HIPAA регулисање података). Поред тога, проверавати да ли је извор или количина података довољна за обуку.
- Резиме утицаја. Прикупити листу потенцијалних штетних ефеката који могу настати употребом система. Током ML животног циклуса, прегледати да ли су идентификовани проблеми ублажени или решени.
- Примeњиви циљеви за сваки од шест основних принципа. Проценити да ли су циљеви сваког принципа испуњени и да ли постоје празнине.
Отстрањивање грешака са одговорном вештачком интелигенцијом
Слично као код отстрањивања грешака у софтверској апликацији, отстрањивање грешака у AI систему је неопходан процес идентификовања и решавања проблема у систему. Постоји много фактора који могу утицати да модел не функционише како се очекује или одговорно. Већина традиционалних метрика перформанси модела су квантитативни агрегати перформанси модела, који нису довољни за анализу како модел крши принципе одговорне AI. Поред тога, модел машинског учења је црна кутија која отежава разумевање шта покреће његов исход или пружање објашњења када направи грешку. Касније у овом курсу ћемо научити како користити Responsible AI контролну таблу да помогнете у отстрањивању грешака AI система. Контролна табла пружа холистички алат за стручњаке за податке и AI програмере да обављају:
- Анализу грешака. Да би се открила дистрибуција грешака модела која може утицати на праведност или поузданост система.
- Преглед модела. Да се открије где постоје разлике у перформансама модела преко различитих група података.
- Анализу података. Да би се разумела дистрибуција података и идентификовала било каква потенцијална пристрасност у подацима која може довести до проблема праведности, инклузивности и поузданости.
- Интерпретабилност модела. Да би се разумело шта утиче или обликује предвиђања модела. Ово помаже у објашњењу понашања модела, што је важно за транспарентност и одговорност.
🚀 Изазов
Да бисмо спречили уношење штета од почетка, требало би:
- имати разноликост позадина и перспектива међу људима који раде на системима
- улагати у скуп података који одражавају разноликост нашег друштва
- развити боље методе током целог животног циклуса машинског учења за откривање и исправљање неодговорне AI кад се појави
Размислите о стварним сценаријима у којима је непоузданост модела очигледна у изградњи и употреби модела. Шта још треба узети у обзир?
Пост-лекцијски квиз
Преглед и самоучење
У овој лекцији сте научили основне појмове праведности и неправедности у машинском учењу.
Погледајте овај радионички програм да дубље знате о темама:
- У потрази за одговорном AI: Примена принципа у пракси од стране Besmira Nushi, Mehrnoosh Sameki и Amit Sharma

🎥 Кликните на слику изнад за видео: RAI Toolbox: Отворена рамка за изградњу одговорног AI од Бесмире Нуши, Мехрнуш Самеки и Амита Шарме
Такође, прочитајте:
-
Microsoft-ов центар ресурса за RAI: Одговорни AI ресурси – Microsoft AI
-
Microsoft-ова FATE истраживачка група: FATE: Праведност, одговорност, транспарентност и етика у AI - Microsoft Research
RAI Toolbox:
Прочитајте о алатима Azure Machine Learning-а за осигурање праведности:
Задатак
Изјава о одрицању одговорности: Овај документ је преведен коришћењем услуге за аутоматски превод Co-op Translator. Иако тежимо тачности, имајте у виду да аутоматски преводи могу садржати грешке или нетачности. Оригинални документ на његовом изворном језику треба сматрати ауторитативним извором. За критичне информације препоручује се професионални људски превод. Нисмо одговорни за било каква неспоразума или погрешна тумачења која произилазе из коришћења овог превода.