
 localizeflow[bot]
b7c2a4a7f1 |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Izgradnja rešitev strojnega učenja z odgovorno umetno inteligenco

Sketchnote avtorja Tomomi Imura
Predpredavanje kviz
Uvod
V tem učnem načrtu boste začeli odkrivati, kako strojno učenje lahko vpliva in vpliva na naše vsakdanje življenje. Že zdaj so sistemi in modeli vključeni v vsakodnevne odločitvene naloge, kot so zdravstvene diagnoze, odobritev posojil ali odkrivanje goljufij. Zato je pomembno, da ti modeli dobro delujejo in zagotavljajo rezultate, ki so zaupanja vredni. Tako kot vsaka programska aplikacija, tudi sistemi umetne inteligence včasih ne dosežejo pričakovanj ali imajo nezaželen izid. Zato je ključnega pomena, da lahko razumemo in pojasnimo obnašanje modela umetne inteligence.
Predstavljajte si, kaj se lahko zgodi, ko podatki, ki jih uporabljate za izdelavo teh modelov, nimajo določenih demografskih skupin, kot so rasa, spol, politični nazor, vera, ali pa nesorazmerno predstavljajo takšne demografije. Kaj pa, ko se rezultat modela interpretira tako, da favorizira določeno demografsko skupino? Kakšne so posledice za aplikacijo? Poleg tega, kaj se zgodi, ko ima model škodljiv izid in škoduje ljudem? Kdo je odgovoren za obnašanje sistema umetne inteligence? To so nekatera vprašanja, ki jih bomo raziskovali v tem učnem načrtu.
V tej lekciji boste:
- Povečali svojo ozaveščenost o pomenu pravičnosti v strojnem učenju in škodah, povezanih s pravičnostjo.
- Spoznali prakso raziskovanja odstopanj in nenavadnih scenarijev za zagotavljanje zanesljivosti in varnosti.
- Razumeli potrebo po opolnomočenju vseh z oblikovanjem vključujočih sistemov.
- Raziskali, kako pomembno je zaščititi zasebnost in varnost podatkov ter ljudi.
- Spoznali pomen pristopa "steklena škatla" za razlago obnašanja modelov umetne inteligence.
- Bili pozorni na to, kako je odgovornost ključna za gradnjo zaupanja v sisteme umetne inteligence.
Predpogoji
Kot predpogoj vas prosimo, da opravite učni tečaj "Principi odgovorne umetne inteligence" in ogledate spodnji video na to temo:
Več o odgovorni umetni inteligenci izvedite s sledenjem temu učnemu tečaju

🎥 Kliknite na zgornjo sliko za video: Microsoftov pristop k odgovorni umetni inteligenci
Pravičnost
Sistemi umetne inteligence bi morali vse obravnavati pošteno ter se izogibati različnemu obravnavanju podobnih skupin ljudi. Na primer, ko sistemi umetne inteligence nudijo nasvete o medicinskem zdravljenju, vlogah za posojila ali zaposlitvi, bi morali vsem z enakimi simptomi, finančnimi pogoji ali strokovnimi kvalifikacijami dati iste priporočila. Vsak izmed nas, kot človek, nosi v sebi podedovane predsodke, ki vplivajo na naše odločitve in dejanja. Ti predsodki so lahko očitni v podatkih, ki jih uporabljamo za usposabljanje sistemov umetne inteligence. Takšna manipulacija se včasih zgodi nenamerno. Pogosto je težko zavestno prepoznati, kdaj uvajate pristranskost v podatke.
"Nepravičnost" zajema negativne vplive ali "škode" za skupino ljudi, kot so tiste, opredeljene po rasi, spolu, starosti ali statusu invalidnosti. Glavne škode, povezane s pravičnostjo, lahko razvrstimo kot:
- Dodelitev, če je na primer spol ali etnična skupina favorizirana pred drugo.
- Kakovost storitve. Če usposabljate podatke za en določen scenarij, a je realnost veliko bolj zapletena, to vodi do slabo delujoče storitve. Na primer, dozirnik za milo, ki očitno ne zazna ljudi s temno poltjo. Reference
- Opljuvanje. Nepravično kritiziranje in označevanje nečesa ali nekoga. Na primer, tehnologija označevanja slik je slovesno napačno označila ljudi s temno poltjo kot gorile.
- Prekomerna ali premalo zastopanost. Gre za idejo, da določene skupine ni mogoče videti v določenem poklicu, in vsaka storitev ali funkcija, ki to še naprej poudarja, prispeva k škodi.
- Stereotipizacija. Povezovanje določene skupine z vnaprej določenimi lastnostmi. Na primer, sistem za prevajanje med angleščino in turščino ima lahko netočnosti zaradi besed s stereotipnimi povezavami s spolom.
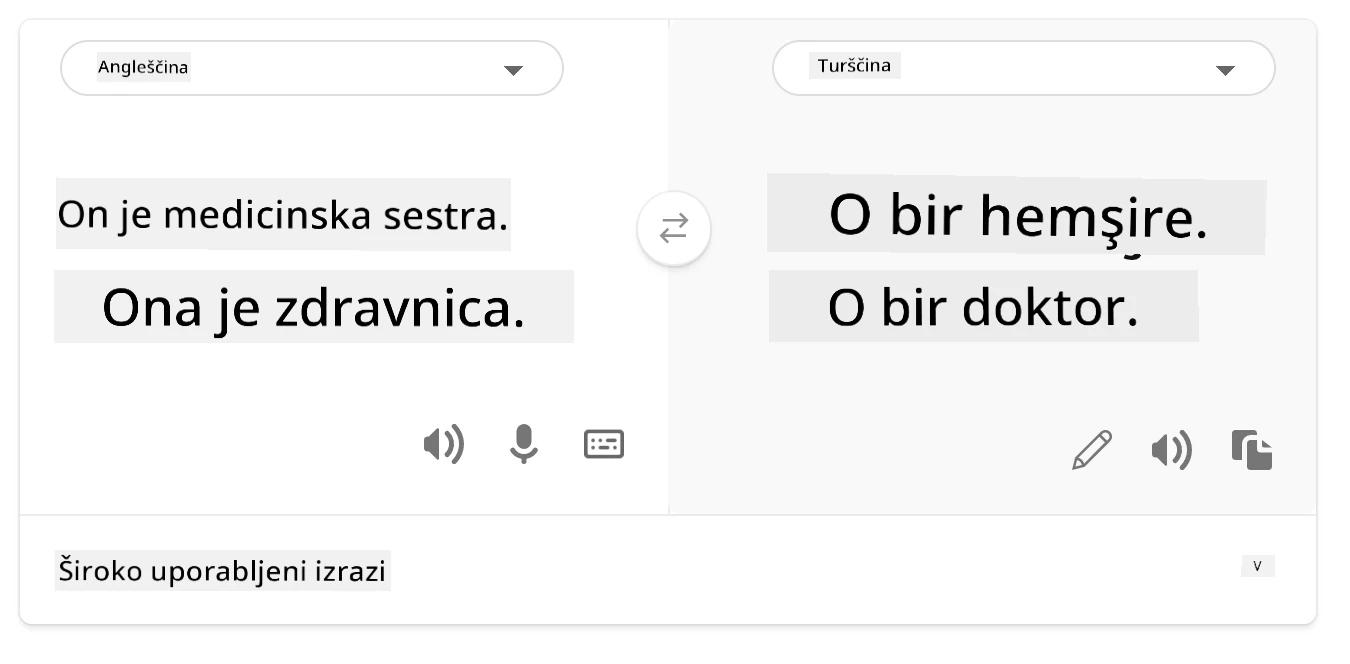
prevod v turščino
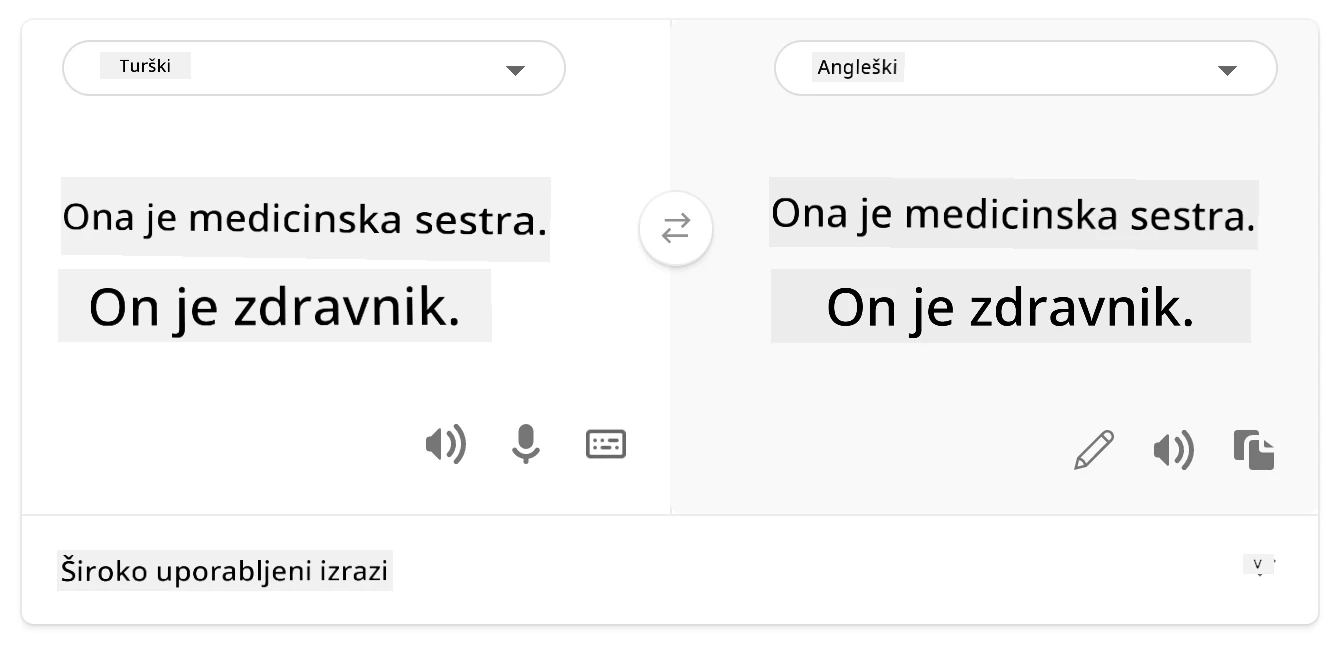
prevod nazaj v angleščino
Pri oblikovanju in testiranju sistemov umetne inteligence moramo zagotoviti, da je AI pravična in da ni programirana za sprejemanje pristranskih ali diskriminatornih odločitev, ki jih tudi ljudem ni dovoljeno sprejemati. Zagotavljanje pravičnosti v umetni inteligenci in strojnem učenju ostaja kompleksen sociotehnični izziv.
Zanesljivost in varnost
Za gradnjo zaupanja morajo biti sistemi umetne inteligence zanesljivi, varni in dosledni pod običajnimi in nepričakovanimi pogoji. Pomembno je vedeti, kako se bodo sistemi umetne inteligence obnašali v različnih situacijah, še posebej, ko so to odstopanja. Pri gradnji rešitev umetne inteligence je treba posvetiti veliko pozornosti ravnanju z različnimi okoliščinami, s katerimi se lahko rešitve srečajo. Na primer, avtonomno vozilo mora postaviti varnost ljudi na prvo mesto. Zato mora AI, ki poganja avto, upoštevati vse možne scenarije, s katerimi se lahko sreča, kot so noč, nevihtno vreme ali snežne nevihte, otroci, ki tečejo čez cesto, hišni ljubljenčki, cestišča v gradnji itd. Kako dobro lahko AI sistem zanesljivo in varno obvladuje širok razpon pogojev, odraža raven predvidevanja, ki ga je podatkovni znanstvenik oziroma razvijalec AI upošteval med oblikovanjem ali testiranjem sistema.
Vključenost
Sistemi umetne inteligence bi morali biti zasnovani tako, da vključujejo in opolnomočijo vse ljudi. Pri oblikovanju in uvedbi sistemov umetne inteligence podatkovni znanstveniki in razvijalci AI prepoznajo in odpravijo morebitne ovire, ki bi lahko nehote izključile ljudi. Na primer, po svetu je 1 milijarda ljudi z invalidnostjo. S pomočjo napredka AI lahko ti ljudje lažje dostopajo do različnih informacij in priložnosti v svojem vsakdanjem življenju. Odpravljač ovir ustvarja priložnosti za inovacije in razvoj izdelkov umetne inteligence z boljšimi izkušnjami, ki koristijo vsem.
Varnost in zasebnost
Sistemi umetne inteligence bi morali biti varni in spoštovati zasebnost ljudi. Ljudje manj zaupajo sistemom, ki ogrožajo njihovo zasebnost, informacije ali življenje. Pri usposabljanju modelov strojnega učenja se zanašamo na podatke za dosego najboljših rezultatov. Zato je treba upoštevati izvor podatkov in njihovo celovitost. Na primer, ali so podatke posredovali uporabniki ali so bili javno dostopni? Poleg tega je pri delu s podatki ključno razviti sisteme AI, ki lahko zaščitijo zaupne informacije in se uprejo napadom. Ker se AI vse bolj širi, je zaščita zasebnosti in varovanje pomembnih osebnih in poslovnih informacij vse bolj kritična in zapletena. Vprašanja zasebnosti in varnosti podatkov zahtevajo še posebej tesno pozornost pri AI, saj je dostop do podatkov bistven za to, da sistemi AI lahko naredijo natančna in informirana predvidevanja in odločitve o ljudeh.
- Kot industrija smo dosegli pomemben napredek na področju zasebnosti in varnosti, na kar so močno vplivale zakonodaje, kot je GDPR (Splošna uredba o varstvu podatkov).
- Kljub temu pa moramo pri sistemih AI priznati napetost med potrebo po več osebnih podatkih za bolj osebne in učinkovite sisteme – in zasebnostjo.
- Tako kot ob začetku povezanih računalnikov z internetom, tudi zdaj opažamo velik porast varnostnih vprašanj, povezanih z AI.
- Hkrati opažamo, da se AI uporablja za izboljšanje varnosti. Na primer, večina sodobnih protivirusnih skenerjev danes uporablja AI heuristike.
- Potrebno je zagotoviti, da se naši postopki podatkovne znanosti harmonično ujemajo z najnovejšimi praksami zasebnosti in varnosti.
Preglednost
Sistemi umetne inteligence bi morali biti razumljivi. Ključni del preglednosti je pojasnitev obnašanja sistemov umetne inteligence in njihovih komponent. Izboljšanje razumevanja sistemov AI zahteva, da deležniki razumejo, kako in zakaj ti delujejo, da lahko prepoznajo morebitne težave z zmogljivostjo, varnostjo in zasebnostjo, pristranskostmi, praksami izključevanja ali nezaželenimi izidi. Prav tako menimo, da bi morali tisti, ki uporabljajo AI sisteme, biti iskreni in odprti glede tega, kdaj, zakaj in kako jih odločijo uporabiti. Prav tako glede omejitev sistemov, ki jih uporabljajo. Na primer, če banka uporablja sistem AI za podporo pri odločitvah o posojilih potrošnikom, je pomembno pregledati rezultate in razumeti, kateri podatki vplivajo na priporočila sistema. Vlade začenjajo regulirati AI v različnih panogah, zato morajo podatkovni znanstveniki in organizacije pojasniti, ali AI sistem ustreza zahtevam predpisov, zlasti kadar pride do nezaželenega izida.
- Ker so sistemi AI zelo kompleksni, je težko razumeti, kako delujejo in interpretirati rezultate.
- Ta pomanjkanje razumevanja vpliva na način upravljanja, operativnosti in dokumentiranja teh sistemov.
- Še pomembneje pa to pomanjkanje razumevanja vpliva na odločitve, sprejete na podlagi rezultatov, ki jih ti sistemi proizvajajo.
Odgovornost
Ljudje, ki oblikujejo in uvajajo sisteme umetne inteligence, morajo biti odgovorni za način delovanja svojih sistemov. Potreba po odgovornosti je še posebej pomembna pri občutljivih tehnologijah, kot je prepoznavanje obrazov. V zadnjem času je vse več povpraševanja po tehnologiji prepoznavanja obrazov, zlasti s strani organov pregona, ki vidijo potencial tehnologije za iskanje pogrešanih otrok. Vendar pa bi te tehnologije lahko potencialno uporabila tudi vlada, da bi ogrozila temeljne svoboščine državljanov, na primer z omogočanjem stalnega nadzora določenih posameznikov. Zato morajo podatkovni znanstveniki in organizacije prevzeti odgovornost za vpliv svojega sistema AI na posameznike ali družbo.

🎥 Kliknite na zgornjo sliko za video: Opozorila o množičnem nadzoru prek prepoznavanja obrazov
Na koncu je eno največjih vprašanj za našo generacijo, kot prvo generacijo, ki uvaja AI v družbo, kako zagotoviti, da bodo računalniki ostali odgovorni ljudem in kako zagotoviti, da bodo ljudje, ki oblikujejo računalnike, ostali odgovorni vsem ostalim.
Ocena vpliva
Pred usposabljanjem modela strojnega učenja je pomembno izvesti oceno vpliva, da se razume namen sistema AI; kakšna je predvidena uporaba; kje bo sistem uveden; in kdo bo sistem uporabljal. To je koristno za pregledovalca(e) ali testirance, ki ocenjujejo sistem, da vedo, katere dejavnike upoštevati pri prepoznavanju morebitnih tveganj in pričakovanih posledic.
Pri izvajanju ocene vpliva so naslednja področja osredotočenosti:
- Neprijeten vpliv na posameznike. Pomembno je biti seznanjen z vsemi omejitvami ali zahtevami, neodobreno uporabo ali znanimi omejitvami, ki slabijo delovanje sistema, da se zagotovi, da sistem ne bo uporabljen na način, ki lahko škoduje posameznikom.
- Zahteve po podatkih. Razumevanje, kako in kje bo sistem uporabljal podatke, omogoča pregledovalcem raziskati vse zahteve glede podatkov, ki jih je treba upoštevati (npr. predpisi GDPR ali HIPAA). Poleg tega preučite, ali je vir ali količina podatkov pomembna za usposabljanje.
- Povzetek vpliva. Zberite seznam morebitnih škod, ki bi lahko nastale zaradi uporabe sistema. Med življenjskim ciklom strojnoučenja preverjajte, ali so bile identificirane težave omiljene ali rešene.
- Uveljavljivi cilji za vsak od šestih osnovnih načel. Ocenite, ali so cilji vsakega od načel izpolnjeni in ali obstajajo kakšne vrzeli.
Odpravljanje napak z odgovorno umetno inteligenco
Podobno kot pri odpravljanju napak v programski aplikaciji je odpravljanje napak v sistemu AI potrebno za prepoznavanje in reševanje težav v sistemu. Veliko dejavnikov lahko vpliva na to, da model ne deluje kot pričakovano ali odgovorno. Večina tradicionalnih meril zmogljivosti modela so kvantitativne agregacije zmogljivosti modela, ki niso zadostne za analizo, kako model krši principe odgovorne umetne inteligence. Poleg tega je model strojnega učenja črna škatla, kar otežuje razumevanje, kaj poganja njegov rezultat ali pojasnitev, ko naredi napako. Kasneje v tem tečaju se bomo naučili uporabljati nadzorno ploščo odgovorne umetne inteligence za pomoč pri odpravljanju napak v sistemih AI. Nadzorna plošča nudi celovito orodje za podatkovne znanstvenike in razvijalce AI za izvajanje:
- Analize napak. Prepoznavanje porazdelitve napak modela, ki lahko vplivajo na pravičnost ali zanesljivost sistema.
- Pregleda modela. Odkrivanje, kje so razlike v zmogljivosti modela med podatkovnimi skupinami.
- Analize podatkov. Razumevanje porazdelitve podatkov in prepoznavanje morebitne pristranskosti, ki bi lahko vodila do težav s pravičnostjo, vključenostjo in zanesljivostjo.
- Razložljivosti modela. Razumevanje, kaj vpliva ali kaže na napovedi modela. To pomaga pri pojasnjevanju obnašanja modela, kar je pomembno za preglednost in odgovornost.
🚀 Izziv
Da bi preprečili uvajanje škod že na začetku, bi morali:
- imeti raznolikost ozadij in pogledov med ljudmi, ki delajo na sistemih
- vlagati v podatkovne zbirke, ki odražajo raznolikost naše družbe
- razvijati boljše metode skozi življenjski cikel strojnega učenja za zaznavanje in popravilo neodgovorne umetne inteligence, ko se pojavi
Razmislite o resničnih življenjskih primerih, kjer je nezaupanja vrednost modela očitna pri gradnji in uporabi modela. Kaj še bi morali upoštevati?
Po-predavanjski kviz
Pregled in samostojno učenje
V tej lekciji ste se naučili nekaj osnovnih pojmov o pravičnosti in nepravičnosti v strojnem učenju.
Oglejte si delavnico za poglobljeno razumevanje tem:
- V prizadevanju za odgovorno umetno inteligenco: Prinašanje principov v prakso, avtorji Besmira Nushi, Mehrnoosh Sameki in Amit Sharma

🎥 Kliknite zgornjo sliko za video: RAI Toolbox: Okvir odprte kode za gradnjo odgovorne umetne inteligence avtorjev Besmira Nushi, Mehrnoosh Sameki in Amit Sharma
Prav tako preberite:
-
Microsoftov center virov za odgovorno umetno inteligenco: Responsible AI Resources – Microsoft AI
-
Microsoftova raziskovalna skupina FATE: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
Orodjarna za odgovorno umetno inteligenco:
Preberite o orodjih Azure Machine Learning za zagotavljanje pravičnosti:
Naloga
Omejitev odgovornosti: Ta dokument je bil preveden z uporabo AI prevajalske storitve Co-op Translator. Čeprav si prizadevamo za natančnost, vas prosimo, da upoštevate, da avtomatizirani prevodi lahko vsebujejo napake ali netočnosti. Izvirni dokument v njegovem izvirnem jeziku je treba obravnavati kot avtoritativni vir. Za kritične informacije je priporočljiv strokovni človeški prevod. Ne odgovarjamo za morebitna nesporazume ali napačne interpretacije, ki izhajajo iz uporabe tega prevoda.