
 localizeflow[bot]
c60c2e5841 |
3 weeks ago | |
|---|---|---|
| .. | ||
| solution | 8 months ago | |
| README.md | 3 weeks ago | |
| assignment.md | 8 months ago | |
| notebook.ipynb | 1 year ago | |
README.md
Începe cu Python și Scikit-learn pentru modele de regresie
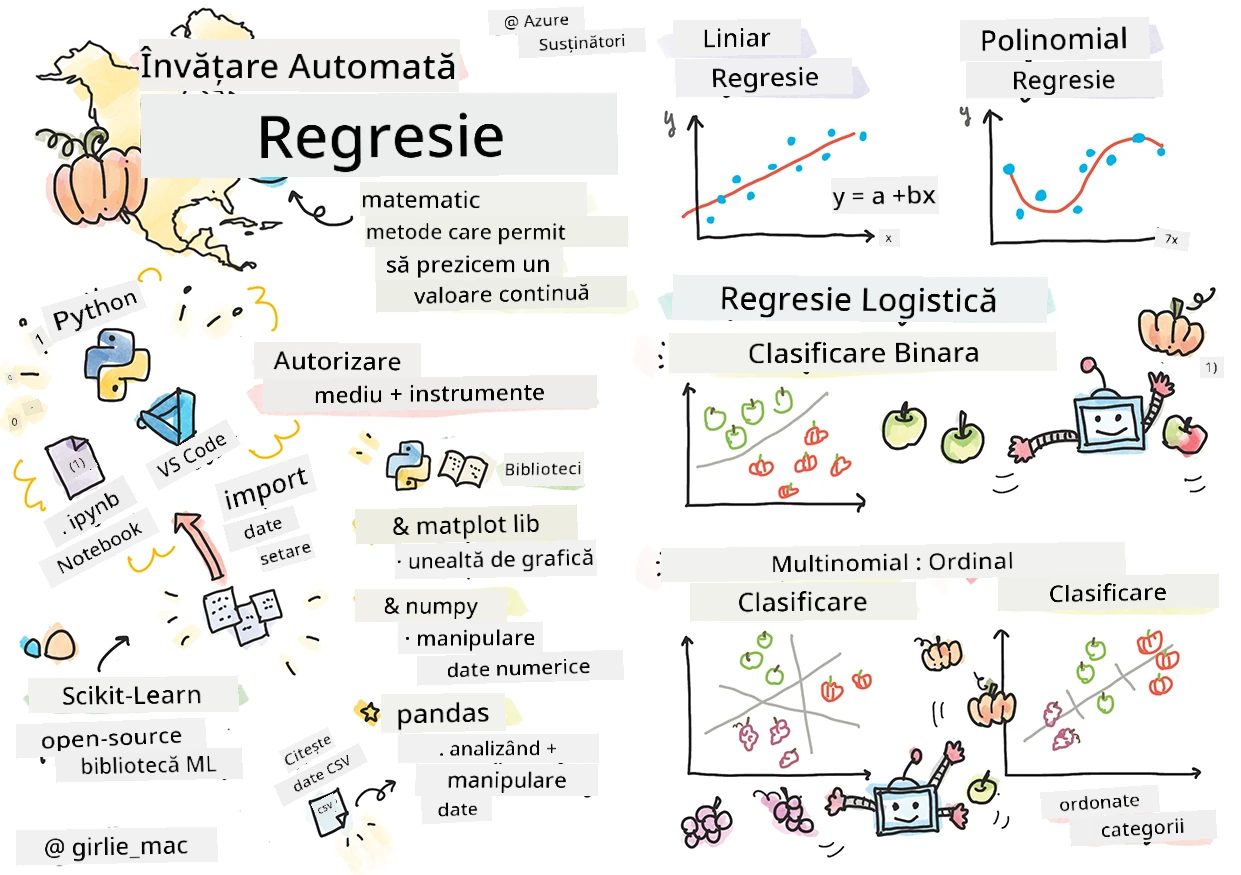
Sketchnote de Tomomi Imura
Chestionar pre-lectură
Această lecție este disponibilă în R!
Introducere
În aceste patru lecții, vei descoperi cum să construiești modele de regresie. Vom discuta în curând la ce servesc acestea. Dar înainte de a face orice, asigură-te că ai uneltele potrivite pregătite pentru a începe procesul!
În această lecție, vei învăța cum să:
- Configurezi calculatorul pentru sarcini locale de învățare automată.
- Lucrezi cu Jupyter Notebooks.
- Folosești Scikit-learn, inclusiv instalarea.
- Explorezi regresia liniară printr-un exercițiu practic.
Instalări și configurări

🎥 Fă click pe imaginea de mai sus pentru un scurt video despre configurarea calculatorului pentru ML.
-
Instalează Python. Asigură-te că Python este instalat pe calculatorul tău. Vei folosi Python pentru multe sarcini de știința datelor și învățare automată. Cele mai multe sisteme de calcul au deja instalat Python. Există și Pachete de codare Python utile disponibile, pentru a ușura configurarea pentru unii utilizatori.
Unele utilizări ale Python necesită o versiune a software-ului, în timp ce altele cer o versiune diferită. Din acest motiv, este util să lucrezi într-un mediu virtual.
-
Instalează Visual Studio Code. Verifică dacă ai Visual Studio Code instalat pe calculator. Urmează aceste instrucțiuni pentru a instala Visual Studio Code pentru instalarea de bază. Vei folosi Python în Visual Studio Code în acest curs, așa că s-ar putea să vrei să te familiarizezi cu modul de a configura Visual Studio Code pentru dezvoltarea în Python.
Familiarizează-te cu Python lucrând prin această colecție de module Learn

🎥 Fă click pe imaginea de mai sus pentru un video: utilizarea Python în VS Code.
-
Instalează Scikit-learn, urmând aceste instrucțiuni. Deoarece trebuie să te asiguri că folosești Python 3, este recomandat să folosești un mediu virtual. Notă, dacă instalezi această bibliotecă pe un Mac M1, există instrucțiuni speciale pe pagina legată mai sus.
-
Instalează Jupyter Notebook. Va trebui să instalezi pachetul Jupyter.
Mediul tău de creare ML
Vei folosi notebook-uri pentru a-ți dezvolta codul Python și a crea modele de învățare automată. Acest tip de fișier este un instrument comun pentru oamenii de știința datelor și poate fi identificat după sufixul sau extensia .ipynb.
Notebook-urile sunt un mediu interactiv care permite dezvoltatorului să scrie cod și să adauge note și documentație în jurul codului, ceea ce este foarte util pentru proiecte orientate spre cercetare sau experimentare.

🎥 Fă click pe imaginea de mai sus pentru un scurt video care detaliază acest exercițiu.
Exercițiu - lucrează cu un notebook
În acest folder vei găsi fișierul notebook.ipynb.
-
Deschide notebook.ipynb în Visual Studio Code.
Un server Jupyter va porni cu Python 3+ pornit. Vei găsi zone ale notebook-ului care pot fi
run, bucăți de cod. Poți rula un bloc de cod selectând iconița ce arată ca un buton de redare. -
Selectează iconița
mdși adaugă puțin markdown și textul următor # Bine ai venit în notebook-ul tău.Apoi, adaugă cod Python.
-
Scrie print('hello notebook') în blocul de cod.
-
Selectează săgeata pentru a rula codul.
Ar trebui să vezi declarația afișată:
hello notebook
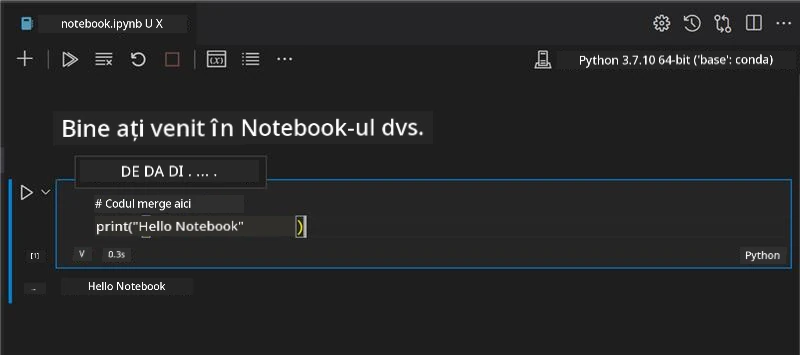
Poți intercala codul tău cu comentarii pentru a auto-documenta notebook-ul.
✅ Gândește-te pentru o clipă cât de diferit este mediul de lucru al unui dezvoltator web față de cel al unui om de știința datelor.
Configurat și gata de lucru cu Scikit-learn
Acum că Python este configurat în mediul tău local și ești confortabil cu Jupyter Notebooks, să devenim la fel de confortabili cu Scikit-learn (pronunță-l sci ca în science). Scikit-learn oferă un API extins pentru a te ajuta să efectuezi sarcini de ML.
Conform site-ului lor web, "Scikit-learn este o bibliotecă open source de învățare automată care suportă învățarea supravegheată și nesupravegheată. De asemenea, oferă diverse unelte pentru ajustarea modelelor, preprocesarea datelor, selecția și evaluarea modelelor și multe alte utilități."
În acest curs, vei folosi Scikit-learn și alte unelte pentru a construi modele de învățare automată pentru a realiza ceea ce numim sarcini de 'învățare automată tradițională'. Am evitat intenționat rețelele neuronale și deep learning, deoarece acestea sunt mai bine acoperite în curriculumul nostru viitor 'AI pentru începători'.
Scikit-learn face simplă construirea și evaluarea modelelor pentru utilizare. Se concentrează în special pe folosirea datelor numerice și conține mai multe seturi de date gata făcute pentru învățare. Include și modele predefinite pentru studenți. Haide să explorăm procesul de încărcare a datelor preambalate și utilizarea unui estimator încorporat pentru a crea primul tău model ML cu Scikit-learn cu niște date de bază.
Exercițiu - primul tău notebook Scikit-learn
Acest tutorial a fost inspirat de exemplul de regresie liniară de pe site-ul Scikit-learn.

🎥 Fă click pe imaginea de mai sus pentru un scurt video care detaliază acest exercițiu.
În fișierul notebook.ipynb atașat acestei lecții, golește toate celulele apăsând iconița „coș de gunoi”.
În această secțiune, vei lucra cu un set de date mic despre diabet care este încorporat în Scikit-learn pentru scopuri educaționale. Imaginează-ți că vrei să testezi un tratament pentru pacienții cu diabet. Modelele de învățare automată te-ar putea ajuta să determini care pacienți ar răspunde mai bine la tratament, bazat pe combinații de variabile. Chiar și un model de regresie foarte simplu, când este vizualizat, ar putea arăta informații despre variabile care te-ar ajuta să organizezi teoretic studiile clinice.
✅ Există multe tipuri de metode de regresie, iar pe care o alegi depinde de răspunsul pe care îl cauți. Dacă vrei să prezici înălțimea probabilă pentru o persoană de o anumită vârstă, vei folosi regresie liniară, deoarece cauți o valoare numerică. Dacă te interesează să descoperi dacă un tip de bucătărie ar trebui considerat vegan sau nu, cauți o alocare într-o categorie, deci vei folosi regresia logistică. Vei învăța mai multe despre regresia logistică mai târziu. Gândește-te puțin la întrebările pe care le poți pune datelor și care dintre aceste metode ar fi mai potrivită.
Să începem această sarcină.
Importă biblioteci
Pentru această sarcină vom importa câteva biblioteci:
- matplotlib. Este un instrument de grafică util și îl vom folosi pentru a crea un grafic de linie.
- numpy. numpy este o bibliotecă utilă pentru manipularea datelor numerice în Python.
- sklearn. Aceasta este biblioteca Scikit-learn.
Importă câteva biblioteci pentru a te ajuta cu sarcinile tale.
-
Adaugă importurile scriind următorul cod:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
Mai sus imporți
matplotlib,numpyși imporțidatasets,linear_modelșimodel_selectiondinsklearn.model_selectioneste folosit pentru a împărți datele în seturi de antrenament și test.
Setul de date diabet
Setul de date încorporat diabet include 442 de eșantioane de date despre diabet, cu 10 variabile caracteristice, unele dintre ele fiind:
- age: vârsta (ani)
- bmi: indicele de masă corporală
- bp: tensiunea arterială medie
- s1 tc: celule T (un tip de globule albe)
✅ Acest set de date include conceptul de „sex” ca variabilă caracteristică importantă în cercetarea diabetului. Multe seturi medicale includ acest tip de clasificare binară. Gândește-te puțin cum astfel de clasificări pot exclude anumite părți ale populației de la tratamente.
Acum, încarcă datele X și y.
🎓 Amintește-ți, aceasta este învățare supravegheată, și avem nevoie de o țintă numită 'y'.
Într-o celulă nouă de cod, încarcă setul de date diabet apelând load_diabetes(). Input-ul return_X_y=True semnalează că X va fi o matrice de date, iar y va fi ținta regresiei.
-
Adaugă câteva comenzi print pentru a afișa forma matricei de date și primul său element:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Ce primești ca răspuns este un tuplu. Ceea ce faci este să atribui primele două valori ale tuplului la
Xșiy, respectiv. Află mai multe despre tupluri.Poți vedea că aceste date au 442 de elemente structurate în array-uri de 10 elemente:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Gândește-te puțin la relația dintre date și ținta regresiei. Regresia liniară prezice relații între caracteristica X și variabila target y. Poți găsi ținta pentru setul de date diabet în documentație? Ce demonstrează acest set de date, având în vedere ținta?
-
Apoi, selectează o porțiune din acest set de date pentru a face o plotare, selectând coloana a 3-a a setului. Poți face asta folosind operatorul
:pentru a selecta toate rândurile, apoi selectând coloana a 3-a prin indexul (2). Poți de asemenea rearanja datele să fie un array 2D—cum e necesar pentru plotare—folosindreshape(n_rows, n_columns). Dacă unul din parametri este -1, dimensiunea corespunzătoare este calculată automat.X = X[:, 2] X = X.reshape((-1,1))✅ Oricând, afișează datele pentru a verifica forma lor.
-
Acum că ai date pregătite pentru a fi plotate, vezi dacă un calculator poate determina o împărțire logică între numerele din acest set. Pentru asta, trebuie să împarți datele (X) și ținta (y) în seturi de test și antrenament. Scikit-learn oferă un mod simplu de a face asta; poți împărți datele de test la un punct dat.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Acum ești gata să-ți antrenezi modelul! Încarcă modelul de regresie liniară și antrenează-l cu seturile tale de antrenament X și y folosind
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()este o funcție pe care o vei vedea în multe biblioteci de ML, cum ar fi TensorFlow -
Apoi, creează o predicție folosind datele de test, folosind funcția
predict(). Aceasta va fi folosită pentru a desena linia între grupurile de datey_pred = model.predict(X_test) -
Acum este timpul să afișezi datele într-un grafic. Matplotlib este un instrument foarte util pentru această sarcină. Creează un scatterplot cu toate datele de test X și y și folosește predicția pentru a trasa o linie în cel mai potrivit loc, între grupările de date ale modelului.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()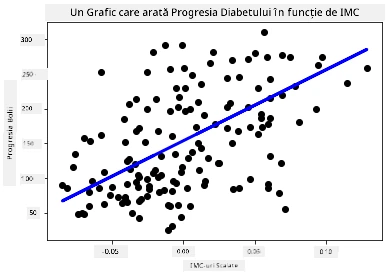
✅ Gândește-te puțin ce se întâmplă aici. O linie dreaptă trece prin multe puncte mici de date, dar ce face exact? Poți vedea cum ar trebui să poți folosi această linie pentru a prezice unde ar trebui să se încadreze un punct de date nou, nevăzut, în relație cu axa y a graficului? Încearcă să exprimi în cuvinte utilizarea practică a acestui model.
Felicitări, ți-ai construit primul model de regresie liniară, ai creat o predicție cu el și ai afișat-o într-un grafic!
🚀Provocare
Plotează o variabilă diferită din acest set de date. Sugestie: editează această linie: X = X[:,2]. Având în vedere ținta acestui set de date, ce poți descoperi despre progresia diabetului ca boală?
Chestionar post-lectură
Recapitulare & Auto-studiu
În acest tutorial, ai lucrat cu regresie liniară simplă, nu cu regresie liniară univariată sau multiplă. Citește puțin despre diferențele dintre aceste metode sau urmărește acest video
Citiți mai multe despre conceptul de regresie și gândiți-vă la ce fel de întrebări pot fi răspunse prin această tehnică. Parcurgeți acest tutorial pentru a vă aprofunda înțelegerea.
Sarcină
Declinare a responsabilității: Acest document a fost tradus folosind serviciul de traducere AI Co-op Translator. În timp ce ne străduim pentru acuratețe, vă rugăm să rețineți că traducerile automate pot conține erori sau inexactități. Documentul original în limba sa nativă trebuie considerat sursa autorizată. Pentru informații critice, se recomandă traducerea profesională realizată de un om. Nu ne asumăm responsabilitatea pentru eventualele neînțelegeri sau interpretări greșite care decurg din utilizarea acestei traduceri.