
 localizeflow[bot]
14f5ba5f5c |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Bygge maskinlæringsløsninger med ansvarlig AI

Sketchnote av Tomomi Imura
Forhåndsquiz
Introduksjon
I dette pensumet vil du begynne å oppdage hvordan maskinlæring kan og påvirker vårt daglige liv. Selv nå er systemer og modeller involvert i daglige beslutningsoppgaver, slik som helsediagnoser, lånegodkjenninger eller å oppdage svindel. Derfor er det viktig at disse modellene fungerer godt for å gi resultater som er pålitelige. Som med enhver programvareapplikasjon, vil AI-systemer kunne skuffe forventninger eller ha et uønsket resultat. Derfor er det essensielt å kunne forstå og forklare oppførselen til en AI-modell.
Tenk over hva som kan skje når dataene du bruker for å bygge disse modellene mangler visse demografiske grupper, som rase, kjønn, politisk syn, religion, eller overrepresenterer slike grupper uforholdsmessig. Hva skjer når modellens output tolkes til fordel for noen demografiske grupper? Hva er konsekvensene for applikasjonen? I tillegg, hva skjer når modellen har et negativt utfall og skader mennesker? Hvem er ansvarlig for AI-systemets oppførsel? Dette er noen av spørsmålene vi vil utforske i dette pensumet.
I denne leksjonen vil du:
- Øke bevisstheten rundt viktigheten av rettferdighet i maskinlæring og skader knyttet til rettferdighet.
- Bli kjent med praksisen med å utforske avvik og uvanlige scenarioer for å sikre pålitelighet og sikkerhet.
- Få forståelse for behovet for å styrke alle ved å designe inkluderende systemer.
- Utforske hvor viktig det er å beskytte personvern og datasikkerhet.
- Se viktigheten av å benytte en åpen tilnærming for å forklare oppførselen til AI-modeller.
- Være oppmerksom på hvordan ansvarlighet er viktig for å bygge tillit til AI-systemer.
Forutsetning
Som forutsetning, vennligst gjennomfør "Responsible AI Principles" læringssti og se videoen nedenfor om temaet:
Lær mer om ansvarlig AI ved å følge denne Læringsstien

🎥 Klikk på bildet ovenfor for en video: Microsofts tilnærming til ansvarlig AI
Rettferdighet
AI-systemer bør behandle alle rettferdig og unngå å påvirke like grupper av mennesker på forskjellige måter. For eksempel, når AI-systemer gir veiledning om medisinsk behandling, lånesøknader eller ansettelser, bør de gi samme anbefalinger til alle med lignende symptomer, økonomiske forhold eller faglige kvalifikasjoner. Hver av oss mennesker bærer med oss arvede skjevheter som påvirker våre beslutninger og handlinger. Disse skjevhetene kan være synlige i dataene vi bruker til å trene AI-systemer. Slike manipulasjoner kan noen ganger skje utilsiktet. Det er ofte vanskelig å bevisst vite når du introduserer skjevheter i data.
"Urettferdighet" omfatter negative konsekvenser, eller "skader", for en gruppe mennesker, slik som de definert ut ifra rase, kjønn, alder eller funksjonshemming. De viktigste rettferdighetsrelaterte skadene kan klassifiseres som:
- Fordeling, hvis for eksempel ett kjønn eller en etnisitet favoriseres over en annen.
- Tjenestekvalitet. Hvis du trener data for ett spesifikt scenario, men virkeligheten er mye mer kompleks, fører det til en tjeneste som presterer dårlig. For eksempel en håndsåpedispenser som ikke ser ut til å kunne oppfatte personer med mørk hud. Referanse
- Nedvurdering. Å urettferdig kritisere og merke noe eller noen. For eksempel en bildeetiketteringsteknologi som beryktet merket bilder av mørkhudede personer som gorillaer.
- Over- eller underrepresentasjon. Ideen er at en viss gruppe ikke sees i et bestemt yrke, og enhver tjeneste eller funksjon som fortsetter å fremme dette bidrar til skade.
- Stereotypisering. Assosiere en gruppe med forhåndstildelte egenskaper. For eksempel kan et språköversettelsessystem mellom engelsk og tyrkisk ha unøyaktigheter på grunn av ord med stereotypiske kjønnsforeninger.
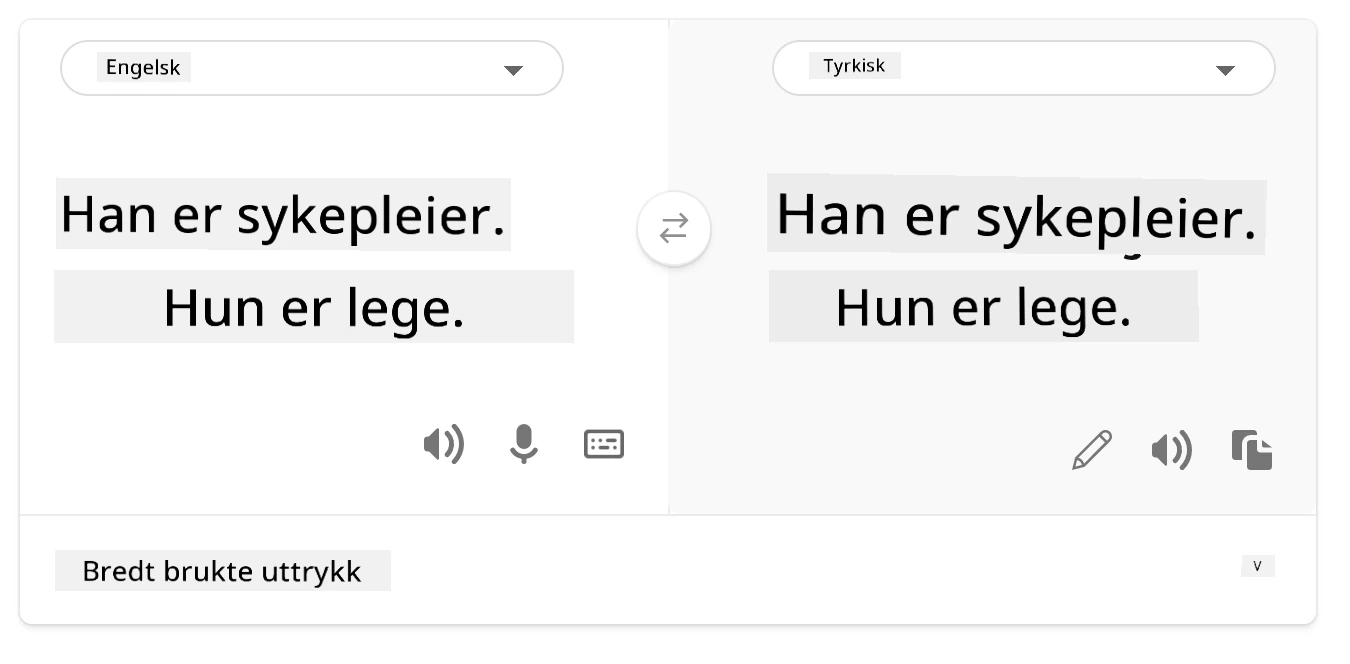
oversettelse til tyrkisk
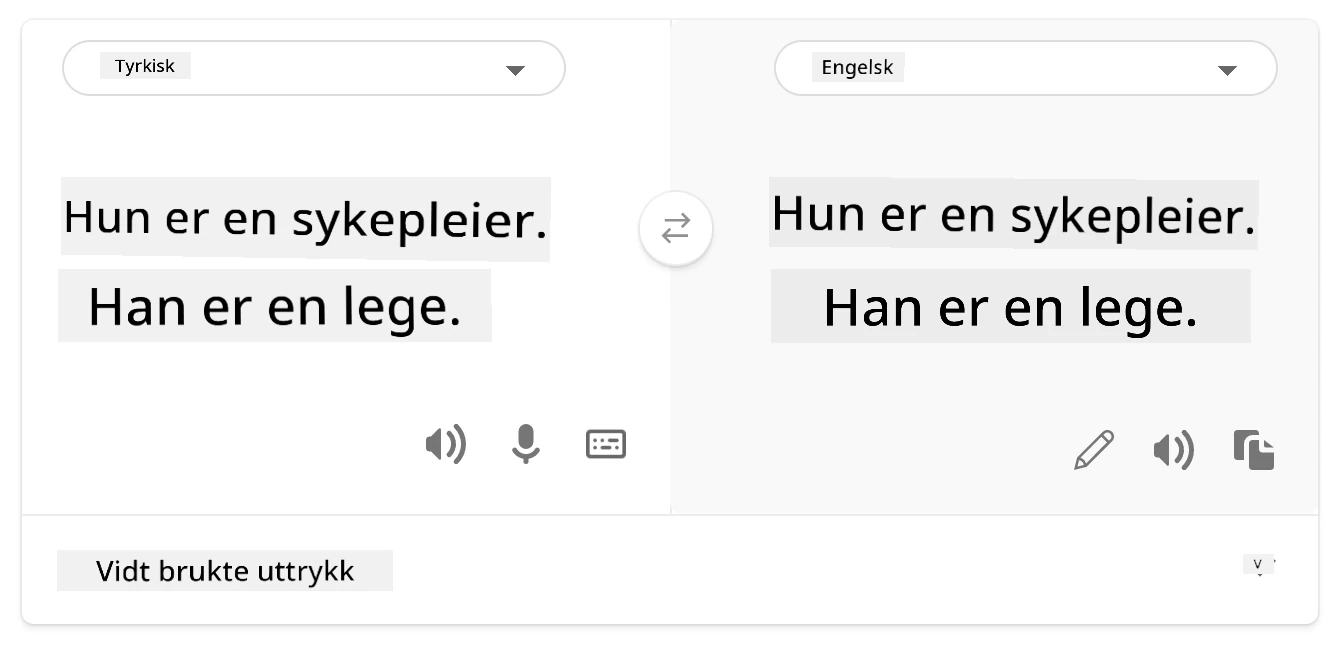
oversettelse tilbake til engelsk
Når vi designer og tester AI-systemer, må vi sikre at AI er rettferdig og ikke programmert til å ta skjeve eller diskriminerende beslutninger, noe mennesker også er forhindret fra å gjøre. Å garantere rettferdighet i AI og maskinlæring er fortsatt en kompleks sosioteknisk utfordring.
Pålitelighet og sikkerhet
For å bygge tillit må AI-systemer være pålitelige, sikre og konsistente under normale og uventede forhold. Det er viktig å vite hvordan AI-systemer oppfører seg i ulike situasjoner, spesielt når de er avvik. Når man bygger AI-løsninger, må det legges stor vekt på hvordan man håndterer et bredt spekter av omstendigheter AI-løsningene kan møte. For eksempel må en selvkjørende bil sette menneskers sikkerhet høyest. Derfor må AI som styrer bilen ta hensyn til alle mulige scenarioer bilen kan komme over, som natt, tordenvær eller snøstormer, barn som løper over gaten, kjæledyr, veiarbeid osv. Hvor godt et AI-system kan håndtere et bredt spekter av forhold pålitelig og trygt reflekterer nivået av forutseenhet dataforskeren eller AI-utvikleren tok hensyn til under design eller testing av systemet.
Inkludering
AI-systemer bør designes for å engasjere og styrke alle. Når man designer og implementerer AI-systemer, identifiserer og adresserer dataforskere og utviklere potensielle barrierer i systemet som utilsiktet kan ekskludere mennesker. For eksempel er det 1 milliard mennesker med funksjonshemming i verden. Med AI sin fremgang kan de lettere få tilgang til et bredt spekter av informasjon og muligheter i hverdagen. Ved å adressere barrierene skaper man muligheter for innovasjon og utvikling av AI-produkter med bedre brukeropplevelser som gagner alle.
Sikkerhet og personvern
AI-systemer bør være trygge og respektere menneskers personvern. Folk har mindre tillit til systemer som setter deres privatliv, informasjon eller liv i fare. Når man trener maskinlæringsmodeller, er vi avhengig av data for å oppnå best mulig resultater. Da må opprinnelsen til dataene og integriteten vurderes. For eksempel, kom dataene fra brukeren selv eller var det offentlig tilgjengelig? Videre er det avgjørende å utvikle AI-systemer som kan beskytte konfidensiell informasjon og motstå angrep. Ettersom AI blir mer utbredt, blir det stadig viktigere og mer komplekst å beskytte personvern og sikre viktig personlig og forretningsinformasjon. Spesielt krever personvern og datasikkerhet grundig oppmerksomhet i AI fordi datatilgang er avgjørende for at AI-systemer kan gjøre nøyaktige og informerte prediksjoner og beslutninger om mennesker.
- Som bransje har vi gjort betydelige fremskritt innen personvern og sikkerhet, drevet i stor grad av regelverk som GDPR (General Data Protection Regulation).
- Likevel må vi med AI-systemer erkjenne spenningen mellom behovet for mer personlig data for å gjøre systemene mer personlige og effektive – og personvern.
- Akkurat som ved internettets fødsel med tilkoblede datamaskiner, ser vi også en stor økning i antall sikkerhetsproblemer knyttet til AI.
- Samtidig har vi sett AI brukt til å forbedre sikkerhet. For eksempel drives de fleste moderne antivirusprogrammer i dag av AI-basert heuristikk.
- Vi må sikre at våre data science-prosesser harmonerer med de nyeste personvern- og sikkerhetspraksisene.
Åpenhet
AI-systemer bør være forståelige. En viktig del av åpenhet er å forklare oppførselen til AI-systemer og deres komponenter. Bedre forståelse av AI-systemer krever at interessenter forstår hvordan og hvorfor de fungerer slik at de kan identifisere potensielle ytelsesproblemer, sikkerhets- og personvernhensyn, skjevheter, ekskluderende praksiser eller utilsiktede resultater. Vi mener også at de som bruker AI-systemer bør være ærlige og åpne om når, hvorfor og hvordan de velger å bruke dem, samt begrensningene ved systemene de benytter. For eksempel, hvis en bank bruker et AI-system til å støtte sine forbrukslånsbeslutninger, er det viktig å undersøke resultatene og forstå hvilke data som påvirker systemets anbefalinger. Regjeringer begynner å regulere AI på tvers av industrier, så dataforskere og organisasjoner må forklare om et AI-system oppfyller regulatoriske krav, spesielt når det er et uønsket resultat.
- Fordi AI-systemer er så komplekse, er det vanskelig å forstå hvordan de fungerer og tolke resultatene.
- Denne mangelen på forståelse påvirker måten disse systemene forvaltes, operasjonaliseres og dokumenteres på.
- Enda viktigere påvirker denne mangelen på forståelse beslutningene som tas basert på systemenes resultater.
Ansvarlighet
De som designer og deployerer AI-systemer må holdes ansvarlige for hvordan systemene deres opererer. Behovet for ansvarlighet er særlig viktig for sensitive teknologier som ansiktsgjenkjenning. Nylig har det vært en økende etterspørsel etter ansiktsgjenkjenningsteknologi, spesielt fra rettshåndhevende myndigheter som ser potensialet i teknologien for bruk som å finne savnede barn. Disse teknologiene kan imidlertid potensielt bli brukt av en regjering til å sette borgernes grunnleggende friheter i fare, for eksempel ved å muliggjøre kontinuerlig overvåkning av spesifikke individer. Derfor må dataforskere og organisasjoner være ansvarlige for hvordan deres AI-system påvirker individer eller samfunnet.

🎥 Klikk på bildet ovenfor for en video: Advarsler om masseovervåkning gjennom ansiktsgjenkjenning
Til syvende og sist er et av de største spørsmålene for vår generasjon, som er den første som introduserer AI i samfunnet, hvordan man sikrer at datamaskiner forblir ansvarlige overfor mennesker og hvordan de som designer datamaskiner forblir ansvarlige overfor alle andre.
Påvirkningsvurdering
Før du trener en maskinlæringsmodell, er det viktig å gjennomføre en påvirkningsvurdering for å forstå hensikten med AI-systemet; hva den tiltenkte bruken er; hvor det skal implementeres; og hvem som vil samhandle med systemet. Dette er nyttig for vurderere eller testere som evaluerer systemet for å vite hvilke faktorer de bør ta hensyn til når de identifiserer potensielle risikoer og forventede konsekvenser.
Følgende er fokusområder ved gjennomføring av en påvirkningsvurdering:
- Negativ påvirkning på individer. Det er avgjørende å være klar over eventuelle restriksjoner eller krav, uautorisert bruk eller kjente begrensninger som hindrer systemets ytelse for å sikre at systemet ikke brukes på en måte som kan skade individer.
- Datakrav. Å forstå hvordan og hvor systemet skal bruke data gjør det mulig for vurderere å utforske eventuelle datakrav du må ta hensyn til (f.eks. GDPR eller HIPAA-reguleringer). I tillegg bør man undersøke om kilden og mengden data er tilstrekkelig for trening.
- Oppsummering av påvirkning. Samle en liste over potensielle skader som kan oppstå ved bruk av systemet. Gjennom hele ML-livssyklusen må det vurderes om identifiserte problemer blir redusert eller adressert.
- Gjeldene mål for hvert av de seks kjerneprinsippene. Vurdere om målene i hver av prinsippene er oppfylt og om det finnes noen hull.
Feilsøking med ansvarlig AI
På samme måte som feilsøking av en programvareapplikasjon, er feilsøking av et AI-system en nødvendig prosess for å identifisere og løse problemer i systemet. Mange faktorer kan påvirke at en modell ikke presterer som forventet eller ansvarlig. De fleste tradisjonelle modellprestasjonsscore er kvantitative aggregater av modellens ytelse, som ikke er tilstrekkelige for å analysere hvordan en modell bryter med prinsippene for ansvarlig AI. Videre er en maskinlæringsmodell en svart boks som gjør det vanskelig å forstå hva som driver resultatet eller gi forklaring når den gjør en feil. Senere i dette kurset vil vi lære hvordan man bruker dashbordet for ansvarlig AI til å hjelpe med å feilsøke AI-systemer. Dashbordet gir et helhetlig verktøy for dataforskere og AI-utviklere til å utføre:
- Feilanalyse. For å identifisere feiltall i modellen som kan påvirke systemets rettferdighet eller pålitelighet.
- Modelloversikt. For å oppdage hvor det er ulikheter i modellens ytelse på tvers av datagrupper.
- Dataanalyse. For å forstå datadistribusjonen og identifisere eventuelle skjevheter i dataene som kan føre til problemer med rettferdighet, inkludering og pålitelighet.
- Modelltolkbarhet. For å forstå hva som påvirker eller styrer modellens prediksjoner. Dette hjelper med å forklare modellens oppførsel, som er viktig for åpenhet og ansvarlighet.
🚀 Utfordring
For å forhindre at skader oppstår i utgangspunktet, bør vi:
- ha mangfold i bakgrunn og perspektiver blant de som jobber med systemene
- investere i datasett som reflekterer mangfoldet i samfunnet vårt
- utvikle bedre metoder gjennom hele maskinlæringslivssyklusen for å oppdage og rette opp uansvarlig AI når det oppstår
Tenk på virkelige scenarioer hvor en modells upålitelighet er tydelig i modellbygging og bruk. Hva mer bør vi vurdere?
Etter-forelesningsquiz
Gjennomgang & Selvstudium
I denne leksjonen har du lært noen grunnleggende konsepter om rettferdighet og urettferdighet i maskinlæring.
Se denne workshopen for å fordype deg i temaene:
- På jakt etter ansvarlig AI: Bringe prinsipper til praksis av Besmira Nushi, Mehrnoosh Sameki og Amit Sharma

🎥 Klikk på bildet over for en video: RAI Toolbox: Et åpen kildekode rammeverk for å bygge ansvarlig AI av Besmira Nushi, Mehrnoosh Sameki, og Amit Sharma
Les også:
-
Microsofts RAI ressurs senter: Responsible AI Resources – Microsoft AI
-
Microsofts FATE forskningsgruppe: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Les om Azure Machine Learnings verktøy for å sikre rettferdighet:
Oppgave
Ansvarsfraskrivelse: Dette dokumentet er oversatt ved hjelp av AI-oversettelsestjenesten Co-op Translator. Selv om vi streber etter nøyaktighet, vær oppmerksom på at automatiske oversettelser kan inneholde feil eller unøyaktigheter. Det opprinnelige dokumentet på originalspråket skal betraktes som den autoritative kilden. For kritisk informasjon anbefales profesjonell menneskelig oversettelse. Vi er ikke ansvarlige for eventuelle misforståelser eller feiltolkninger som oppstår ved bruk av denne oversettelsen.