
 localizeflow[bot]
fb6bda5cad |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Machine Learning-oplossingen bouwen met verantwoorde AI

Sketchnote door Tomomi Imura
Pre-college quiz
Introductie
In dit curriculum ga je ontdekken hoe machine learning onze dagelijkse levens kan beïnvloeden en al beïnvloedt. Zelfs nu zijn systemen en modellen betrokken bij dagelijkse beslissingen, zoals diagnoses in de gezondheidszorg, lening goedkeuringen of het opsporen van fraude. Daarom is het belangrijk dat deze modellen goed functioneren om uitkomsten te leveren die betrouwbaar zijn. Net als elke softwaretoepassing zullen AI-systemen soms niet aan verwachtingen voldoen of een ongewenste uitkomst hebben. Daarom is het essentieel om het gedrag van een AI-model te kunnen begrijpen en uitleggen.
Stel je voor wat er kan gebeuren als de data die je gebruikt om deze modellen te bouwen bepaalde demografische groepen mist, zoals ras, geslacht, politieke opvatting, religie, of die groepen onevenredig vertegenwoordigt. Wat als de output van het model wordt geïnterpreteerd als bevooroordeeld ten gunste van een bepaalde demografie? Wat is de consequentie voor de toepassing? Daarnaast, wat gebeurt er wanneer het model een nadelige uitkomst heeft en schadelijk is voor mensen? Wie is verantwoordelijk voor het gedrag van AI-systemen? Dit zijn enkele vragen die we in dit curriculum zullen onderzoeken.
In deze les zul je:
- Je bewust maken van het belang van eerlijkheid in machine learning en aan eerlijkheid gerelateerde schade.
- Vertrouwd raken met de praktijk van het verkennen van uitschieters en ongewone scenario's om betrouwbaarheid en veiligheid te waarborgen.
- Inzicht krijgen in de noodzaak om iedereen te versterken door inclusieve systemen te ontwerpen.
- Verkennen hoe belangrijk het is om privacy en veiligheid van data en mensen te beschermen.
- Het belang inzien van een transparante aanpak om het gedrag van AI-modellen uit te leggen.
- Rekening houden met hoe verantwoordelijkheid essentieel is voor het opbouwen van vertrouwen in AI-systemen.
Vereisten
Als vereiste volg je het leertraject "Principes van verantwoorde AI" en bekijk je de onderstaande video over dit onderwerp:
Leer meer over Verantwoorde AI door dit Leertraject te volgen

🎥 Klik op de afbeelding hierboven voor een video: Microsoft's Benadering van Verantwoorde AI
Eerlijkheid
AI-systemen moeten iedereen eerlijk behandelen en voorkomen dat vergelijkbare groepen mensen op verschillende manieren worden getroffen. Bijvoorbeeld, wanneer AI-systemen advies geven over medische behandeling, leningaanvragen of werkgelegenheid, zouden ze aan iedereen met vergelijkbare symptomen, financiële omstandigheden of professionele kwalificaties dezelfde aanbevelingen moeten doen. Wij mensen dragen allemaal aangeboren vooroordelen mee die onze beslissingen en acties beïnvloeden. Deze vooroordelen kunnen zichtbaar zijn in de data die we gebruiken om AI-systemen te trainen. Soms gebeurt zo’n manipulatie onbedoeld. Het is vaak moeilijk bewust te weten wanneer je vooringenomenheid in data introduceert.
“Oneerlijkheid” omvat negatieve gevolgen, of “schade”, voor een groep mensen, zoals die gedefinieerd worden op basis van ras, geslacht, leeftijd of handicapstatus. De belangrijkste aan eerlijkheid gerelateerde schade kan worden ingedeeld als:
- Toewijzing, als bijvoorbeeld een geslacht of etniciteit wordt bevoordeeld boven een ander.
- Kwaliteit van de dienstverlening. Als je de data traint voor één specifiek scenario, terwijl de werkelijkheid veel complexer is, leidt dat tot een slecht presterende dienst. Bijvoorbeeld, een handzeepdispenser die mensen met een donkere huid blijkbaar niet kon detecteren. Referentie
- Vernedering. Onterecht bekritiseren en labelen van iets of iemand. Bijvoorbeeld, een beeldlabeltechnologie die berucht was omdat hij afbeeldingen van donkergekleurde mensen verkeerd labelde als gorilla's.
- Over- of ondervertegenwoordiging. Het idee dat een bepaalde groep niet zichtbaar is in een bepaald beroep, en dat elke dienst of functie die dat blijft promoten bijdraagt aan schade.
- Stereotypering. Het associëren van een bepaalde groep met vooraf toegewezen kenmerken. Bijvoorbeeld, een taalvertalingssysteem tussen Engels en Turks kan onnauwkeurigheden hebben door woorden met stereotiepe associaties met geslacht.
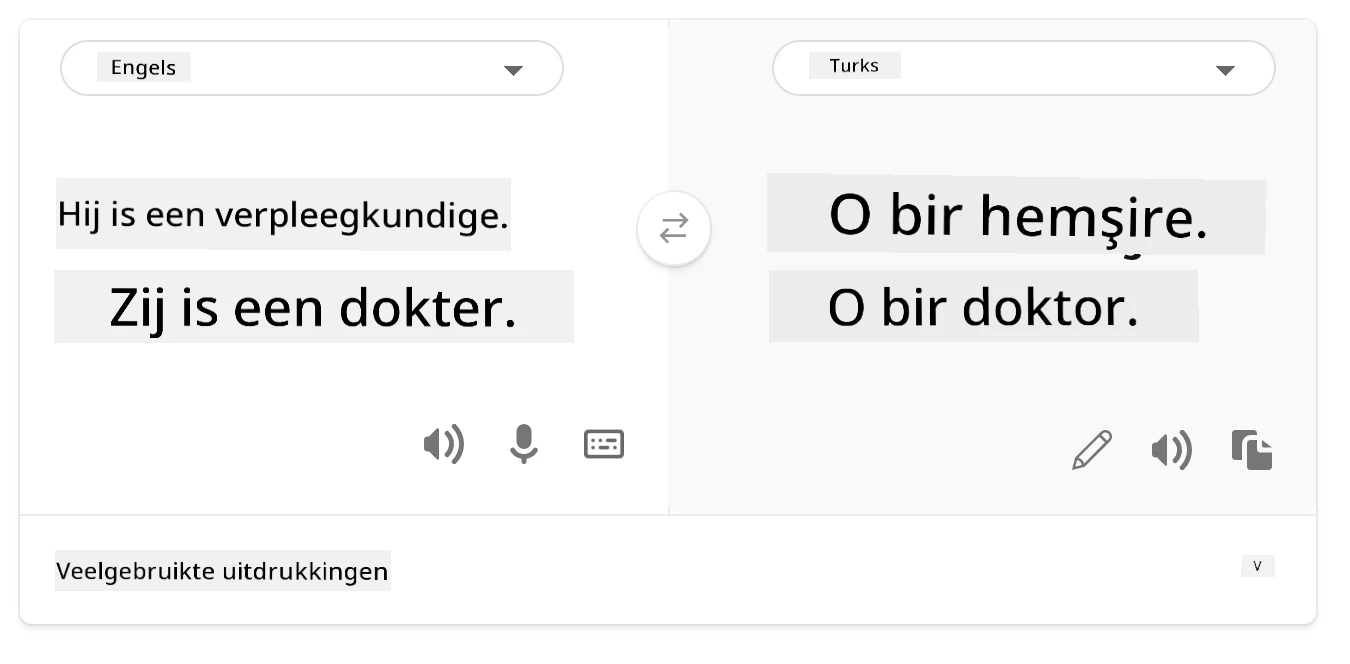
vertaling naar Turks
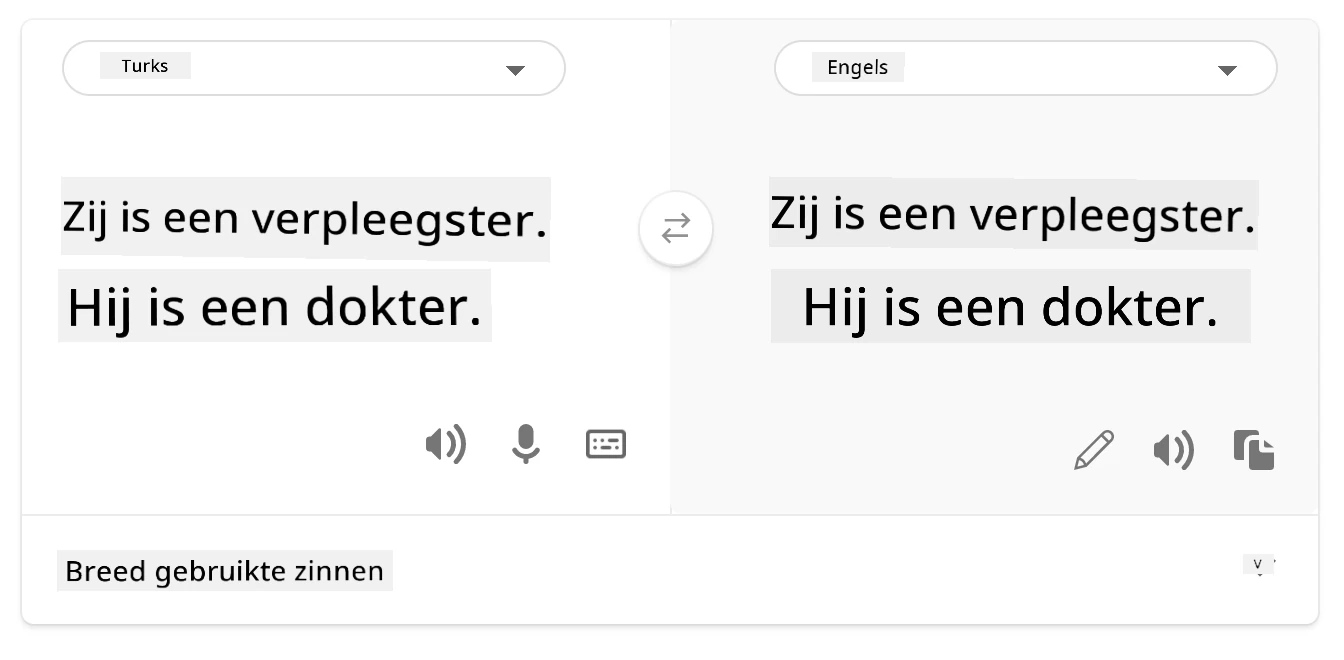
terugvertaling naar Engels
Bij het ontwerpen en testen van AI-systemen moeten we ervoor zorgen dat AI eerlijk is en niet geprogrammeerd om bevooroordeelde of discriminerende beslissingen te nemen, wat mensen ook verboden is. Het waarborgen van eerlijkheid in AI en machine learning blijft een complexe sociotechnische uitdaging.
Betrouwbaarheid en veiligheid
Om vertrouwen op te bouwen, moeten AI-systemen betrouwbaar, veilig en consistent zijn onder normale en onverwachte omstandigheden. Het is belangrijk om te weten hoe AI-systemen zich gedragen in diverse situaties, vooral als het om uitschieters gaat. Bij het bouwen van AI-oplossingen moet er veel aandacht zijn voor het omgaan met de verschillende omstandigheden die de AI-oplossingen zullen tegenkomen. Bijvoorbeeld, een zelfrijdende auto moet de veiligheid van mensen als hoogste prioriteit stellen. Daarom moet de AI die de auto aandrijft alle mogelijke scenario’s overwegen zoals nacht, onweersbuien of sneeuwstormen, kinderen die de straat oversteken, huisdieren, wegwerkzaamheden, enzovoort. Hoe goed een AI-systeem betrouwbaar en veilig een breed scala aan omstandigheden kan hanteren, weerspiegelt het niveau van anticipatie dat de datawetenschapper of AI-ontwikkelaar in het ontwerp of testen van het systeem heeft meegenomen.
🎥 Klik hier voor een video: Betrouwbaarheid en veiligheid in AI
Inclusiviteit
AI-systemen moeten worden ontworpen om iedereen te betrekken en te versterken. Bij het ontwerpen en implementeren van AI-systemen identificeren datawetenschappers en AI-ontwikkelaars potentiële barrières in het systeem die er onbedoeld toe kunnen leiden dat mensen worden uitgesloten. Bijvoorbeeld, er zijn 1 miljard mensen met een handicap wereldwijd. Met de vooruitgang van AI kunnen zij makkelijker toegang krijgen tot een breed scala aan informatie en kansen in hun dagelijks leven. Door barrières aan te pakken ontstaan kansen om te innoveren en AI-producten te ontwikkelen met betere ervaringen die iedereen ten goede komen.
Beveiliging en privacy
AI-systemen moeten veilig zijn en de privacy van mensen respecteren. Mensen hebben minder vertrouwen in systemen die hun privacy, informatie of leven in gevaar brengen. Bij het trainen van machine learning-modellen vertrouwen we op data om de beste resultaten te produceren. Daarbij moeten de oorsprong van de data en de integriteit in overweging worden genomen. Bijvoorbeeld, was de data door gebruikers ingediend of publiekelijk beschikbaar? Vervolgens is het cruciaal om AI-systemen te ontwikkelen die vertrouwelijke informatie kunnen beschermen en bestand zijn tegen aanvallen. Naarmate AI steeds vaker wordt gebruikt, wordt het beschermen van privacy en het beveiligen van belangrijke persoonlijke en zakelijke informatie steeds kritischer en complexer. Privacy- en databeveiligingskwesties vereisen bijzondere aandacht in AI, omdat toegang tot data essentieel is voor AI-systemen om nauwkeurige en geïnformeerde voorspellingen en beslissingen over mensen te maken.
- Als sector hebben we aanzienlijke vooruitgang geboekt op het gebied van privacy & beveiliging, mede dankzij regelgeving zoals de GDPR (Algemene Verordening Gegevensbescherming).
- Toch moeten we bij AI-systemen de spanning erkennen tussen de behoefte aan meer persoonlijke gegevens om systemen persoonlijker en effectiever te maken – en privacy.
- Net zoals bij de opkomst van verbonden computers met internet, zien we ook een sterke toename van beveiligingsproblemen gerelateerd aan AI.
- Tegelijkertijd wordt AI ook ingezet om beveiliging te verbeteren. Bijvoorbeeld, de meeste moderne antivirusprogramma’s worden tegenwoordig aangestuurd door AI-heuristieken.
- We moeten ervoor zorgen dat onze Data Science-processen harmonieus samengaan met de nieuwste privacy- en beveiligingspraktijken.
Transparantie
AI-systemen moeten begrijpelijk zijn. Een cruciaal onderdeel van transparantie is het uitleggen van het gedrag van AI-systemen en hun componenten. Om het begrip van AI-systemen te verbeteren, moeten belanghebbenden begrijpen hoe en waarom ze functioneren, zodat zij mogelijke prestatieproblemen, veiligheids- en privacyzorgen, vooroordelen, uitsluitingspraktijken of onbedoelde uitkomsten kunnen identificeren. We vinden ook dat degenen die AI-systemen gebruiken eerlijk en open moeten zijn over wanneer, waarom, en hoe zij ervoor kiezen deze in te zetten. Evenals over de beperkingen van de systemen die zij gebruiken. Bijvoorbeeld, als een bank een AI-systeem gebruikt ter ondersteuning van haar consumentenkredietbeslissingen, is het belangrijk de uitkomsten te onderzoeken en te begrijpen welke data de aanbevelingen van het systeem beïnvloeden. Overheden beginnen AI te reguleren in diverse sectoren, dus datawetenschappers en organisaties moeten kunnen uitleggen of een AI-systeem aan de regelgeving voldoet, vooral wanneer er een ongewenste uitkomst is.
- Omdat AI-systemen zo complex zijn, is het moeilijk te begrijpen hoe ze werken en de resultaten te interpreteren.
- Dit gebrek aan begrip beïnvloedt hoe deze systemen worden beheerd, operationeel gemaakt en gedocumenteerd.
- Dit gebrek aan begrip beïnvloedt belangrijker nog de beslissingen die worden genomen op basis van de resultaten die deze systemen produceren.
Verantwoordingsplicht
De mensen die AI-systemen ontwerpen en inzetten moeten verantwoordelijk zijn voor hoe hun systemen functioneren. De noodzaak van verantwoordelijkheid is bijzonder cruciaal bij gevoelige technologieën zoals gezichtsherkenning. Onlangs is de vraag naar gezichtsherkenningstechnologie toegenomen, vooral van wetshandhavingsinstanties die de potentie van de technologie zien bij toepassingen zoals het vinden van vermiste kinderen. Echter, deze technologieën zouden ook door een overheid kunnen worden gebruikt om de fundamentele vrijheden van burgers in gevaar te brengen, bijvoorbeeld door continue bewaking van specifieke individuen mogelijk te maken. Daarom moeten datawetenschappers en organisaties verantwoordelijk zijn voor hoe hun AI-systeem individuen of de samenleving beïnvloedt.

🎥 Klik op de afbeelding hierboven voor een video: Waarschuwingen over massale surveillance via gezichtsherkenning
Uiteindelijk is een van de belangrijkste vragen voor onze generatie, als de eerste generatie die AI naar de maatschappij brengt, hoe ervoor te zorgen dat computers verantwoordelijk blijven aan mensen en hoe te verzekeren dat de mensen die computers ontwerpen verantwoordelijk blijven aan iedereen.
Effectbeoordeling
Voordat je een machine learning-model traint, is het belangrijk een effectbeoordeling uit te voeren om het doel van het AI-systeem te begrijpen; wat het beoogde gebruik is; waar het zal worden ingezet; en wie met het systeem zal interacteren. Dit is nuttig voor beoordelaar(s) of testers om te weten welke factoren ze moeten overwegen bij het identificeren van potentiële risico’s en verwachtte gevolgen.
De volgende aandachtsgebieden gelden bij het uitvoeren van een effectbeoordeling:
- Nadelig effect op individuen. Bewust zijn van beperkingen of vereisten, ongeoorloofd gebruik of bekende beperkingen die de prestaties van het systeem belemmeren, is cruciaal om te voorkomen dat het systeem op een schadelijke manier wordt gebruikt.
- Datavereisten. Inzicht krijgen in hoe en waar het systeem data gebruikt stelt beoordelaars in staat eventuele data-eisen te onderzoeken (bijv. GDPR- of HIPAA-gegevensregels). Evalueer ook of de bron of hoeveelheid data voldoende is voor training.
- Samenvatting van effecten. Verzamel een lijst van potentiële schadelijke gevolgen die mochten ontstaan door het gebruik van het systeem. Tijdens de ML-levenscyclus moet je controleren of de geïdentificeerde problemen worden verminderd of aangepakt.
- Toepasselijke doelen voor elk van de zes kernprincipes. Beoordeel of de doelen van elk principe zijn behaald en of er hiaten zijn.
Debuggen met verantwoorde AI
Net als bij het debuggen van een softwaretoepassing is het debuggen van een AI-systeem een noodzakelijke procedure om problemen in het systeem te identificeren en op te lossen. Er zijn veel factoren die ervoor kunnen zorgen dat een model niet presteert zoals verwacht of verantwoord. De meeste traditionele modelprestatie-metrieken zijn kwantitatieve samenvattingen van de prestatie van een model, maar die zijn niet voldoende om te analyseren hoe een model de principes van verantwoorde AI schendt. Bovendien is een machine learning-model een black box, wat het moeilijk maakt te begrijpen wat de uitkomst drijft of uitleg te geven wanneer het een fout maakt. Later in deze cursus leren we hoe het Responsible AI-dashboard helpt bij het debuggen van AI-systemen. Het dashboard biedt een holistisch hulpmiddel voor datawetenschappers en AI-ontwikkelaars om:
- Foutanalyse. Om de verdeling van fouten van het model te identificeren die de eerlijkheid of betrouwbaarheid van het systeem kunnen beïnvloeden.
- Modeloverzicht. Om te ontdekken waar er verschillen zijn in de prestaties van het model over datacohorten.
- Data-analyse. Om de datadistributie te begrijpen en eventuele vooringenomenheid in de data te identificeren die kan leiden tot problemen met eerlijkheid, inclusiviteit en betrouwbaarheid.
- Modelverklaarbaarheid. Om te begrijpen wat de voorspellingen van het model beïnvloedt of bepaalt. Dit helpt bij het uitleggen van het gedrag van het model, wat belangrijk is voor transparantie en verantwoordelijkheid.
🚀 Uitdaging
Om schade te voorkomen voordat deze ontstaat, zouden we:
- diversiteit in achtergronden en perspectieven moeten hebben onder de mensen die aan systemen werken
- moeten investeren in datasets die de diversiteit van onze samenleving weerspiegelen
- betere methoden moeten ontwikkelen gedurende de gehele machine learning levenscyclus om onverantwoorde AI te detecteren en corrigeren als die optreedt
Denk aan realistische scenario’s waarin onbetrouwbaarheid van een model duidelijk is bij het bouwen en gebruiken van modellen. Wat zouden we nog meer moeten overwegen?
Post-college quiz
Overzicht & Zelfstudie
In deze les heb je de basisbegrippen van eerlijkheid en oneerlijkheid in machine learning geleerd.
Bekijk deze workshop om dieper op de onderwerpen in te gaan:
- In het nastreven van verantwoorde AI: Principes in de praktijk brengen door Besmira Nushi, Mehrnoosh Sameki en Amit Sharma

🎥 Klik op de afbeelding hierboven voor een video: RAI Toolbox: Een open-source kader voor het bouwen van verantwoordelijke AI door Besmira Nushi, Mehrnoosh Sameki en Amit Sharma
Lees ook:
-
Microsoft's RAI-hulpmiddelencentrum: Responsible AI Resources – Microsoft AI
-
Microsoft's FATE-onderzoeksgroep: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Lees over de tools van Azure Machine Learning om eerlijkheid te waarborgen:
Opdracht
Disclaimer: Dit document is vertaald met behulp van de AI vertaaldienst Co-op Translator. Hoewel we streven naar nauwkeurigheid, dient u er rekening mee te houden dat geautomatiseerde vertalingen fouten of onnauwkeurigheden kunnen bevatten. Het originele document in de oorspronkelijke taal moet worden beschouwd als de gezaghebbende bron. Voor kritieke informatie wordt professionele menselijke vertaling aanbevolen. Wij zijn niet aansprakelijk voor eventuele misverstanden of verkeerde interpretaties die voortvloeien uit het gebruik van deze vertaling.