
 localizeflow[bot]
4e2f9e9b38 |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
책임감 있는 AI로 머신러닝 솔루션 구축하기

스케치노트 작성자: Tomomi Imura
강의 전 퀴즈
소개
이 커리큘럼에서는 머신러닝이 우리의 일상생활에 어떤 영향을 미치고 있는지 살펴볼 것입니다. 현재도 시스템과 모델은 건강 진단, 대출 승인, 사기 탐지 같은 일상적인 의사 결정 작업에 관여하고 있습니다. 따라서 이러한 모델들이 신뢰할 수 있는 결과를 제공하도록 잘 작동하는 것이 중요합니다. 모든 소프트웨어 애플리케이션과 마찬가지로 AI 시스템도 기대를 충족하지 못하거나 바람직하지 않은 결과를 낼 수 있습니다. 그래서 AI 모델의 동작을 이해하고 설명할 수 있는 것이 필수적입니다.
모델을 구축하는 데 사용하는 데이터에 인종, 성별, 정치적 견해, 종교 등 특정 인구통계가 결여되어 있거나 불균형하게 대표되고 있다면 어떤 일이 벌어질지 상상해 보세요. 모델의 출력이 일부 인구통계에 편향되게 해석된다면 그 결과는 어떻게 될까요? 또한 모델이 부정적인 결과를 내고 사람들에게 해를 끼친다면 누가 AI 시스템의 책임을 지는 걸까요? 이러한 질문들을 이번 커리큘럼에서 탐구할 것입니다.
이 수업에서 여러분은:
- 머신러닝에서 공정성의 중요성 및 공정성과 관련된 피해에 대한 인식을 높입니다.
- 이상치 및 비정상 시나리오를 탐색하여 신뢰성과 안전성을 확보하는 실습에 익숙해집니다.
- 모두를 포용하는 시스템을 설계해야 하는 필요성을 이해합니다.
- 데이터 및 개인의 프라이버시와 보안을 보호하는 것이 얼마나 중요한지 탐구합니다.
- AI 모델의 행위를 설명하기 위해 유리 상자 접근법의 중요성을 확인합니다.
- AI 시스템에 대한 신뢰를 구축하는 데 책임성이 얼마나 중요한지 인식합니다.
선수 조건
선수 조건으로 "책임감 있는 AI 원칙" 학습 경로를 수강하고 아래 영상을 시청해 주세요:
학습 경로를 통해 책임감 있는 AI에 대해 더 알아보세요.

🎥 위 이미지를 클릭하면 영상: Microsoft의 책임감 있는 AI 접근법
공정성
AI 시스템은 모두를 공정하게 대우하고 비슷한 그룹에 대해 다르게 영향을 주지 않아야 합니다. 예를 들어, AI 시스템이 의료 치료, 대출 신청, 고용에 관한 지침을 제공할 때 유사한 증상, 경제 사정, 직업 자격을 가진 사람에게 동일한 권고를 해야 합니다. 우리 각자는 의식하지 못한 편견을 내재하고 있으며 이는 우리의 결정과 행동에 영향을 미칩니다. 이러한 편견은 AI 시스템을 학습시키는 데이터에서 명백하게 나타날 수 있습니다. 의도치 않게 이러한 조작이 발생할 수도 있습니다. 데이터에 편향을 도입할 때를 의식적으로 알기 어려운 경우가 많습니다.
“불공정성”은 특정 인종, 성별, 나이, 장애 상태 등으로 정의되는 집단에 부정적인 영향 또는 "피해"를 포함합니다. 주요 공정성 관련 피해는 다음과 같이 분류할 수 있습니다:
- 배분: 예를 들어, 특정 성별이나 민족이 다른 집단보다 우대받는 경우.
- 서비스 품질: 한 가지 특정 시나리오에 대해 데이터만 학습했는데 현실은 훨씬 복잡해 성능이 떨어지는 서비스. 예를 들어, 어두운 피부색을 감지하지 못하는 손 세정기. 참고
- 폄하: 어떤 것 또는 누군가를 부당하게 비난하거나 낙인 찍는 것. 예를 들어, 이미지 라벨링 기술이 어두운 피부색 사람을 고릴라로 잘못 분류한 경우로 악명이 높습니다.
- 과소 또는 과대 대표: 특정 직업에서 어떤 그룹이 거의 보이지 않고, 그 현상을 지속하는 서비스나 기능이 피해에 기여하는 경우.
- 고정관념: 특정 집단에 사전에 할당된 특성을 연관 짓는 것. 예를 들어, 영어와 터키어 간 번역 시스템에서 성별에 대한 고정관념적 연관어로 인해 부정확한 번역이 발생할 수 있습니다.
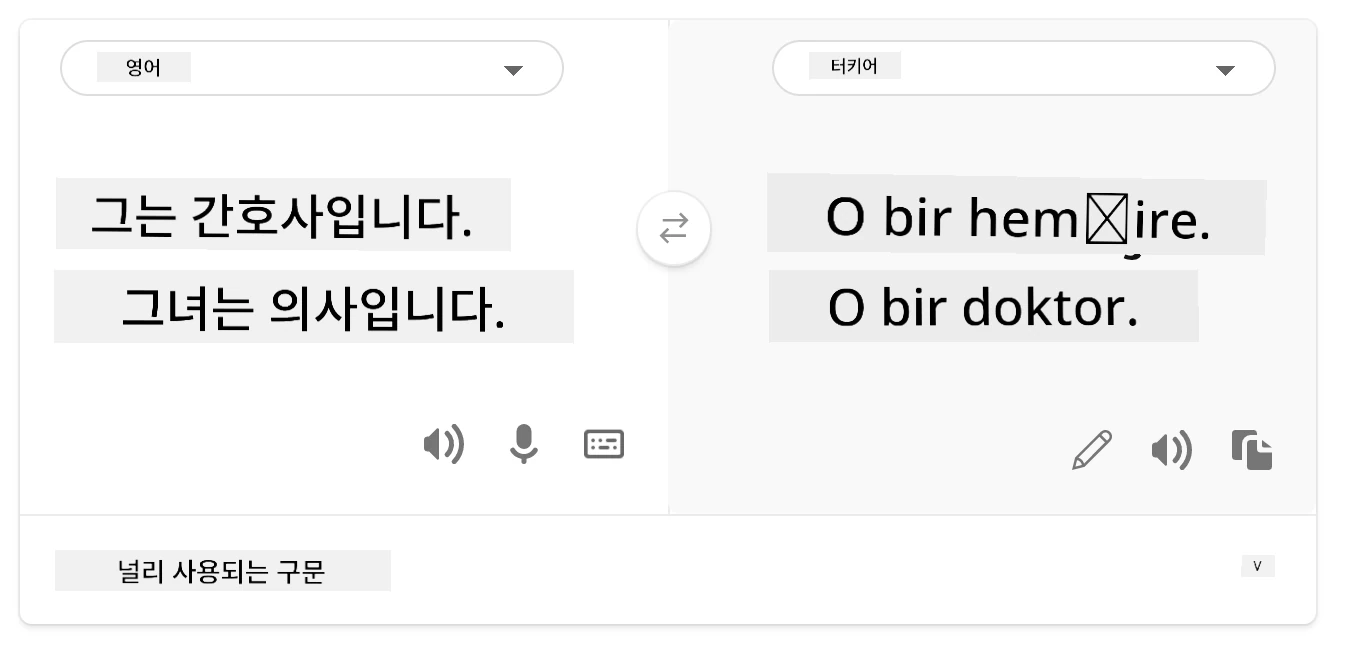
터키어로 번역된 내용
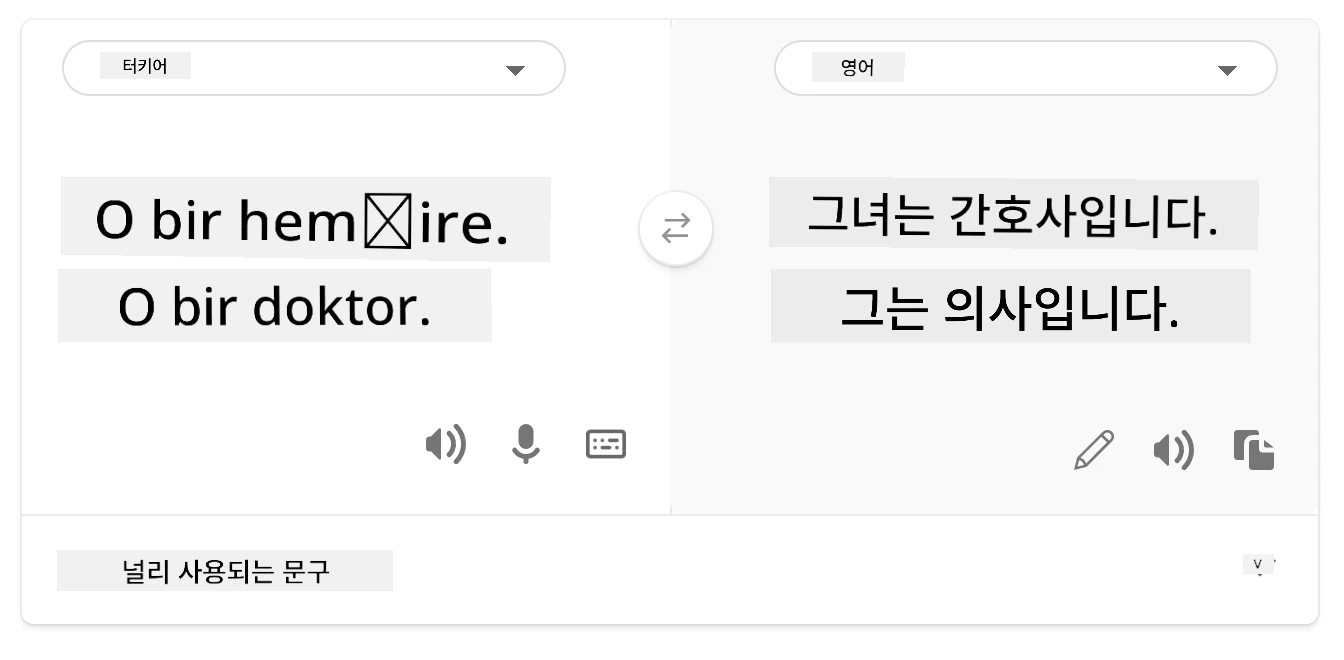
영어로 다시 번역된 내용
AI 시스템을 설계하고 테스트할 때, AI가 공정하도록 하고 편향되거나 차별적인 결정을 내리지 않도록 보장해야 합니다. 인간도 그런 결정을 내려서는 안 됩니다. AI와 머신러닝에서 공정성을 보장하는 것은 여전히 복잡한 사회기술적 도전 과제입니다.
신뢰성과 안전성
신뢰를 구축하려면 AI 시스템은 정상 및 비정상 상황에서도 신뢰할 수 있고 안전하며 일관되어야 합니다. 특히 이상치 상황에서 AI 시스템이 어떻게 작동할지 아는 것이 중요합니다. AI 솔루션을 구축할 때 AI가 만날 다양한 상황을 처리하는 방법에 상당한 집중이 필요합니다. 예를 들어, 자율주행차는 사람들의 안전을 최우선으로 두어야 합니다. 따라서 그 자동차를 구동하는 AI는 밤, 폭풍우, 눈보라, 아이들이 길을 뛰어다니는 상황, 애완동물, 도로 공사 등 가능한 모든 시나리오를 고려해야 합니다. AI 시스템이 얼마나 넓은 범위의 상황을 안정적이고 안전하게 다룰 수 있느냐는 데이터 과학자나 AI 개발자가 설계 및 테스트 과정에서 얼마나 예측하고 대비했는지 반영합니다.
포용성
AI 시스템은 모두가 참여하고 사용할 수 있도록 설계되어야 합니다. AI 시스템을 설계하고 구현할 때 데이터 과학자와 AI 개발자는 무의식적으로 사람들을 배제할 수 있는 잠재적 장벽을 찾아내 해결합니다. 전 세계에 10억 명의 장애인이 있습니다. AI의 발전으로 그들은 일상생활에서 다양한 정보와 기회에 더욱 쉽게 접근할 수 있습니다. 장벽을 해결함으로써 모두에게 혜택을 주는 더 나은 경험의 AI 제품을 혁신하고 개발할 기회가 생깁니다.
보안 및 프라이버시
AI 시스템은 안전하고 사람들의 프라이버시를 존중해야 합니다. 프라이버시, 정보, 생명을 위험에 빠뜨리는 시스템에 대한 신뢰는 줄어듭니다. 머신러닝 모델을 학습할 때 최상의 결과를 위해 데이터를 의존합니다. 이때 데이터의 출처와 무결성을 고려해야 합니다. 예를 들어, 데이터가 사용자 제출인지 공개된 것인지 확인해야 합니다. 또한 데이터를 다루는 과정에서 기밀 정보를 보호하고 공격에 저항할 수 있는 AI 시스템을 개발하는 것이 매우 중요합니다. AI가 보편화됨에 따라 프라이버시 보호와 중요한 개인 및 업무 정보의 보안이 점점 더 중요하고 복잡해지고 있습니다. AI 시스템이 사람에 대한 정확하고 정보에 근거한 예측 및 결정을 내리는 데 데이터 접근이 필수적이어서, 프라이버시와 데이터 보안 문제에 각별한 주의가 필요합니다.
- 업계에서는 GDPR(일반 데이터 보호 규정)과 같은 규제로 인해 프라이버시 및 보안에 상당한 진전을 이루었습니다.
- 하지만 AI 시스템에서는 개인화되고 효과적인 시스템을 위해 더 많은 개인 데이터가 필요함과 프라이버시 사이의 긴장을 인식해야 합니다.
- 인터넷과 연결된 컴퓨터가 탄생할 때처럼 AI와 관련된 보안 문제도 큰 폭으로 증가하고 있습니다.
- 동시에 AI는 보안 향상에 활용되고 있습니다. 예를 들어, 대부분 최신 안티바이러스 스캐너는 AI 휴리스틱으로 구동됩니다.
- 우리 데이터 과학 프로세스가 최신 프라이버시 및 보안 관행과 조화롭게 융합되어야 합니다.
투명성
AI 시스템은 이해 가능해야 합니다. 투명성의 핵심은 AI 시스템과 그 구성요소의 동작을 설명하는 것입니다. AI 시스템의 이해를 높이려면 이해관계자가 시스템이 어떻게 작동하며 왜 그렇게 되는지 파악하여 성능 문제, 안전 및 프라이버시 우려, 편향, 배제적 관행, 의도치 않은 결과를 식별할 수 있어야 합니다. 또한 AI를 사용하는 이들은 언제, 왜, 어떻게 배포하는지, 그리고 시스템의 한계에 대해 정직하고 솔직해야 한다고 믿습니다. 예를 들어, 은행이 소비자 대출 결정을 지원하기 위해 AI 시스템을 사용한다면 결과를 검토하고 어떤 데이터가 시스템 권고에 영향을 미치는지 이해하는 것이 중요합니다. 정부들이 산업 전반에 걸쳐 AI를 규제하기 시작하고 있어 데이터 과학자와 조직은 AI 시스템이 규제 요건을 충족하는지 특히 바람직하지 않은 결과가 있을 때 설명할 수 있어야 합니다.
- AI 시스템이 매우 복잡해서 어떻게 작동하는지 이해하고 결과를 해석하기 어렵습니다.
- 이러한 이해 부족은 시스템 관리, 운영 및 문서화 방식에 영향을 미칩니다.
- 더 중요한 것은 이런 이해 부족이 시스템 결과를 근거로 하는 의사결정에 영향을 미칩니다.
책임성
AI 시스템을 설계하고 배포하는 사람들은 시스템의 작동 방식에 대해 책임을 져야 합니다. 얼굴 인식과 같은 민감한 기술에는 책임성이 특히 중요합니다. 최근 법 집행 기관에서는 행방불명 아동 찾기 같은 용도에 얼굴 인식 기술에 대한 수요가 증가하고 있습니다. 하지만 정부가 특정 개인을 지속적으로 감시하는 등 시민의 기본 자유를 위협하는 데 이 기술을 사용할 가능성도 있습니다. 그렇기 때문에 데이터 과학자들과 조직은 AI 시스템이 개인이나 사회에 미치는 영향에 책임을 져야 합니다.

🎥 위 이미지를 클릭하면 영상: 얼굴 인식을 통한 대규모 감시에 대한 경고
궁극적으로 우리 세대, 즉 사회에 AI를 처음으로 도입하는 세대가 직면한 가장 큰 질문 중 하나는 컴퓨터가 사람에게 책임을 지게 하고, 컴퓨터를 설계하는 사람들이 모두에게 책임을 지게 하는 방법입니다.
영향 평가
머신러닝 모델을 학습시키기 전에, AI 시스템의 목적, 의도된 사용, 배포 위치, 시스템과 상호작용할 사람을 이해하기 위해 영향 평가를 수행하는 것이 중요합니다. 이는 시스템 평가자나 테스터가 잠재적 위험과 예상 결과를 식별할 때 고려해야 할 요소를 알 수 있도록 도움이 됩니다.
영향 평가 시 집중해야 할 영역은 다음과 같습니다:
- 개인에 대한 부정적 영향: 제한 사항, 지원되지 않는 사용, 알려진 한계 등 시스템의 성능에 방해가 되는 요인을 인지하여 시스템 때문에 개인에게 해가 가지 않도록 해야 합니다.
- 데이터 요구사항: 시스템이 데이터를 어떻게, 어디서 사용할지 이해하여 검토자가 준수해야 할 데이터 규제(GDPR, HIPAA 등)를 확인하고 데이터 출처 및 양이 학습에 적합한지 평가합니다.
- 영향 요약: 시스템 사용으로 발생할 수 있는 잠재적 피해 목록을 수집하고 ML 라이프사이클 전반에 걸쳐 문제를 완화하거나 해결하는지 검토합니다.
- 각 핵심 원칙에 적용되는 목표: 각 원칙의 목표 달성 여부와 부족한 부분이 있는지 평가합니다.
책임감 있는 AI로 디버깅하기
소프트웨어 애플리케이션을 디버깅하듯이 AI 시스템 디버깅은 문제를 식별하고 해결하는 필수 과정입니다. 이유 없이 모델이 기대에 못 미치거나 책임감 있게 작동하지 않는 다양한 요인이 있습니다. 대부분 기존 모델 성능 지표는 모델 성능의 정량적 집계에 불과해 책임감 있는 AI 원칙 위반 여부를 분석하는 데 충분하지 않습니다. 게다가 머신러닝 모델은 블랙박스이기에 결과를 이끄는 요인을 이해하거나 실수 시 설명하기 어렵습니다. 이 후 과정에서 책임감 있는 AI 대시보드를 사용해 AI 시스템을 디버깅하는 방법을 배울 것입니다. 대시보드는 데이터 과학자와 AI 개발자가 수행할 수 있는 포괄적인 도구를 제공합니다:
- 오류 분석: 시스템의 공정성 또는 신뢰성에 영향을 줄 수 있는 오류 분포를 식별합니다.
- 모델 개요: 데이터 코호트별 모델 성능 차이를 발견합니다.
- 데이터 분석: 데이터 분포를 이해하고 공정성, 포용성, 신뢰성 문제를 야기할 수 있는 잠재적 편향을 발견합니다.
- 모델 해석 가능성: 모델 예측에 영향을 미치는 요인을 이해합니다. 이는 투명성과 책임성을 위해 모델 동작을 설명하는 데 중요합니다.
🚀 챌린지
해를 사전에 방지하기 위해 우리는:
- 다양한 배경과 관점을 가진 사람들이 시스템 작업에 참여하도록 해야 합니다.
- 사회를 반영하는 데이터 세트에 투자해야 합니다.
- 머신러닝 생명주기 내내 책임감 없는 AI를 발견하고 수정하는 더 나은 방법을 개발해야 합니다.
모델 구축과 사용에서 모델의 신뢰성 부족이 드러나는 실제 사례를 생각해 보세요. 또 무엇을 고려해야 할까요?
강의 후 퀴즈
복습 및 자율 학습
이번 수업에서는 머신러닝에서 공정성과 불공정성에 대한 기본 개념을 배웠습니다.
다음 워크숍을 시청하며 주제에 대해 더 깊이 탐구해 보세요:
- 책임감 있는 AI를 추구하며: 원칙을 실천으로 옮기기, Besmira Nushi, Mehrnoosh Sameki, Amit Sharma 저

🎥 위 이미지를 클릭하면 영상이 나옵니다: Besmira Nushi, Mehrnoosh Sameki, Amit Sharma의 책임 있는 AI 구축을 위한 오픈 소스 프레임워크 RAI Toolbox
또한, 다음도 읽어보세요:
-
마이크로소프트의 RAI 리소스 센터: Responsible AI Resources – Microsoft AI
-
마이크로소프트의 FATE 연구 그룹: FATE: 공정성, 책임성, 투명성, 그리고 AI 윤리 - Microsoft Research
RAI Toolbox:
공정성을 보장하기 위한 Azure Machine Learning 도구에 대해 읽어보세요:
과제
면책 조항: 이 문서는 AI 번역 서비스 Co-op Translator를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역은 오류나 부정확한 부분이 있을 수 있음을 유의하시기 바랍니다. 원본 문서의 원어본이 권위 있는 자료로 간주되어야 합니다. 중요한 정보의 경우, 전문가의 인간 번역을 권장합니다. 이 번역 사용으로 인해 발생하는 오해나 잘못된 해석에 대해 당사는 책임을 지지 않습니다.