
 localizeflow[bot]
1e8aaef95b |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Costruire soluzioni di Machine Learning con un'IA responsabile

Sketchnote di Tomomi Imura
Quiz pre-lezione
Introduzione
In questo curriculum, inizierai a scoprire come il machine learning può e sta impattando la nostra vita quotidiana. Anche ora, sistemi e modelli sono coinvolti nelle attività decisionali quotidiane, come diagnosi sanitarie, approvazioni di prestiti o rilevamento di frodi. Perciò, è importante che questi modelli funzionino bene per fornire risultati affidabili. Proprio come qualsiasi applicazione software, i sistemi di IA possono deludere le aspettative o avere risultati indesiderati. Ecco perché è essenziale essere in grado di comprendere e spiegare il comportamento di un modello di IA.
Immagina cosa può succedere quando i dati usati per costruire questi modelli mancano di certi dati demografici, come razza, genere, opinioni politiche, religione, o rappresentano in modo sproporzionato tali dati demografici. Cosa succede quando l’output del modello viene interpretato per favorire un determinato gruppo demografico? Qual è la conseguenza per l'applicazione? Inoltre, cosa accade quando il modello ha un esito negativo e risulta dannoso per le persone? Chi è responsabile del comportamento dei sistemi di IA? Queste sono alcune delle domande che esploreremo in questo curriculum.
In questa lezione, tu:
- Accrescerai la tua consapevolezza sull'importanza dell'equità nel machine learning e dei danni correlati all'equità.
- Ti familiarizzerai con la pratica di esplorare valori anomali e scenari insoliti per garantire affidabilità e sicurezza.
- Acquisirai comprensione della necessità di responsabilizzare tutti progettando sistemi inclusivi.
- Esplorerai quanto sia vitale proteggere la privacy e la sicurezza dei dati e delle persone.
- Vedrai l'importanza di avere un approccio di tipo “trasparente” per spiegare il comportamento dei modelli di IA.
- Sarai consapevole di come la responsabilità sia essenziale per costruire fiducia nei sistemi di IA.
Prerequisiti
Come prerequisito, per favore segui il Percorso di apprendimento "Principi di IA responsabile" e guarda il video sottostante sull'argomento:
Scopri di più sull'IA responsabile seguendo questo Percorso di apprendimento

🎥 Clicca sull'immagine sopra per un video: Approccio di Microsoft all'IA responsabile
Equità
I sistemi di IA dovrebbero trattare tutti con equità ed evitare di influenzare gruppi simili di persone in modi diversi. Ad esempio, quando i sistemi di IA forniscono indicazioni su trattamenti medici, richieste di prestito o assunzioni, dovrebbero fare le stesse raccomandazioni a tutti con sintomi simili, condizioni finanziarie simili o qualifiche professionali simili. Ognuno di noi, come esseri umani, porta con sé pregiudizi ereditati che influenzano decisioni e azioni. Questi pregiudizi possono essere evidenti nei dati usati per addestrare i sistemi di IA. Tale manipolazione può talvolta avvenire involontariamente. Spesso è difficile sapere coscientemente quando si introduce un bias nei dati.
"Ingiustizia" comprende impatti negativi, o "danni", per un gruppo di persone, come quelli definiti in termini di razza, genere, età o stato di disabilità. I principali danni correlati all'equità possono essere classificati come:
- Assegnazione, se ad esempio un genere o etnia è favorito rispetto a un altro.
- Qualità del servizio. Se si addestra il modello per uno scenario specifico ma la realtà è molto più complessa, si ottiene un servizio di scarsa qualità. Per esempio, un distributore di sapone per le mani che sembrava incapace di riconoscere persone con pelle scura. Riferimento
- Denigrazione. Criticare ingiustamente e etichettare qualcosa o qualcuno. Per esempio, una tecnologia di etichettatura immagini che ha infamemente etichettato persone dalla pelle scura come gorilla.
- Sovra- o sotto-rappresentazione. L’idea è che un certo gruppo non sia rappresentato in una professione, e qualsiasi servizio o funzione che contribuisce a promuovere questo causa danno.
- Stereotipi. Associare a un dato gruppo attributi preassegnati. Per esempio, un sistema di traduzione linguistica tra inglese e turco potrebbe avere inesattezze dovute a parole con associazioni stereotipate al genere.
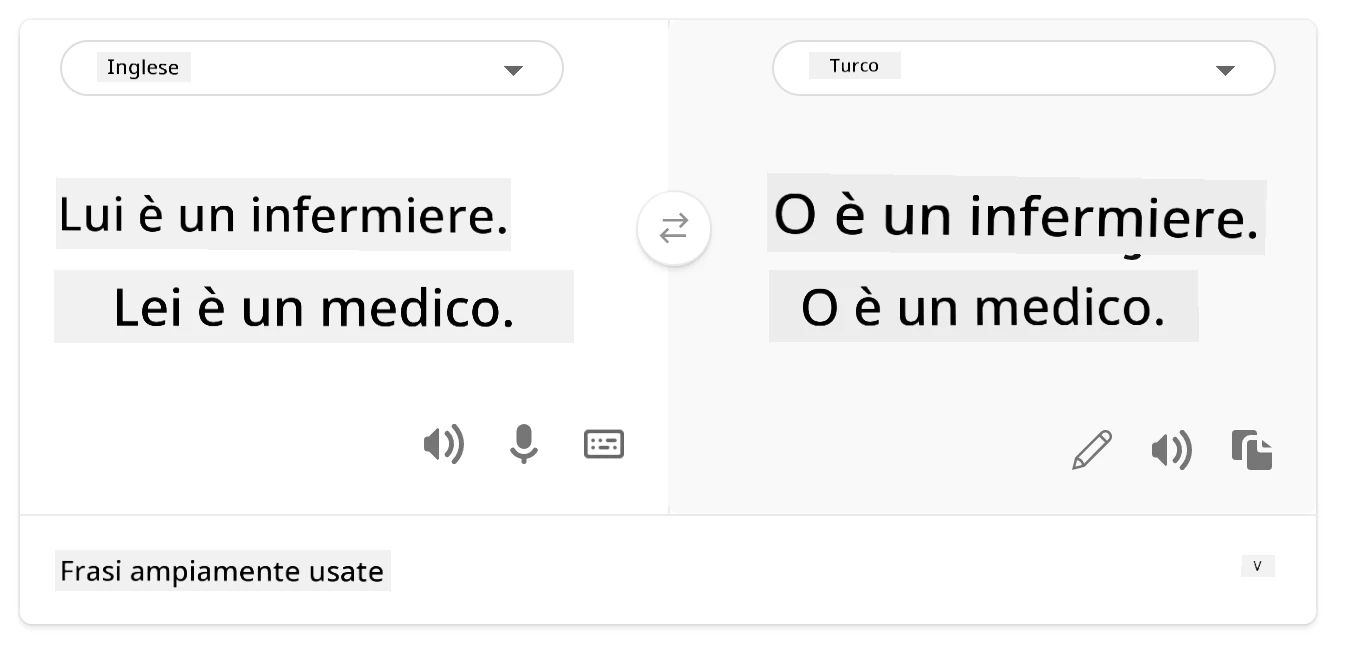
traduzione in turco
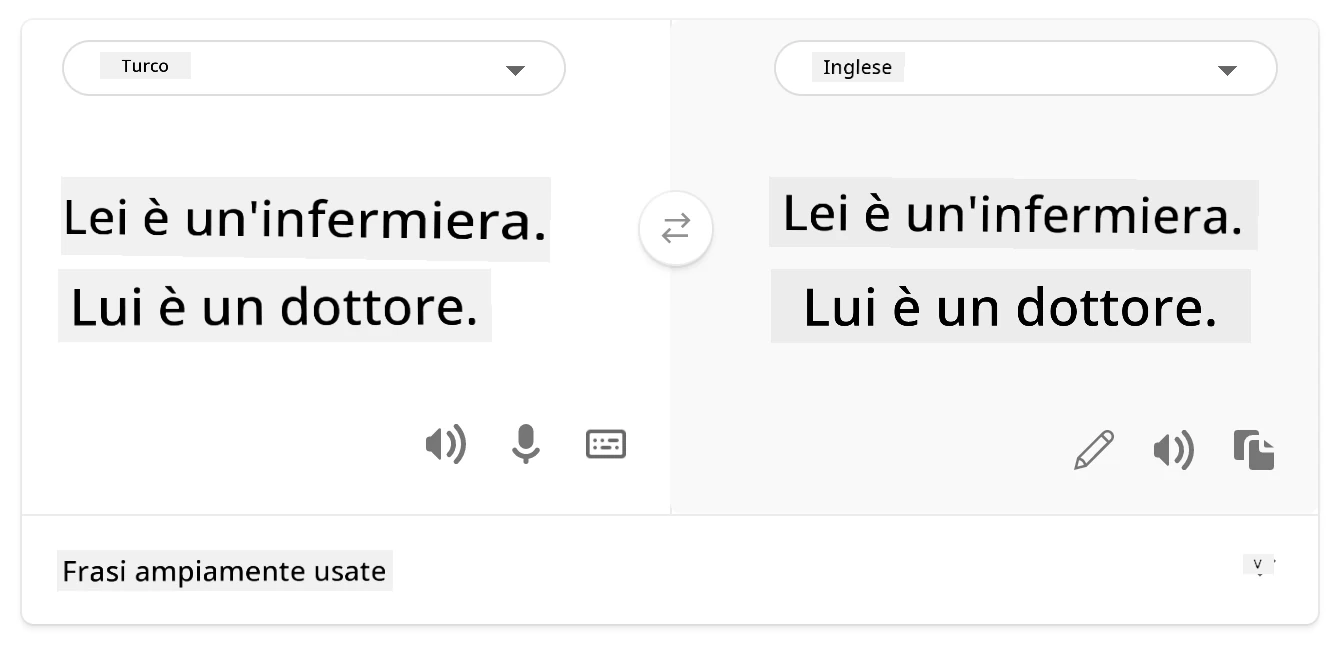
traduzione di nuovo in inglese
Quando si progettano e testano sistemi di IA, dobbiamo garantire che l’IA sia equa e non programmata per prendere decisioni discriminatorie o di parte, che anche gli esseri umani sono proibiti di fare. Garantire equità nell’IA e nel machine learning rimane una complessa sfida sociotecnica.
Affidabilità e sicurezza
Per costruire fiducia, i sistemi di IA devono essere affidabili, sicuri e coerenti in condizioni normali e impreviste. È importante sapere come i sistemi di IA si comporteranno in varie situazioni, specialmente se sono fuori norma. Quando si costruiscono soluzioni IA, è necessario porre grande attenzione a come gestire una vasta gamma di circostanze che tali soluzioni potrebbero incontrare. Ad esempio, un'auto a guida autonoma deve mettere la sicurezza delle persone come priorità assoluta. Di conseguenza, l’IA che alimenta l’auto deve considerare tutti i possibili scenari che l’auto potrebbe incontrare, come notte, temporali o bufere di neve, bambini che attraversano la strada, animali domestici, lavori stradali, ecc. Quanto bene un sistema di IA può gestire una vasta gamma di condizioni in modo affidabile e sicuro riflette quanto il data scientist o sviluppatore IA abbia anticipato durante la progettazione o test del sistema.
Inclusività
I sistemi di IA dovrebbero essere progettati per coinvolgere e responsabilizzare tutti. Quando progettano e implementano sistemi IA, data scientist e sviluppatori IA identificano e affrontano potenziali barriere nel sistema che potrebbero escludere involontariamente le persone. Per esempio, ci sono 1 miliardo di persone con disabilità nel mondo. Con il progresso dell’IA, esse possono accedere più facilmente a una vasta gamma di informazioni e opportunità nella vita quotidiana. Affrontando le barriere, si creano opportunità per innovare e sviluppare prodotti IA con migliori esperienze che beneficiano tutti.
Sicurezza e privacy
I sistemi di IA dovrebbero essere sicuri e rispettare la privacy delle persone. Le persone hanno meno fiducia in sistemi che mettono a rischio la loro privacy, informazioni o vite. Quando addestriamo modelli di machine learning, facciamo affidamento sui dati per produrre i migliori risultati. In questo processo, l’origine dei dati e l’integrità devono essere considerati. Per esempio, i dati erano inviati dagli utenti o erano pubblicamente disponibili? Inoltre, lavorando con i dati, è cruciale sviluppare sistemi IA che possano proteggere informazioni riservate e resistere ad attacchi. Man mano che l’IA diventa più diffusa, proteggere la privacy e mettere in sicurezza informazioni personali e aziendali importanti diventa sempre più critico e complesso. Le questioni di privacy e sicurezza dei dati richiedono particolare attenzione per l’IA perché l’accesso ai dati è essenziale affinché i sistemi IA facciano previsioni e decisioni accurate e informate sulle persone.
- Come settore abbiamo fatto significativi progressi in Privacy e sicurezza, alimentati in modo significativo da regolamenti come il GDPR (General Data Protection Regulation).
- Tuttavia, con i sistemi IA dobbiamo riconoscere la tensione tra la necessità di più dati personali per rendere i sistemi più personali ed efficaci – e la privacy.
- Proprio come con la nascita dei computer connessi a Internet, vediamo anche un forte aumento del numero di problemi di sicurezza legati all'IA.
- Allo stesso tempo, abbiamo visto l’IA usata per migliorare la sicurezza. Per esempio, la maggior parte degli scanner antivirus moderni oggi sono guidati da euristiche di IA.
- Dobbiamo assicurarci che i nostri processi di Data Science si integrino armoniosamente con le ultime pratiche di privacy e sicurezza.
Trasparenza
I sistemi di IA dovrebbero essere comprensibili. Una parte cruciale della trasparenza è spiegare il comportamento dei sistemi di IA e dei loro componenti. Migliorare la comprensione dei sistemi IA richiede che gli stakeholder comprendano come e perché funzionano così da poter identificare potenziali problemi di performance, preoccupazioni di sicurezza e privacy, pregiudizi, pratiche esclusive o risultati non voluti. Crediamo anche che coloro che usano sistemi IA dovrebbero essere onesti e trasparenti su quando, perché e come decidono di metterli in uso. Così come sulle limitazioni dei sistemi che usano. Per esempio, se una banca usa un sistema IA per supportare le decisioni di prestito ai consumatori, è importante esaminare i risultati e capire quali dati influenzano le raccomandazioni del sistema. I governi stanno iniziando a regolamentare l’IA in tutti i settori, quindi data scientist e organizzazioni devono spiegare se un sistema IA soddisfa i requisiti normativi, soprattutto quando si presenta un risultato indesiderato.
- Poiché i sistemi IA sono così complessi, è difficile capire come funzionano e interpretare i risultati.
- Questa mancanza di comprensione influenza il modo in cui questi sistemi sono gestiti, operazionalizzati e documentati.
- Questa mancanza di comprensione influenza in modo più importante le decisioni prese usando i risultati prodotti da questi sistemi.
Responsabilità
Le persone che progettano e mettono in funzione sistemi IA devono essere responsabili del modo in cui i loro sistemi funzionano. La necessità di responsabilità è particolarmente cruciale con tecnologie d’uso sensibile come il riconoscimento facciale. Recentemente, c’è stata una domanda crescente per la tecnologia di riconoscimento facciale, specialmente da parte delle forze dell’ordine che vedono il potenziale della tecnologia in usi come ritrovare bambini scomparsi. Tuttavia, queste tecnologie potrebbero essere potenzialmente usate da un governo per mettere a rischio le libertà fondamentali dei loro cittadini permettendo, per esempio, la sorveglianza continua di individui specifici. Perciò, data scientist e organizzazioni devono essere responsabili di come il loro sistema IA impatta individui o società.

🎥 Clicca sull'immagine sopra per un video: Avvertimenti sulla sorveglianza di massa tramite riconoscimento facciale
Alla fine, una delle domande più grandi per la nostra generazione, come prima generazione che porta l’IA nella società, è come assicurarsi che i computer rimangano responsabili nei confronti delle persone e come assicurarsi che le persone che progettano i computer rimangano responsabili verso tutti gli altri.
Valutazione dell’impatto
Prima di addestrare un modello di machine learning, è importante condurre una valutazione dell’impatto per comprendere lo scopo del sistema IA; qual è l’uso previsto; dove sarà implementato; e chi interagirà con il sistema. Queste informazioni sono utili per revisori o tester che valutano il sistema per sapere quali fattori considerare nell’identificare potenziali rischi e conseguenze attese.
I seguenti sono aree di attenzione durante la valutazione dell’impatto:
- Impatto negativo sugli individui. Essere consapevoli di qualsiasi restrizione o requisito, uso non supportato o limitazioni conosciute che ostacolano la performance del sistema è vitale per assicurare che il sistema non venga usato in modo da causare danni agli individui.
- Requisiti dei dati. Comprendere come e dove il sistema utilizzerà i dati consente ai revisori di esplorare eventuali requisiti di dati di cui tener conto (per esempio, regolamenti GDPR o HIPAA). Inoltre, esaminare se la fonte o la quantità dei dati è adeguata per l’addestramento.
- Riepilogo dell’impatto. Raccogliere una lista dei potenziali danni che potrebbero derivare dall’uso del sistema. Durante l’intero ciclo di vita del ML, verificare se le problematiche identificate sono mitigate o affrontate.
- Obiettivi applicabili per ciascuno dei sei principi fondamentali. Valutare se gli obiettivi di ciascun principio sono raggiunti e se ci sono lacune.
Debugging con IA responsabile
Similmente al debugging di un’applicazione software, il debugging di un sistema IA è un processo necessario per identificare e risolvere problemi nel sistema. Ci sono molti fattori che possono influire sul fatto che un modello non funzioni come previsto o in modo responsabile. La maggior parte delle metriche tradizionali di performance di un modello sono aggregati quantitativi della performance del modello, che non sono sufficienti per analizzare come un modello violi i principi di IA responsabile. Inoltre, un modello di machine learning è una scatola nera che rende difficile capire cosa guida il suo risultato o fornire spiegazioni quando commette un errore. Più avanti in questo corso, impareremo come usare la dashboard di IA responsabile per aiutare a debuggare i sistemi IA. La dashboard fornisce uno strumento olistico per data scientist e sviluppatori IA per eseguire:
- Analisi degli errori. Per identificare la distribuzione degli errori del modello che può influire sull’equità o sull’affidabilità del sistema.
- Panoramica del modello. Per scoprire dove ci sono disparità nella performance del modello tra coorti di dati.
- Analisi dei dati. Per comprendere la distribuzione dei dati e identificare eventuali bias nei dati che potrebbero portare a problemi di equità, inclusività e affidabilità.
- Interpretabilità del modello. Per capire cosa influenza o condiziona le predizioni del modello. Questo aiuta a spiegare il comportamento del modello, importante per trasparenza e responsabilità.
🚀 Sfida
Per prevenire che danni vengano introdotti in primo luogo, dovremmo:
- avere una diversità di background e prospettive tra le persone che lavorano sui sistemi
- investire in dataset che riflettano la diversità della nostra società
- sviluppare metodi migliori lungo tutto il ciclo di vita del machine learning per rilevare e correggere IA irresponsabili quando si presentano
Pensa a scenari reali in cui l’inaffidabilità di un modello è evidente nella costruzione e nell’uso del modello. Cos’altro dovremmo considerare?
Quiz post-lezione
Revisione e studio individuale
In questa lezione, hai imparato alcune basi dei concetti di equità e ingiustizia nel machine learning.
Guarda questo workshop per approfondire i temi:
- In cerca di un’IA responsabile: portare i principi alla pratica di Besmira Nushi, Mehrnoosh Sameki e Amit Sharma

🎥 Clicca sull'immagine sopra per un video: RAI Toolbox: Un framework open-source per costruire un’IA responsabile di Besmira Nushi, Mehrnoosh Sameki e Amit Sharma
Leggi anche:
-
Centro risorse RAI di Microsoft: Responsible AI Resources – Microsoft AI
-
Gruppo di ricerca FATE di Microsoft: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Leggi degli strumenti di Azure Machine Learning per garantire l’equità:
Compito
Disclaimer: Questo documento è stato tradotto utilizzando il servizio di traduzione AI Co-op Translator. Sebbene ci impegniamo per garantire la precisione, si prega di notare che le traduzioni automatizzate possono contenere errori o imprecisioni. Il documento originale nella sua lingua nativa deve essere considerato la fonte autorevole. Per informazioni critiche, si raccomanda una traduzione professionale effettuata da un essere umano. Non siamo responsabili per eventuali malintesi o interpretazioni errate derivanti dall’uso di questa traduzione.