
 localizeflow[bot]
4e2f9e9b38 |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
जिम्मेदार AI के साथ मशीन लर्निंग समाधान बनाना

स्केचनोट द्वारा टोमोमी इमुरा
पूर्व व्याख्यान प्रश्नोत्तरी
परिचय
इस पाठ्यक्रम में, आप पता लगाना शुरू करेंगे कि मशीन लर्निंग कैसे और किस प्रकार हमारे दैनिक जीवन को प्रभावित कर रही है। अभी भी, सिस्टम और मॉडल दैनिक निर्णय लेने के कार्यों में सम्मिलित हैं, जैसे स्वास्थ्य देखभाल निदान, ऋण अनुमोदन या धोखाधड़ी का पता लगाना। इसलिए, यह महत्वपूर्ण है कि ये मॉडल अच्छे से काम करें ताकि विश्वसनीय परिणाम प्रदान कर सकें। किसी भी सॉफ़्टवेयर एप्लिकेशन की तरह, AI सिस्टम अपेक्षाओं को पूरा नहीं कर पाएंगे या उनका परिणाम अवांछित हो सकता है। इसलिए, AI मॉडल के व्यवहार को समझना और व्याख्या करना आवश्यक है।
कल्पना करें कि जब आप जिन डेटा का उपयोग इन मॉडलों को बनाने के लिए करते हैं, उनमें कुछ जनसांख्यिकी, जैसे जाति, लिंग, राजनीतिक दृष्टिकोण, धर्म, या असमान रूप से प्रतिनिधित्व हो, तो क्या हो सकता है। जब मॉडल का आउटपुट कुछ जनसांख्यिकी के पक्ष में व्याख्यायित किया जाता है तो क्या होगा? आवेदन के लिए इसका क्या परिणाम होगा? इसके अतिरिक्त, जब मॉडल का परिणाम प्रतिकूल हो और लोगों के लिए हानिकारक हो, तो क्या होगा? AI सिस्टम के व्यवहार के लिए कौन जिम्मेदार होगा? ये कुछ प्रश्न हैं जिन्हें हम इस पाठ्यक्रम में खोजेंगे।
इस पाठ में, आप:
- मशीन लर्निंग में निष्पक्षता के महत्व और निष्पक्षता-संबंधित नुकसान के बारे में जागरूकता बढ़ाएंगे।
- विश्वसनीयता और सुरक्षा सुनिश्चित करने के लिए असामान्य परिदृश्यों और आउटलेयर्स का पता लगाने के अभ्यास से परिचित होंगे।
- समावेशी सिस्टम डिजाइन करके सभी को सशक्त बनाने की आवश्यकता को समझेंगे।
- यह समझेंगे कि डेटा और लोगों की गोपनीयता और सुरक्षा की रक्षा करना कितना महत्वपूर्ण है।
- AI मॉडलों के व्यवहार को समझाने के लिए ग्लास बॉक्स दृष्टिकोण के महत्व को देखेंगे।
- AI सिस्टम में विश्वास बनाने के लिए जवाबदेही कितना आवश्यक है, इसका ध्यान रखेंगे।
पूर्वापेक्षा
पूर्वापेक्षा के रूप में, कृपया "जिम्मेदार AI सिद्धांत" लर्न पाथ लें और नीचे दिए गए वीडियो को देखें:
जिम्मेदार AI के बारे में अधिक जानने के लिए इस लर्निंग पाथ को फॉलो करें

🎥 ऊपर की छवि पर क्लिक करें वीडियो के लिए: Microsoft का जिम्मेदार AI के लिए दृष्टिकोण
निष्पक्षता
AI सिस्टम को सभी के प्रति निष्पक्ष व्यवहार करना चाहिए और समान समूहों को अलग-अलग तरीकों से प्रभावित करने से बचना चाहिए। उदाहरण के लिए, जब AI सिस्टम चिकित्सा उपचार, ऋण आवेदन या रोजगार पर मार्गदर्शन प्रदान करते हैं, तो उन्हें समान लक्षणों, वित्तीय परिस्थितियों या पेशेवर योग्यताओं वाले सभी को समान सुझाव देना चाहिए। हम सभी, मनुष्यों के रूप में, वंशानुगत पूर्वाग्रह लेकर चलते हैं जो हमारे निर्णयों और कार्यों को प्रभावित करते हैं। ये पूर्वाग्रह उस डेटा में स्पष्ट हो सकते हैं जिसका उपयोग हम AI सिस्टम को प्रशिक्षण देने के लिए करते हैं। कभी-कभी ऐसा अप्रत्यक्ष रूप से होता है। यह जानना अक्सर मुश्किल होता है कि कब आप डेटा में पूर्वाग्रह ला रहे हैं।
“अनिष्पक्षता” उस समूह के लिए नकारात्मक प्रभावों या "हानियों" को शामिल करती है, जैसे कि वे जो जाति, लिंग, उम्र या विकलांगता स्थिति के संदर्भ में परिभाषित होते हैं। मुख्य निष्पक्षता-संबंधित नुकसान को वर्गीकृत किया जा सकता है:
- आवंटन, यदि उदाहरण के लिए कोई लिंग या जातीयता दूसरे की तुलना में पक्षपाती हो।
- सेवा की गुणवत्ता। यदि आप किसी एक विशिष्ट परिदृश्य के लिए डेटा प्रशिक्षण देते हैं लेकिन वास्तविकता कहीं अधिक जटिल है, तो इससे एक खराब प्रदर्शन वाली सेवा बनती है। उदाहरण के लिए, एक हाथ धोने वाले साबुन का डिस्पेंसर जो गहरे रंग की त्वचा वाले लोगों को पहचान पाने में सक्षम नहीं था। संदर्भ
- अपमानजनक टिप्पणी। किसी चीज़ या किसी व्यक्ति की अनुचित आलोचना और लेबलिंग। उदाहरण के लिए, एक इमेज लेबलिंग तकनीक ने काले रंग की त्वचा वाले लोगों की तस्वीरों को गोरिल्ला के रूप में गलत टैग किया।
- अधिक या कम प्रतिनिधित्व। यह विचार कि कोई विशिष्ट समूह किसी विशेष पेशे में दिखाई नहीं देता है, और कोई भी सेवा या कार्य जो इसे बढ़ावा देता है, वह नुकसान पहुंचाता है।
- स्टीरियोटाइपिंग। किसी दिए गए समूह को पूर्वनिर्धारित विशेषताओं से जोड़ना। उदाहरण के लिए, अंग्रेजी और तुर्की के बीच एक भाषा अनुवाद प्रणाली में लिंग से जुड़े रूढ़िवादी शब्द उपयोग के कारण अशुद्धताएं हो सकती हैं।
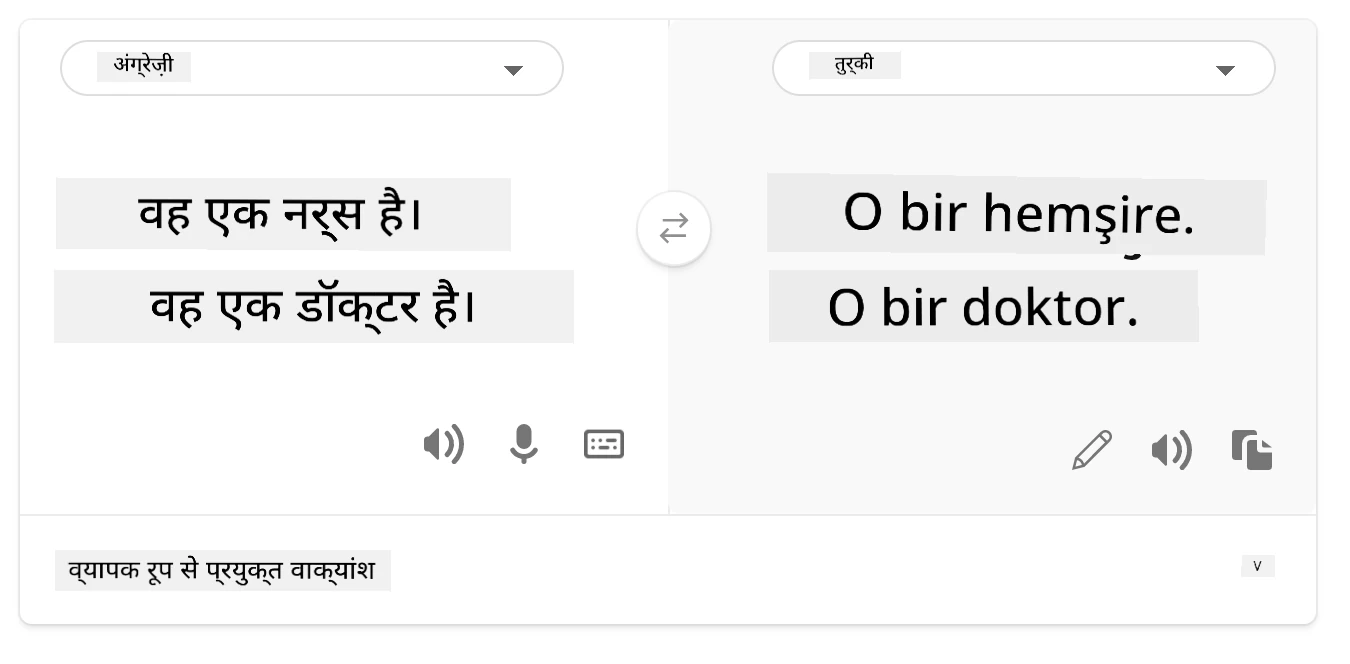
तुर्की में अनुवाद
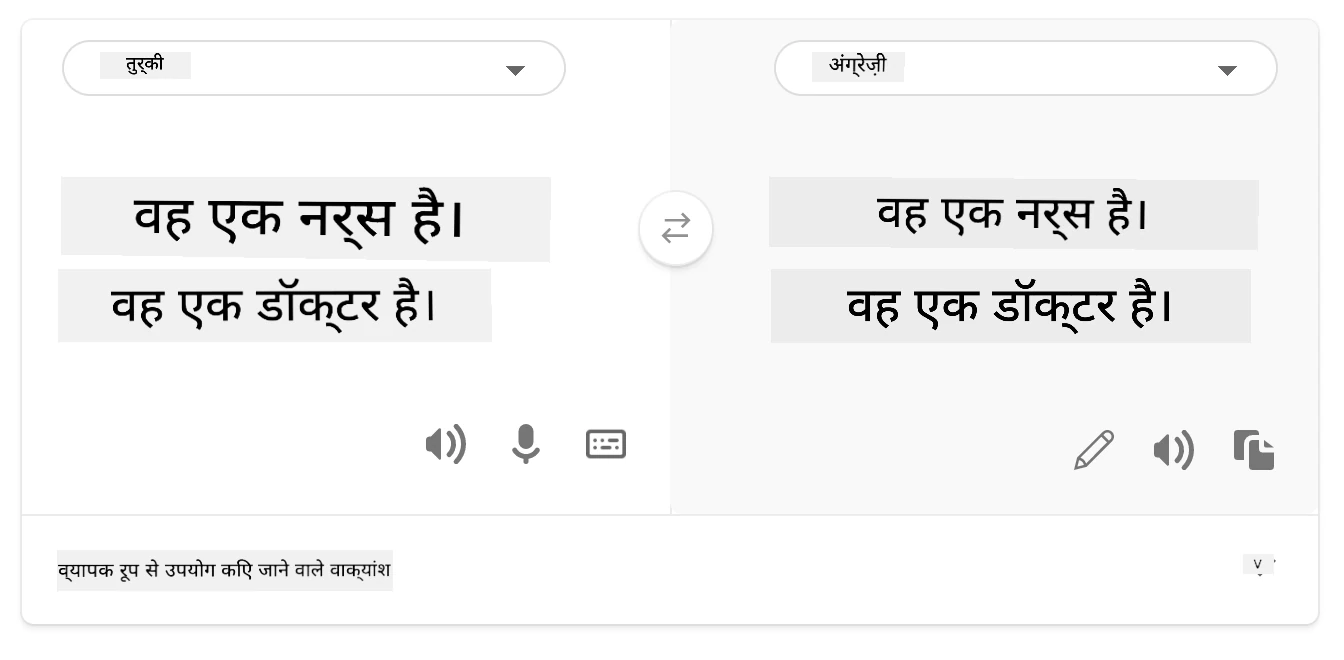
फिर से अंग्रेजी में अनुवाद
जब AI सिस्टम डिजाइन और परीक्षण किए जाते हैं, तो हमें सुनिश्चित करना चाहिए कि AI निष्पक्ष हो और पूर्वाग्रही या भेदभावपूर्ण निर्णय लेने के लिए प्रोग्राम न किया गया हो, जो मनुष्यों के लिए भी प्रतिबंधित है। AI और मशीन लर्निंग में निष्पक्षता की गारंटी देना एक जटिल सामाजिक तकनीकी चुनौती बनी हुई है।
विश्वसनीयता और सुरक्षा
विश्वास बनाने के लिए, AI सिस्टम को सामान्य और अप्रत्याशित परिस्थितियों में विश्वसनीय, सुरक्षित और सुसंगत होना चाहिए। यह जानना महत्वपूर्ण है कि AI सिस्टम विभिन्न परिस्थितियों में कैसे व्यवहार करेगा, खासकर जब वे आउटलेयर्स होते हैं। AI समाधान बनाते समय, यह ध्यान देना आवश्यक है कि AI समाधान किन विभिन्न परिस्थितियों का सामना कर सकता है। उदाहरण के लिए, एक सेल्फ-ड्राइविंग कार को लोगों की सुरक्षा को प्राथमिकता देना चाहिए। परिणामस्वरूप, कार को चलाने वाला AI उन सभी संभावित स्थितियों को ध्यान में रखेगा जिनसे कार गुजर सकती है जैसे रात, तूफान या हिमपात, बच्चे सड़क पार करते हुए, पालतू जानवर, सड़क निर्माण आदि। AI सिस्टम कितनी अच्छी तरह विभिन्न परिस्थितियों को विश्वसनीय और सुरक्षित रूप से संभाल सकता है, यह उस स्तर को दर्शाता है जो डेटा वैज्ञानिक या AI डेवलपर ने सिस्टम की डिजाइन या परीक्षण के दौरान अनुमानित किया था।
🎥 विश्वसनीयता और सुरक्षा पर वीडियो देखें: AI में विश्वसनीयता और सुरक्षा
समावेशिता
AI सिस्टम को सभी को शामिल करने और सशक्त बनाने के लिए डिजाइन किया जाना चाहिए। AI सिस्टम डिजाइन और कार्यान्वयन में डेटा वैज्ञानिक और AI डेवलपर्स सिस्टम में संभावित बाधाओं की पहचान करते हैं जो अनजाने में लोगों को बाहर कर सकती हैं। उदाहरण के लिए, दुनिया भर में 1 बिलियन लोग विकलांगता के साथ हैं। AI के विकास से वे अपनी दैनिक ज़िंदगी में अधिक आसानी से विभिन्न जानकारी और अवसरों तक पहुंच सकते हैं। बाधाओं का समाधान करने से नवोन्मेष के अवसर बनते हैं और बेहतर अनुभवों के साथ AI उत्पाद विकसित किए जा सकते हैं जो सभी को लाभ पहुंचाते हैं।
सुरक्षा और गोपनीयता
AI सिस्टम को सुरक्षित और लोगों की गोपनीयता का सम्मान करना चाहिए। लोग ऐसे सिस्टम पर कम भरोसा करते हैं जो उनकी गोपनीयता, जानकारी या जीवन को खतरे में डालते हैं। मशीन लर्निंग मॉडल को प्रशिक्षित करते समय, हम डेटा पर निर्भर रहते हैं ताकि सर्वोत्तम परिणाम प्राप्त कर सकें। ऐसा करते समय, डेटा का स्रोत और उसकी अखंडता पर विचार किया जाना चाहिए। उदाहरण के लिए, क्या डेटा उपयोगकर्ता द्वारा प्रस्तुत किया गया था या सार्वजनिक रूप से उपलब्ध था? इसके बाद, डेटा के साथ काम करते समय, यह जरूरी है कि AI सिस्टम संवेदनशील जानकारी की रक्षा कर सकें और हमलों का सामना कर सकें। AI के बढ़ते प्रसार के साथ, गोपनीयता की सुरक्षा और महत्वपूर्ण व्यक्तिगत एवं व्यावसायिक जानकारी की सुरक्षा और भी महत्वपूर्ण और जटिल होती जा रही है। गोपनीयता और डेटा सुरक्षा के मुद्दे AI के लिए विशेष ध्यान मांगते हैं क्योंकि डेटा की पहुँच AI सिस्टम के लिए सही और सूचित भविष्यवाणियाँ और निर्णय लेने के लिए आवश्यक है।
- उद्योग के रूप में, हमने गोपनीयता और सुरक्षा में महत्वपूर्ण प्रगति की है, जिसका मुख्य रूप से साला नियम जैसे GDPR (General Data Protection Regulation) ने समर्थन किया है।
- फिर भी, AI सिस्टम के साथ हमें यह स्वीकार करना होगा कि डेटा की अधिक आवश्यकता और गोपनीयता के बीच तनाव है - अधिक व्यक्तिगत और प्रभावी सिस्टम बनाने के लिए अधिक व्यक्तिगत डेटा जरूरी होता है।
- जैसे इंटरनेट के साथ जुड़े कंप्यूटर के जन्म के समय सुरक्षा समस्याएं बढ़ीं, वैसे ही AI के साथ भी सुरक्षा मुद्दों की संख्या में भारी वृद्धि देखी गई है।
- साथ ही, हमने देखा है कि AI का उपयोग सुरक्षा सुधारने में भी किया जा रहा है। उदाहरण के लिए, अधिकांश आधुनिक एंटी-वायरस स्कैनर आज AI हीरिस्टिक्स द्वारा संचालित होते हैं।
- हमें सुनिश्चित करना चाहिए कि हमारे डेटा साइंस प्रक्रियाएँ नवीनतम गोपनीयता और सुरक्षा प्रथाओं के साथ संतुलित हों।
पारदर्शिता
AI सिस्टम को समझने योग्य होना चाहिए। पारदर्शिता का एक महत्वपूर्ण भाग AI सिस्टम के व्यवहार और उनके घटकों को समझाना है। AI सिस्टम की समझ को बेहतर बनाने के लिए स्टेकहोल्डर्स को यह जानना चाहिए कि वे कैसे और क्यों कार्य करते हैं ताकि वे संभावित प्रदर्शन मुद्दों, सुरक्षा और गोपनीयता की चिंताओं, पूर्वाग्रहों, बहिष्कारकारी प्रथाओं, या अनपेक्षित परिणामों की पहचान कर सकें। हमें यह भी मानना चाहिए कि जो लोग AI सिस्टम का उपयोग करते हैं उन्हें ईमानदार और स्पष्ट होना चाहिए कि वे कब, क्यों, और कैसे इन सिस्टमों को लागू करते हैं। साथ ही वे सिस्टम की सीमाओं के बारे में भी स्पष्ट हों। उदाहरण के लिए, यदि कोई बैंक अपने उपभोक्ता ऋण निर्णयों के लिए AI सिस्टम का उपयोग करता है, तो परिणामों की जांच कर यह समझना जरूरी है कि सिस्टम की सिफारिशों को कौन सा डेटा प्रभावित करता है। सरकारें उद्योगों में AI को विनियमित करना शुरू कर रही हैं, इसलिए डेटा वैज्ञानिकों और संगठनों को स्पष्ट करना चाहिए कि क्या AI सिस्टम नियामक आवश्यकताओं को पूरा करता है, खासकर जब कोई अवांछित परिणाम हो।
- चूँकि AI सिस्टम बहुत जटिल हैं, इसे समझना और परिणामों की व्याख्या करना कठिन होता है।
- यह समझ की कमी इन सिस्टमों के प्रबंधन, संचालन, और दस्तावेज़ीकरण को प्रभावित करती है।
- इससे भी महत्वपूर्ण, यह समझ की कमी उन निर्णयों को प्रभावित करती है जो इन सिस्टमों के परिणामों के आधार पर लिए जाते हैं।
जवाबदेही
AI सिस्टम डिज़ाइन और लागू करने वाले लोग अपने सिस्टम के संचालन के लिए जवाबदेह होने चाहिए। खासकर संवेदनशील प्रयुक्तियों जैसे चेहरे की पहचान के साथ जवाबदेही बहुत महत्वपूर्ण होती है। हाल ही में, चेहरे की पहचान तकनीक के लिए मांग बढ़ी है, विशेषकर कानून प्रवर्तन संगठनों से, जो तकनीक की संभावनाओं को जैसे लापता बच्चों को ढूंढने में देखते हैं। हालांकि, इन तकनीकों का सरकार द्वारा नागरिकों की मौलिक स्वतंत्रताओं को जोखिम में डालने के लिए भी इस्तेमाल किया जा सकता है, उदाहरण के लिए, कुछ व्यक्तियों की निरंतर निगरानी सक्षम कर। इसलिए, डेटा वैज्ञानिकों और संगठनों को यह जिम्मेदारी लेनी चाहिए कि उनका AI सिस्टम व्यक्तियों या समाज पर कैसे प्रभाव डालता है।

🎥 ऊपर की छवि पर क्लिक करें वीडियो के लिए: चेहरे की पहचान के माध्यम से व्यापक निगरानी की चेतावनी
अंततः हमारे पीढ़ी के लिए सबसे बड़ा सवाल है, क्योंकि हम AI को समाज में ला रहे हैं, कि हम सुनिश्चित करें कि कंप्यूटर लोगों के प्रति जवाबदेह बने रहें और जिन्होंने कंप्यूटर डिजाइन किए हैं वे सभी के प्रति जवाबदेह बने रहें।
प्रभाव मूल्यांकन
मशीन लर्निंग मॉडल को प्रशिक्षण देने से पहले, यह जरूरी है कि प्रभाव मूल्यांकन किया जाए ताकि AI सिस्टम का उद्देश्य, उसका इरादा उपयोग क्या है, वह कहाँ पर लागू होगा, और कौन सिस्टम के साथ इंटरैक्ट करेगा, यह समझा जा सके। यह समीक्षक या परीक्षकों को यह जानने में मदद करता है कि किसी भी संभावित जोखिम और अपेक्षित परिणामों का मूल्यांकन करते समय किन कारकों को ध्यान में रखना चाहिए।
प्रभाव मूल्यांकन करते समय निम्न क्षेत्रों पर ध्यान केंद्रित किया जाता है:
- व्यक्तियों पर प्रतिकूल प्रभाव। कोई भी प्रतिबंध, आवश्यकताएँ, असमर्थित उपयोग या ज्ञात सीमाएँ जो प्रणाली के प्रदर्शन को प्रभावित कर सकती हैं, इसके प्रति जागरूक रहना आवश्यक है ताकि सिस्टम का उपयोग ऐसे तरीके से न हो जिससे व्यक्तियों को नुकसान पहुंचे।
- डेटा आवश्यकताएँ। यह समझना कि सिस्टम डेटा को कैसे और कहाँ उपयोग करेगा, समीक्षकों को किसी भी डेटा आवश्यकताओं की जांच करने में मदद करता है (जैसे GDPR या HIPAA डेटा नियम)। साथ ही, जांचें कि डेटा का स्रोत या मात्रा प्रशिक्षण के लिए पर्याप्त है या नहीं।
- प्रभाव का सारांश। सिस्टम के उपयोग से उत्पन्न संभावित हानियों की सूची बनाएँ। मशीन लर्निंग जीवनचक्र के दौरान, यह समीक्षा करें कि पहचानी गई समस्याएं कम या संबोधित की गई हैं या नहीं।
- प्रत्येक छह मूल सिद्धांतों के लिए लागू लक्ष्य। यह आंकलन करें कि क्या प्रत्येक सिद्धांत के लक्ष्य पूरे किए जा रहे हैं और यदि कोई अंतर है।
जिम्मेदार AI के साथ डिबगिंग
किसी सॉफ़्टवेयर एप्लिकेशन को डिबग करने की तरह, AI सिस्टम को डिबग करना भी सिस्टम में मुद्दों की पहचान और समाधान करने की आवश्यक प्रक्रिया है। कई कारक होते हैं जो मॉडल के अपेक्षित या जिम्मेदारीपूर्ण प्रदर्शन को प्रभावित करते हैं। अधिकांश पारंपरिक मॉडल प्रदर्शन मीट्रिक्स मॉडल के प्रदर्शन के मात्रात्मक संकलन होते हैं, जो यह विश्लेषण करने के लिए पर्याप्त नहीं हैं कि मॉडल जिम्मेदार AI सिद्धांतों का उल्लंघन कैसे करता है। इसके अलावा, एक मशीन लर्निंग मॉडल एक ब्लैक बॉक्स होता है जिससे यह समझना कठिन होता है कि उसका परिणाम क्या प्रभावित करता है या गलती होने पर व्याख्या देना। इस पाठ्यक्रम में बाद में, हम जिम्मेदार AI डैशबोर्ड का उपयोग करना सीखेंगे जो AI सिस्टम को डिबग करने में मदद करता है। यह डैशबोर्ड डेटा वैज्ञानिकों और AI डेवलपर्स के लिए एक समग्र उपकरण प्रदान करता है जिसके माध्यम से वे:
- त्रुटि विश्लेषण। मॉडल की त्रुटि वितरण की पहचान करें जो सिस्टम की निष्पक्षता या विश्वसनीयता को प्रभावित कर सकती है।
- मॉडल अवलोकन। डेटा समूहों के बीच मॉडल के प्रदर्शन में अंतर की खोज करें।
- डेटा विश्लेषण। डेटा वितरण को समझें और किसी भी संभावित पूर्वाग्रह की पहचान करें जो निष्पक्षता, समावेशिता और विश्वसनीयता के मुद्दे पैदा कर सकता है।
- मॉडल व्याख्यायिता। समझें कि मॉडल की भविष्यवाणियों को क्या प्रभावित करता है। यह मॉडल के व्यवहार को समझाने में मदद करता है, जो पारदर्शिता और जवाबदेही के लिए आवश्यक है।
🚀 चुनौती
नुकसान को पहले से ही रोकने के लिए, हमें:
- सिस्टम पर काम करने वाले लोगों में पृष्ठभूमि और दृष्टिकोण की विविधता होनी चाहिए।
- हमारे समाज की विविधता को प्रतिबिंबित करने वाले डेटासेट में निवेश करना चाहिए।
- मशीन लर्निंग जीवनचक्र के दौरान जब भी जिम्मेदार AI में त्रुटि हो, उसे पहचानने और सुधारने के बेहतर तरीके विकसित करें।
ऐसे वास्तविक जीवन के परिदृश्यों के बारे में सोचें जहाँ मॉडल की अविश्वसनीयता मॉडल-निर्माण और उपयोग में स्पष्ट हो। हमें और क्या विचार करना चाहिए?
पोस्ट-व्याख्यान प्रश्नोत्तरी
समीक्षा और स्व-अध्ययन
इस पाठ में, आपने मशीन लर्निंग में निष्पक्षता और अनिष्पक्षता की कुछ मूल अवधारणाओं को सीखा है।
इस वर्कशॉप को देखें और विषयों में गहराई से जानें:
- जिम्मेदार AI की खोज में: सिद्धांतों को व्यवहार में लाना, बेमसीरा नुशी, मेहरनूश सामेकी और अमित शर्मा द्वारा

🎥 वीडियो के लिए ऊपर दिए गए चित्र पर क्लिक करें: जिम्मेदार AI बनाने के लिए एक ओपन-सोर्स फ्रेमवर्क RAI टूलबॉक्स, ब्रेस्मिरा नुशी, मेहरनूश सामेकी और अमित शर्मा द्वारा
साथ ही पढ़ें:
-
माइक्रोसॉफ्ट का RAI संसाधन केंद्र: जिम्मेदार AI संसाधन – Microsoft AI
-
माइक्रोसॉफ्ट का FATE अनुसंधान समूह: FATE: AI में निष्पक्षता, जवाबदेही, पारदर्शिता, और नैतिकता - Microsoft Research
RAI टूलबॉक्स:
निष्पक्षता सुनिश्चित करने के लिए Azure मशीन लर्निंग के उपकरणों के बारे में पढ़ें:
असाइनमेंट
अस्वीकरण: इस दस्तावेज़ का अनुवाद AI अनुवाद सेवा Co-op Translator का उपयोग करके किया गया है। जबकि हम सटीकता के लिए प्रयास करते हैं, कृपया ध्यान दें कि स्वचालित अनुवादों में त्रुटियाँ या अशुद्धियाँ हो सकती हैं। मूल दस्तावेज़ अपनी मूल भाषा में ही प्रामाणिक स्रोत माना जाना चाहिए। महत्वपूर्ण जानकारी के लिए, पेशेवर मानव अनुवाद की सिफारिश की जाती है। इस अनुवाद के उपयोग से उत्पन्न किसी भी गलतफहमी या गलत व्याख्या के लिए हम उत्तरदायी नहीं हैं।