
 localizeflow[bot]
14f5ba5f5c |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Vastuuullisen tekoälyn avulla koneoppimisratkaisujen rakentaminen

Luonnos Tomomi Imura
Esiluentokilpailu
Johdanto
Tässä oppimateriaalissa alat tutkia, miten koneoppiminen vaikuttaa ja on jo vaikuttanut jokapäiväiseen elämäämme. Jo nyt järjestelmät ja mallit ovat mukana päivittäisissä päätöksentekotehtävissä, kuten terveydenhuollon diagnooseissa, lainapäätöksissä tai petosten havaitsemisessa. Siksi on tärkeää, että nämä mallit toimivat hyvin ja tuottavat luotettavia tuloksia. Aivan kuten mikä tahansa ohjelmistosovellus, myös tekoälyjärjestelmät voivat pettää odotukset tai aiheuttaa ei-toivottuja tuloksia. Siksi on olennaista pystyä ymmärtämään ja selittämään tekoälymallin toimintaa.
Kuvittele, mitä voi tapahtua, kun tietoa, jolla näitä malleja rakennetaan, puuttuu tiettyjä väestöryhmiä, kuten rotua, sukupuolta, poliittista näkökantaa, uskontoa, tai kun kyseiset väestöryhmät on edustettu suhteettoman paljon. Entä kun mallin tulos tulkitaan suosimaan jotakin väestöryhmää? Mikä on sovelluksen seuraus? Lisäksi mitä tapahtuu, kun mallin tulos on haitallinen ihmisille? Kuka vastaa tekoälyjärjestelmän toiminnasta? Näitä kysymyksiä tarkastelemme tässä oppimateriaalissa.
Tässä oppitunnissa:
- Nostetaan tietoisuutta oikeudenmukaisuuden merkityksestä koneoppimisessa ja oikeudenmukaisuuteen liittyvistä haitoista.
- Tutustutaan poikkeamien ja epätavallisten tilanteiden tutkimiseen luotettavuuden ja turvallisuuden varmistamiseksi.
- Saadaan ymmärrystä tarpeesta voimaannuttaa kaikki suunnittelemalla osallistavia järjestelmiä.
- Tutustutaan siihen, kuinka tärkeää on suojella ihmisten ja tietojen yksityisyyttä ja turvallisuutta.
- Nähdään, miten tärkeää on käyttää läpinäkyvää (“glasstipparimallia”) lähestymistapaa tekoälymallien käyttäytymisen selittämiseksi.
- Huomioidaan, kuinka vastuuvelvollisuus on olennaista luottamuksen rakentamisessa tekoälyjärjestelmiin.
Edellytys
Edellytyksenä on, että suoritat "Vastuullisen tekoälyn periaatteet" -oppimispolun ja katsot alla olevan videon aiheesta:
Opi lisää vastuullisesta tekoälystä seuraamalla tätä Oppimispolkua

🎥 Klikkaa yllä olevaa kuvaa katsoaksesi videon: Microsoftin lähestymistapa vastuulliseen tekoälyyn
Oikeudenmukaisuus
Tekoälyjärjestelmien tulisi kohdella kaikkia oikeudenmukaisesti ja välttää vaikuttamasta samankaltaisiin ihmisryhmiin eri tavoilla. Esimerkiksi kun tekoälyjärjestelmät antavat ohjeita lääketieteellisestä hoidosta, lainahakemuksista tai työllistymisestä, niiden pitäisi antaa samanlaiset suositukset kaikille samankaltaisin oirein, taloudellisin olosuhtein tai ammatillisin pätevyysin varustetuille henkilöille. Me ihmiset kannaamme mukanaan perittyjä ennakkoluuloja, jotka vaikuttavat päätöksiimme ja toimintaamme. Nämä ennakkoluulot voivat näkyä käyttäjädataan, jota hyödynnämme tekoälyjärjestelmien kouluttamisessa. Tällainen manipulointi voi toisinaan tapahtua tahattomasti. On usein vaikeaa tietoisesti tunnistaa, milloin olet tuomassa ennakkoluuloa dataan.
”Epäoikeudenmukaisuus” käsittää negatiiviset vaikutukset eli ”haitat” ryhmälle ihmisiä, esimerkiksi rodun, sukupuolen, iän tai vammaisuuden perusteella määritellyt. Keskeiset oikeudenmukaisuuteen liittyvät haitat voidaan luokitella seuraavasti:
- Jakaminen, kun esimerkiksi sukupuolta tai etnistä taustaa suositaan toisen kustannuksella.
- Palvelun laatu. Jos data on koulutettu tiettyyn tilanteeseen, mutta todellisuus on paljon monimutkaisempi, se johtaa heikosti toimivaan palveluun. Esimerkiksi käsisaippua-annostelija, joka ei näytä tunnistavan tummaihoisia ihmisiä. Lähde
- Halventaminen. Epäoikeudenmukainen arvostelu ja leimaaminen jostakin tai jostakin henkilöstä. Esimerkiksi kuvantunnistusteknologia, joka pahamaineisesti leimasi tummaihoisia kuvia gorilloiksi.
- Ylitys- tai alipainoisuus. Ajatus siitä, että tietty ryhmä ei näy tietyssä ammatissa, ja mikä tahansa palvelu tai toiminto, joka ylläpitää tätä, aiheuttaa haittoja.
- Stereotypiointi. Tietyn ryhmän yhdistäminen ennalta määrättyihin ominaisuuksiin. Esimerkiksi englannin ja turkin kielten käännösjärjestelmässä voi olla epätarkkuuksia, koska sanoilla on sukupuoleen liittyviä stereotypioita.
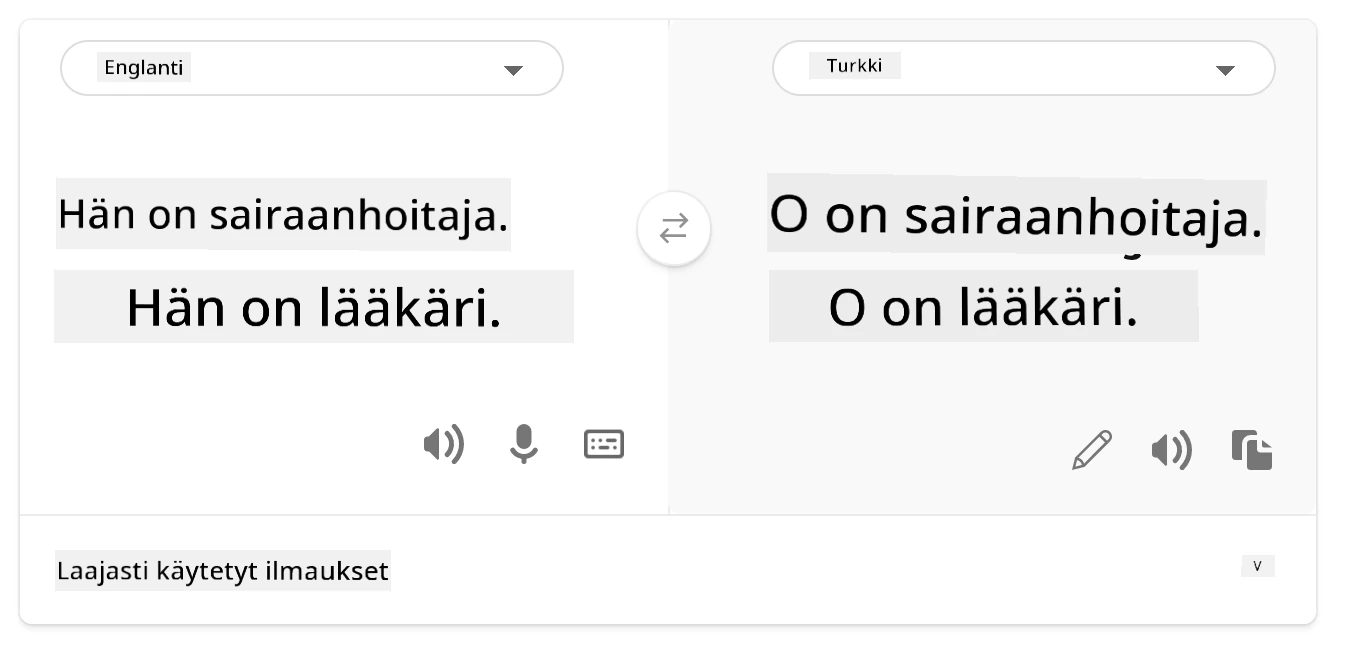
käännös turkiksi
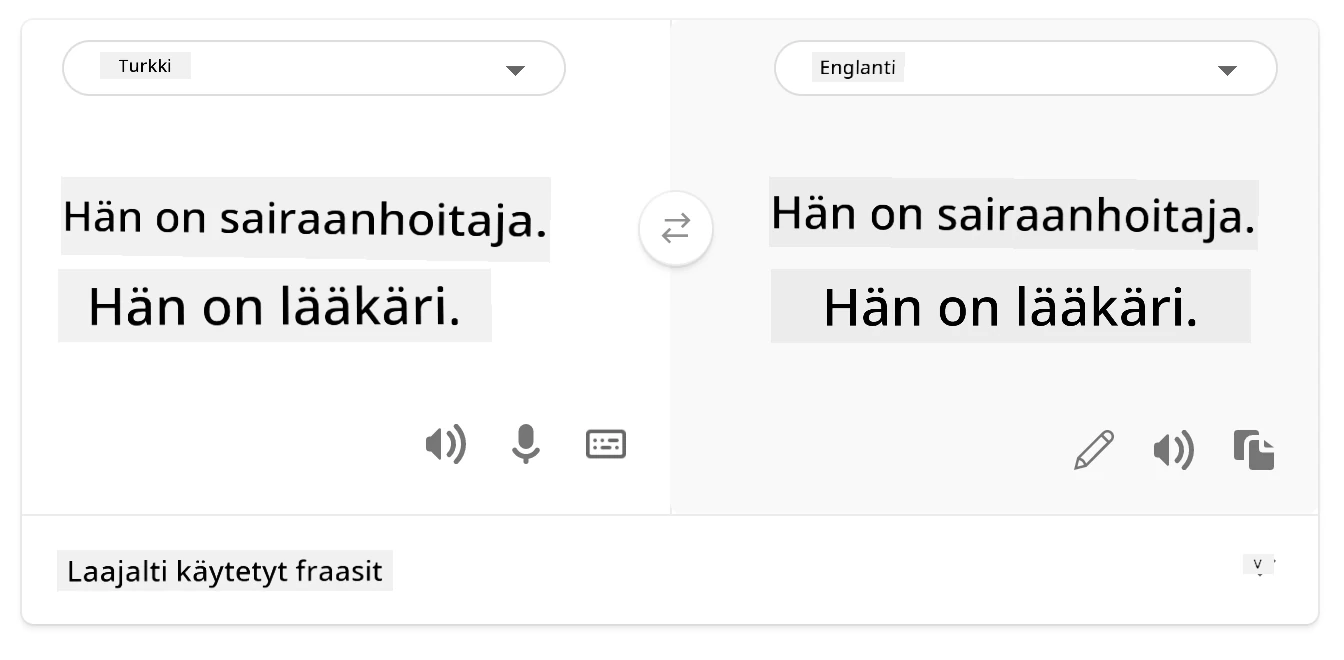
käännös takaisin englanniksi
Suunnitellessamme ja testatessamme tekoälyjärjestelmiä meidän tulee varmistaa, että tekoäly on oikeudenmukaista eikä ohjelmoitu tekemään vinoutuneita tai syrjiviä päätöksiä, joita ihmisiltäkin on kielletty tekemästä. Vastuullisuuden takaaminen tekoälyssä ja koneoppimisessa on kuitenkin monimutkainen sosiotekninen haaste.
Luotettavuus ja turvallisuus
Luottamuksen rakentamiseksi tekoälyjärjestelmien tulee olla luotettavia, turvallisia ja johdonmukaisia normaaleissa ja odottamattomissa olosuhteissa. On tärkeää tietää, miten tekoäly käyttäytyy eri tilanteissa, erityisesti poikkeustapauksissa. Rakentaessamme tekoälyratkaisuja tulee panostaa siihen, miten käsitellä laajaa kirjoa olosuhteita, joita tekoälyratkaisut kohtaavat. Esimerkiksi itseajavan auton tulee asettaa turvallisuus etusijalle. Tämän vuoksi auton tekoälyn tulee ottaa huomioon kaikki mahdolliset tilanteet, joita auto voi kohdata, kuten yö, myrskyt tai lumimyrskyt, lapset juoksemassa kadun yli, lemmikit, liikennejärjestelyt jne. Kuinka hyvin tekoälyjärjestelmä voi käsitellä laajan valikoiman olosuhteita luotettavasti ja turvallisesti heijastaa sitä, kuinka hyvin datatieteilijä tai tekoälykehittäjä on ottanut erilaiset tilanteet huomioon suunnittelun tai testauksen aikana.
🎥 Klikkaa tästä videoon: Luotettavuus ja turvallisuus tekoälyssä
Osallisuus
Tekoälyjärjestelmät tulisi suunnitella siten, että ne osallistuivat ja voimaannuttavat kaikkia. Kun tekoälyjärjestelmiä suunnittelevat ja toteuttavat datatieteilijät ja tekoälykehittäjät, heidän tulee tunnistaa ja käsitellä mahdollisia esteitä järjestelmässä, jotka voisivat tahattomasti syrjiä ihmisiä. Esimerkiksi maailmassa on miljardi vammaista ihmistä. Tekoälyn kehityksen myötä he voivat päästä helpommin käsiksi laajaan valikoimaan tietoa ja mahdollisuuksia päivittäisessä elämässään. Esteiden käsittely luo mahdollisuuksia innovoida ja kehittää tekoälytuotteita, joissa on parempia käyttökokemuksia, jotka hyödyttävät kaikkia.
Turvallisuus ja yksityisyys
Tekoälyjärjestelmien tulee olla turvallisia ja kunnioittaa ihmisten yksityisyyttä. Ihmiset luottavat vähemmän järjestelmiin, jotka asettavat heidän yksityisyytensä, tietonsa tai henkensä vaaraan. Koneoppimismalleja kouluttaessamme luotamme dataan parhaan tuloksen saamiseksi. Tässä prosessissa tulee ottaa huomioon datan alkuperä ja eheys. Esimerkiksi onko data käyttäjän lähettämää vai julkisesti saatavilla? Lisäksi on ratkaisevan tärkeää kehittää tekoälyjärjestelmiä, jotka pystyvät suojaamaan luottamuksellisia tietoja ja vastustamaan hyökkäyksiä. Kun tekoäly yleistyy, yksityisyyden suojaaminen ja tärkeiden henkilö- ja yritystietojen suojaaminen tulee yhä tärkeämmäksi ja monimutkaisemmaksi. Yksityisyyteen ja tietoturvaan liittyvät kysymykset vaativat erityistä huomiota tekoälyssä, sillä datan käyttö on oleellista tekoälyjärjestelmille, jotta ne voivat tehdä tarkkoja ja tietoon perustuvia ennusteita ja päätöksiä ihmisistä.
- Alan tasolla olemme tehneet merkittäviä edistysaskeleita yksityisyydessä ja turvallisuudessa, joita sääntelyt kuten GDPR (Yleinen tietosuoja-asetus) ovat merkittävästi edistäneet.
- Kuitenkin tekoälyjärjestelmien kohdalla meidän on tunnustettava jännite henkilökohtaisen datan tarpeen ja yksityisyyden välillä; eli että järjestelmät tarvitsevat enemmän henkilökohtaista dataa toimiakseen henkilökohtaisesti ja tehokkaasti – mutta yksityisyyttä on silti suojeltava.
- Samoin kuin internetin myötä yhdistettyjen tietokoneiden syntyessä, näemme myös suuren kasvun tekoälyyn liittyvissä tietoturvakysymyksissä.
- Samaan aikaan olemme nähneet tekoälyn käytön turvallisuuden parantamiseksi. Esimerkiksi useimmat nykyaikaiset virustorjuntaohjelmat perustuvat tekoälyn heuristiikkaan.
- Meidän on varmistettava, että datatieteen prosessimme sulautuvat saumattomasti uusimpien yksityisyys- ja tietoturvakäytäntöjen kanssa.
Läpinäkyvyys
Tekoälyjärjestelmien tulee olla ymmärrettäviä. Läpinäkyvyyden tärkeä osa on selittää tekoälyjärjestelmien ja niiden komponenttien käyttäytymistä. Tekoälyjärjestelmien parempi ymmärtäminen vaatii, että sidosryhmät ymmärtävät, miten ja miksi ne toimivat, jotta he voivat tunnistaa mahdollisia suorituskykyyn, turvallisuuteen ja yksityisyyteen liittyviä ongelmia, vinoumia, syrjiviä käytäntöjä tai ei-toivottuja tuloksia. Uskomme myös, että tekoälyjärjestelmiä käyttävien tulisi olla rehellisiä ja avoimia siitä, milloin, miksi ja miten he päättävät käyttää niitä. Sekä järjestelmien rajoituksista. Esimerkiksi, jos pankki käyttää tekoälyjärjestelmää kuluttajalainojen päätöksenteon tukena, on tärkeää tarkastella tuloksia ja ymmärtää, mikä data vaikuttaa järjestelmän suosituksiin. Hallitukset ovat alkaneet säädellä tekoälyä eri aloilla, joten datatieteilijöiden ja organisaatioiden tulee kyetä selittämään, täyttääkö tekoälyjärjestelmä sääntelyvaatimukset, erityisesti kun tulos on ei-toivottu.
- Koska tekoälyjärjestelmät ovat niin monimutkaisia, on vaikeaa ymmärtää, miten ne toimivat ja tulkita tuloksia.
- Tämä ymmärryksen puute vaikuttaa siihen, miten järjestelmiä hallitaan, käytetään tuotannossa ja dokumentoidaan.
- Tämä ymmärryksen puute vaikuttaa vielä enemmän niihin päätöksiin, joita tehdään näiden järjestelmien tuottamien tulosten perusteella.
Vastuuvelvollisuus
Ihmisten, jotka suunnittelevat ja ottavat käyttöön tekoälyjärjestelmiä, täytyy olla vastuussa siitä, miten heidän järjestelmänsä toimivat. Vastuuvelvollisuuden tarve on erityisen tärkeää herkille käyttösovelluksille, kuten kasvojentunnistukselle. Viime aikoina kasvojentunnistusteknologian kysyntä on kasvanut, erityisesti lainvalvontaviranomaisten keskuudessa, jotka näkevät teknologian potentiaalin esimerkiksi kadonneiden lasten löytämisessä. Kuitenkin näitä teknologioita voisi mahdollisesti käyttää hallitus asettamaan kansalaisten perusoikeudet vaaraan, esimerkiksi mahdollistamalla jatkuvan valvonnan tiettyjen yksilöiden osalta. Siksi datatieteilijöiden ja organisaatioiden tulee olla vastuussa siitä, miten heidän tekoälyjärjestelmänsä vaikuttaa yksilöihin ja yhteiskuntaan.

🎥 Klikkaa yllä olevaa kuvaa katsoaksesi videon: Varoituksia massavalvonnasta kasvojentunnistuksen kautta
Lopulta yksi suurimmista kysymyksistä sukupolvellemme, ensimmäiselle, joka tuo tekoälyn yhteiskuntaan, on, miten varmistamme, että tietokoneet pysyvät vastuullisina ihmisille ja miten varmistamme, että tietokoneiden suunnittelijat pysyvät vastuullisina kaikille muille.
Vaikutusten arviointi
Ennen koneoppimismallin kouluttamista on tärkeää tehdä vaikutusten arviointi ymmärtääkseen tekoälyjärjestelmän tarkoituksen; mihin se on tarkoitettu; missä sitä käytetään; ja kuka järjestelmän kanssa tulee olemaan vuorovaikutuksessa. Nämä auttavat järjestelmää arvioivia tarkastajia tai testaajia tietämään, mitä tekijöitä tulee ottaa huomioon riskien ja odotettujen seurausten tunnistamisessa.
Seuraavat ovat keskeisiä alueita vaikutusten arvioinnissa:
- Adversiiviset vaikutukset yksilöihin. On tärkeää olla tietoinen rajoituksista, vaatimuksista, tukemattomasta käytöstä tai tunnetuista rajoitteista, jotka voivat haitata järjestelmän suorituskykyä, jotta järjestelmää ei käytettäisi tavalla, joka voisi aiheuttaa haittaa yksilöille.
- Datan vaatimukset. Ymmärtäminen, miten ja missä järjestelmä käyttää dataa, antaa arvioijille mahdollisuuden harkita mahdollisia datavaatimuksia (esim. GDPR- tai HIPAA-tietosäädökset). Lisäksi on tarkasteltava, onko datan lähde tai määrä riittävä koulutukseen.
- Vaikutusten yhteenveto. Kerää luettelo mahdollisista haitoista, jotka voivat syntyä järjestelmän käytöstä. Koneoppimisen elinkaaren aikana tarkastetaan, onko tunnistetut ongelmat lievennetty tai käsitelty.
- Sovellettavat tavoitteet kaikille kuudelle ydinperiaatteelle. Arvioidaan, onko periaatteiden tavoitteet saavutettu ja onko aukkoja.
Virheiden etsiminen vastuullisella tekoälyllä
Samoin kuin ohjelmistosovelluksen virheiden etsiminen, myös tekoälyjärjestelmän virheiden etsiminen on välttämätön prosessi järjestelmän ongelmien tunnistamiseksi ja ratkaisemiseksi. On monia tekijöitä, jotka voivat vaikuttaa mallin odottamattomaan tai vastuuttomaan toimintaan. Useimmat perinteiset mallin suorituskykymittarit antavat määrällisen yhteenvedon mallin suorituskyvystä, mutta ne eivät riitä analysoimaan, miten malli rikkoo vastuullisen tekoälyn periaatteita. Lisäksi koneoppimismalli on musta laatikko, mikä vaikeuttaa ymmärtämistä, mikä ohjaa sen tulosta tai selityksen antamista virheen tapahtuessa. Myöhemmin tässä kurssissa opimme käyttämään Responsible AI -hallintapaneelia auttamaan tekoälyjärjestelmien virheiden etsimisessä. Hallintapaneeli tarjoaa kokonaisvaltaisen työkalun datatieteilijöille ja tekoälykehittäjille suorittaa:
- Virheanalyysi. Virheen jakautumisen tunnistamiseksi, mikä voi vaikuttaa järjestelmän oikeudenmukaisuuteen tai luotettavuuteen.
- Mallin yleiskatsaus. Löytää mallin suorituskyvyn eroja eri dataryhmien välillä.
- Datan analyysi. Ymmärtää datan jakautuminen ja tunnistaa mahdolliset vinoumat datassa, jotka voisivat johtaa oikeudenmukaisuuden, osallistavuuden ja luotettavuuden ongelmiin.
- Mallin tulkittavuus. Ymmärtää, mikä vaikuttaa tai ohjaa mallin ennusteita. Tämä auttaa selittämään mallin käyttäytymistä, mikä on tärkeää läpinäkyvyyden ja vastuuvelvollisuuden kannalta.
🚀 Haaste
Haittojen ehkäisemiseksi jo lähtökohtaisesti meidän tulisi:
- työllistää erilaisia taustoja ja näkökulmia omaavia ihmisiä järjestelmien parissa työskentelevien joukossa
- panostaa aineistoihin, jotka kuvastavat yhteiskuntamme monimuotoisuutta
- kehittää parempia menetelmiä koneoppimisen elinkaaren eri vaiheissa vastuuttoman tekoälyn havaitsemiseksi ja korjaamiseksi
Mieti todellisia tilanteita, joissa mallin epäluotettavuus ilmenee mallin rakentamisessa ja käytössä. Mitä muuta meidän pitäisi huomioida?
Jälkikoe
Kertaus ja itsenäinen opiskelu
Tässä oppitunnissa olet oppinut koneoppimisen oikeudenmukaisuuden ja epäoikeudenmukaisuuden peruskäsitteitä.
Katso tämä työpaja syventääksesi aiheita:
- Responsible AI:n tavoitteena: Periaatteiden vieminen käytäntöön, esittäjinä Besmira Nushi, Mehrnoosh Sameki ja Amit Sharma

🎥 Klikkaa yllä olevaa kuvaa nähdäksesi videon: RAI Toolbox: Avoimen lähdekoodin kehys vastuullisen tekoälyn rakentamiseen esittäjinä Besmira Nushi, Mehrnoosh Sameki ja Amit Sharma
Lue myös:
-
Microsoftin RAI-resurssikeskus: Responsible AI Resources – Microsoft AI
-
Microsoftin FATE-tutkimusryhmä: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Lue Azure Machine Learningin työkaluista oikeudenmukaisuuden varmistamiseen:
Tehtävä
Vastuuvapauslauseke: Tämä asiakirja on käännetty käyttämällä tekoälypohjaista käännöspalvelua Co-op Translator. Vaikka pyrimme tarkkuuteen, otathan huomioon, että automaattiset käännökset saattavat sisältää virheitä tai epätarkkuuksia. Alkuperäinen asiakirja sen alkuperäiskielellä on virallinen lähde. Tärkeissä asioissa suositellaan ammattimaista ihmiskäännöstä. Emme ole vastuussa tämän käännöksen käytöstä aiheutuvista väärinymmärryksistä tai tulkinnoista.