
 localizeflow[bot]
69605c1e65 |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Aufbau von Machine Learning-Lösungen mit verantwortungsvoller KI

Sketchnote von Tomomi Imura
Quiz vor der Vorlesung
Einführung
In diesem Lehrplan werden Sie entdecken, wie Machine Learning unser tägliches Leben beeinflussen kann und bereits beeinflusst. Schon jetzt sind Systeme und Modelle an täglichen Entscheidungsprozessen beteiligt, wie etwa bei medizinischen Diagnosen, Kreditentscheidungen oder der Betrugserkennung. Daher ist es wichtig, dass diese Modelle zuverlässig funktionieren und vertrauenswürdige Ergebnisse liefern. Wie bei jeder Softwareanwendung kann es auch bei KI-Systemen vorkommen, dass sie Erwartungen nicht erfüllen oder unerwünschte Ergebnisse liefern. Deshalb ist es essenziell, das Verhalten eines KI-Modells verstehen und erklären zu können.
Stellen Sie sich vor, was passieren kann, wenn die Daten, die Sie zum Erstellen dieser Modelle verwenden, bestimmte demografische Gruppen wie Rasse, Geschlecht, politische Ansicht, Religion nicht enthalten oder diese unverhältnismäßig vertreten. Was passiert, wenn die Ausgabe des Modells dahingehend interpretiert wird, eine bestimmte demografische Gruppe zu bevorzugen? Welche Konsequenzen hat das für die Anwendung? Außerdem, was passiert, wenn das Modell ein unerwünschtes Ergebnis zeigt und Menschen schadet? Wer ist verantwortlich für das Verhalten der KI-Systeme? Diese Fragen werden wir in diesem Lehrplan untersuchen.
In dieser Lektion werden Sie:
- Ihr Bewusstsein für die Bedeutung von Fairness im Machine Learning und die damit verbundenen Schäden schärfen.
- Mit der Praxis vertraut werden, Ausreißer und ungewöhnliche Szenarien zu erkunden, um Zuverlässigkeit und Sicherheit zu gewährleisten.
- Ein Verständnis dafür erlangen, warum es wichtig ist, durch inklusives Design alle Menschen zu befähigen.
- Erkunden, wie wichtig es ist, den Datenschutz und die Sicherheit von Daten und Menschen zu schützen.
- Die Bedeutung eines Transparenzansatzes (Glasbox) zur Erklärung des Verhaltens von KI-Modellen erkennen.
- Sich bewusst sein, wie essenziell Verantwortlichkeit ist, um Vertrauen in KI-Systeme zu schaffen.
Voraussetzungen
Als Voraussetzung absolvieren Sie bitte den Lernpfad „Responsible AI Principles“ und sehen Sie sich das untenstehende Video zum Thema an:
Erfahren Sie mehr über Responsible AI durch das Folgen dieses Lernpfads

🎥 Klicken Sie auf das obere Bild für ein Video: Microsofts Ansatz zu Responsible AI
Fairness
KI-Systeme sollten alle Menschen fair behandeln und vermeiden, ähnliche Menschengruppen unterschiedlich zu beeinflussen. Zum Beispiel sollten KI-Systeme, die Empfehlungen für medizinische Behandlungen, Kreditanträge oder Beschäftigung geben, allen mit ähnlichen Symptomen, finanziellen Verhältnissen oder beruflichen Qualifikationen dieselben Empfehlungen geben. Jeder von uns trägt vererbte Vorurteile in sich, die unsere Entscheidungen und Handlungen beeinflussen. Diese Vorurteile können in den Daten sichtbar sein, die zur Schulung von KI-Systemen verwendet werden. Solche Manipulationen können manchmal unbeabsichtigt geschehen. Es ist oft schwierig bewusst zu wissen, wann man Verzerrungen in Daten einführt.
„Unfairness“ umfasst negative Auswirkungen oder „Schäden“ für eine Gruppe von Menschen, etwa definiert nach Rasse, Geschlecht, Alter oder Behinderungsstatus. Die wichtigsten fairnesbezogenen Schäden können wie folgt klassifiziert werden:
- Zuweisung, wenn z.B. ein Geschlecht oder eine Ethnie gegenüber einer anderen bevorzugt wird.
- Dienstleistungsqualität. Wenn man die Daten nur für ein bestimmtes Szenario trainiert, die Realität aber viel komplexer ist, führt das zu einer schlecht funktionierenden Dienstleistung. Zum Beispiel ein Seifenspender, der scheinbar Menschen mit dunkler Hautfarbe nicht erkennen konnte. Referenz
- Abwertung. Ungerechtfertigte Kritik und Etikettierung von etwas oder jemandem. Beispielsweise wurde eine Bildkennungstechnologie berüchtigt dafür, Bilder dunkler Hautfarbe fälschlicherweise als Gorillas zu kennzeichnen.
- Über- oder Unterrepräsentation. Die Vorstellung, dass eine bestimmte Gruppe in einem Beruf nicht vertreten ist, und jeder Dienst oder jede Funktion, die das fördert, trägt zur Schädigung bei.
- Stereotypisierung. Eine bestimmte Gruppe mit vorgegebenen Attributen assoziieren. Zum Beispiel kann ein Sprachübersetzungssystem zwischen Englisch und Türkisch Ungenauigkeiten aufweisen aufgrund von Worten mit stereotypischer Geschlechtszuordnung.
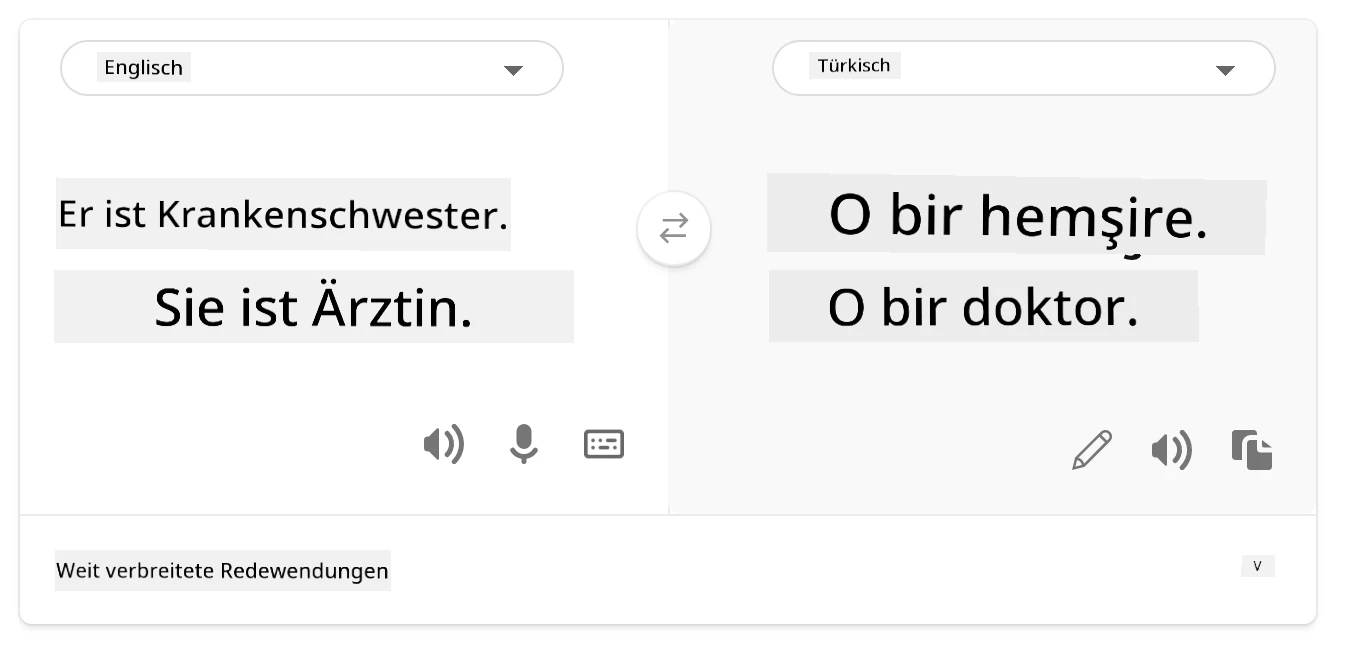
Übersetzung ins Türkische
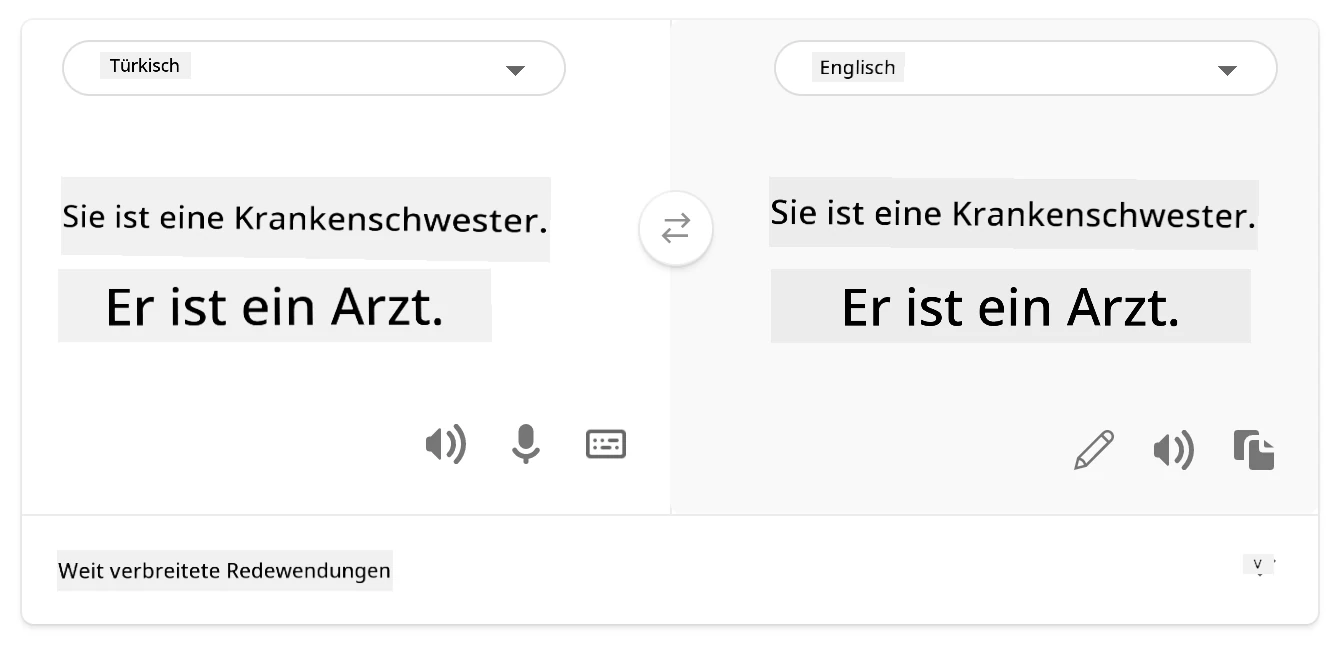
Rückübersetzung ins Englische
Beim Design und Test von KI-Systemen müssen wir sicherstellen, dass KI fair ist und nicht programmiert wird, voreingenommene oder diskriminierende Entscheidungen zu treffen, die Menschen ebenfalls nicht treffen dürfen. Fairness in KI und Machine Learning zu gewährleisten, bleibt eine komplexe soziotechnische Herausforderung.
Zuverlässigkeit und Sicherheit
Um Vertrauen aufzubauen, müssen KI-Systeme zuverlässig, sicher und konsistent unter normalen und unerwarteten Bedingungen arbeiten. Es ist wichtig zu wissen, wie KI-Systeme sich in verschiedenen Situationen verhalten, besonders bei Ausreißern. Beim Aufbau von KI-Lösungen muss viel Augenmerk darauf liegen, wie mit einer Vielzahl von Situationen umgegangen wird, denen KI-Lösungen begegnen könnten. Zum Beispiel muss ein autonom fahrendes Auto die Sicherheit der Menschen oberste Priorität geben. Daher muss die KI, die das Auto steuert, alle möglichen Szenarien berücksichtigen, denen das Auto begegnen könnte, wie Nacht, Gewitter oder Schneestürme, Kinder, die auf die Straße laufen, Haustiere, Straßenarbeiten etc. Wie gut ein KI-System einen großen Bereich an Bedingungen zuverlässig und sicher bewältigen kann, spiegelt den Grad der Voraussicht wider, den der Datenwissenschaftler oder KI-Entwickler während der Entwurfs- oder Testphase des Systems berücksichtigt hat.
🎥 Klicken Sie hier für ein Video: Zuverlässigkeit und Sicherheit in KI
Inklusivität
KI-Systeme sollten so gestaltet sein, dass sie alle Menschen einbinden und befähigen. Beim Entwerfen und Implementieren von KI-Systemen identifizieren und beheben Datenwissenschaftler und KI-Entwickler potenzielle Barrieren im System, die Menschen unbeabsichtigt ausschließen könnten. Zum Beispiel gibt es weltweit 1 Milliarde Menschen mit Behinderungen. Mit dem Fortschritt der KI können sie in ihrem Alltag leichter auf eine Vielzahl von Informationen und Möglichkeiten zugreifen. Durch das Überwinden von Barrieren entstehen Chancen, KI-Produkte mit besseren Erfahrungen zu innovieren und zu entwickeln, die allen zugutekommen.
Sicherheit und Datenschutz
KI-Systeme sollten sicher sein und die Privatsphäre der Menschen respektieren. Menschen haben weniger Vertrauen in Systeme, die ihre Privatsphäre, Informationen oder Leben gefährden. Beim Trainieren von Machine Learning-Modellen verlassen wir uns auf Daten, um die besten Ergebnisse zu erzielen. Dabei müssen Herkunft und Integrität der Daten berücksichtigt werden. Zum Beispiel: Wurden die Daten vom Nutzer bereitgestellt oder sind sie öffentlich zugänglich? Während der Arbeit mit Daten ist es entscheidend, KI-Systeme zu entwickeln, die vertrauliche Informationen schützen und Angriffen widerstehen können. Mit der zunehmenden Verbreitung von KI wird der Schutz der Privatsphäre und Sicherung wichtiger persönlicher und geschäftlicher Informationen immer kritischer und komplexer. Datenschutz- und Datensicherheitsfragen erfordern besondere Aufmerksamkeit bei KI, da der Zugriff auf Daten unerlässlich ist, damit KI-Systeme genaue und fundierte Vorhersagen und Entscheidungen über Menschen treffen können.
- Als Branche haben wir bedeutende Fortschritte im Bereich Datenschutz & Sicherheit gemacht, stark angetrieben durch Regelungen wie die DSGVO (Datenschutz-Grundverordnung).
- Dennoch müssen wir bei KI-Systemen die Spannung zwischen dem Bedarf an mehr persönlichen Daten, um Systeme persönlicher und wirksamer zu machen, und dem Datenschutz anerkennen.
- Wie beim Aufkommen vernetzter Computer mit dem Internet sehen wir auch einen starken Anstieg der Sicherheitsprobleme im Zusammenhang mit KI.
- Gleichzeitig wird KI auch genutzt, um die Sicherheit zu verbessern. Zum Beispiel werden heute die meisten modernen Antivirenscanner von KI-Heuristiken gesteuert.
- Wir müssen sicherstellen, dass unsere Data Science-Prozesse harmonisch mit den neuesten Datenschutz- und Sicherheitspraktiken verbunden sind.
Transparenz
KI-Systeme sollten verständlich sein. Ein wesentlicher Teil der Transparenz ist die Erklärung des Verhaltens von KI-Systemen und ihrer Komponenten. Das Verständnis von KI-Systemen zu verbessern, erfordert, dass alle Beteiligten nachvollziehen, wie und warum diese funktionieren, damit sie mögliche Leistungsprobleme, Sicherheits- und Datenschutzbedenken, Verzerrungen, Ausschlusspraktiken oder unbeabsichtigte Ergebnisse erkennen können. Wir sind auch der Ansicht, dass diejenigen, die KI-Systeme nutzen, ehrlich und offen darlegen sollten, wann, warum und wie sie diese einsetzen sowie die Einschränkungen der Systeme, die sie verwenden. Zum Beispiel ist es für eine Bank, die ein KI-System zur Unterstützung ihrer Kreditentscheidungen verwendet, wichtig, die Ergebnisse zu überprüfen und zu verstehen, welche Daten die Empfehlungen des Systems beeinflussen. Regierungen beginnen, KI in verschiedenen Branchen zu regulieren, daher müssen Datenwissenschaftler und Organisationen erklären, ob ein KI-System die regulatorischen Anforderungen erfüllt, besonders wenn es zu unerwünschten Ergebnissen kommt.
- Da KI-Systeme so komplex sind, ist es schwierig zu verstehen, wie sie funktionieren und Ergebnisse zu interpretieren.
- Dieses mangelnde Verständnis wirkt sich auf die Art und Weise aus, wie diese Systeme verwaltet, operationalisiert und dokumentiert werden.
- Noch wichtiger beeinflusst dieses mangelnde Verständnis die Entscheidungen, die auf Grundlage der von diesen Systemen erzeugten Ergebnisse getroffen werden.
Verantwortlichkeit
Die Personen, die KI-Systeme entwerfen und einsetzen, müssen für deren Funktionsweise verantwortlich sein. Die Notwendigkeit für Verantwortlichkeit ist besonders wichtig bei sensiblen Technologien wie Gesichtserkennung. In letzter Zeit steigt die Nachfrage nach Gesichtserkennungstechnologie, insbesondere von Strafverfolgungsbehörden, die das Potenzial der Technologie bei der Suche nach vermissten Kindern sehen. Diese Technologien könnten jedoch potenziell von Regierungen genutzt werden, um die Grundfreiheiten ihrer Bürger zu gefährden, beispielsweise durch die Ermöglichung der ständigen Überwachung bestimmter Personen. Daher müssen Datenwissenschaftler und Organisationen verantwortlich dafür sein, wie ihr KI-System Einzelpersonen oder die Gesellschaft beeinflusst.

🎥 Klicken Sie auf das Bild oben für ein Video: Warnungen vor Massenüberwachung durch Gesichtserkennung
Letztendlich ist eine der größten Fragen für unsere Generation, als erste Generation, die KI in die Gesellschaft bringt, wie sichergestellt werden kann, dass Computer gegenüber Menschen rechenschaftspflichtig bleiben und dass die Menschen, die Computer entwerfen, gegenüber allen anderen rechenschaftspflichtig bleiben.
Auswirkungen abschätzen
Bevor ein Machine Learning-Modell trainiert wird, ist es wichtig, eine Bewertung der Auswirkungen durchzuführen, um den Zweck des KI-Systems zu verstehen; wie es verwendet werden soll; wo es eingesetzt wird; und wer mit dem System interagieren wird. Dies hilft Prüfern oder Testern bei der Evaluierung, welche Faktoren bei der Identifizierung potenzieller Risiken und erwarteter Konsequenzen zu berücksichtigen sind.
Folgende Schwerpunkte sind bei der Durchführung einer Auswirkungenbewertung zu beachten:
- Nachteilige Auswirkungen auf Einzelpersonen. Bewusstsein für jegliche Einschränkungen oder Anforderungen, unzulässige Verwendung oder bekannte Einschränkungen, die die Leistung des Systems beeinträchtigen, ist entscheidend, um zu gewährleisten, dass das System nicht auf eine Weise genutzt wird, die Einzelpersonen schadet.
- Datenanforderungen. Das Verständnis, wie und wo das System Daten verwendet, ermöglicht es Prüfern, potenzielle Datenanforderungen (z. B. DSGVO- oder HIPAA-Vorschriften) zu berücksichtigen. Außerdem sollte geprüft werden, ob die Datenquelle oder -menge für das Training ausreichend ist.
- Zusammenfassung der Auswirkungen. Erstellen Sie eine Liste potenzieller Schäden, die durch die Nutzung des Systems entstehen könnten. Im Verlauf des ML-Lebenszyklus sollte geprüft werden, ob die identifizierten Probleme abgeschwächt oder behoben werden.
- Anwendbare Ziele für jedes der sechs Kernprinzipien. Bewerten Sie, ob die Ziele jedes Prinzips erfüllt sind und ob es Lücken gibt.
Debugging mit verantwortungsvoller KI
Ähnlich wie beim Debuggen einer Softwareanwendung ist das Debuggen eines KI-Systems ein notwendiger Prozess, um Probleme im System zu identifizieren und zu lösen. Es gibt viele Faktoren, die dazu führen können, dass ein Modell nicht wie erwartet oder verantwortungsvoll arbeitet. Die meisten herkömmlichen Modell-Performance-Metriken sind quantitative Gesamtwerte der Modellleistung, die nicht ausreichen, um zu analysieren, wie ein Modell die Grundsätze verantwortungsvoller KI verletzt. Darüber hinaus ist ein Machine Learning-Modell eine Blackbox, was es erschwert zu verstehen, was sein Ergebnis antreibt oder eine Erklärung zu liefern, wenn ein Fehler gemacht wird. Später in diesem Kurs lernen wir, wie man das Responsible AI Dashboard verwendet, um KI-Systeme zu debuggen. Das Dashboard bietet ein ganzheitliches Tool für Datenwissenschaftler und KI-Entwickler, um:
- Fehleranalyse. Um die Fehlerverteilung des Modells zu identifizieren, die die Fairness oder Zuverlässigkeit des Systems beeinflussen kann.
- Modellübersicht. Um zu erkennen, wo es Unterschiede in der Modellleistung über verschiedene Datengruppen gibt.
- Datenanalyse. Um die Datenverteilung zu verstehen und potenzielle Verzerrungen in den Daten zu identifizieren, die zu Problemen in Fairness, Inklusivität und Zuverlässigkeit führen können.
- Modellinterpretierbarkeit. Um zu verstehen, was die Vorhersagen des Modells beeinflusst. Dies hilft beim Erklären des Modellverhaltens, was für Transparenz und Verantwortlichkeit wichtig ist.
🚀 Herausforderung
Um Schäden von Anfang an zu vermeiden, sollten wir:
- eine Vielfalt an Hintergründen und Perspektiven unter den Menschen, die an Systemen arbeiten, haben
- in Datensätze investieren, die die Vielfalt unserer Gesellschaft widerspiegeln
- bessere Methoden im gesamten Machine Learning-Lebenszyklus entwickeln, um unverantwortliche KI zu erkennen und zu korrigieren, wenn sie auftritt
Denken Sie über reale Szenarien nach, bei denen die Unzuverlässigkeit eines Modells beim Aufbau und Gebrauch des Modells offensichtlich wird. Was sollten wir sonst noch berücksichtigen?
Quiz nach der Vorlesung
Rückblick & Selbststudium
In dieser Lektion haben Sie einige Grundlagen zu den Konzepten von Fairness und Unfairness im Machine Learning gelernt.
Sehen Sie sich diesen Workshop an, um tiefer in die Themen einzutauchen:
- Auf der Suche nach verantwortungsvoller KI: Prinzipien in der Praxis umsetzen von Besmira Nushi, Mehrnoosh Sameki und Amit Sharma

🎥 Klicken Sie auf das Bild oben für ein Video: RAI Toolbox: Ein Open-Source-Framework für verantwortungsbewusste KI von Besmira Nushi, Mehrnoosh Sameki und Amit Sharma
Lesen Sie auch:
-
Microsofts RAI-Ressourcenzentrum: Responsible AI Resources – Microsoft AI
-
Microsofts FATE-Forschungsgruppe: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Lesen Sie über die Tools von Azure Machine Learning, um Fairness sicherzustellen:
Aufgabe
Haftungsausschluss: Dieses Dokument wurde mit dem KI-Übersetzungsdienst Co-op Translator übersetzt. Obwohl wir uns um Genauigkeit bemühen, beachten Sie bitte, dass automatisierte Übersetzungen Fehler oder Ungenauigkeiten enthalten können. Das Originaldokument in seiner Ursprungssprache gilt als maßgebliche Quelle. Bei kritischen Informationen wird eine professionelle menschliche Übersetzung empfohlen. Wir übernehmen keine Haftung für Missverständnisse oder Fehlinterpretationen, die aus der Verwendung dieser Übersetzung entstehen.