
 localizeflow[bot]
14f5ba5f5c |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Opbygning af maskinlæringsløsninger med ansvarlig AI

Sketchnote af Tomomi Imura
Quiz før forelæsning
Introduktion
I dette kursus vil du begynde at opdage, hvordan maskinlæring kan og gør indflydelse på vores hverdag. Selv nu er systemer og modeller involveret i daglige beslutningstagning, såsom sundhedsdiagnoser, lånegodkendelser eller opdagelse af bedrageri. Derfor er det vigtigt, at disse modeller fungerer godt for at levere resultater, der er troværdige. Ligesom med enhver softwareapplikation vil AI-systemer kunne skuffe forventninger eller have et uønsket resultat. Derfor er det essentielt at kunne forstå og forklare adfærden hos en AI-model.
Forestil dig, hvad der kan ske, når de data, du bruger til at bygge disse modeller, mangler visse demografiske grupper, såsom race, køn, politisk holdning, religion, eller skævt repræsenterer sådanne grupper. Hvad sker der, når modellens output fortolkes til at favorisere en bestemt demografisk gruppe? Hvad er konsekvensen for applikationen? Desuden, hvad sker der, når modellen har et negativt resultat og skader mennesker? Hvem er ansvarlig for AI-systemets adfærd? Dette er nogle af de spørgsmål, vi vil udforske i dette kursus.
I denne lektion vil du:
- Øge din bevidsthed om vigtigheden af retfærdighed i maskinlæring og skader relateret til uretfærdighed.
- Blive fortrolig med praksissen at undersøge outliers og usædvanlige scenarier for at sikre pålidelighed og sikkerhed.
- Få forståelse for behovet for at styrke alle ved at designe inkluderende systemer.
- Undersøge hvor vigtigt det er at beskytte dataprivatliv og sikkerhed for både data og mennesker.
- Se vigtigheden af en gennemsigtig tilgang til at forklare AI-modellers adfærd.
- Være opmærksom på, hvordan ansvarlighed er essentiel for at opbygge tillid til AI-systemer.
Forudsætning
Som forudsætning, tag venligst "Principper for ansvarlig AI" Learn Path og se videoen nedenfor om emnet:
Lær mere om ansvarlig AI ved at følge denne Learning Path

🎥 Klik på billedet ovenfor for en video: Microsofts tilgang til ansvarlig AI
Retfærdighed
AI-systemer skal behandle alle retfærdigt og undgå at påvirke lignende grupper af mennesker forskelligt. For eksempel, når AI-systemer giver vejledning om medicinsk behandling, låneansøgninger eller beskæftigelse, skal de give de samme anbefalinger til alle med lignende symptomer, økonomiske forhold eller faglige kvalifikationer. Hver af os som mennesker bærer arvede bias, der påvirker vores beslutninger og handlinger. Disse bias kan være synlige i de data, vi bruger til at træne AI-systemerne. Denne manipulation kan nogle gange ske utilsigtet. Det er ofte svært bevidst at vide, hvornår man introducerer bias i data.
"Uretfærdighed" omfatter negative påvirkninger eller "skader" for en gruppe mennesker, såsom dem defineret ved race, køn, alder eller handicapstatus. De vigtigste fairness-relaterede skader kan klassificeres som:
- Tildeling, hvis eksempelvis et køn eller en etnicitet favoriseres over en anden.
- Servicekvalitet. Hvis du træner data for et bestemt scenarie, men virkeligheden er meget mere kompleks, fører det til en dårligt fungerende service. For eksempel en håndsæbedispenser, der tilsyneladende ikke kan registrere personer med mørk hud. Reference
- Nedværdigelse. At uretfærdigt kritisere og mærke noget eller nogen. For eksempel blev billedgenkendelsesteknologi berygtet for at fejllabels mørkhudede personer som gorillaer.
- Over- eller underrepræsentation. Ideen er, at en bestemt gruppe ikke ses i et bestemt erhverv, og enhver service eller funktion, der fortsat fremmer det, bidrager til skade.
- Stereotypisering. At forbinde en given gruppe med forudbestemte egenskaber. For eksempel kan et sprogområdigelsessystem mellem engelsk og tyrkisk have unøjagtigheder på grund af ord med stereotype tilknytninger til køn.
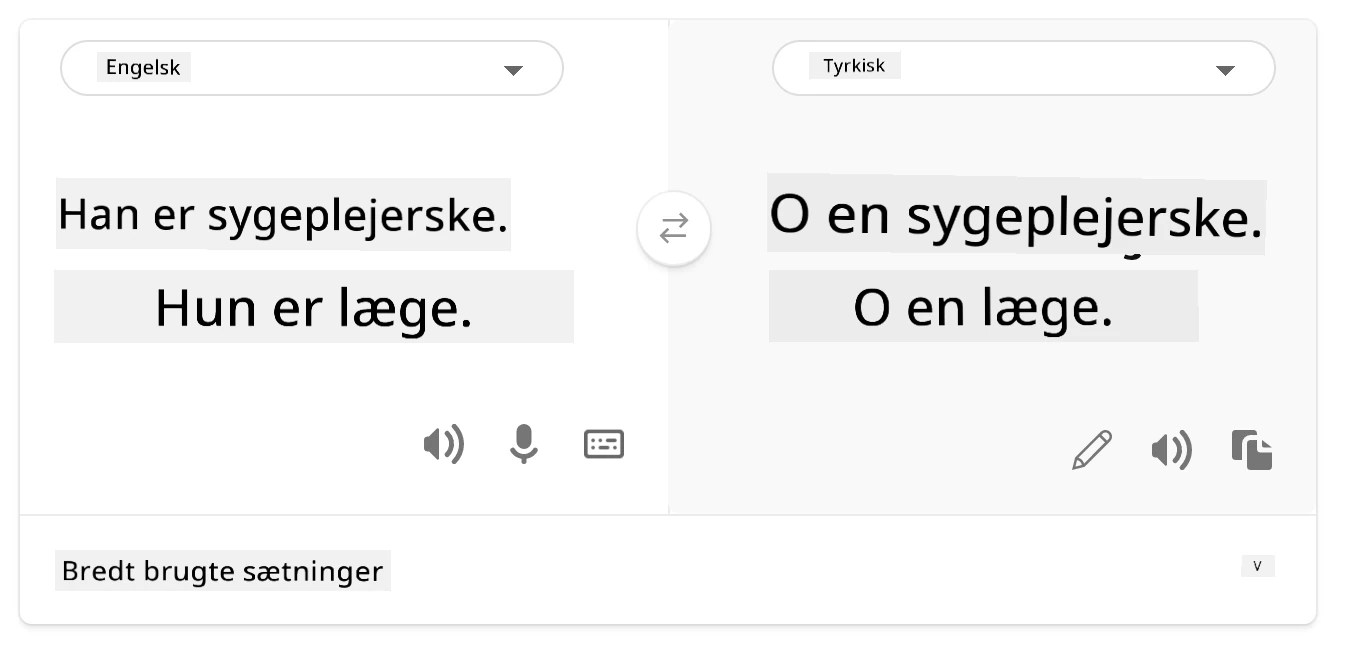
oversættelse til tyrkisk
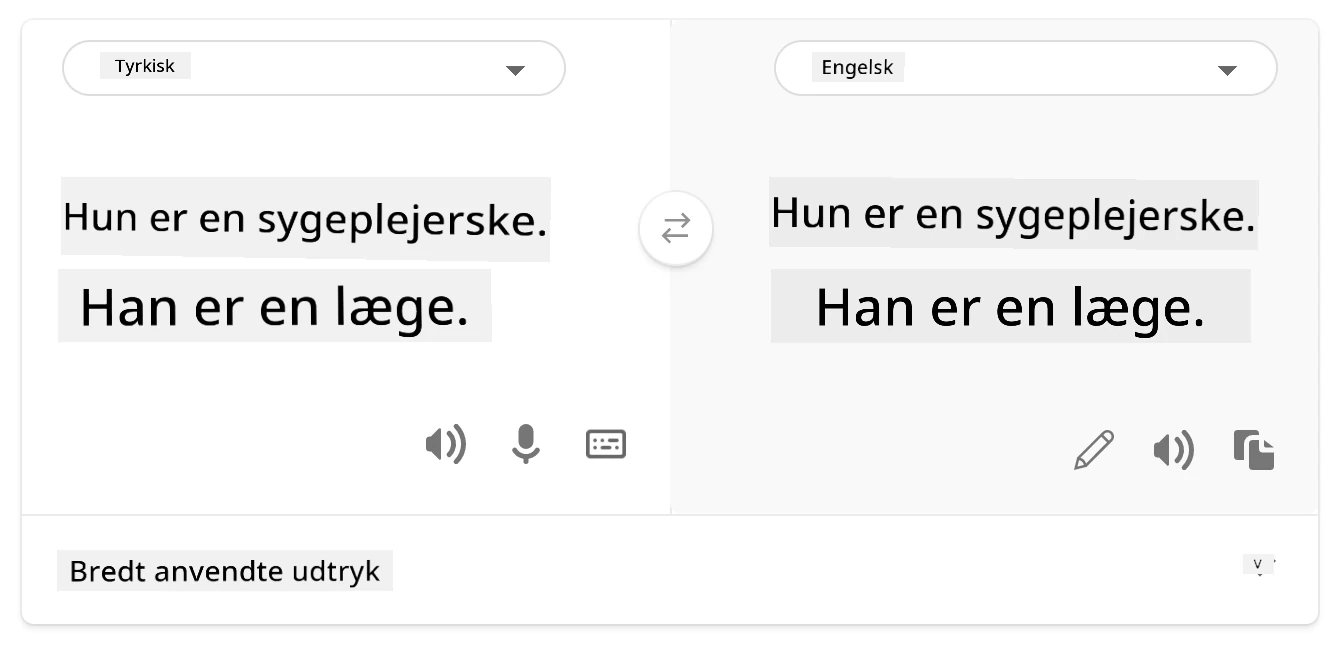
oversættelse tilbage til engelsk
Når man designer og tester AI-systemer, skal man sikre, at AI er retfærdig og ikke programmeret til at træffe biasede eller diskriminerende beslutninger, som mennesker også er forbudt at tage. At sikre retfærdighed i AI og maskinlæring er en kompleks socio-teknisk udfordring.
Pålidelighed og sikkerhed
For at opbygge tillid skal AI-systemer være pålidelige, sikre og konsistente under normale og uventede forhold. Det er vigtigt at kende AI-systemers opførsel i forskellige situationer, især når der er outliers. Når man opbygger AI-løsninger, skal der lægges stor vægt på at håndtere mange forskellige forhold, som AI-løsningerne kan møde. For eksempel skal en selvkørende bil have folks sikkerhed som højeste prioritet. Derfor skal AI’en bag bilen overveje alle mulige scenarier, som bilen kan støde på, såsom nat, tordenvejr eller snevejr, børn der løber over gaden, kæledyr, vejarbejde osv. Hvor godt et AI-system kan håndtere et bredt udvalg af forhold pålideligt og sikkert, afspejler det niveau af forudseenhed, som datavidenskabsmanden eller AI-udvikleren har haft i design- eller testfasen af systemet.
Inklusion
AI-systemer bør designes til at engagere og styrke alle. Ved design og implementering af AI-systemer identificerer datavidenskabsfolk og AI-udviklere potentielle barrierer i systemet, som utilsigtet kunne udelukke mennesker. For eksempel er der 1 milliard mennesker med handicap verden over. Med AI’s fremskridt kan de nemmere få adgang til en bred vifte af informationer og muligheder i deres daglige liv. Ved at adressere barriererne skabes muligheder for innovation og udvikling af AI-produkter med bedre oplevelser, der gavner alle.
Sikkerhed og privatliv
AI-systemer skal være sikre og respektere folks privatliv. Folk har mindre tillid til systemer, som bringer deres privatliv, informationer eller liv i fare. Når vi træner maskinlæringsmodeller, er vi afhængige af data for at opnå de bedste resultater. I den forbindelse skal datakildens oprindelse og integritet overvejes. For eksempel: Var dataene brugergenererede eller offentligt tilgængelige? Dernæst er det afgørende at udvikle AI-systemer, som kan beskytte fortrolige oplysninger og modstå angreb, mens man arbejder med dataene. Efterhånden som AI bliver mere udbredt, bliver beskyttelse af privatliv og sikring af vigtige personlige og forretningsmæssige oplysninger mere kritisk og komplekst. Spørgsmål om privatliv og datasikkerhed kræver særlig opmærksomhed i AI, fordi adgang til data er afgørende for, at AI-systemer kan lave præcise og informerede forudsigelser og beslutninger om mennesker.
- Som branche har vi gjort betydelige fremskridt inden for privatliv og sikkerhed, stærkt drevet af reguleringer som GDPR (Generel Databeskyttelsesforordning).
- Alligevel må vi med AI-systemer anerkende spændingen mellem behovet for mere personlige data til at gøre systemerne mere personlige og effektive – og privatliv.
- Ligesom ved internetts fødsel med forbundne computere ser vi også en stor stigning i antallet af sikkerhedsproblemer relateret til AI.
- Samtidig har vi set AI blive brugt til at forbedre sikkerhed. For eksempel drives de fleste moderne antivirus-scannere i dag af AI-heuristikker.
- Vi skal sikre, at vores Data Science-processer blander sig harmonisk med de seneste privatlivs- og sikkerhedspraksisser.
Gennemsigtighed
AI-systemer skal være forståelige. En central del af gennemsigtighed er at forklare AI-systemers og deres komponenters adfærd. Forbedring af forståelsen kræver, at interessenter forstår hvordan og hvorfor de fungerer, så de kan identificere potentielle problemer med ydelse, sikkerheds- og privatlivsbekymringer, bias, ekskluderende praksisser eller utilsigtede resultater. Vi mener også, at dem, der bruger AI-systemer, bør være ærlige og åbenhjertige om hvornår, hvorfor og hvordan de vælger at implementere dem. Samt om systemernes begrænsninger. For eksempel, hvis en bank bruger et AI-system til at understøtte sine lånebeslutninger, er det vigtigt at undersøge resultaterne og forstå, hvilke data der påvirker systemets anbefalinger. Regeringer begynder at regulere AI på tværs af brancher, så datavidenskabsfolk og organisationer må forklare, om et AI-system opfylder regulatoriske krav, især når der er et uønsket resultat.
- Fordi AI-systemer er så komplekse, er det svært at forstå, hvordan de fungerer, og at fortolke resultaterne.
- Denne manglende forståelse påvirker måden, disse systemer styres, operationaliseres og dokumenteres på.
- Denne manglende forståelse påvirker vigtigere beslutninger, der træffes baseret på resultaterne fra disse systemer.
Ansvarlighed
De personer, der designer og implementerer AI-systemer, skal holdes ansvarlige for, hvordan deres systemer opererer. Behovet for ansvarlighed er særligt vigtigt ved følsomme brugsteknologier som ansigtsgenkendelse. For nylig har der været en stigende efterspørgsel efter ansigtsgenkendelsesteknologi, især fra retshåndhævende myndigheder, der ser teknologien som værktøj til at finde savnede børn. Dog kan disse teknologier potentielt bruges af regeringer til at bringe borgernes grundlæggende friheder i fare, for eksempel ved at muliggøre kontinuerlig overvågning af specifikke individer. Derfor skal datavidenskabsfolk og organisationer være ansvarlige for, hvordan deres AI-system påvirker enkeltpersoner eller samfundet.

🎥 Klik på billedet ovenfor for en video: Advarsler om masseovervågning via ansigtsgenkendelse
I sidste ende er et af de største spørgsmål for vores generation, som er den første generation, der bringer AI til samfundet, hvordan vi sikrer, at computere forbliver ansvarlige over for mennesker, og hvordan de personer, der designer computere, forbliver ansvarlige over for alle andre.
Vurdering af påvirkning
Inden man træner en maskinlæringsmodel, er det vigtigt at foretage en vurdering af påvirkningen for at forstå formålet med AI-systemet; hvad den tiltænkte brug er; hvor det skal implementeres; og hvem der vil interagere med systemet. Dette er nyttigt for anmeldere eller testere, der evaluerer systemet, så de ved, hvilke faktorer de skal tage i betragtning, når de identificerer potentielle risici og forventede konsekvenser.
Følgende er fokusområder ved gennemførelse af en vurdering af påvirkning:
- Negativ påvirkning på individer. Være opmærksom på eventuelle begrænsninger eller krav, uunderstøttet brug eller kendte begrænsninger, der hæmmer systemets præstation, er afgørende for at sikre, at systemet ikke anvendes på en måde, der kunne skade individer.
- Data krav. At få forståelse for hvordan og hvor systemet vil bruge data, gør det muligt for anmeldere at undersøge eventuelle datakrav, man skal være opmærksom på (f.eks. GDPR eller HIPAA-databestemmelser). Desuden undersøges det, om datakilden eller datamængden er tilstrækkelig til træning.
- Oversigt over påvirkning. Saml en liste over potentielle skader, der kan opstå ved brug af systemet. Under maskinlæringens livscyklus gennemgås, om de identificerede problemer afhjælpes eller adresseres.
- Anvendelige mål for hver af de seks kerneprincipper. Vurder om målene fra hvert af principperne er opfyldt, og om der er huller.
Debugging med ansvarlig AI
Ligesom man debugger en softwareapplikation, er debugging af AI-systemer en nødvendig proces med at identificere og løse problemer i systemet. Der er mange faktorer, der kan påvirke, at en model ikke præsterer som forventet eller ansvarligt. De fleste traditionelle modelpræstationsmålinger er kvantitative aggregeringer af en models præstation, hvilket ikke er tilstrækkeligt til at analysere, hvordan en model bryder de ansvarlige AI-principper. Ydermere er en maskinlæringsmodel en sort boks, som gør det svært at forstå, hvad der driver dens resultat, eller give forklaring ved fejl. Senere i dette kursus vil vi lære at bruge Responsible AI dashboardet til at hjælpe med debugging af AI-systemer. Dashboardet giver et holistisk værktøj for datavidenskabsfolk og AI-udviklere til at udføre:
- Fejlanalyse. For at identificere modellens fejlfordeling, som kan påvirke systemets retfærdighed eller pålidelighed.
- Modeloversigt. For at opdage hvor der er forskelle i modellens præstation på tværs af datakohorter.
- Dataanalyse. For at forstå datadistributionen og identificere potentielle bias i data, som kan føre til problemer med retfærdighed, inklusion og pålidelighed.
- Modelfortolkning. For at forstå, hvad der påvirker eller influerer modellens forudsigelser. Dette hjælper med at forklare modellens adfærd, hvilket er vigtigt for gennemsigtighed og ansvarlighed.
🚀 Udfordring
For at forhindre at skader opstår i første omgang bør vi:
- have en mangfoldighed af baggrunde og perspektiver blandt de personer, der arbejder på systemer
- investere i datasæt, der afspejler mangfoldigheden i vores samfund
- udvikle bedre metoder gennem hele maskinlæringslivscyklussen til at opdage og rette uansvarlig AI, når det opstår
Tænk på virkelige scenarier, hvor en models utroværdighed tydeligt viser sig i modelbygning og brug. Hvad mere bør vi overveje?
Quiz efter forelæsning
Gennemgang og selvstudium
I denne lektion har du lært nogle grundlæggende begreber om retfærdighed og uretfærdighed i maskinlæring.
Se denne workshop for at dykke dybere ned i emnerne:
- I jagten på ansvarlig AI: At bringe principper til praksis af Besmira Nushi, Mehrnoosh Sameki og Amit Sharma

🎥 Klik på billedet ovenfor for en video: RAI Toolbox: Et open source-framework til at bygge ansvarlig AI af Besmira Nushi, Mehrnoosh Sameki og Amit Sharma
Læs også:
-
Microsofts RAI ressourcercenter: Responsible AI Resources – Microsoft AI
-
Microsofts FATE forskningsgruppe: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Læs om Azure Machine Learnings værktøjer til at sikre retfærdighed:
Opgave
Ansvarsfraskrivelse: Dette dokument er blevet oversat ved hjælp af AI-oversættelsestjenesten Co-op Translator. Selvom vi bestræber os på nøjagtighed, skal du være opmærksom på, at automatiserede oversættelser kan indeholde fejl eller unøjagtigheder. Det originale dokument på dets oprindelige sprog bør betragtes som den autoritative kilde. For kritisk information anbefales professionel menneskelig oversættelse. Vi påtager os intet ansvar for misforståelser eller fejltolkninger, der opstår som følge af brugen af denne oversættelse.