
 localizeflow[bot]
b08221c6ab |
3 weeks ago | |
|---|---|---|
| .. | ||
| solution | 8 months ago | |
| README.md | 3 weeks ago | |
| assignment.md | 8 months ago | |
| notebook.ipynb | 1 year ago | |
README.md
Začínáme s Pythonem a Scikit-learn pro regresní modely
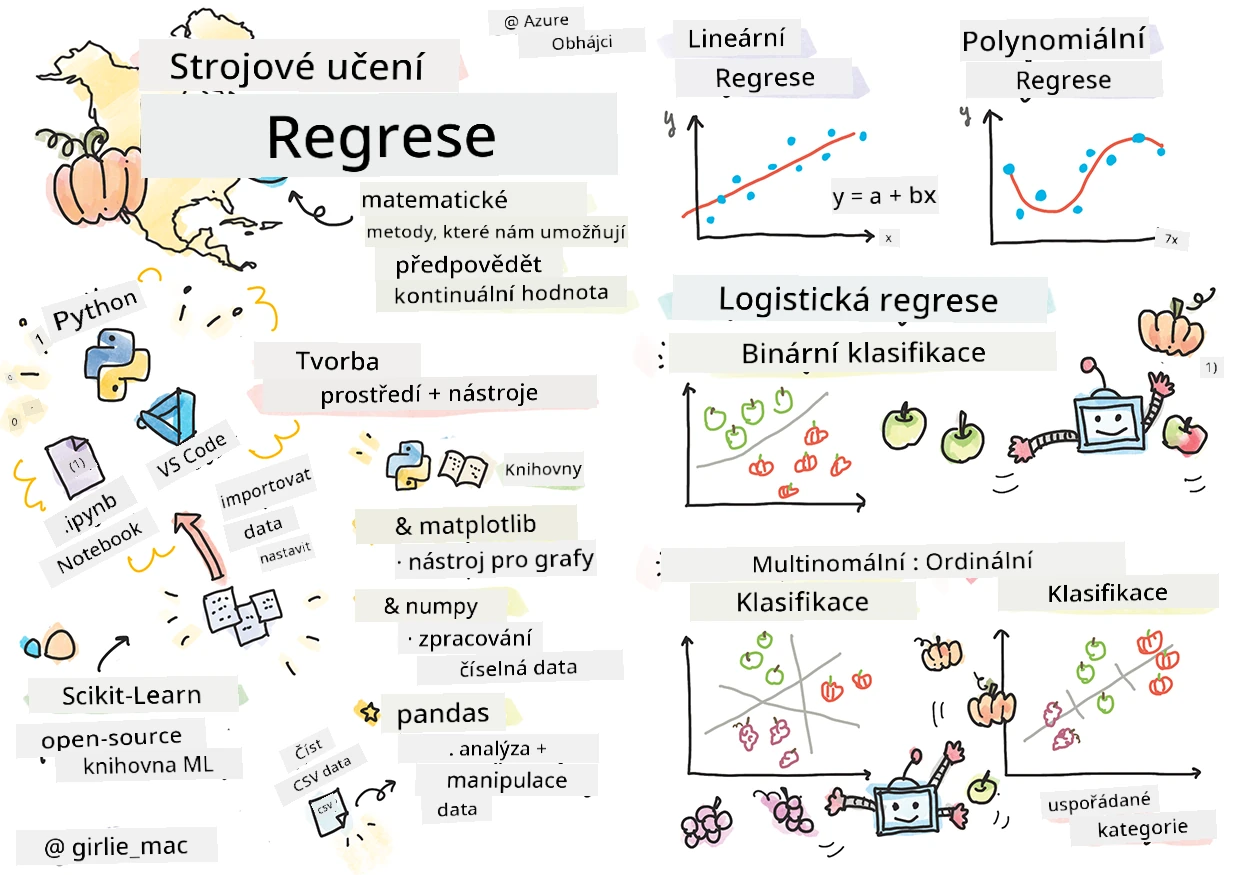
Sketchnote od Tomomi Imura
Kvíz před přednáškou
Tato lekce je dostupná i v R!
Úvod
V těchto čtyřech lekcích se naučíte, jak sestavit regresní modely. Brzy probereme, k čemu jsou tyto modely určeny. Než však začnete, ujistěte se, že máte připravené správné nástroje pro spuštění procesu!
V této lekci se naučíte:
- Jak nakonfigurovat váš počítač pro úlohy strojového učení na lokální úrovni.
- Jak pracovat s Jupyter Notebooky.
- Jak používat Scikit-learn, včetně instalace.
- Jak prozkoumat lineární regresi prostřednictvím praktického cvičení.
Instalace a konfigurace

🎥 Klikněte na obrázek výše pro krátké video o konfiguraci počítače pro strojové učení.
-
Nainstalujte Python. Ujistěte se, že máte na počítači nainstalovaný Python. Python budete používat pro mnoho úloh datové vědy a strojového učení. Většina počítačových systémů již Python obsahuje. K dispozici jsou také užitečné balíčky pro kódování v Pythonu, které ulehčují nastavení některým uživatelům.
Některé použití Pythonu však vyžaduje jednu verzi softwaru, zatímco jiné jinou verzi. Proto je užitečné pracovat v virtuálním prostředí.
-
Nainstalujte Visual Studio Code. Ujistěte se, že máte na počítači nainstalovaný Visual Studio Code. Postupujte podle těchto pokynů, jak nainstalovat Visual Studio Code pro základní instalaci. V tomto kurzu budete používat Python ve Visual Studio Code, proto možná budete chtít osvěžit, jak nastavit Visual Studio Code pro vývoj v Pythonu.
Seznamte se s Pythonem pomocí této kolekce učebních modulů

🎥 Klikněte na obrázek výše pro video: používání Pythonu ve VS Code.
-
Nainstalujte Scikit-learn podle těchto pokynů. Protože musíte zajistit použití Pythonu 3, doporučuje se používat virtuální prostředí. Pokud instalujete tuto knihovnu na Mac s čipem M1, jsou na výše uvedené stránce speciální instrukce.
-
Nainstalujte Jupyter Notebook. Budete potřebovat nainstalovat balíček Jupyter.
Vaše prostředí pro tvorbu ML
K vývoji Python kódu a tvorbě modelů strojového učení budete používat notebooky. Tento typ souboru je běžným nástrojem datových vědců a poznáte je podle přípony .ipynb.
Notebooky jsou interaktivní prostředí, která umožňují vývojáři jak psát kód, tak přidávat poznámky a dokumentaci kolem kódu, což je velmi užitečné pro experimentální nebo výzkumné projekty.

🎥 Klikněte na obrázek výše pro krátké video ukazující práci s tímto cvičením.
Cvičení – práce s notebookem
V této složce najdete soubor notebook.ipynb.
-
Otevřete notebook.ipynb ve Visual Studio Code.
Spustí se Jupyter server s Pythonem 3+. V notebooku najdete oblasti, které můžete
spustit, tedy bloky kódu. Kód můžete spustit kliknutím na ikonu připomínající tlačítko přehrávání. -
Vyberte ikonu
mda přidejte trochu markdownu a následující text # Vítejte ve svém notebooku.Pak přidejte nějaký Python kód.
-
Napište print('hello notebook') do bloku kódu.
-
Klikněte na šipku pro spuštění kódu.
Měli byste vidět vytištěné:
hello notebook
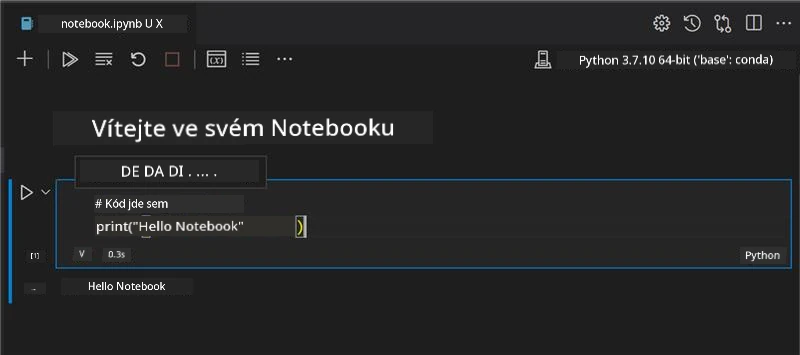
Ke svému kódu můžete přidávat komentáře pro vlastní dokumentaci notebooku.
✅ Zamyslete se na chvíli, jak odlišné je pracovní prostředí webového vývojáře oproti datovému vědci.
Práce se Scikit-learn
Nyní, když máte Python nastaven ve svém lokálním prostředí a jste obeznámeni s Jupyter Notebooky, pojďme si stejně pohodlně osvojit Scikit-learn (vyslovujte sci jako v science). Scikit-learn poskytuje rozsáhlé API, které vám pomůže provádět úlohy strojového učení.
Podle jejich webu „Scikit-learn je open source knihovna pro strojové učení, která podporuje řízené i neřízené učení. Nabízí také různé nástroje pro fitování modelů, předzpracování dat, výběr a hodnocení modelu a mnoho dalších užitečných funkcí.“
V tomto kurzu budete používat Scikit-learn a další nástroje k vytvoření modelů strojového učení pro tzv. 'tradiční úlohy strojového učení'. Úmyslně jsme se vyhnuli neuronovým sítím a hlubokému učení, které jsou lépe pokryty v našem nadcházejícím kurzu 'AI pro začátečníky'.
Scikit-learn umožňuje snadno vytvářet modely a hodnotit je pro praktické použití. Primárně se zaměřuje na numerická data a obsahuje několik hotových datových sad pro výuku. Obsahuje také předpřipravené modely k vyzkoušení. Pojďme si prozkoumat proces načítání předpřipravených dat a použití vestavěného odhadu pro vytvoření prvního modelu strojového učení se Scikit-learn na základních datech.
Cvičení – váš první notebook se Scikit-learn
Tento návod byl inspirován příkladem lineární regrese na webu Scikit-learn.

🎥 Klikněte na obrázek výše pro krátké video ukazující práci s tímto cvičením.
V souboru notebook.ipynb přidruženém k této lekci vymažte všechny buňky pomocí ikony „koš“.
V této části budete pracovat s malou datovou sadou o diabetu, která je součástí Scikit-learn pro výukové účely. Představte si, že chcete otestovat léčbu pro diabetické pacienty. Modely strojového učení vám mohou pomoci určit, kteří pacienti by na léčbu lépe reagovali, na základě kombinací proměnných. I velmi základní regresní model může, pokud ho zobrazíte vizuálně, ukázat informace o proměnných, které by vám pomohly uspořádat vaše teoretické klinické studie.
✅ Existuje mnoho typů regresních metod a kterou z nich vyberete, závisí na odpovědi, kterou hledáte. Pokud chcete předpovědět pravděpodobnou výšku osoby daného věku, použijete lineární regresi, protože hledáte číselnou hodnotu. Jestliže chcete zjistit, zda je určitý typ kuchyně veganský, hledáte zařazení do kategorie, a použijete logistickou regresi. O logistické regresi se dozvíte více později. Zamyslete se nad otázkami, které můžete klást datům, a která z těchto metod by byla vhodnější.
Pojďme se pustit do tohoto úkolu.
Import knihoven
Pro tento úkol importujeme některé knihovny:
- matplotlib. Je to užitečný grafický nástroj a použijeme jej k vytvoření čárového grafu.
- numpy. numpy je užitečná knihovna pro práci s číselnými daty v Pythonu.
- sklearn. To je knihovna Scikit-learn.
Naimportujte si nějaké knihovny, které vám pomohou s úkoly.
-
Přidejte importy zapsáním následujícího kódu:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
Výše importujete
matplotlib,numpya zsklearnimportujetedatasets,linear_modelamodel_selection.model_selectionse používá pro rozdělení dat na tréninkovou a testovací sadu.
Datová sada diabetu
Vestavěná datová sada diabetu obsahuje 442 vzorků dat o diabetu, s 10 znakovými proměnnými, z nichž některé zahrnují:
- věk: věk v letech
- bmi: index tělesné hmotnosti
- bp: průměrný krevní tlak
- s1 tc: T-buňky (typ bílých krvinek)
✅ Tato datová sada zahrnuje jako znak proměnnou 'pohlaví', což je důležitý faktor výzkumu diabetu. Mnoho lékařských datových sad zahrnuje tento typ binární klasifikace. Zamyslete se nad tím, jak takové rozdělení může vylučovat určité části populace z léčby.
Teď načtěte data X a y.
🎓 Pamatujte, že jde o řízené učení a potřebujeme pojmenovaný cíl 'y'.
V nové buňce načtěte datovou sadu diabetu voláním load_diabetes(). Vstup return_X_y=True znamená, že X bude datová matice a y bude cílová proměnná pro regresi.
-
Přidejte příkazy print, které ukáží tvar matice dat a její první prvek:
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
Co dostáváte zpět jako odpověď, je n-tice. Co děláte, je přiřazení prvních dvou hodnot n-tice do proměnných
Xay. Více se dozvíte o n-ticích.Vidíte, že tato data obsahují 442 položek ve formátu polí o 10 prvcích:
(442, 10)
[ 0.03807591  0.05068012  0.06169621  0.02187235 -0.0442235  -0.03482076
-0.04340085 -0.00259226  0.01990842 -0.01764613]
✅ Zamyslete se nad vztahem mezi daty a cílovou proměnnou regresní analýzy. Lineární regrese předpovídá vztahy mezi znakovou proměnnou X a cílovou proměnnou y. Dokážete najít cíl pro datovou sadu diabetu v dokumentaci? Co tato datová sada demonstruje vzhledem k cíli?
-
Nyní vyberte část této datové sady k zobrazení v grafu tím, že vyberete 3. sloupec datové sady. To lze provést pomocí operátoru
:pro výběr všech řádků a poté výběrem 3. sloupce pomocí indexu (2). Data můžete také přeformátovat na 2D pole – jak vyžaduje kreslení – použitímreshape(počet_řádků, počet_sloupců). Pokud je jeden z parametrů -1, odpovídající rozměr je vypočítán automaticky.X = X[:, 2] X = X.reshape((-1,1))✅ Kdykoli si vytiskněte data a zkontrolujte jejich tvar.
-
Když už máte data připravená k vykreslení, můžete zkusit zjistit, zda stroj dokáže určit logické rozdělení mezi čísly v této datové sadě. K tomu musíte rozdělit jak data (X), tak cíl (y) na testovací a tréninkové sady. Scikit-learn na to má jednoduchý způsob; můžete rozdělit testovací data v daném bodě.
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33) -
Nyní jste připraveni trénovat svůj model! Načtěte lineární regresní model a natrénujte jej na tréninkových sadách X a y pomocí
model.fit():model = linear_model.LinearRegression() model.fit(X_train, y_train)✅
model.fit()je funkce, kterou uvidíte ve většině knihoven ML, například v TensorFlow. -
Pak vytvořte predikci pomocí testovacích dat, použitím funkce
predict(). Bude sloužit k vykreslení čáry mezi skupinami dat.y_pred = model.predict(X_test) -
Nyní je čas data zobrazit v grafu. Matplotlib je pro tento úkol velmi užitečný nástroj. Vytvořte rozptylový graf všech testovacích dat X a y a pomocí predikce nakreslete čáru na nejvhodnějším místě mezi skupinami dat modelu.
plt.scatter(X_test, y_test,  color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()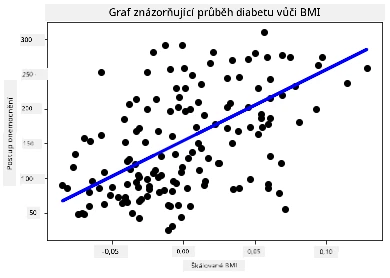
✅ Zamyslete se, co se zde děje. Přímka prochází mnoha malými body dat, ale co vlastně dělá? Vidíte, jak byste mohli pomocí této čáry předpovědět, kam by do osy y grafu zapadalo nové, dosud neviděné datové bod? Pokuste se vyjádřit praktické využití tohoto modelu.
Gratulujeme, vytvořili jste svůj první lineární regresní model, vytvořili predikci a zobrazili ji v grafu!
🚀Výzva
Vykreslete jinou proměnnou z této datové sady. Nápověda: upravte tento řádek: X = X[:,2]. Co z datové sady a jejího cíle dokážete zjistit o průběhu diabetu jako nemoci?
Kvíz po přednášce
Přehled a samostudium
V tomto tutoriálu jste pracovali se základní lineární regresí, nikoli s univariační nebo vícerozměrnou lineární regresí. Přečtěte si něco o rozdílech mezi těmito metodami nebo se podívejte na toto video
Přečtěte si více o konceptu regrese a přemýšlejte o tom, jaké druhy otázek lze touto technikou zodpovědět. Prohlubte své znalosti pomocí tohoto návodu.
Zadání
Prohlášení o omezení odpovědnosti: Tento dokument byl přeložen pomocí AI překladatelské služby Co-op Translator. Přestože usilujeme o co největší přesnost, mějte prosím na paměti, že automatizované překlady mohou obsahovat chyby nebo nepřesnosti. Originální dokument v jeho mateřském jazyce by měl být považován za autoritativní zdroj. Pro kritické informace se doporučuje profesionální lidský překlad. Nejsme odpovědní za jakékoli nedorozumění nebo nesprávné interpretace vzniklé použitím tohoto překladu.