
 localizeflow[bot]
b08221c6ab |
3 weeks ago | |
|---|---|---|
| .. | ||
| README.md | 3 weeks ago | |
| assignment.md | 7 months ago | |
README.md
Vytváření řešení strojového učení s odpovědnou AI

Sketchnote od Tomomi Imura
Kvíz před lekcí
Úvod
V tomto kurzu začnete objevovat, jak strojové učení může a již ovlivňuje naše každodenní životy. Již nyní jsou systémy a modely zapojeny do každodenního rozhodování, jako jsou zdravotní diagnózy, schvalování půjček nebo detekce podvodů. Je proto důležité, aby tyto modely fungovaly dobře a poskytovaly výsledky, kterým lze důvěřovat. Stejně jako každý softwarový aplikace, i AI systémy mohou nesplnit očekávání nebo mít nežádoucí výsledky. Proto je zásadní být schopen porozumět a vysvětlit chování modelu AI.
Představte si, co se může stát, když data, která používáte k vytváření těchto modelů, postrádají určité demografické skupiny, jako je rasa, pohlaví, politický názor, náboženství, nebo když takové demografické skupiny neúměrně reprezentují. Co se stane, když je výstup modelu interpretován tak, že zvýhodňuje určitou demografickou skupinu? Jaké jsou důsledky pro aplikaci? A co se stane, když model má negativní výsledek a je škodlivý pro lidi? Kdo je odpovědný za chování AI systému? To jsou některé otázky, které budeme v tomto kurzu zkoumat.
V této lekci:
- Zvýšíte své povědomí o důležitosti spravedlnosti ve strojovém učení a škodách souvisejících se spravedlností.
- Se seznámíte s praxí zkoumání odlehlých hodnot a neobvyklých scénářů, abyste zajistili spolehlivost a bezpečnost.
- Získáte porozumění potřebě posílit všechny vytvořením inkluzivních systémů.
- Prozkoumáte, jak je důležité chránit soukromí a bezpečnost dat a lidí.
- Uvidíte, jak je důležité mít přístup „skleněné krabice“ k vysvětlení chování AI modelů.
- Budete si vědomi, jak je odpovědnost nezbytná pro budování důvěry v AI systémy.
Předpoklady
Jako předpoklad absolvujte prosím „Principy odpovědné AI“ v Learning Path a podívejte se na níže uvedené video na toto téma:
Více se dozvíte o odpovědné AI sledováním této Learning Path

🎥 Klikněte na obrázek výše pro video: Přístup Microsoftu k odpovědné AI
Spravedlnost
AI systémy by měly zacházet se všemi spravedlivě a vyhnout se tomu, aby podobné skupiny lidí ovlivňovaly různými způsoby. Například pokud AI systémy poskytují doporučení ohledně lékařské péče, žádostí o půjčku nebo zaměstnání, měly by všem se stejnými symptomy, finanční situací nebo odbornými kvalifikacemi poskytovat stejná doporučení. Každý z nás jako lidé máme vrozené předsudky, které ovlivňují naše rozhodnutí a jednání. Tyto předsudky mohou být patrné v datech, která používáme k natrénování AI systémů. Taková manipulace může někdy probíhat nevědomky. Často je obtížné vědomě poznat, kdy do dat zavádíte předsudky.
„Nespravedlnost“ zahrnuje negativní dopady nebo „škody“ pro skupinu lidí, například definovaných podle rasy, pohlaví, věku nebo zdravotního postižení. Hlavní škody související se spravedlností mohou být klasifikovány jako:
- Přidělení, pokud je například pohlaví nebo etnicita zvýhodněna před jinými.
- Kvalita služby. Pokud trénujete data pro konkrétní scénář, ale realita je mnohem složitější, vede to k špatně fungující službě. Například dávkovač mýdla na ruce, který nedokázal správně rozpoznat lidi s tmavou pletí. Reference
- Znevažování. Nespravedlivě kritizovat a označit něco nebo někoho. Například technologie označování obrázků nechvalně označila obrázky tmavopletých lidí jako gorily.
- Nadměrná nebo nedostatečná reprezentace. Myšlenka je, že určitá skupina není vidět v určité profesi, a jakákoli služba nebo funkce, která toto podporuje, přispívá ke škodě.
- Stereotypizace. Spojování určité skupiny s předem přiřazenými atributy. Například překladový systém mezi angličtinou a turečtinou může mít nepřesnosti kvůli slovům se stereotypními asociacemi s pohlavím.
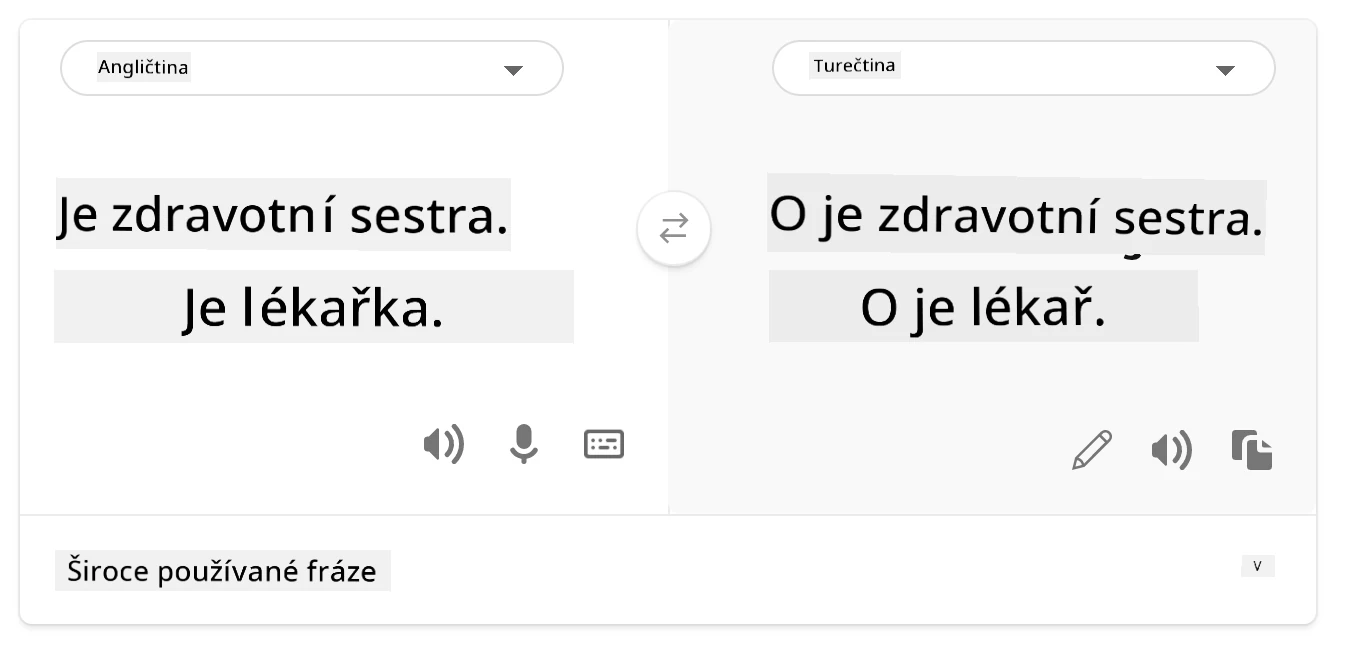
překlad do turečtiny
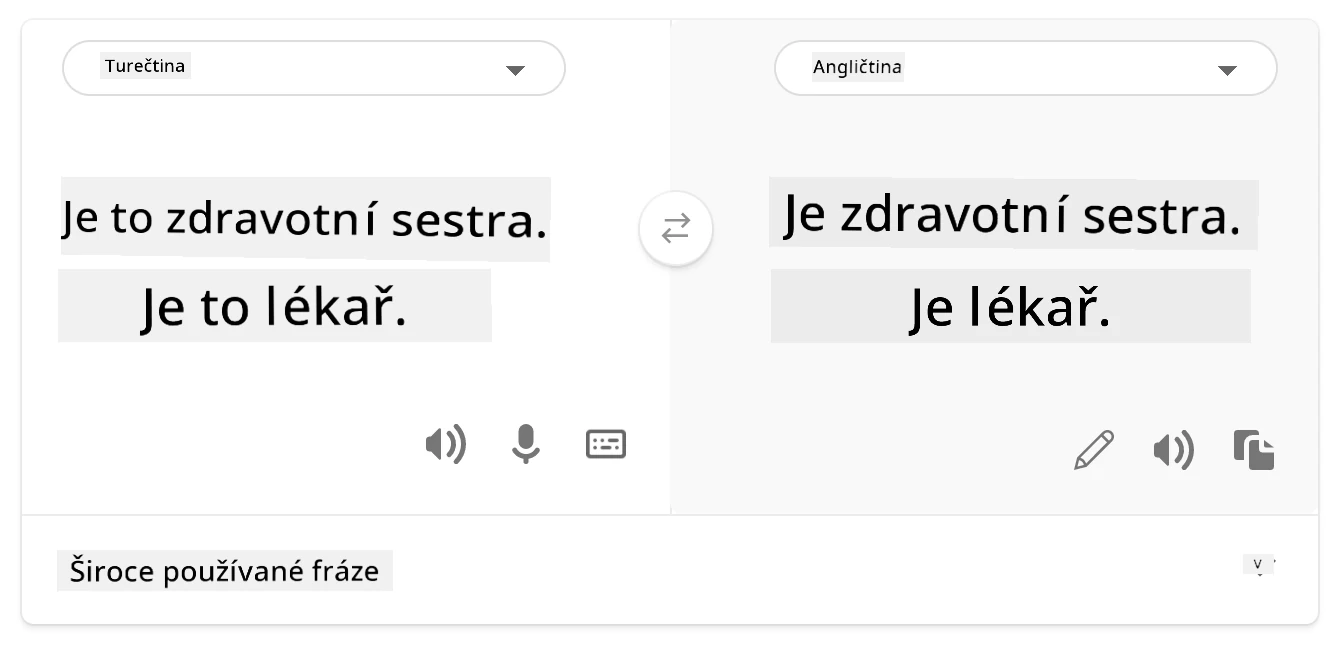
překlad zpět do angličtiny
Při navrhování a testování AI systémů je třeba zajistit, aby AI byla spravedlivá a nebyla naprogramována dělat zaujatá nebo diskriminační rozhodnutí, která jsou rovněž zakázána lidským bytostem. Zajištění spravedlnosti v AI a strojovém učení zůstává složitou sociálně-technickou výzvou.
Spolehlivost a bezpečnost
Pro získání důvěry musí být AI systémy spolehlivé, bezpečné a konzistentní za normálních i neočekávaných podmínek. Je důležité znát chování AI systémů v různých situacích, zejména pokud jde o odlehlé případy. Při vytváření AI řešení je nutné mít výrazný důraz na to, jak se vypořádat s širokou škálou okolností, které mohou AI řešení potkat. Například samořiditelný vůz musí klást bezpečnost lidí na první místo. Výsledkem je, že AI, která vůz pohání, musí zvážit všechny možné scénáře, se kterými se auto může setkat, jako je tma, bouřky nebo sněhové bouře, děti přebíhající silnici, domácí mazlíčci, silniční stavby atd. Jak dobře AI systém zvládne širokou škálu podmínek spolehlivě a bezpečně odráží úroveň předvídavosti, kterou datový vědec nebo AI vývojář zvažoval při návrhu nebo testování systému.
Inkluzivita
AI systémy by měly být navrženy tak, aby zapojovaly a posilovaly všechny. Při navrhování a implementaci AI systémů datoví vědci a AI vývojáři identifikují a řeší potenciální bariéry v systému, které by mohly nevědomky některé lidi vylučovat. Například na světě je 1 miliarda lidí s postižením. S pokrokem AI mohou tyto osoby snadněji přistupovat k široké škále informací a příležitostí ve svém každodenním životě. Odstraňováním bariér vznikají příležitosti k inovacím a vývoji AI produktů s lepšími zkušenostmi, které prospívají všem.
Bezpečnost a soukromí
AI systémy by měly být bezpečné a respektovat soukromí lidí. Lidé mají menší důvěru v systémy, které ohrožují jejich soukromí, informace nebo životy. Při trénování modelů strojového učení spoléháme na data, aby produkovala nejlepší výsledky. Při tom je třeba zvážit původ a integritu dat. Například zda byla data zadána uživatelem nebo zda byla veřejně dostupná. Dále je při práci s daty zásadní vyvíjet AI systémy, které dokážou chránit důvěrné informace a odolávat útokům. S rostoucím rozšířením AI se ochrana soukromí a zabezpečení důležitých osobních a obchodních informací stává stále důležitější a složitější. Otázky soukromí a bezpečnosti dat vyžadují zvláštní pozornost u AI, protože přístup k datům je nezbytný pro to, aby AI systémy mohly dělat přesná a informovaná rozhodnutí o lidech.
- Jako odvětví jsme dosáhli významného pokroku v oblasti soukromí a bezpečnosti, což bylo výrazně podpořeno předpisy jako GDPR (Obecné nařízení o ochraně osobních údajů).
- Přesto musíme u AI systémů uznat napětí mezi potřebou většího množství osobních údajů pro učinění systémů osobnějšími a účinnějšími – a potřebou ochrany soukromí.
- Stejně jako při zrození propojených počítačů s internetem zaznamenáváme také výrazný nárůst počtu bezpečnostních problémů souvisejících s AI.
- Současně jsme viděli, že AI se používá ke zlepšení bezpečnosti. Například většina moderních antivirových skenerů dnes využívá heuristiky AI.
- Musíme zajistit, aby naše procesy datové vědy harmonicky zapadaly do nejnovějších praktik ochrany soukromí a bezpečnosti.
Transparentnost
AI systémy by měly být srozumitelné. Klíčovou součástí transparentnosti je vysvětlení chování AI systémů a jejich komponent. Zlepšení porozumění AI systémům vyžaduje, aby zainteresované strany chápaly, jak a proč fungují, aby mohly identifikovat potenciální problémy s výkonem, obavy o bezpečnost a soukromí, zaujatosti, vylučující praktiky nebo nechtěné výsledky. Také věříme, že ti, kdo AI systémy používají, by měli být upřímní a otevření ohledně toho, kdy, proč a jak je nasazují. Stejně tak ohledně omezení systémů, které používají. Například pokud banka používá AI systém k podpoře rozhodnutí o půjčkách spotřebitelům, je důležité zkoumat výsledky a rozumět, která data ovlivňují doporučení systému. Vlády začínají regulovat AI napříč odvětvími, a proto musí datoví vědci a organizace vysvětlit, zda AI systém splňuje regulační požadavky, zejména když dojde k nežádoucímu výsledku.
- Protože AI systémy jsou tak složité, je obtížné porozumět, jak fungují, a interpretovat výsledky.
- Tento nedostatek porozumění ovlivňuje způsob, jakým jsou tyto systémy spravovány, provozovány a dokumentovány.
- Tento nedostatek porozumění ještě významněji ovlivňuje rozhodnutí založená na výsledcích, které tyto systémy produkují.
Odpovědnost
Lidé, kteří navrhují a nasazují AI systémy, musí být odpovědní za to, jak jejich systémy fungují. Potřeba odpovědnosti je zvlášť důležitá u citlivých technologií, jako je rozpoznávání obličeje. Nedávno rostl zájem o technologii rozpoznávání obličeje, zejména ze strany orgánů činných v trestním řízení, kteří vidí potenciál technologie např. při hledání pohřešovaných dětí. Nicméně tyto technologie by mohly být potenciálně zneužity vládou, která by mohla ohrozit základní svobody svých občanů, například umožněním kontinuálního sledování konkrétních jedinců. Proto se od datových vědců a organizací očekává odpovědnost za to, jak jejich AI systém ovlivňuje jednotlivce či společnost.

🎥 Klikněte na obrázek výše pro video: Varování před masovým sledováním pomocí rozpoznávání obličeje
Nakonec je jednou z největších otázek pro naši generaci, jako první generaci, která přináší AI společnosti, jak zajistit, aby počítače zůstaly odpovědné vůči lidem a jak zajistit, aby lidé, kteří počítače navrhují, zůstali odpovědní vůči všem ostatním.
Hodnocení dopadů
Před trénováním modelu strojového učení je důležité provést hodnocení dopadu, aby bylo jasné, jaký je účel AI systému; jaké je zamýšlené použití; kde bude nasazen; a kdo bude se systémem interagovat. To pomáhá recenzentům nebo testerům při hodnocení systému, aby věděli, jaké faktory zohlednit při identifikaci potenciálních rizik a očekávaných důsledků.
Následující oblasti jsou klíčové při provádění hodnocení dopadu:
- Negativní dopad na jednotlivce. Být si vědom jakýchkoli omezení nebo požadavků, nepodporovaného použití či známých limitací, které mohou brzdit výkon systému, je zásadní pro zajištění, že systém nebude použit způsobem, který by mohl ublížit jednotlivcům.
- Požadavky na data. Porozumění tomu, jak a kde systém bude používat data, umožní recenzentům prozkoumat případné požadavky na data (např. nařízení GDPR nebo HIPAA). Dále je třeba posoudit, zda je zdroj nebo množství dat dostatečné pro trénink.
- Shrnutí dopadu. Sestavte seznam potenciálních škod, které by mohly vzniknout používáním systému. Během životního cyklu ML průběžně kontrolujte, zda se identifikované problémy řeší nebo zmírňují.
- Použitelné cíle pro každý ze šesti základních principů. Posuďte, zda jsou cíle každého principu splněny a zda existují mezery.
Ladění s odpovědnou AI
Podobně jako ladění softwarové aplikace je ladění AI systému nezbytný proces identifikace a řešení problémů v systému. Existuje mnoho faktorů, které by mohly způsobit, že model nebude fungovat podle očekávání nebo zodpovědně. Většina tradičních metrik výkonu modelů je kvantitativním souhrnem výkonu modelu, který však nestačí k analýze toho, jak model porušuje principy odpovědné AI. Navíc je model strojového učení černou skříňkou, což ztěžuje pochopení, co ovlivňuje jeho výstup, nebo poskytnutí vysvětlení chyby. Později v tomto kurzu se naučíme, jak používat dashboard Responsible AI k ladění AI systémů. Dashboard poskytuje komplexní nástroj pro datové vědce a AI vývojáře k provádění:
- Analýza chyb. Identifikovat rozložení chyb modelu, které mohou ovlivnit spravedlnost nebo spolehlivost systému.
- Přehled modelu. Odhalit, kde existují rozdíly ve výkonu modelu napříč datovými skupinami.
- Analýza dat. Porozumět rozložení dat a identifikovat možné předsudky v datech, které by mohly vést k problémům se spravedlností, inkluzivitou a spolehlivostí.
- Interpretovatelnost modelu. Porozumět, co ovlivňuje nebo řídí predikce modelu. To pomáhá vysvětlit chování modelu, což je důležité pro transparentnost a odpovědnost.
🚀 Výzva
Abychom zabránili zavádění škod od samého počátku, měli bychom:
- mít různorodost zázemí a pohledů mezi lidmi pracujícími na systémech
- investovat do datových sad, které odrážejí rozmanitost naší společnosti
- vyvíjet lepší metody v celém životním cyklu strojového učení pro detekci a opravu nezodpovědné AI, když k ní dochází
Zamyslete se nad reálnými scénáři, kdy je nedůvěryhodnost modelu zřejmá při vytváření a používání modelu. Co dalšího bychom měli zvážit?
Kvíz po lekci
Přehled a samostudium
V této lekci jste se naučili základy pojmů spravedlnosti a nespravedlnosti ve strojovém učení.
Podívejte se na tento workshop, abyste se ponořili hlouběji do témat:
- Ve snaze o odpovědnou AI: Přenášení principů do praxe, Besmira Nushi, Mehrnoosh Sameki a Amit Sharma

🎥 Klikněte na obrázek výše pro video: RAI Toolbox: Open-source rámec pro vytváření zodpovědné umělé inteligence od Besmira Nushi, Mehrnoosh Sameki a Amit Sharma
Také si přečtěte:
-
Microsoftův RAI zdrojový portál: Responsible AI Resources – Microsoft AI
-
Microsoftova výzkumná skupina FATE: FATE: Fairness, Accountability, Transparency, and Ethics in AI - Microsoft Research
RAI Toolbox:
Přečtěte si o nástrojích Azure Machine Learning pro zajištění spravedlnosti:
Zadání
Prohlášení o omezení odpovědnosti: Tento dokument byl přeložen pomocí AI překladatelské služby Co-op Translator. Přestože usilujeme o co největší přesnost, mějte prosím na paměti, že automatizované překlady mohou obsahovat chyby nebo nepřesnosti. Originální dokument v jeho mateřském jazyce by měl být považován za autoritativní zdroj. Pro kritické informace se doporučuje profesionální lidský překlad. Nejsme odpovědní za jakékoli nedorozumění nebo nesprávné interpretace vzniklé použitím tohoto překladu.