
 localizeflow[bot]
ddbadf801a |
3 months ago | |
|---|---|---|
| .. | ||
| solution | ||
| README.md | 3 months ago | |
| assignment.md | ||
| notebook.ipynb | ||
README.md
카트폴 스케이팅
이전 강의에서 해결했던 문제는 장난감 문제처럼 보일 수 있으며, 실제 생활 시나리오에 적용하기 어렵다고 느껴질 수 있습니다. 그러나 실제 많은 문제들이 이와 비슷한 시나리오를 공유합니다 — 체스나 바둑 게임도 포함됩니다. 이들은 규칙이 정해진 보드와 이산 상태를 갖고 있다는 점에서 비슷합니다.
사전 강의 퀴즈
소개
이번 강의에서는 Q-러닝의 동일한 원리를 연속 상태 문제에 적용할 것입니다. 연속 상태란 하나 이상의 실수로 주어지는 상태를 의미합니다. 아래 문제를 다룰 예정입니다:
문제: 피터가 늑대에게서 도망치려면 더 빨리 움직여야 합니다. Q-러닝을 이용하여 피터가 스케이트를 배우고, 특히 균형을 잡는 법을 배우는 과정을 살펴봅니다.
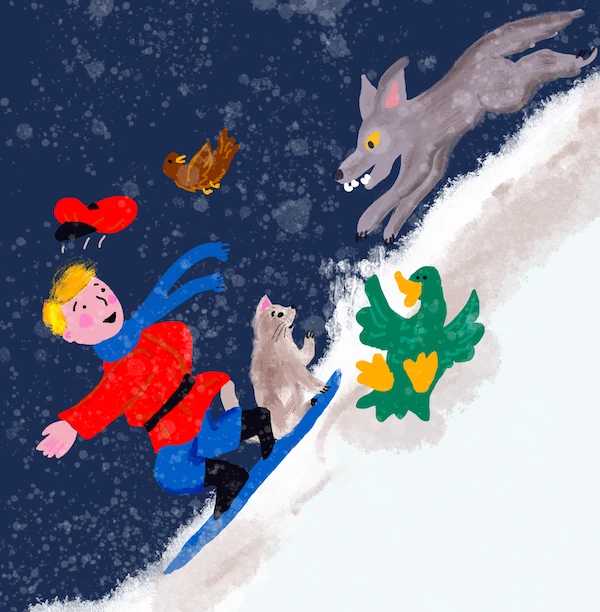
피터와 그의 친구들이 늑대에게서 도망치기 위해 창의력을 발휘하고 있습니다! 이미지 제공: Jen Looper
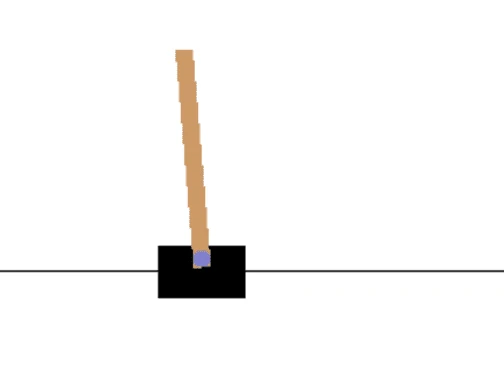
우리는 카트폴(CartPole) 문제라 불리는 단순화된 균형 맞추기 문제를 사용할 것입니다. 카트폴 세계에서는 수평 슬라이더가 좌우로 움직일 수 있고, 목표는 슬라이더 위에 수직 막대를 균형 있게 세우는 것입니다.
필수 사항
이번 강의에서는 OpenAI Gym이라는 라이브러리를 사용하여 다양한 환경을 시뮬레이션할 것입니다. Visual Studio Code와 같이 로컬에서 강의 코드를 실행하면, 시뮬레이션이 새 창에서 열릴 것입니다. 온라인 실행 시에는 여기 설명된 코드 조정이 필요할 수 있습니다.
OpenAI Gym
이전 강의에는 게임의 규칙과 상태를 우리가 정의한 Board 클래스로 표현했습니다. 이번에는 균형 잡기 물리학을 시뮬레이션하는 특수 환경을 이용합니다. 강화학습 알고리즘 훈련에 가장 널리 사용되는 시뮬레이션 환경 중 하나는 Gym이라 불리며, OpenAI에서 유지 관리합니다. 이 Gym을 이용하여 카트폴 시뮬레이션부터 아타리 게임까지 다양한 환경을 만들 수 있습니다.
참고: OpenAI Gym에서 사용할 수 있는 다른 환경들은 여기에서 확인할 수 있습니다.
먼저 gym을 설치하고 필요한 라이브러리를 가져옵니다 (코드 블록 1):
import sys
!{sys.executable} -m pip install gym

import gym
import matplotlib.pyplot as plt
import numpy as np
import random
연습 - 카트폴 환경 초기화하기
카트폴 균형 문제를 다루려면 해당 환경을 초기화해야 합니다. 각 환경에는 다음이 연관되어 있습니다:
-
관찰 공간: 환경에서 받는 정보의 구조를 정의합니다. 카트폴 문제에서는 기둥의 위치, 속도 등 여러 값을 받습니다.
-
행동 공간: 가능한 행동을 정의합니다. 이 경우 행동 공간은 이산적이며, 두 가지 행동 - 왼쪽 과 오른쪽 으로 구성됩니다. (코드 블록 2)
-
초기화하려면 다음 코드를 입력하세요:
env = gym.make("CartPole-v1")
print(env.action_space)
print(env.observation_space)
print(env.action_space.sample())
환경이 어떻게 작동하는지 보려면 100 스텝 동안 간단한 시뮬레이션을 실행해 보겠습니다. 각 스텝에서는 하나의 행동을 제공하는데, 여기서는 action_space에서 무작위로 행동을 선택합니다.
-
아래 코드를 실행해 결과를 확인해 보세요.
✅ 이 코드는 로컬 파이썬 설치 환경에서 실행하는 것이 좋습니다! (코드 블록 3)
env.reset()

for i in range(100):
   env.render()
   env.step(env.action_space.sample())
env.close()
결과는 다음과 비슷한 이미지를 볼 수 있습니다:
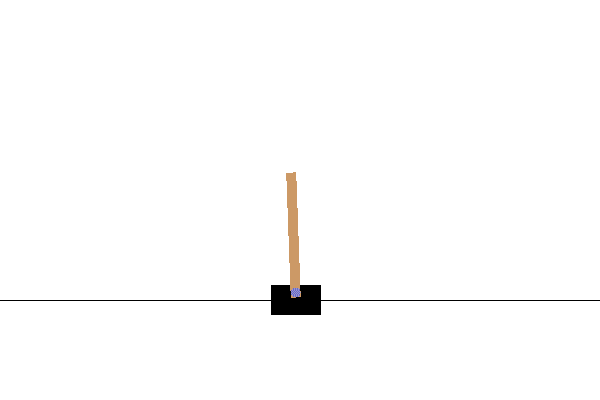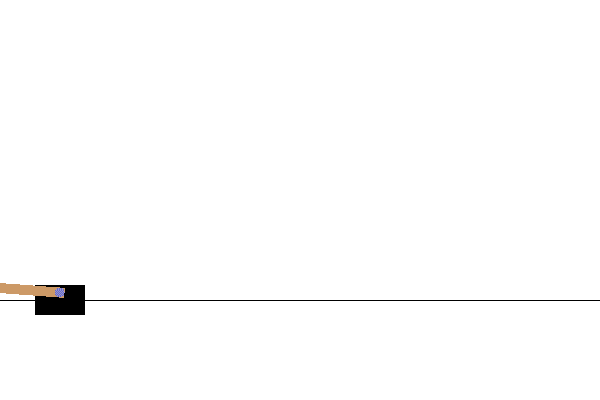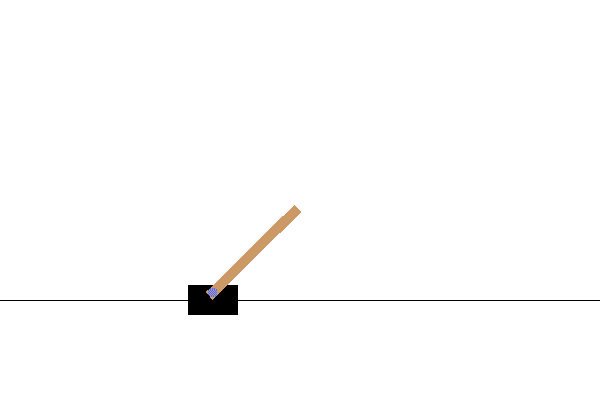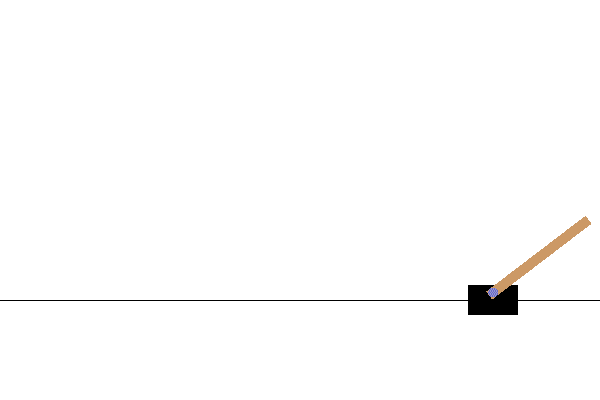
-
시뮬레이션 도중에는 어떻게 행동할지 결정하기 위해 관찰값을 받아야 합니다. 사실
step함수는 현재 관찰값, 보상 값, 그리고 시뮬레이션을 계속할지 여부를 나타내는 완료 플래그를 반환합니다: (코드 블록 4)env.reset() done = False while not done: env.render() obs, rew, done, info = env.step(env.action_space.sample()) print(f"{obs} -> {rew}") env.close()노트북 출력에서는 다음과 같은 결과를 볼 수 있습니다:
[ 0.03403272 -0.24301182  0.02669811  0.2895829 ] -> 1.0
[ 0.02917248 -0.04828055  0.03248977  0.00543839] -> 1.0
[ 0.02820687  0.14636075  0.03259854 -0.27681916] -> 1.0
[ 0.03113408  0.34100283  0.02706215 -0.55904489] -> 1.0
[ 0.03795414  0.53573468  0.01588125 -0.84308041] -> 1.0
...
[ 0.17299878  0.15868546 -0.20754175 -0.55975453] -> 1.0
[ 0.17617249  0.35602306 -0.21873684 -0.90998894] -> 1.0
시뮬레이션 각 스텝에서 반환되는 관찰 벡터는 다음 값을 포함합니다:
- 카트 위치
- 카트 속도
- 막대 각도
- 막대 회전 속도
-
이 값들의 최소 및 최대값을 구해 봅시다: (코드 블록 5)
print(env.observation_space.low)
print(env.observation_space.high)
각 시뮬레이션 단계에서 보상 값이 항상 1인 것을 알 수 있습니다. 이는 목표가 가능한 오랫동안 막대를 수직으로 유지하여 최대한 오래 생존하는 것이기 때문입니다.
✅ 사실 카트폴 시뮬레이션은 100번 연속 시도에서 평균 보상이 195 이상이면 문제를 해결한 것으로 간주됩니다.
상태 이산화
Q-러닝에서는 각 상태에서 무엇을 할지 정의하는 Q-테이블을 만들어야 합니다. 이를 위해 상태가 이산적이어야 하며, 더 정확히는 유한한 개수의 이산 값들을 포함해야 합니다. 따라서 관찰값을 이산화하여 유한 집합의 상태로 매핑할 필요가 있습니다.
이를 하는 몇 가지 방법은 다음과 같습니다:
- 빈(bin)으로 나누기: 특정 값의 구간을 알고 있으면 이 구간을 여러 빈으로 나누고, 값이 속한 빈 번호로 값을 대체할 수 있습니다. 이는 numpy의
digitize메서드를 사용해 가능합니다. 이 경우 선택한 빈 개수에 따라 상태 크기를 정확히 알 수 있습니다.
✅ 선형 보간법을 사용해 값을 어떤 유한한 구간(예: -20에서 20) 안으로 가져온 뒤, 반올림하여 정수로 변환하는 방법도 있습니다. 이 경우 입력 값의 정확한 범위를 모르면 상태 크기에 대한 제어가 다소 떨어집니다. 예를 들어 우리 문제에서는 4개의 값 중 2개가 상한/하한이 없기 때문에 상태의 개수가 무한대가 될 수 있습니다.
이번 예제에서는 두 번째 방법으로 진행하겠습니다. 후에 알 수 있겠지만, 상한/하한이 불명확해도 그런 극단적인 값은 드물게 발생하므로 극값 상태들은 매우 희귀합니다.
-
관찰값을 받아서 4개의 정수 값을 가지는 튜플로 변환하는 함수는 다음과 같습니다: (코드 블록 6)
def discretize(x): return tuple((x/np.array([0.25, 0.25, 0.01, 0.1])).astype(np.int)) -
빈을 활용한 다른 이산화 방법도 살펴봅시다: (코드 블록 7)
def create_bins(i,num): return np.arange(num+1)*(i[1]-i[0])/num+i[0] print("Sample bins for interval (-5,5) with 10 bins\n",create_bins((-5,5),10)) ints = [(-5,5),(-2,2),(-0.5,0.5),(-2,2)] # 각 매개변수에 대한 값의 구간 nbins = [20,20,10,10] # 각 매개변수에 대한 빈의 수 bins = [create_bins(ints[i],nbins[i]) for i in range(4)] def discretize_bins(x): return tuple(np.digitize(x[i],bins[i]) for i in range(4)) -
이제 간단한 시뮬레이션을 실행하여 이산화된 환경 값을 관찰해 보세요.
discretize와discretize_bins양쪽 모두 시험해 보고 차이가 있는지 확인해 보세요.✅
discretize_bins는 0부터 시작하는 빈 번호를 반환하므로 입력 값이 0 근처일 때는 구간 중간 번호(10)를 돌려줍니다. 반면discretize는 출력 값 범위를 제한하지 않아 음수가 나올 수 있기 때문에 상태 값이 이동하지 않으며, 0은 0에 대응합니다. (코드 블록 8)env.reset() done = False while not done: #env.render() obs, rew, done, info = env.step(env.action_space.sample()) #print(discretize_bins(obs)) print(discretize(obs)) env.close()✅
env.render로 시작하는 줄의 주석을 해제하면 환경이 실제 어떻게 동작하는지 볼 수 있습니다. 주석 상태라면 백그라운드에서 실행하는 것이므로 더 빠릅니다. 이 "보이지 않는" 실행 방식을 Q-러닝 과정에서 사용할 것입니다.
Q-테이블 구조
이전 강의에선 상태가 0부터 8사이의 두 숫자였어서, Q-테이블을 크기 8x8x2인 numpy 텐서로 나타내기 편했습니다. 빈 이산화를 쓰면 상태 벡터 크기가 알려져서 같은 방식을 사용하여 관찰 공간 각 매개변수에 대해 선택한 빈 수만큼 20x20x10x10x2 (끝의 2는 행동 공간 차원) 배열로 상태를 표현할 수 있습니다.
그러나 때때로 관찰 공간의 정확한 차원이 알려지지 않을 수 있습니다. discretize 함수처럼 상태가 일정 경계 내에 머무르는지 확실치 않은 경우도 있습니다. 그래서 우리는 약간 다른 방식을 사용하여 Q-테이블을 딕셔너리로 나타냅니다.
-
(state, action) 쌍을 딕셔너리 키로 쓰고, 값은 Q-테이블 엔트리 값을 대응시킵니다. (코드 블록 9)
Q = {}
actions = (0,1)

def qvalues(state):
    return [Q.get((state,a),0) for a in actions]
여기서는
qvalues()함수도 정의하여 주어진 상태에서 가능한 모든 행동에 대한 Q-테이블 값 리스트를 반환합니다. 만약 Q-테이블에 해당 엔트리가 없으면 기본값 0을 반환합니다.
Q-러닝 시작
이제 피터에게 균형 잡기 기술을 가르쳐 봅시다!
-
먼저 하이퍼파라미터를 설정합니다: (코드 블록 10)
# 하이퍼파라미터
alpha = 0.3
gamma = 0.9
epsilon = 0.90
여기서
alpha는 학습률로 매 단계마다 Q-테이블 값을 얼마나 조정할지 정의합니다. 이전에는 1에서 출발해 훈련 중 점차 낮추었습니다. 이번 예제에서는 단순화를 위해 고정값으로 두고 나중에 값들을 조절해 볼 수 있습니다.gamma는 할인율로, 미래 보상을 현재 보상보다 얼마나 더 중요시할지 나타냅니다.epsilon은 탐색/활용 비율로 탐색과 활용 중 어느 쪽을 더 선호할지 결정합니다. 알고리즘에서는epsilon확률로 Q-테이블의 값을 따라 행동하고, 나머지 경우에는 무작위 행동을 실행합니다. 이렇게 해야 전에 보지 못한 탐색 영역을 살필 수 있습니다.✅ 균형 맞추기 관점에서 무작위 행동(탐색)은 잘못된 방향에 무작위 펀치를 가하는 것이며, 막대는 이런 "실수"에서 균형 회복법을 학습해야 합니다.
알고리즘 개선
이전 강의 알고리즘에 다음 두 가지 개선을 할 수 있습니다:
-
평균 누적 보상 계산: 여러 시뮬레이션 동안 평균 누적 보상을 계산합니다. 각 5000 반복마다 진행 상황을 출력하고 이 기간의 누적 보상 평균을 냅니다. 만약 195점 이상 획득하면 문제를 해결했다고 간주할 수 있습니다.
-
최대 평균 누적 결과 계산,
Qmax, 그리고 이 결과에 대응하는 Q-테이블을 저장합니다. 훈련할 때 평균 누적 결과가 가끔 감소하는데, 이때는 Q-테이블 내에서 이전에 관찰된 최적 모델 값을 유지하려고 합니다.
-
모든 시뮬레이션에서 누적 보상을
rewards벡터에 수집하여 후속 시각화에 이용합니다. (코드 블록 11)def probs(v,eps=1e-4): v = v-v.min()+eps v = v/v.sum() return v Qmax = 0 cum_rewards = [] rewards = [] for epoch in range(100000): obs = env.reset() done = False cum_reward=0 # == 시뮬레이션 실행 == while not done: s = discretize(obs) if random.random()<epsilon: # 활용 - Q-테이블 확률에 따라 행동 선택 v = probs(np.array(qvalues(s))) a = random.choices(actions,weights=v)[0] else: # 탐험 - 무작위로 행동 선택 a = np.random.randint(env.action_space.n) obs, rew, done, info = env.step(a) cum_reward+=rew ns = discretize(obs) Q[(s,a)] = (1 - alpha) * Q.get((s,a),0) + alpha * (rew + gamma * max(qvalues(ns))) cum_rewards.append(cum_reward) rewards.append(cum_reward) # == 주기적으로 결과 출력 및 평균 보상 계산 == if epoch%5000==0: print(f"{epoch}: {np.average(cum_rewards)}, alpha={alpha}, epsilon={epsilon}") if np.average(cum_rewards) > Qmax: Qmax = np.average(cum_rewards) Qbest = Q cum_rewards=[]
다음과 같은 결과를 관찰할 수 있습니다:
-
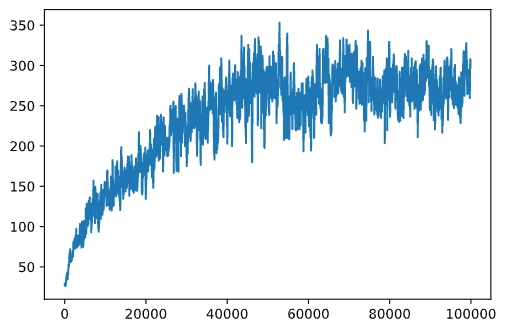
목표에 근접: 100번 이상의 연속 실행에서 평균 195 누적 보상 달성에 매우 근접했거나 이미 달성했을 수 있습니다! 결과가 작아도 5000번 평균이고 공식 기준은 100번이므로 확실치 않습니다.
-
보상이 감소하기 시작함: 가끔 보상이 떨어지는데, 이는 Q-테이블의 이미 학습된 값을 더 나쁘게 만드는 값으로 덮어쓸 수 있음을 뜻합니다.
이 현상은 훈련 진행 상황을 그래프로 그리면 더 뚜렷해집니다.
훈련 진행 상황 시각화
훈련 동안, 각 반복에서 누적 보상 값을 rewards 벡터에 수집했습니다. 반복 횟수에 대응하여 이 값을 그래프로 나타낸 모습은 다음과 같습니다:
plt.plot(rewards)
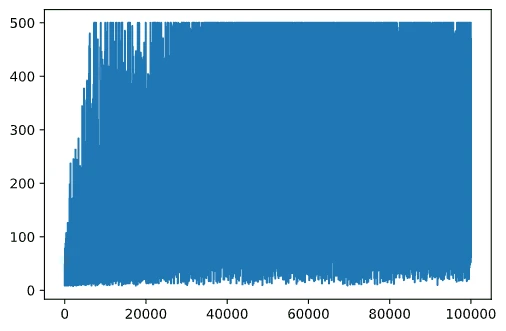
이 그래프는 말해주는 바가 거의 없습니다. 왜냐하면 확률적 훈련 프로세스 특성상 세션 길이가 크게 달라지기 때문입니다. 이 그래프를 좀 더 의미있게 만들기 위해, 100번 실험에 대한 이동 평균을 계산할 수 있습니다. np.convolve로 편리하게 계산 가능합니다: (코드 블록 12)
def running_average(x,window):
    return np.convolve(x,np.ones(window)/window,mode='valid')

plt.plot(running_average(rewards,100))
하이퍼파라미터 조절
학습을 더 안정적으로 만들려면 훈련 중에 하이퍼파라미터를 조절하는 것이 좋습니다. 특히:
-
학습률(alpha): 1에 가까운 값에서 시작해 점차 감소시킵니다. 시간이 지날수록 Q-테이블 값의 확률이 좋아지고, 완전히 덮어쓰지 않고 조금씩 조정하게 됩니다.
-
epsilon 증가: 탐색을 줄이고 활용을 늘리기 위해 epsilon 값을 천천히 올릴 수 있습니다. 낮은 epsilon 값에서 시작하여 1에 가까워지는 방향이 적절할 것입니다.
과제 1: 하이퍼파라미터 값을 조절하며 더 높은 누적 보상을 달성할 수 있는지 시험해 보세요. 195 이상을 얻었나요?
과제 2: 문제를 정식으로 해결하려면 100번 연속 실행에서 평균 보상 195를 얻어야 합니다. 훈련 중에 이를 측정하고 문제를 정식으로 해결했는지 확인하세요!
결과를 실제로 보기
훈련된 모델이 실제로 어떻게 동작하는지 보는 것이 흥미로울 것입니다. 시뮬레이션을 실행하고 훈련 중과 동일한 행동 선택 전략을 따르며 Q-Table의 확률 분포에 따라 샘플링 해봅시다: (코드 블록 13)
obs = env.reset()
done = False
while not done:
   s = discretize(obs)
   env.render()
   v = probs(np.array(qvalues(s)))
   a = random.choices(actions,weights=v)[0]
   obs,_,done,_ = env.step(a)
env.close()
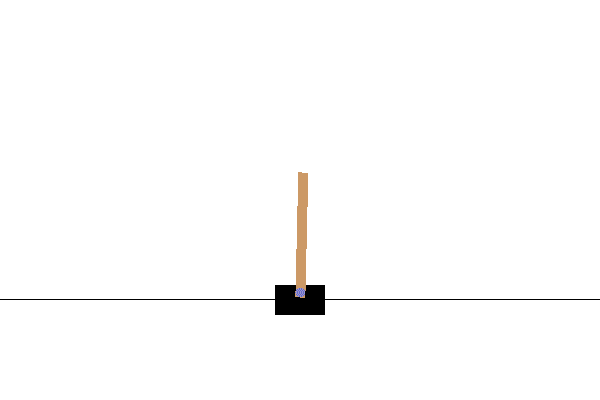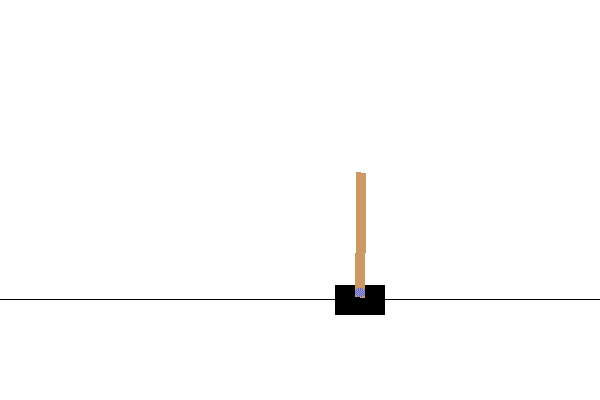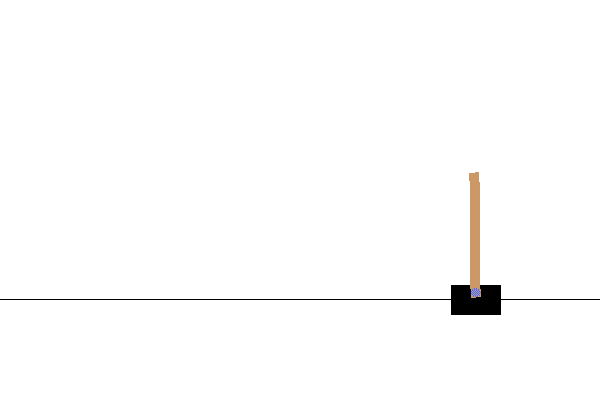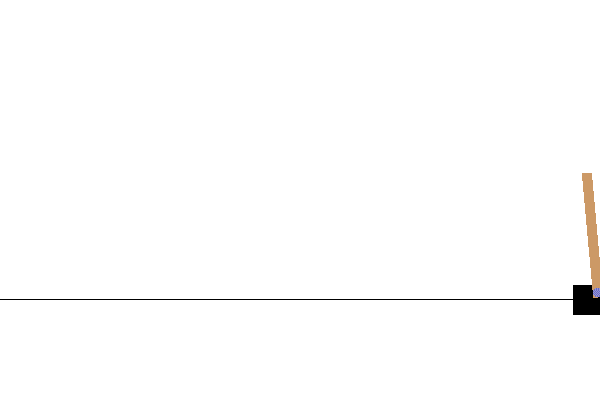
다음과 같은 것을 볼 수 있을 것입니다:
🚀도전 과제
과제 3: 여기서는 최종 Q-Table 사본을 사용했는데, 이것이 최선의 사본이 아닐 수도 있습니다. 최상의 성능을 낸 Q-Table을
Qbest변수에 저장해두었음을 기억하세요!Qbest를Q에 복사해서 최상의 Q-Table로 같은 예제를 시도해 보고 차이를 확인해 보세요.
과제 4: 여기서는 각 단계마다 최선의 행동을 선택하지 않고, 해당 확률 분포에 따라 샘플링했습니다. 항상 Q-Table 값이 가장 높은 최선의 행동을 선택하는 것이 더 합리적일까요? 이는
np.argmax함수를 사용해 가장 높은 Q-Table 값에 해당하는 행동 번호를 찾으면 됩니다. 이 전략을 구현하고 균형 유지가 개선되는지 확인해 보세요.
강의 후 퀴즈
과제
결론
이제 원하는 게임 상태를 정의하는 보상 함수만 제공하고 탐색 공간을 지능적으로 탐험할 기회를 줌으로써 에이전트를 훈련해 좋은 결과를 얻는 방법을 배웠습니다. 이산 및 연속 환경의 경우에 Q-러닝 알고리즘을 성공적으로 적용했지만, 행동은 이산적이었습니다.
행동 상태도 연속적이고 관찰 공간이 Atari 게임 화면과 같이 훨씬 복잡한 상황을 연구하는 것도 중요합니다. 이러한 문제에서는 좋은 결과를 얻기 위해 신경망과 같은 더 강력한 머신러닝 기법을 사용해야 하는 경우가 많습니다. 이러한 고급 주제들은 우리가 곧 다룰 더 고급 AI 강의에서 다뤄질 내용입니다.
면책 조항: 이 문서는 AI 번역 서비스 Co-op Translator를 사용하여 번역되었습니다. 정확성을 기하기 위해 노력하고 있으나, 자동 번역은 오류나 부정확한 부분이 있을 수 있음을 유의하시기 바랍니다. 원본 문서의 원어본이 권위 있는 자료로 간주되어야 합니다. 중요한 정보의 경우, 전문가의 인간 번역을 권장합니다. 이 번역 사용으로 인해 발생하는 오해나 잘못된 해석에 대해 당사는 책임을 지지 않습니다.