# 使用 Python 和 Scikit-learn 開始回歸模型
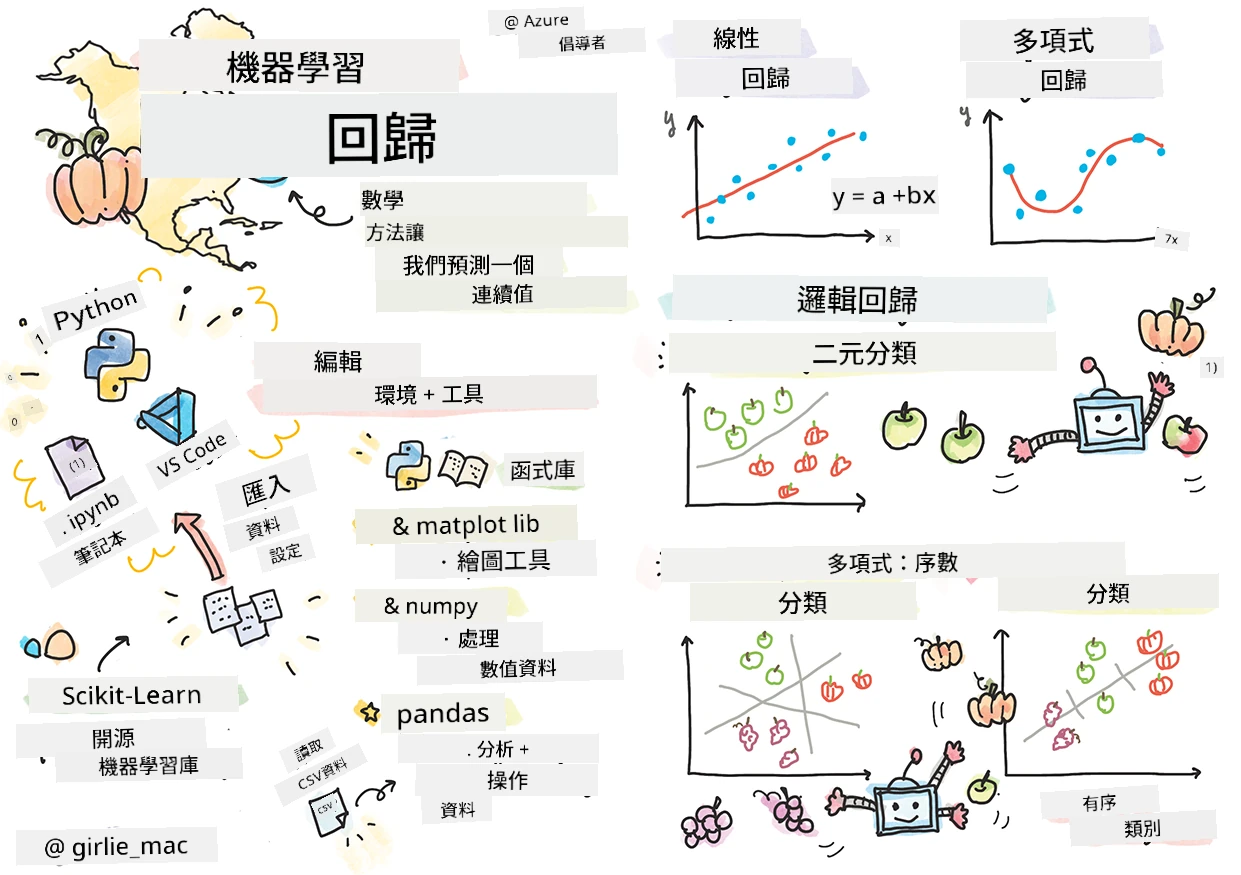
> 手繪筆記由 [Tomomi Imura](https://www.twitter.com/girlie_mac) 製作
## [課前小測驗](https://ff-quizzes.netlify.app/en/ml/)
> ### [本課程亦提供 R 版本!](../../../../2-Regression/1-Tools/solution/R/lesson_1.html)
## 介紹
在這四課中,您將學習如何建立回歸模型。我們稍後會討論其用途。但在您開始之前,請確保您已備妥適用的工具來展開此流程!
在本課中,您將學會:
- 為本地機器學習任務配置您的電腦。
- 使用 Jupyter 筆記本。
- 使用 Scikit-learn,包括安裝。
- 透過實作活動探索線性回歸。
## 安裝與設定
[](https://youtu.be/-DfeD2k2Kj0 "適合初學者的機器學習 - 準備好您的工具以建構機器學習模型")
> 🎥 點擊上方圖片觀看設定電腦進行機器學習的短片。
1. **安裝 Python**。確保您的電腦已安裝 [Python](https://www.python.org/downloads/)。Python 被廣泛用於資料科學與機器學習工作。大多數作業系統已預裝 Python。部分用戶也可以使用有助安裝的 [Python 程式包](https://code.visualstudio.com/learn/educators/installers?WT.mc_id=academic-77952-leestott)。
然而,Python 的某些用法需要特定版本,因此建議在 [虛擬環境](https://docs.python.org/3/library/venv.html) 中工作。
2. **安裝 Visual Studio Code**。請確保您已在電腦上安裝 Visual Studio Code。請遵循[安裝 Visual Studio Code 指引](https://code.visualstudio.com/)完成基本安裝。此課程將在 Visual Studio Code 中使用 Python,您也可參考如何[設定 Visual Studio Code](https://docs.microsoft.com/learn/modules/python-install-vscode?WT.mc_id=academic-77952-leestott)以便 Python 開發。
> 藉由此[學習模組](https://docs.microsoft.com/users/jenlooper-2911/collections/mp1pagggd5qrq7?WT.mc_id=academic-77952-leestott)練習熟悉 Python。
>
> [](https://youtu.be/yyQM70vi7V8 "用 Visual Studio Code 設定 Python")
>
> 🎥 點擊上方圖片觀看在 VS Code 中使用 Python 的教學影片。
3. **安裝 Scikit-learn**,請依照[此處的指引](https://scikit-learn.org/stable/install.html)進行。請確認使用 Python 3,建議搭配虛擬環境。若您在 M1 Mac 安裝,鏈結頁面有特別說明。
1. **安裝 Jupyter Notebook**。您需要[安裝 Jupyter 套件](https://pypi.org/project/jupyter/)。
## 您的機器學習開發環境
您將使用 筆記本 來開發 Python 程式碼並建立機器學習模型。這類檔案是資料科學常用工具,副檔名為 `.ipynb`。
筆記本提供互動式環境,允許開發者同時撰寫程式碼及相關備註和說明,對實驗或研究導向專案非常有幫助。
[](https://youtu.be/7E-jC8FLA2E "適合初學者的機器學習 - 設定 Jupyter 筆記本開始建立回歸模型")
> 🎥 點擊上方圖片觀看本練習的簡短影片。
### 練習 - 操作筆記本
您會在此資料夾中找到 _notebook.ipynb_ 檔案。
1. 在 Visual Studio Code 中開啟 _notebook.ipynb_。
Jupyter 伺服器將啟動並使用 Python 3+。您會發現筆記本中有可 `執行` 的程式碼區塊。您可點擊像播放按鈕的圖示來執行程式碼。
1. 選擇 `md` 圖示,新增一些 markdown,並加入文字 **# 歡迎使用您的筆記本**。
接著,添加一些 Python 程式碼。
1. 在程式碼區塊中輸入 **print('hello notebook')**。
1. 點擊箭頭執行程式碼。
您應該會看到印出的訊息:
```output
hello notebook
```
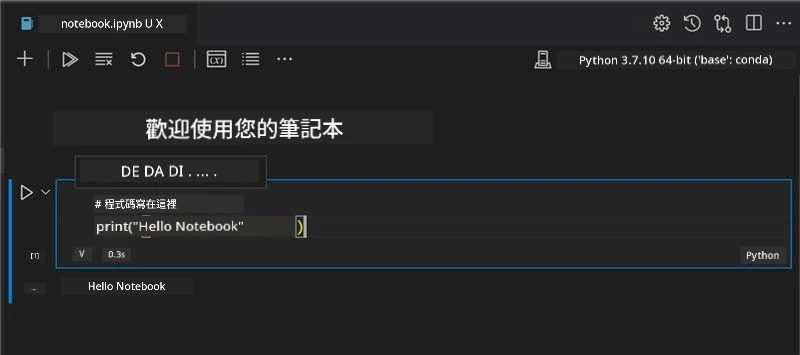
您可穿插程式碼與註解,為筆記本自我撰寫文件。
✅ 想想網頁開發者的工作環境與資料科學家有何不同。
## 使用 Scikit-learn 起步
現在 Python 已在本地環境設定完成,並熟悉了 Jupyter 筆記本,我們來熟悉 Scikit-learn(唸作 `sci`,像科學 science 的發音)。Scikit-learn 提供[豐富的 API](https://scikit-learn.org/stable/modules/classes.html#api-ref)輔助機器學習工作。
根據其 [官方網站](https://scikit-learn.org/stable/getting_started.html):"Scikit-learn 是一個開源機器學習函式庫,支持監督式與非監督式學習,並提供模型擬合、資料預處理、模型選擇與評估等多種工具。"
在本課程中,您將使用 Scikit-learn 及其他工具來建立傳統機器學習模型。我們故意避開神經網絡與深度學習,因其將在即將推出的「初學者 AI 課程」中詳述。
Scikit-learn 使模型建立與評估簡單直接,主要針對數值資料,並包含數個準備好的資料集供學習使用,也附帶可供學生嘗試的預建模型。我們來探索以內建資料與預設估計器,如何用 Scikit-learn 建立第一個機器學習模型。
## 練習 - 您的第一個 Scikit-learn 筆記本
> 本指南靈感來自 Scikit-learn 網站上的[線性回歸示範](https://scikit-learn.org/stable/auto_examples/linear_model/plot_ols.html#sphx-glr-auto-examples-linear-model-plot-ols-py)。
[](https://youtu.be/2xkXL5EUpS0 "適合初學者的機器學習 - 您的第一個 Python 線性回歸專案")
> 🎥 點擊上方圖片觀看本練習的簡短影片。
在此課程相關的 _notebook.ipynb_ 檔中,按下「垃圾桶」圖示清除所有儲存格。
本節將使用 Scikit-learn 內建的小型糖尿病資料集。假設您想測試糖尿病患者的療法,機器學習模型有助判斷哪些患者基於變數組合會較好反應。即使是最基本的回歸模型,經視覺化後,也可呈現關於有助安排臨床試驗的變數資訊。
✅ 回歸方法有多種,選用取決於您想要的答案。若您想預測某年齡者的可能身高,會用線性回歸,因為您在尋求一個數值。若您想辨別一種料理是否為素食,您正尋求類別判定,會使用邏輯回歸;稍後會學到更多。思考您能從資料問些什麼問題,哪種方法較適合。
讓我們開始進行這個任務。
### 匯入函式庫
本任務將匯入以下函式庫:
- **matplotlib**。這是一個實用的[繪圖工具](https://matplotlib.org/),我們會用來繪製線圖。
- **numpy**。[numpy](https://numpy.org/doc/stable/user/whatisnumpy.html) 在 Python 中處理數值資料非常有用。
- **sklearn**。這是 [Scikit-learn](https://scikit-learn.org/stable/user_guide.html) 函式庫。
匯入這些函式庫協助您的任務。
1. 輸入以下程式碼以加入匯入:
```python
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model, model_selection
```
上述程式碼匯入了 `matplotlib`、`numpy`,以及從 `sklearn` 匯入 `datasets`、`linear_model` 和 `model_selection`。`model_selection` 用於將資料分割為訓練與測試集。
### 糖尿病資料集
內建的[糖尿病資料集](https://scikit-learn.org/stable/datasets/toy_dataset.html#diabetes-dataset)包含 442 筆糖尿病相關資料,含 10 個特徵變數,部分如下:
- age:年齡(歲)
- bmi:身體質量指數
- bp:平均血壓
- s1 tc:T 細胞(一種白血球)
✅ 此資料集包含名為「性別」的特徵變數,對糖尿病研究至關重要。許多醫學資料集包含此類二元分類。想想此類分類如何可能令部分族群無法接受治療。
現在,載入 X 和 y 資料。
> 🎓 記住,這是監督式學習,需要標記為 y 的目標。
在新程式碼儲存格中,藉由呼叫 `load_diabetes()` 載入糖尿病資料集。參數 `return_X_y=True` 表示 `X` 是資料矩陣,`y` 是回歸目標。
1. 添加列印指令以顯示資料矩陣形狀及第一筆數據:
```python
X, y = datasets.load_diabetes(return_X_y=True)
print(X.shape)
print(X[0])
```
您的回傳結果是一個元組。賦值將元組的前兩個值分別給 `X` 和 `y`。更多資訊參見[元組介紹](https://wikipedia.org/wiki/Tuple)。
可見此資料集有 442 筆資料,每筆為包含 10 個元素的陣列:
```text
(442, 10)
[ 0.03807591 0.05068012 0.06169621 0.02187235 -0.0442235 -0.03482076
-0.04340085 -0.00259226 0.01990842 -0.01764613]
```
✅ 思考資料與回歸目標的關係。線性回歸預測特徵 X 與目標變數 y 的關聯。在文件中能找到糖尿病資料集的[目標](https://scikit-learn.org/stable/datasets/toy_dataset.html#diabetes-dataset)嗎?以此目標,此資料集展示了什麼?
2. 接著,從資料集中選擇部分資料繪圖,選擇第 3 欄資料。透過 `:` 選擇所有列,使用索引 (2) 選取第 3 欄。使用 `reshape(n_rows, n_columns)` 將資料重塑為 2D 陣列以利繪圖。若參數為 -1,對應維度將自動計算。
```python
X = X[:, 2]
X = X.reshape((-1,1))
```
✅ 隨時印出資料確認其形狀。
3. 現有資料可供繪製,您看看機器能否幫助找出資料的合適劃分。為此,需將資料 (X) 與目標 (y) 分割為測試與訓練集。Scikit-learn 提供簡單方法於指定點分割測試資料。
```python
X_train, X_test, y_train, y_test = model_selection.train_test_split(X, y, test_size=0.33)
```
4. 之後,您可訓練模型!載入線性回歸模型,並以 `model.fit()` 透過訓練集 X 和 y 訓練模型:
```python
model = linear_model.LinearRegression()
model.fit(X_train, y_train)
```
✅ `model.fit()` 是許多機器學習函式庫如 TensorFlow 中常見的函式。
5. 接著,使用測試資料利用 `predict()` 產生預測。此預測用於繪製資料組間的分界線。
```python
y_pred = model.predict(X_test)
```
6. 現在來展示資料的繪圖。Matplotlib 是實用工具。繪製測試集 X 和 y 的散點圖,並根據預測在最合適位置繪出模型資料分群間線條。
```python
plt.scatter(X_test, y_test, color='black')
plt.plot(X_test, y_pred, color='blue', linewidth=3)
plt.xlabel('Scaled BMIs')
plt.ylabel('Disease Progression')
plt.title('A Graph Plot Showing Diabetes Progression Against BMI')
plt.show()
```
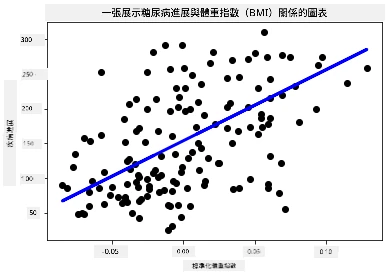
✅ 想想這在做什麼。一條直線穿過眾多小資料點,但實際作用是?您是否能利用這條線預測新資料點在繪圖 y 軸上的位置?嘗試用語言描述此模型的實用意義。
恭喜,您建立了第一個線性回歸模型,並以其產生預測,最後顯示於圖表中!
---
## 🚀挑戰
繪製此資料集中的另一個變數。提示:編輯此行:`X = X[:,2]`。考慮此資料集目標,您能發現糖尿病作為疾病的進展情形?
## [課後小測驗](https://ff-quizzes.netlify.app/en/ml/)
## 複習與自學
在本教學中,您接觸的是簡單線性回歸,而非單變量或多變量線性回歸。稍微閱讀這些方法間的差異,或觀看[此影片](https://www.coursera.org/lecture/quantifying-relationships-regression-models/linear-vs-nonlinear-categorical-variables-ai2Ef)。
詳細了解回歸的概念,並思考這種技術可以解答哪些類型的問題。進行這個 [教程](https://docs.microsoft.com/learn/modules/train-evaluate-regression-models?WT.mc_id=academic-77952-leestott) 以深化你的理解。
## 作業
[另一個數據集](assignment.md)
---
**免責聲明**:
本文件使用 AI 翻譯服務 [Co-op Translator](https://github.com/Azure/co-op-translator) 進行翻譯。雖然我們力求準確,但請注意,自動翻譯可能包含錯誤或不準確之處。原始文件的母語版本應被視為權威來源。對於重要資訊,建議尋求專業人工翻譯。我們不對因使用本翻譯而引起的任何誤解或曲解承擔責任。