# การเล่นสเก็ต CartPole
ปัญหาที่เราได้แก้ไขในบทเรียนก่อนหน้าอาจดูเหมือนเป็นปัญหาเล่น ๆ ที่ไม่ค่อยใช้ได้กับสถานการณ์ในชีวิตจริง แต่ความจริงไม่ใช่เช่นนั้น เพราะปัญหาในโลกแห่งความเป็นจริงหลายปัญหาก็มีสถานการณ์แบบนี้เช่นกัน — รวมถึงการเล่นหมากรุกหรือโกะ พวกเขาคล้ายกันเพราะเรามีบอร์ดกับกฎที่กำหนดไว้ และมี **สถานะเชิงความแตกต่าง**
## [แบบทดสอบก่อนเรียน](https://ff-quizzes.netlify.app/en/ml/)
## บทนำ
ในบทเรียนนี้เราจะนำหลักการเดียวกับ Q-Learning ไปใช้กับปัญหาที่มี **สถานะเชิงต่อเนื่อง** คือสถานะที่กำหนดโดยจำนวนจริงหนึ่งค่าหรือมากกว่านั้น เราจะจัดการกับปัญหาต่อไปนี้:
> **ปัญหา**: ถ้าพีเตอร์ต้องการหนีหมาป่า เขาต้องสามารถเคลื่อนที่ได้เร็วขึ้น เราจะดูว่าพีเตอร์จะเรียนรู้การเล่นสเก็ต โดยเฉพาะการรักษาสมดุลได้อย่างไร โดยใช้ Q-Learning
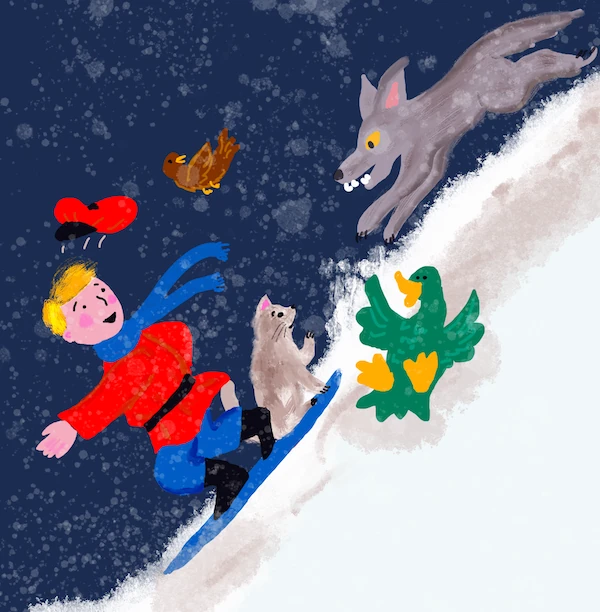
> พีเตอร์และเพื่อน ๆ ของเขาคิดสร้างสรรค์วิธีหนีหมาป่า! ภาพโดย [Jen Looper](https://twitter.com/jenlooper)
เราจะใช้รุ่นง่ายของการรักษาสมดุลที่รู้จักกันในชื่อปัญหา **CartPole** ในโลก cartpole นี้ เรามีที่เลื่อนไปทางซ้าย-ขวา และเป้าหมายคือรักษาเสาแนวตั้งให้ตั้งอยู่บนที่เลื่อนนี้ได้อย่างสมดุล
 ## สิ่งที่ต้องเตรียม
ในบทเรียนนี้เราจะใช้ไลบรารีชื่อ **OpenAI Gym** เพื่อจำลอง **สภาพแวดล้อม** ต่าง ๆ คุณสามารถรันโค้ดของบทเรียนนี้ในเครื่องตัวเอง (เช่นจากโปรแกรม Visual Studio Code) ซึ่งกรณีนี้จะเปิดหน้าต่างจำลองขึ้นมาหนึ่งหน้าต่าง เมื่อรันโค้ดออนไลน์ อาจต้องปรับแต่งโค้ดตามที่อธิบายไว้ [ตรงนี้](https://towardsdatascience.com/rendering-openai-gym-envs-on-binder-and-google-colab-536f99391cc7)
## OpenAI Gym
ในบทเรียนก่อนหน้า กฎของเกมและสถานะถูกกำหนดโดยคลาส `Board` ที่เราสร้างเอง ที่นี่เราจะใช้ **สภาพแวดล้อมจำลอง** แบบพิเศษซึ่งจะจำลองฟิสิกส์เบื้องหลังเสาที่รักษาสมดุล หนึ่งในสภาพแวดล้อมจำลองยอดนิยมสำหรับฝึกอัลกอริทึมเสริมกำลังเรียกว่าสภาพแวดล้อม [Gym](https://gym.openai.com/) ซึ่งได้รับการดูแลโดย [OpenAI](https://openai.com/) โดยใช้ gym นี้เราสามารถสร้าง **สภาพแวดล้อม** ต่าง ๆ ตั้งแต่จำลอง cartpole ไปจนถึงเกม Atari
> **หมายเหตุ**: คุณสามารถดูสภาพแวดล้อมอื่น ๆ ที่มีให้ใน OpenAI Gym ได้ [ที่นี่](https://gym.openai.com/envs/#classic_control)
เริ่มด้วยการติดตั้ง gym และนำเข้าไลบรารีที่จำเป็น (โค้ดบล็อก 1):
```python
import sys
!{sys.executable} -m pip install gym
import gym
import matplotlib.pyplot as plt
import numpy as np
import random
```
## แบบฝึกหัด - การเริ่มต้นสภาพแวดล้อม cartpole
เพื่อทำงานกับปัญหาการรักษาสมดุล cartpole เราต้องเริ่มต้นสภาพแวดล้อมที่เกี่ยวข้อง สภาพแวดล้อมแต่ละอันเกี่ยวข้องกับ:
- **Observation space** ที่กำหนดโครงสร้างของข้อมูลที่เราได้รับจากสภาพแวดล้อม สำหรับปัญหา cartpole เราจะได้รับตำแหน่งของเสา ความเร็ว และค่าบางค่าอื่น ๆ
- **Action space** กำหนดการกระทำที่เป็นไปได้ สำหรับเรา action space เป็นแบบแบ่งแยกและประกอบด้วยสองการกระทำ - **ซ้าย** และ **ขวา** (โค้ดบล็อก 2)
1. ในการเริ่มต้น ให้พิมพ์โค้ดดังนี้:
```python
env = gym.make("CartPole-v1")
print(env.action_space)
print(env.observation_space)
print(env.action_space.sample())
```
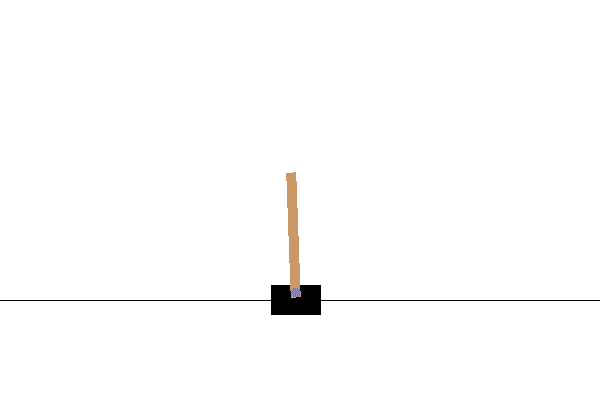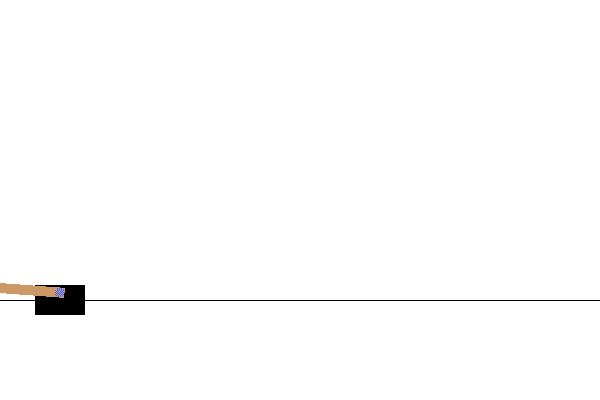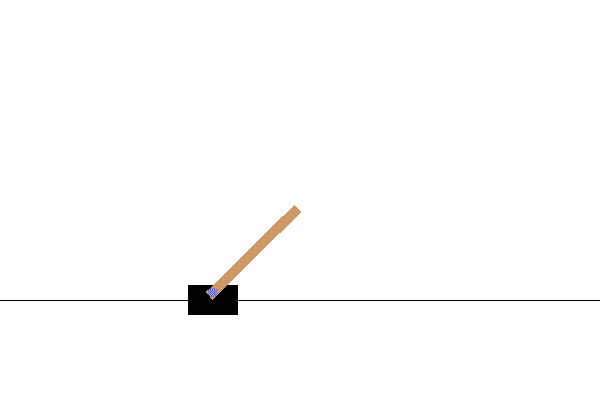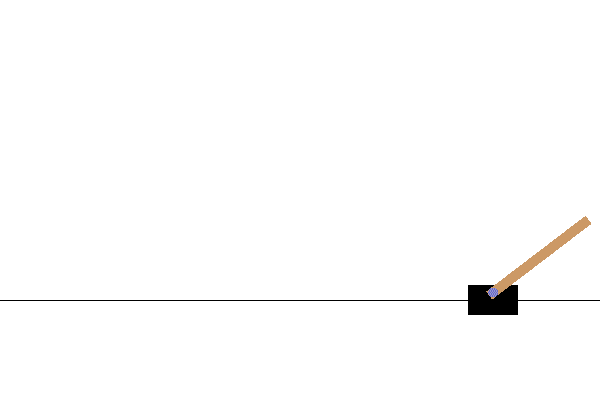
เพื่อดูว่าสภาพแวดล้อมทำงานอย่างไร ให้รันการจำลองสั้น ๆ จำนวน 100 ก้าว ในแต่ละก้าว ให้เราส่งการกระทำที่ต้องการทำ — ในการจำลองนี้เราเลือกการกระทำแบบสุ่มจาก `action_space`
1. รันโค้ดด้านล่างและดูผลลัพธ์
✅ จำไว้ว่าควรรันโค้ดนี้ในเครื่อง Python ติดตั้งท้องถิ่นของคุณจะดีที่สุด! (โค้ดบล็อก 3)
```python
env.reset()
for i in range(100):
env.render()
env.step(env.action_space.sample())
env.close()
```
คุณควรจะเห็นสิ่งที่คล้ายกับภาพนี้:
1. ระหว่างการจำลอง เราต้องได้ข้อมูลการสังเกตเพื่อช่วยตัดสินใจทำการกระทำ ในความเป็นจริง ฟังก์ชัน step จะคืนค่าการสังเกตปัจจุบัน รางวัล และสัญญาณ done ที่แสดงว่าควรจะหยุดการจำลองหรือไม่: (โค้ดบล็อก 4)
```python
env.reset()
done = False
while not done:
env.render()
obs, rew, done, info = env.step(env.action_space.sample())
print(f"{obs} -> {rew}")
env.close()
```
คุณจะเห็นผลลัพธ์ในโน้ตบุ๊กแบบนี้:
```text
[ 0.03403272 -0.24301182 0.02669811 0.2895829 ] -> 1.0
[ 0.02917248 -0.04828055 0.03248977 0.00543839] -> 1.0
[ 0.02820687 0.14636075 0.03259854 -0.27681916] -> 1.0
[ 0.03113408 0.34100283 0.02706215 -0.55904489] -> 1.0
[ 0.03795414 0.53573468 0.01588125 -0.84308041] -> 1.0
...
[ 0.17299878 0.15868546 -0.20754175 -0.55975453] -> 1.0
[ 0.17617249 0.35602306 -0.21873684 -0.90998894] -> 1.0
```
เวกเตอร์การสังเกตที่คืนค่ามาในแต่ละก้าวของการจำลองประกอบด้วยค่าดังนี้:
- ตำแหน่งของรถเข็น
- ความเร็วของรถเข็น
- มุมของเสา
- อัตราการหมุนของเสา
1. หาค่าต่ำสุดและค่าสูงสุดของตัวเลขเหล่านี้: (โค้ดบล็อก 5)
```python
print(env.observation_space.low)
print(env.observation_space.high)
```
คุณอาจสังเกตเห็นว่าค่ารางวัลในแต่ละก้าวของการจำลองคือ 1 เสมอ เพราะเป้าหมายของเราคืออยู่รอดให้นานที่สุด หมายความว่ารักษาเสาให้อยู่ในตำแหน่งตั้งตรงที่สมเหตุสมผลเป็นเวลานานที่สุด
✅ จริง ๆ แล้ว การจำลอง CartPole ถือว่าแก้ไขได้ถ้าสามารถได้รางวัลเฉลี่ย 195 ใน 100 รอบติดต่อกัน
## การแบ่งสถานะเป็นช่วง
ใน Q-Learning เราต้องสร้าง Q-Table ที่กำหนดว่าจะทำอะไรในแต่ละสถานะ เพื่อทำเช่นนี้ได้เราต้องให้สถานะเป็น **ค่าต่าง ๆ อย่างชัดเจน** ซึ่งแปลว่าควรมีจำนวนค่าที่แตกต่างกันจำกัด ดังนั้นเราจึงต้อง **แบ่งช่วง** การสังเกตของเรา เพื่อแมปเป็นชุดสถานะจำกัด
มีหลายวิธีที่เราสามารถทำได้:
- **แบ่งออกเป็นถังข้อมูล**: ถ้าเรารู้ช่วงของค่าบางค่า เราสามารถแบ่งช่วงนี้ออกเป็นจำนวน **ถังข้อมูล** และแทนที่ค่าด้วยหมายเลขถังข้อมูลที่มันอยู่ วิธีนี้ใช้เมธอด [`digitize`](https://numpy.org/doc/stable/reference/generated/numpy.digitize.html) ของ numpy ในกรณีนี้ เราจะรู้อย่างแน่นอนว่าขนาดของสถานะเป็นเท่าไรเพราะขึ้นอยู่กับจำนวนถังข้อมูลที่เราเลือกสำหรับการแปลงเป็นดิจิทัล
✅ เราสามารถใช้การประมาณเชิงเส้น (linear interpolation) เพื่อนำค่ามาให้อยู่ในช่วงจำกัด (เช่นจาก -20 ถึง 20) แล้วเปลี่ยนตัวเลขเป็นจำนวนเต็มโดยปัดเศษ วิธีนี้ให้การควบคุมขนาดของสถานะน้อยลงเล็กน้อย โดยเฉพาะถ้าเราไม่รู้ช่วงที่แน่นอนของค่าป้อนเข้า ตัวอย่างเช่น กรณีของเรา มี 2 ใน 4 ค่าที่ไม่มีขอบเขตบนหรือล่าง ซึ่งอาจทำให้จำนวนสถานะไม่มีที่สิ้นสุด
ในตัวอย่างของเรา เราจะเลือกวิธีที่สอง ตามที่คุณจะเห็นภายหลัง ถึงแม้ขอบเขตบน/ล่างไม่ได้กำหนดไว้ ค่าพวกนี้ก็น้อยครั้งที่จะทะลุออกนอกช่วงจำกัด ดังนั้นสถานะที่มีค่าสุดขั้วจะค่อนข้างน้อยมาก
1. นี่คือฟังก์ชันที่จะรับข้อมูลการสังเกตจากโมเดลของเราและคืนชุดตัวเลขจำนวนเต็ม 4 ตัว: (โค้ดบล็อก 6)
```python
def discretize(x):
return tuple((x/np.array([0.25, 0.25, 0.01, 0.1])).astype(np.int))
```
1. มาลองวิธีแบ่งช่วงโดยใช้ถังข้อมูล: (โค้ดบล็อก 7)
```python
def create_bins(i,num):
return np.arange(num+1)*(i[1]-i[0])/num+i[0]
print("Sample bins for interval (-5,5) with 10 bins\n",create_bins((-5,5),10))
ints = [(-5,5),(-2,2),(-0.5,0.5),(-2,2)] # ช่วงของค่าสำหรับแต่ละพารามิเตอร์
nbins = [20,20,10,10] # จำนวนช่องสำหรับแต่ละพารามิเตอร์
bins = [create_bins(ints[i],nbins[i]) for i in range(4)]
def discretize_bins(x):
return tuple(np.digitize(x[i],bins[i]) for i in range(4))
```
1. ลองรันการจำลองสั้น ๆ และสังเกตค่าสภาพแวดล้อมที่แบ่งช่วงแล้วทั้งสองแบบ ลองเปรียบเทียบ `discretize` กับ `discretize_bins` ว่าต่างกันไหม
✅ `discretize_bins` คืนค่าหมายเลขถังข้อมูลที่เริ่มจากศูนย์ ดังนั้นค่าป้อนเข้าสร้างรอบ 0 จึงได้หมายเลขตรงกลางช่วง (10) ส่วนใน `discretize` เราไม่ได้กังวลเกี่ยวกับช่วงของค่าผลลัพธ์ ทำให้ค่าคงสถานะไม่เป็นการเลื่อน ค่า 0 ตรงกับ 0 จริง ๆ (โค้ดบล็อก 8)
```python
env.reset()
done = False
while not done:
#env.render()
obs, rew, done, info = env.step(env.action_space.sample())
#print(discretize_bins(obs))
print(discretize(obs))
env.close()
```
✅ ยกเลิกการคอมเมนต์บรรทัดที่เริ่มด้วย env.render ถ้าคุณอยากดูการทำงานของสภาพแวดล้อมแบบเรียลไทม์ หากไม่ทำก็รันโค้ดในฉากหลังซึ่งจะเร็วกว่า เราจะใช้วิธีรัน “ไม่เห็น” นี้ในขั้นตอน Q-Learning
## โครงสร้างของ Q-Table
ในบทเรียนก่อนหน้าสถานะเป็นคู่ตัวเลขง่าย ๆ ตั้งแต่ 0 ถึง 8 ซึ่งสะดวกในการแทน Q-Table ด้วยเทนเซอร์ numpy ขนาด 8x8x2 ถ้าเราใช้วิธีแบ่งช่วงอย่างถังข้อมูล ขนาดของเวกเตอร์สถานะก็จะทราบเช่นกัน ดังนั้นเราสามารถแทนสถานะด้วยอาร์เรย์ขนาด 20x20x10x10x2 (ที่นี่ 2 คือมิติของ action space และมิติแรก ๆ เป็นจำนวนถังข้อมูลที่เราใช้สำหรับแต่ละพารามิเตอร์ใน observation space)
แต่บางครั้งมิติที่แม่นยำของ observation space อาจไม่ทราบ ในกรณีของฟังก์ชัน `discretize` เราอาจไม่แน่ใจว่าสถานะจะอยู่ในขอบเขตที่กำหนดเพราะค่าส่วนหนึ่งไม่มีขอบเขต เราจะใช้วิธีแทน Q-Table ด้วยพจนานุกรมแทน
1. ใช้คู่ *(state, action)* เป็นคีย์ของพจนานุกรม และค่าจะเป็นค่าของ Q-Table entry (โค้ดบล็อก 9)
```python
Q = {}
actions = (0,1)
def qvalues(state):
return [Q.get((state,a),0) for a in actions]
```
ที่นี่เรายังกำหนดฟังก์ชัน `qvalues()` ซึ่งคืนรายการค่าของ Q-Table สำหรับสถานะที่กำหนดที่สอดคล้องกับการกระทำที่เป็นไปได้ทั้งหมด ถ้าไม่มีข้อมูลนั้นใน Q-Table เราจะคืนค่าเริ่มต้นเป็น 0
## มาเริ่ม Q-Learning กันเถอะ
ตอนนี้เราพร้อมจะสอนพีเตอร์ให้รักษาสมดุลแล้ว!
1. เริ่มโดยตั้งค่าพารามิเตอร์ไฮเปอร์จำนวนหนึ่ง: (โค้ดบล็อก 10)
```python
# ไฮเปอร์พารามิเตอร์
alpha = 0.3
gamma = 0.9
epsilon = 0.90
```
ที่นี่ `alpha` คือ **อัตราการเรียนรู้** ที่กำหนดว่าควรจะปรับค่าปัจจุบันของ Q-Table มากน้อยแค่ไหนในแต่ละก้าว ในบทเรียนก่อนหน้าเราเริ่มต้นจาก 1 แล้วลด `alpha` ในระหว่างฝึก ในตัวอย่างนี้เราจะเก็บให้คงที่เพื่อความง่าย และคุณสามารถทดลองปรับค่า `alpha` ได้ทีหลัง
`gamma` คือ **ตัวลดค่ารางวัลในอนาคต** ที่แสดงระดับความสำคัญของรางวัลในอนาคตเทียบกับรางวัลปัจจุบัน
`epsilon` คือ **ตัวแปรสำรวจ/ใช้ประโยชน์** ที่กำหนดว่าจะสำรวจมากกว่าการใช้ประโยชน์ หรือในทางกลับกัน ในอัลกอริทึมของเรา เราจะเลือกการกระทำถัดไปตามค่า Q-Table ในสัดส่วน `epsilon` เปอร์เซ็นต์ และในที่เหลือจะเลือกการกระทำแบบสุ่ม ซึ่งจะช่วยให้เราสำรวจส่วนของพื้นที่ค้นหาที่ไม่เคยเห็นมาก่อน
✅ ในแง่การรักษาสมดุล — การเลือกการกระทำแบบสุ่ม (การสำรวจ) จะทำเหมือนการถูกชกผิดทาง และเสาจะต้องเรียนรู้ฟื้นฟูสมดุลจาก “ความผิดพลาด” เหล่านั้น
### ปรับปรุงอัลกอริทึม
เรายังสามารถทำการปรับปรุงสองอย่างกับอัลกอริทึมนี้จากบทเรียนก่อนหน้าได้:
- **คำนวณรางวัลสะสมเฉลี่ย** ในจำนวนจำลองหลายรอบ เราจะพิมพ์ความก้าวหน้าทุก 5000 รอบ และเฉลี่ยรางวัลสะสมในช่วงเวลานั้น ซึ่งถ้าเราได้มากกว่า 195 แต้ม เราสามารถถือว่าปัญหาได้รับการแก้ไขแล้วด้วยคุณภาพที่สูงกว่าที่กำหนด
- **คำนวณค่ารางวัลสะสมเฉลี่ยสูงสุด**, `Qmax` และเราจะเก็บ Q-Table ที่สอดคล้องกับผลลัพธ์นั้น เมื่อรันการฝึกฝนคุณจะเห็นว่าบางครั้งค่ารางวัลสะสมเฉลี่ยเริ่มลดลง เราจึงต้องเก็บค่าของ Q-Table ที่สอดคล้องกับโมเดลดีที่สุดในระหว่างการฝึก
1. เก็บรางวัลสะสมทั้งหมดไว้ในเวกเตอร์ `rewards` เพื่อใช้วาดกราฟต่อไป (โค้ดบล็อก 11)
```python
def probs(v,eps=1e-4):
v = v-v.min()+eps
v = v/v.sum()
return v
Qmax = 0
cum_rewards = []
rewards = []
for epoch in range(100000):
obs = env.reset()
done = False
cum_reward=0
# == ทำการจำลอง ==
while not done:
s = discretize(obs)
if random.random() Qmax:
Qmax = np.average(cum_rewards)
Qbest = Q
cum_rewards=[]
```
สิ่งที่คุณอาจสังเกตจากผลลัพธ์เหล่านี้:
- **ใกล้เป้าหมาย** เราใกล้จะทำตามเป้าหมายได้รางวัลสะสม 195 ใน 100 รอบติดต่อกัน หรือเราอาจทำได้จริงแล้ว! แม้จะได้น้อยกว่านิดหน่อย เราก็ยังไม่รู้แน่เพราะเราหาค่าเฉลี่ยจาก 5000 รอบ แต่เกณฑ์ทางการกำหนดแค่ 100 รอบ
- **รางวัลเริ่มลดลง** บางครั้งรางวัลสะสมเริ่มลดลง ซึ่งหมายความว่าเราสามารถ “ทำลาย” ค่าที่เรียนรู้แล้วใน Q-Table ด้วยค่าที่ทำให้สถานการณ์แย่ลง
การสังเกตนี้จะชัดเจนมากขึ้นถ้าเราวาดกราฟความก้าวหน้าการฝึก
## วาดกราฟความก้าวหน้าการฝึก
ระหว่างการฝึก เราเก็บค่ารางวัลสะสมในแต่ละรอบไว้ในเวกเตอร์ `rewards` นี่คือรูปลักษณ์เมื่อเราวาดกราฟเทียบกับจำนวนรอบ:
```python
plt.plot(rewards)
```
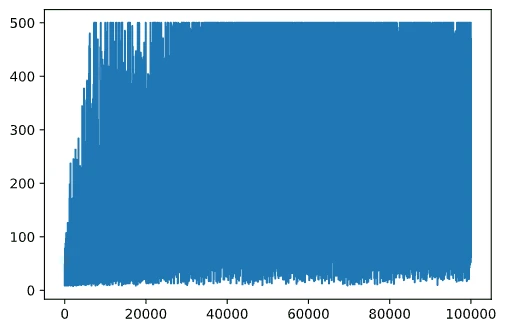
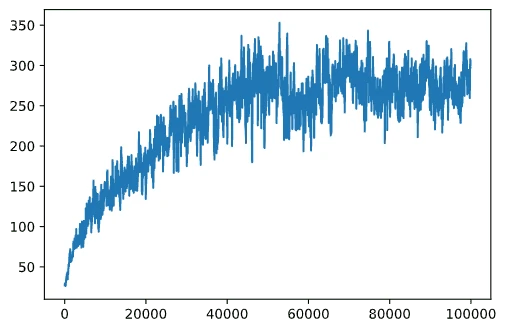
จากกราฟนี้ เราไม่สามารถบอกอะไรได้ เพราะลักษณะของกระบวนการฝึกแบบสโตแคสติก ความยาวของช่วงฝึกต่างกันมาก เพื่อให้กราฟดูสมเหตุสมผลมากขึ้น เราสามารถคำนวณ **ค่าเฉลี่ยเคลื่อนที่** จากการทดลองหลายชุด เช่น 100 รอบ นี่ทำได้สะดวกโดยใช้ `np.convolve`: (โค้ดบล็อก 12)
```python
def running_average(x,window):
return np.convolve(x,np.ones(window)/window,mode='valid')
plt.plot(running_average(rewards,100))
```
## การเปลี่ยนค่าไฮเปอร์พารามิเตอร์
เพื่อให้การเรียนรู้เสถียรขึ้น ฉลาดที่จะปรับพารามิเตอร์ไฮเปอร์บางตัวระหว่างการฝึก โดยเฉพาะ:
- **สำหรับอัตราเรียนรู้** `alpha` เราอาจเริ่มต้นด้วยค่าที่ใกล้ 1 และค่อยลดค่าพารามิเตอร์นี้ ในระยะยาว เราจะได้ค่าความน่าจะเป็นที่ดีใน Q-Table ดังนั้นควรปรับเล็กน้อย ไม่ใช่เขียนทับแบบเต็ม
- **เพิ่มค่า epsilon** เราอาจอยากเพิ่ม `epsilon` อย่างช้า ๆ เพื่อสำรวจน้อยลงและใช้ประโยชน์มากขึ้น มันน่าจะสมเหตุสมผลเริ่มด้วยค่าต่ำของ `epsilon` และเพิ่มขึ้นจนเกือบ 1
> **งานที่ 1**: ทดลองเล่นกับค่าพารามิเตอร์ไฮเปอร์และดูว่าสามารถได้รางวัลสะสมสูงขึ้นไหม คุณได้มากกว่า 195 หรือเปล่า?
> **งานที่ 2**: เพื่อแก้ปัญหาอย่างเป็นทางการ คุณต้องได้รางวัลเฉลี่ย 195 จากการเล่นต่อเนื่อง 100 ครั้ง วัดสิ่งนั้นระหว่างการฝึกและตรวจสอบให้แน่ใจว่าคุณได้แก้ปัญหาอย่างเป็นทางการแล้ว!
## การดูผลลัพธ์ในการทำงานจริง
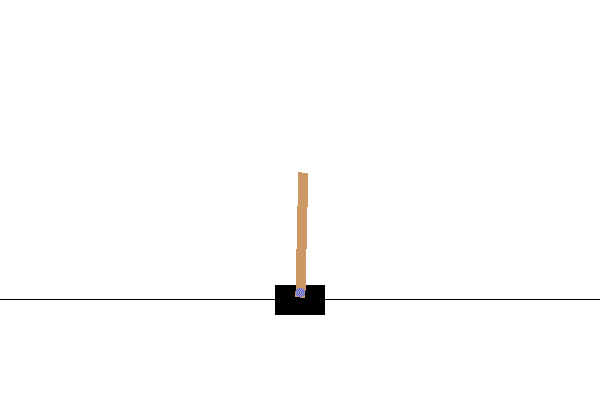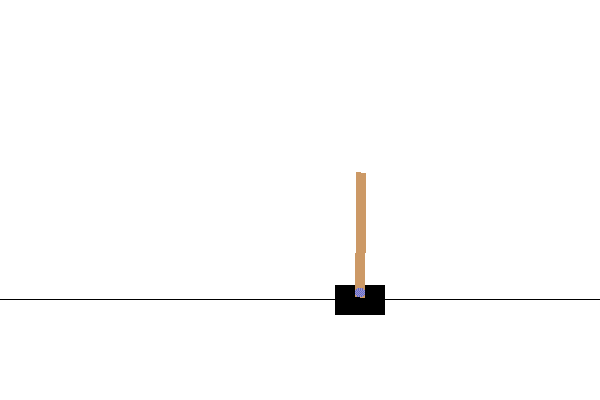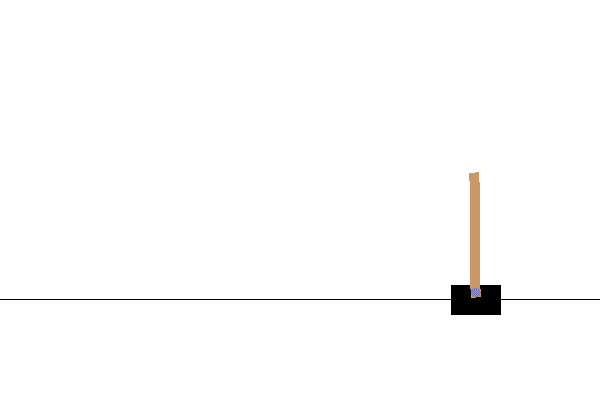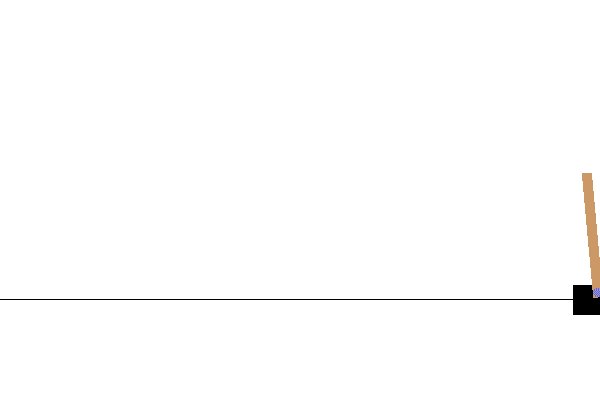
จะน่าสนใจถ้าเราได้เห็นพฤติกรรมของโมเดลที่ได้รับการฝึกจริงๆ ลองรันจำลองและทำตามกลยุทธ์การเลือกการกระทำเดียวกับที่ใช้ระหว่างการฝึก คือการสุ่มตามการแจกแจงความน่าจะเป็นใน Q-Table: (บล็อกโค้ด 13)
```python
obs = env.reset()
done = False
while not done:
s = discretize(obs)
env.render()
v = probs(np.array(qvalues(s)))
a = random.choices(actions,weights=v)[0]
obs,_,done,_ = env.step(a)
env.close()
```
คุณควรจะเห็นอะไรประมาณนี้:
---
## 🚀ความท้าทาย
> **งานที่ 3**: ที่นี่ เราใช้สำเนาสุดท้ายของ Q-Table ซึ่งอาจจะไม่ใช่ตัวที่ดีที่สุด จำไว้ว่าพวกเราเก็บ Q-Table ที่ทำงานดีที่สุดไว้ในตัวแปร `Qbest`! ลองทำตัวอย่างเดียวกันกับ Q-Table ที่ทำงานดีที่สุดโดยคัดลอก `Qbest` ไปทับ `Q` และดูว่าคุณสังเกตเห็นความแตกต่างไหม
> **งานที่ 4**: ที่นี่เราไม่ได้เลือกการกระทำที่ดีที่สุดในแต่ละก้าว แต่สุ่มตามการแจกแจงความน่าจะเป็นที่ตรงกัน จะสมเหตุสมผลไหมถ้าเราเลือกการกระทำที่ดีที่สุดเสมอ โดยเลือกค่าที่สูงที่สุดใน Q-Table? เราสามารถทำได้โดยใช้ฟังก์ชัน `np.argmax` เพื่อหาหมายเลขการกระทำที่ตรงกับค่าที่สูงที่สุดใน Q-Table นำกลยุทธ์นี้ไปใช้และดูว่ามันช่วยปรับปรุงการบาลานซ์ไหม
## [แบบทดสอบหลังการบรรยาย](https://ff-quizzes.netlify.app/en/ml/)
## การบ้าน
[ฝึกสอน Mountain Car](assignment.md)
## สรุป
ตอนนี้เราได้เรียนรู้วิธีฝึกตัวแทนให้ได้ผลลัพธ์ที่ดีเพียงแค่ให้ฟังก์ชันรางวัลซึ่งกำหนดสถานะที่ต้องการในเกม และให้โอกาสตัวแทนสำรวจช่องค้นหาอย่างชาญฉลาด เราประสบความสำเร็จในการใช้วิธี Q-Learning ในกรณีของสภาพแวดล้อมที่เป็นแบบไม่ต่อเนื่องและต่อเนื่อง แต่มีการกระทำที่เป็นแบบไม่ต่อเนื่อง
การศึกษาในสถานการณ์ที่สถานะการกระทำเป็นแบบต่อเนื่อง และเมื่อช่องสังเกตซับซ้อนมากขึ้น เช่น ภาพจากหน้าจอเกม Atari ก็เป็นสิ่งสำคัญ ในปัญหาเหล่านั้นเรามักจะต้องใช้เทคนิคการเรียนรู้ของเครื่องที่ทรงพลังกว่า เช่น เครือข่ายประสาทเทียม เพื่อให้ได้ผลลัพธ์ที่ดี หัวข้อขั้นสูงเหล่านี้จะเป็นเรื่องของคอร์ส AI ขั้นสูงที่กำลังจะมาในอนาคตของเรา
---
**ปฏิเสธความรับผิดชอบ**:
เอกสารนี้ได้รับการแปลโดยใช้บริการแปลภาษา AI [Co-op Translator](https://github.com/Azure/co-op-translator) ขณะที่เราพยายามให้ความถูกต้อง โปรดทราบว่าการแปลโดยอัตโนมัติอาจมีข้อผิดพลาดหรือความไม่ถูกต้อง เอกสารต้นฉบับในภาษาต้นทางควรถูกพิจารณาเป็นแหล่งข้อมูลที่เชื่อถือได้ สำหรับข้อมูลที่สำคัญ แนะนำให้ใช้การแปลโดยมนุษย์มืออาชีพ เราไม่รับผิดชอบต่อความเข้าใจผิดหรือการตีความที่ผิดพลาดที่เกิดขึ้นจากการใช้การแปลนี้